
ARIA Paper review
Ask Your Advisor: Learning When to Consult Stronger Models in Agentic Systems
https://arxiv.org/abs/2610.13870
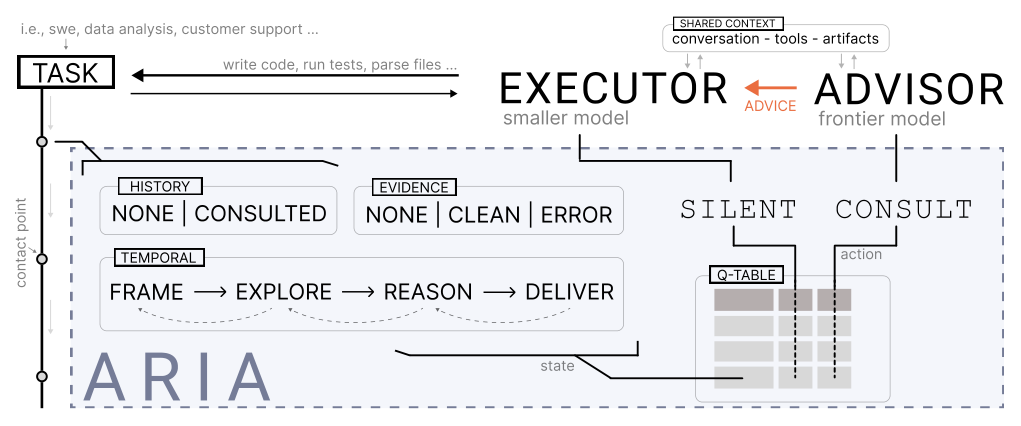
ARIA 는 ETH Zurich 에서 만든 메타 컨트롤러다.
싼 모델(executor)이 에이전트 워크플로를 끝까지 책임지고, 비싼 모델(advisor)은 조언만 하는 구성에서 “언제 물어볼까”만 따로 배운다.
두 LLM 은 손대지 않고, 24개 상태짜리 표(Q-table) 하나를 Monte Carlo 로 채운다.
2026년 10월에 arXiv 에 올라온 논문이고 저자는 6명, 32쪽이다.
코드는 공개되어 있다.
1. Introduction
에이전트 워크플로는 길다.
단계마다 추론·도구 호출·수정이 들어가니 비싼 모델로 끝까지 돌리면 돈이 많이 든다.
그런데 강한 추론이 필요한 순간은 실행 중에 드문드문 나타난다.
지금 있는 비용 절감 방법은 대부분 작업 단위다.
라우팅(RouteLLM 등)은 작업을 보고 어느 모델이 할지 정하고, 적응형 계산은 응답 전에 추론량을 정한다.
실행 도중의 특정 순간에 강한 모델을 끼워 넣는 방법은 아니다.
executor-advisor 구성은 그 자리를 채운다.
싼 모델이 실행을 맡고, 강한 모델이 통제권 없이 조언만 준다.
문제는 “언제 물어보는가”를 executor 자신에게 맡긴다는 점이다.
LLM 은 자기 오류 위치를 못 찾고 확신도도 잘 안 맞는다는 선행 연구를 근거로, 저자들은 이 결정을 executor 에서 떼어낸다.
불확실하다고 꼭 조언이 유용한 것도 아니고, 확신하고 있어도 조언이 효과를 낼 수 있다.
그래서 질문을 바꾼다.
“지금 물어보면 최종 결과가 비용을 상쇄할 만큼 좋아지는가”.
ARIA(Allocation of Reasoning In Agentic systems)는 이 질문을 순차 결정 문제로 두고 tabular Monte Carlo control 로 푼다.
상태는 자기 보고 확신이 아니라 관측 가능한 워크플로 증거에서 만든다.
프레임워크는 Magentic-One 을 쓰되, 컨트롤러가 요구하는 건 “반복되는 결정 지점”뿐이다.
평가는 SWE-bench Verified, Terminal-Bench 2.1, τ2-bench 세 벤치마크다.
Executor-only 와 Advisor-only 를 아래·위 기준점으로 두고, 그 사이에 고정 스케줄·프롬프트·학습·라우팅 방법들을 놓고 비교한다.
2. Related Work
특화·적응형 계산(CodeAct, 추론 모델, test-time compute)은 실행 중 드러나는 증거를 쓰지 않는다.
라우팅·캐스케이딩(RouteLLM, AutoMix, STEER)은 어느 모델이 실행할지를 바꾸고, STEER 는 로짓 기반 확신도라 모델 내부 접근이 필요하다.
외부 조언 쪽은 Anthropic 의 Advisor Strategy, SWE-Protégé 등이 있는데 전자는 언제 물을지를 에이전트에 맡기고 후자는 작은 모델을 학습시킨다.
ARIA 는 조언 자체를 새로 제안하는 게 아니라, 모델은 고정한 채 비용을 반영한 “언제” 정책만 배운다고 자리매김한다.
3. Methodology
executor, advisor, 환경, 워크플로는 전부 고정이다.
배우는 건 “지금 조언을 넣을까”를 정하는 이진 정책 하나다.
3.1 Consultation During the Trajectory
Magentic-One 의 오케스트레이션 이벤트 세 개를 접점(contact point)으로 삼는다.
PRE-STEP 은 다음 executor 지시 직전, STALL 은 진행이 막혀 replanning 이 일어날 때, PRE-DELIVERY 는 최종 제출 직전이다.
접점마다 ARIA 는 SILENT 또는 CONSULT 를 고른다.
CONSULT 면 advisor 가 작업 명세와 현재까지의 궤적을 받아 자연어 평가와 다음 단계 권고를 돌려준다.
오케스트레이터가 이걸 executor 의 다음 지시에 섞어 넣는다.
advisor 는 도구를 실행하지도, 제출하지도 않는다.
PRE-DELIVERY 에서 advisor 가 “틀렸다”고 하면 수정 사이클 한 번을 더 허용한다(Appendix A.1).
학습 신호는 즉각적인 피드백이 아니라 에피소드 끝의 결과다.
3.2 State Abstraction
상태는 세 축의 곱이다.
- 시간 위치 $p_t$: FRAME, EXPLORE, REASON, DELIVER 네 가지
- 실행 증거 $e_t$: NONE, CLEAN, ERROR 세 가지
- 상담 이력 $h_t$: 이미 조언을 받았는지 0/1
곱하면 24개 상태다.
시간 위치는 접점의 순번으로 정한다.
첫 접점이 FRAME, 다음 둘이 EXPLORE, 그 뒤는 REASON, PRE-DELIVERY 는 순번과 상관없이 DELIVER 다.
Pólya 의 문제 풀이 단계에서 이름을 따왔지만, 의미 분류로 읽으면 안 되고 거친 진행도 라벨로 봐야 한다.
실행 증거는 가장 최근 실행 단계의 출력에서 뽑는다.
traceback, 0 이 아닌 exit code, pytest 실패 요약 같은 명시적 신호가 있으면 ERROR, 없으면 CLEAN 이다.
정답 여부가 아니라 실행 상태다.
깨끗한 출력이 틀린 전략을 따르고 있을 수도 있고, 에러가 혼자 고칠 수 있는 것일 수도 있다.
남은 예산은 상태에 넣지 않는다.
예산 B 를 다 쓰면 CONSULT 는 강제로 SILENT 가 된다.
-> 24칸이면 정책 전체를 한 화면에 놓고 읽을 수 있다. 대신 “무슨 에러인지”, “어느 파일을 건드렸는지” 같은 정보는 다 버린다. 저자들도 Appendix A.2 에서 결정에 유용한 정보를 버리는 대가로 재사용성과 해석 가능성을 산다고 쓴다.
3.3 Cost-Aware Policy Learning
중간 보상이 없으니 종료 시점 결과로 배운다.
궤적 τ 의 성공 $Y(\tau) \in {0,1}$ 와 상담 횟수 $N_c(\tau)$ 로 비용 반영 수익을 정의한다.
$\bar{c}$ 는 상담 한 번의 평균 비용, $\Delta$ 는 매 접점마다 상담했을 때의 에피소드당 평균 지출이다.
둘 다 도메인별로 잰다.
이렇게 정규화하면 λ 가 “매번 상담하는 정책의 값을 과제 하나 푼 것 기준으로 환산한 값”이 된다.
상담 한 번당 벌점 $\kappa = \lambda \bar{c}/\Delta$ 는 SWE-bench 0.029, Terminal-Bench 0.024, τ2-bench 0.019 다(Appendix A.3, λ=0.10 기준).
예산 제약 하의 성공 최대화를 라그랑주 완화한 꼴이라고 설명한다.
학습은 every-visit tabular Monte Carlo control 에 표본 평균 업데이트다.
접점 t 의 방문에는 “성공 여부 − t 이후 상담 벌점 합”이 수익으로 붙는다.
γ=1 인데, 할인을 두면 종료 결과가 상담 비용보다 작아져 늦게 상담하는 쪽으로 치우치기 때문이다.
ε-greedy 로 탐색하고(0.40 에서 0.10 으로 110 에피소드에 걸쳐 선형 감소), 종료 결과까지 간 에피소드만 표를 갱신한다.
평가 때는 표를 얼려 greedy 로 돌리고, 동점이나 안 가본 상태는 SILENT 다.
4. Experiments
executor 는 gemini-3-flash-preview(낮은 추론 노력), advisor 는 gemini-3.1-pro-preview(높은 추론 노력)다.
같은 계열을 쓴 이유는 배포 행동 차이를 줄이기 위해서다.
벤치마크는 셋이다.
SWE-bench Verified 는 학습 50, 테스트 50(Verified-Mini).
Terminal-Bench 2.1 은 학습 27, 테스트 50.
τ2-bench telecom 은 학습 20, 테스트 40.
학습·테스트는 과제 ID 로 겹침 없음을 확인했다.
상담 조건은 에피소드당 최대 B=4 회다.
비교 조건은 열 개다.
Executor-only 와 Advisor-only 는 능력 범위의 양 끝이다.
FrugalGPT(점수 기반 캐스케이드), RouteLLM(실행 전 라우팅), AutoMix(자기 검증 후 승격)는 작업 단위 할당이다.
Plan 은 첫 접점에서만 묻고, Heuristic 은 Anthropic 이 권하는 시작·끝·막힘 트리거이고, Always 는 예산이 남는 한 매 접점마다 묻는다.
LLM-Router 는 Magentic-One 의 오케스트레이터 LLM 이 advisor 를 화자로 고르게 한다.
Random 은 ARIA 의 상담 횟수에 맞춘 확률로 동전을 던진다.
타이밍 효과와 “그냥 advisor 를 썼다”는 효과를 떼어내는 통제군이다.
λ 는 기본 0.10 이고 0.35, 0.50 은 같은 학습 궤적에서 수익만 다시 계산한 오프라인 재추정이다.
지표는 RouteLLM 을 따라 PGR(performance gap recovered, executor-advisor 성공률 격차 중 회수한 비율)과 CostShare(비용을 같은 양 끝으로 정규화한 값)를 쓴다.
둘의 차 ER(excess recovery)이 양수면 두 모델을 단순히 섞는 것보다 나은 trade-off 라는 뜻이다.
실패 분석에는 MAST(Multi-Agent System Failure Taxonomy, 14개 실패 모드를 시스템 설계·에이전트 간 불일치·검증 실패 세 범주로 묶은 분류)를 LLM 판정으로 붙이고 사람이 일부 검증한다.
5. Results
세 벤치마크에서 열한 조건의 성공률·비용·ER 을 세 seed 평균으로 잰 표다.
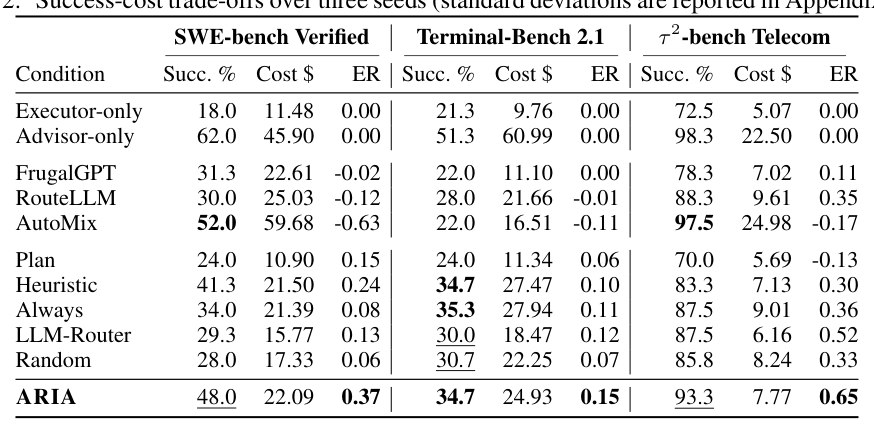
SWE-bench 에서 Executor-only 는 18.0% 에 $11.48, Advisor-only 는 62.0% 에 $45.90, ARIA 는 48.0% 에 $22.09 다.
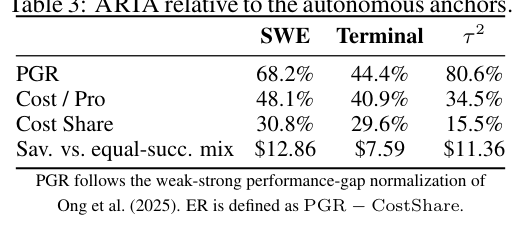
PGR 은 SWE 68.2%, Terminal 44.4%, τ2 80.6% 이고 비용은 Advisor-only 의 48.1%, 40.9%, 34.5% 다.
ER 은 0.37, 0.15, 0.65 로 모든 조건 중 가장 높다.
같거나 낮은 비용으로 더 높은 성공률을 낸 조건도, 같거나 높은 성공률로 더 싼 조건도 없어서 평가된 조건들 안에서는 Pareto 경계 위에 있다.
작업 단위 할당과는 결과가 다르다.
SWE-bench 에서 FrugalGPT, RouteLLM, AutoMix 의 ER 은 −0.02, −0.12, −0.63 이다.
RouteLLM 과 ARIA 는 비용이 비슷한데($25.03 vs $22.09) 성공률은 30.0% 와 48.0% 다.
τ2-bench 에서 AutoMix 는 97.5% 를 찍지만 $24.98 로 Advisor-only 보다 비싸다.
Always 는 같은 B=4 예산에서 SWE-bench 비용이 ARIA 와 거의 같은데($21.39) 14.0 포인트 낮다.
Terminal-Bench 에서는 Always 가 0.6 포인트 높고 비용은 12% 더 든다.
-> Terminal-Bench 는 세 벤치마크 중 ARIA 의 우위가 가장 약하다. Heuristic 과 성공률이 같고(34.7%), Always 보다 조금 낮다. seed 표준편차가 5.0 포인트라(Appendix C.1) 이 차이들은 저자도 통계적 분리라고 보지 않는다.
5.1 Placement Matters Beyond Advisor Access and Volume
상담 횟수가 비슷해도 결과가 다르다.
SWE-bench 에서 Random, Heuristic, ARIA 는 에피소드당 2.53, 2.75, 2.78 번 상담하는데 성공률은 28.0%, 41.3%, 48.0% 다.
같은 양의 조언을 어디에 넣느냐로 20 포인트가 갈린다.
Terminal-Bench 에서는 Heuristic 과 ARIA 가 둘 다 34.7% 이고 ARIA 가 9.2% 싸다.
τ2-bench 에서는 ARIA 93.3% 대 Random 85.8% 인데, Random 의 상담량이 ARIA 의 87.8% 라 정확히 맞춘 비교는 아니다.
조언이 많다고 꼭 좋은 것도 아니다.
Always 의 예산을 B=10 으로 올리면 SWE-bench 는 20.7 포인트 오르고 ER 도 ARIA 근처(0.36)까지 가지만, 상담량이 ARIA 의 두 배 가까이 되고 비용도 $6.42 더 든다.
Terminal-Bench 는 4.0 포인트 오르는데 ER 은 그대로이고, τ2-bench 는 오히려 2.5 포인트 떨어진다.
오케스트레이터 LLM 에 맡기면(LLM-Router) 거의 안 묻고 늦게 묻는다.
에피소드당 0.41, 0.61, 0.48 번이다.
묻는 시점은 ARIA 와 비슷한 단계지만 훨씬 뒤로 몰린다.
마지막 1/3 구간에 77%, 64%, 76% 가 몰리는데 ARIA 는 47%, 25%, 7% 다.
5.2 Consultation Price Controls the Operating Point
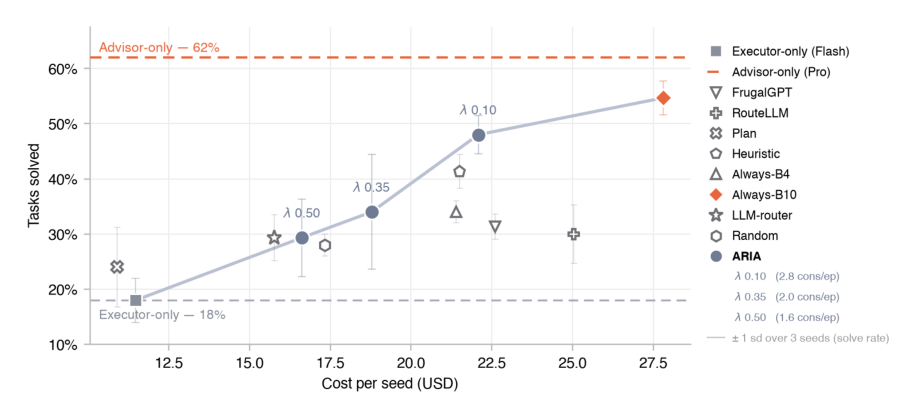
SWE-bench 에서 λ 를 0.10, 0.35, 0.50 으로 올리면 상담이 2.78, 2.03, 1.55 회로 줄고 비용은 $22.09, $18.78, $16.63 으로 내려간다.
성공률은 48.0%, 34.0%, 29.3% 다.
싼 정책이 더 효율적인 건 아니다.
ER 이 0.37 에서 0.15, 0.11 로 떨어진다.
추가 상담이 비용 증가분보다 성능을 더 회수하므로 λ=0.10 이 시험한 값 중 ER 이 가장 높은 지점이다.
세 정책은 같은 학습 궤적에서 재추정한 것이라, 각 λ 에서 독립적으로 다시 학습한 결과가 아니라는 점을 저자들이 반복해서 적는다.
5.3 Learned Allocation Differs Across Workflow Domains
얼린 정책표를 보면 상담은 소수 상태에 몰린다.
24개 상태 중 CONSULT 를 고르는 상태는 정책마다 4~9개다.
나머지 상태도 대부분 방문 경험이 있고, 값을 비교한 결과로 조용히 있는다.
τ2-bench 에서 학습 중 한 번도 못 본 상태는 전부 ERROR 증거 상태다.
대화와 도구 호출 위주라 실수가 의미·절차 수준에 머물고 명시적 에러가 안 나기 때문이다.
어디에 몰리는지는 벤치마크마다 다르다.
SWE-bench 에서는 실제 advisor 호출의 53.5% 가 DELIVER 단계다.
τ2-bench 에서는 82.2% 가 REASON 단계다.
Heuristic 은 시작 전·끝 선언 전·막힘 때 묻는 범용 규칙인데 이 분포와 안 맞는다.
그래서 SWE-bench 에서 6.7 포인트, τ2-bench 에서 10.0 포인트 뒤지고 Terminal-Bench 에서만 동률이다.
범용 규칙은 좋은 출발점이고 벤치마크별 학습이 그 위에 더 얹는다는 게 저자들의 해석이다.
부록 C.4 를 보면 아홉 개 정책(벤치마크 3 × seed 3) 중 여덟 개가 공통으로 CONSULT 를 고르는 상태가 하나 있다.
DELIVER, 증거 CLEAN, 이미 한 번 상담한 상태다.
-> seed 간 합의가 낮다는 건 24칸짜리 표도 150 에피소드로는 안정적으로 못 채운다는 뜻이다. 그 와중에 “제출 직전에 한 번 더 검토받기”만 세 벤치마크에서 다 살아남았다.
5.4 Failure Analysis Reveals Mechanism and Scope
실패한 궤적에 MAST 주 실패 모드를 붙인 결과다.
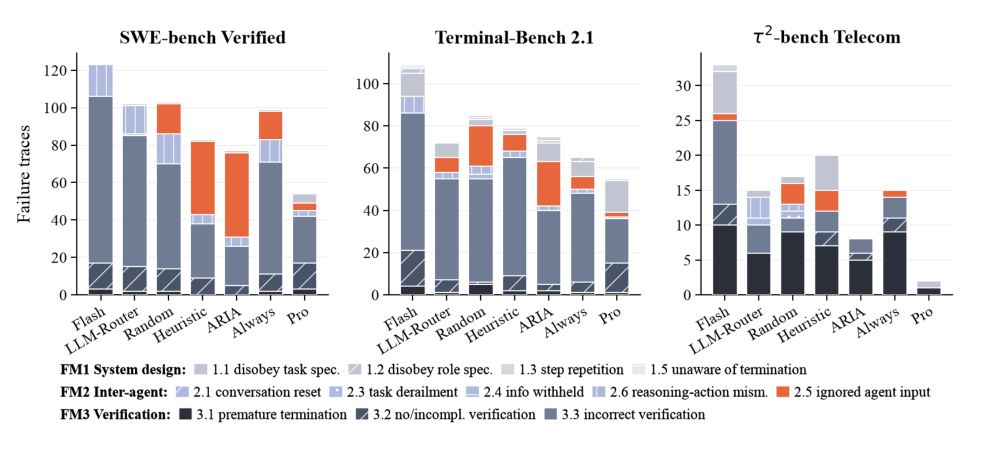
SWE-bench 에서 Executor-only 실패의 86% 는 검증 실패다.
상담 배치가 정교해질수록 이 비중이 준다.
Random 68%, Heuristic 46%, ARIA 34% 다.
LLM-Router 는 같은 advisor 를 쓰는데도 83% 로 혼자 할 때와 비슷하다.
절대 수로는 ARIA 에 26건, Random 에 70건 남는다.
검증 실패가 줄자 다른 병목이 나온다.
“무시된 에이전트 입력”(FM-2.5)이 ARIA 의 SWE-bench 실패 중 58% 를 차지한다.
LLM-Router 에서는 0%, Random 16%, Heuristic 47%, Always-B10 71% 다.
MAST 원 데이터에서는 이 모드가 1.9% 인데 여기서는 17.3% 다.
사람이 검증한 결과, 관련 조언이 executor 에 도달했지만 행동에 반영되지 않은 경우가 맞다(Appendix C.6).
배치와 수용은 다른 문제다.
ARIA 는 조언의 하류 가치가 높은 지점을 배울 수는 있지만 executor 가 그 조언을 따르게 만들지는 못한다.
SWE-bench DELIVER 단계는 무시율이 36~40% 로 가장 높은데도 ARIA 는 거기서 자주 묻는다.
τ2-bench 에서는 무시율이 7% 미만이다.
Terminal-Bench 에서 ARIA 와 Heuristic 은 성공률이 같지만 각자 상대가 못 푼 12개를 푼다.
남은 실패도 다르다.
검증 실패 비중이 ARIA 53%, Heuristic 82% 다.
같은 헤드라인 숫자 뒤에 다른 과제, 다른 한계가 있다.
MAST 프로파일은 모델 단독이 아니라 상호작용 방식까지 포함한 시스템 전체의 속성으로 읽어야 한다는 말로 절을 맺는다.
-> “Placement and uptake are therefore distinct problems” 가 이 논문에서 가장 쓸모 있는 문장이다. 조언을 넣을 자리를 잘 골랐더니, 조언을 받고도 안 고치는 executor 가 병목으로 드러났다.
6. Discussion and Limitations
상담 타이밍이 접근 권한이나 횟수보다 중요하다는 게 결론이다.
이득은 비슷한 결정 지점이 과제 간에 반복될 때 크고, Terminal-Bench 처럼 이질적인 과제에서는 작다.
그래서 상담 정책은 서로 다른 과제 유형을 가로질러서보다 관련된 워크플로 안에서 배우는 게 유용하다고 본다.
실험은 모델 쌍 하나, 프레임워크 하나(Magentic-One)다.
저자들은 이걸 한계로 적으면서 다른 모델 쌍·구성·프레임워크를 연구할 테스트베드로 내놓는다.
본문에 안 적힌 한계도 부록에 있다.
SWE-bench 와 Terminal-Bench 의 학습 과제는 두 모델 중 하나라도 푼 과제만 남긴 것이라 결과를 보고 고른 집합이다.
Terminal-Bench 테스트 50개 중 15개(30%)는 어느 모델도 못 푼 과제인데 학습 집합엔 그런 과제가 없다.
저자들은 이 비대칭이 평가 비용을 낮추는 쪽으로 작용하지는 않는다고 쓴다.
테스트 집합은 50, 50, 40 과제이고 seed 간 성공률 표준편차는 3.5, 5.0, 2.9 포인트다.
MAST 판정 모델이 advisor 와 같은 계열이라 40개를 사람이 검증했고 주 라벨 일치는 87.5% 다.
τ2-bench 의 사용자 시뮬레이터 비용($48.26)은 보고된 비용에 안 들어 있다.
7. Conclusion
ARIA 는 세 벤치마크에서 executor-advisor 격차의 44~81% 를 Advisor-only 비용의 절반 이하로 회수하고 ER 이 가장 높았다.
파인튜닝도 모델 내부 접근도 필요 없고, 정책은 λ 하나로 trade-off 를 조절하는 읽을 수 있는 표다.
실패 분석은 조언 수용을 다음 개선 지점으로 지목한다.
8. 지금 관점: 휴리스틱으로 시작해 어디까지 갈까
앞에서 본 Harness Benefit에서는 스킬을 잘 만드는 능력과 스킬로 득을 보는 능력이 달랐다.
이 논문은 같은 구도를 조언에서 본다.
조언을 넣을 자리를 고르는 능력과 조언을 받아 고치는 능력이 다르고, 앞을 잘하면 뒤가 병목으로 올라온다.
RBC가 플레이북에 무엇을 남길지를 에이전트 판단 대신 무작위 실험으로 정했듯, 여기서도 “언제 물을까”를 LLM 의 자기 평가에서 떼어내 결과 데이터로 정한다.
LLM-Router 조건이 그 근거다.
전체 ledger 를 다 보는 오케스트레이터도 에피소드당 0.5번 남짓만 묻고, 그마저 막판에 몰린다.
지금 바로 가져다 쓸 수 있는 건 학습된 표 자체보다 그 표가 보여준 모양이다.
아홉 정책 중 여덟이 “제출 직전, 에러 없음, 이미 한 번 물어봤음” 상태에서 CONSULT 를 골랐다.
즉 Anthropic 식 시작·끝·막힘 휴리스틱 중 “끝” 트리거는 세 도메인에서 다 살아남았고, 시작 트리거는 SWE-bench 에서 0/3 이다.
PRE-DELIVERY 에서 강한 모델에게 한 번 검토받고 수정 사이클 하나를 허용하는 구성은 학습 없이도 넣을 수 있다.
그다음에 할 일은 ARIA 를 그대로 구현하는 것보다 자기 워크플로의 접점을 정의하고 상담 횟수·결과 로그를 남기는 쪽이 먼저다.
표가 24칸이어도 150 에피소드로는 seed 마다 다르게 채워졌다는 걸 보면, 작은 도메인에서는 로그를 보고 사람이 규칙을 고치는 게 Monte Carlo 보다 빠를 수 있다.
그대로 받아들이기 어려운 부분도 있다.
Terminal-Bench 에서 ARIA 는 Heuristic 과 동률이고 Always 보다 0.6 포인트 낮으니, 과제가 이질적이면 학습의 이득이 seed 편차 안에 묻힌다.
학습 집합은 결과를 보고 고른 것이고 테스트는 50개짜리다.
모델 쌍이 Gemini flash/pro 하나라 다른 계열, 특히 executor 가 조언을 더 잘 따르거나 덜 따르는 모델에서 무시율 58% 가 어떻게 바뀔지는 원문에서 확인 못 함.
그리고 PRE-DELIVERY 에서 무시율이 가장 높은데도 거기서 묻는 게 최적이라는 결과는, 조언을 강제로 반영하게 하는 장치(예: advisor 가 “틀렸다”면 제출을 막는 규칙)를 붙이면 숫자가 꽤 달라질 수 있다는 뜻이기도 하다.
그 장치는 이 논문의 범위 밖이다.
Leave a comment