
Harness Benefit Paper review
Harness Updating Is Not Harness Benefit: Disentangling Evolution Capabilities in Self-Evolving LLM Agents
https://arxiv.org/abs/2605.30621
이 논문은 Pennsylvania State University, UC Santa Cruz, Amazon 등에서 만든 분석 연구다.
저자가 17명이고, 2026년 5월 28일 arXiv에 올라온 논문이다.
모델 가중치는 그대로 두고 프롬프트·스킬·메모리 같은 바깥쪽 harness를 고쳐 가는 자기진화 에이전트에서, “갱신을 만드는 모델”과 “갱신으로 득을 보는 모델”을 따로 떼어 잰다.
앞에서 본 Voyager가 성공한 행동을 스킬로 저장하는 쪽이었다면, 이 논문은 그 저장이 누구한테 얼마나 도움이 되는지를 묻는다.
1. Introduction
LLM 에이전트는 모델 하나로 돌지 않는다.
프롬프트·스킬·메모리·도구로 이루어진 harness 위에서 돈다.
논문은 이 harness를 “모델 파라미터를 바꾸지 않고 실행 방식을 정하는, 편집 가능한 바깥쪽 상태”로 정의한다.
사람이 손으로 짠 harness는 배포 환경에서 잘 깨진다.
과제 분포가 바뀌고, 엣지 케이스가 나오고, 쓸 만한 절차는 실제 과제를 돌려 본 뒤에야 보인다.
그래서 실행 증거(실패, 피드백, 궤적, 성공한 절차)를 harness에 다시 써 넣는 방식이 나왔고, 논문은 이를 harness self-evolution 이라 부른다.
갱신을 만드는 LLM 역할을 evolver 라 부른다.
지금까지의 평가는 end-to-end 질문 하나였다.
“이 자기진화 방법이 에이전트 성능을 올리는가”.
논문은 이 질문이 개선의 출처를 숨긴다고 본다.
점수가 오른 게 evolver가 좋은 갱신을 만든 덕인지, 과제를 푸는 에이전트가 갱신을 잘 써먹은 덕인지 구분이 안 된다.
그래서 두 능력을 따로 정의한다.
harness-updating 은 실행 증거에서 쓸모 있는 갱신을 만드는 능력이다.
harness-benefit 은 갱신된 harness로 과제를 더 잘 푸는 능력이다.
한 모델은 evolver로 쓰일 때 앞의 능력을, 과제 해결 에이전트로 쓰일 때 뒤의 능력을 쓴다.
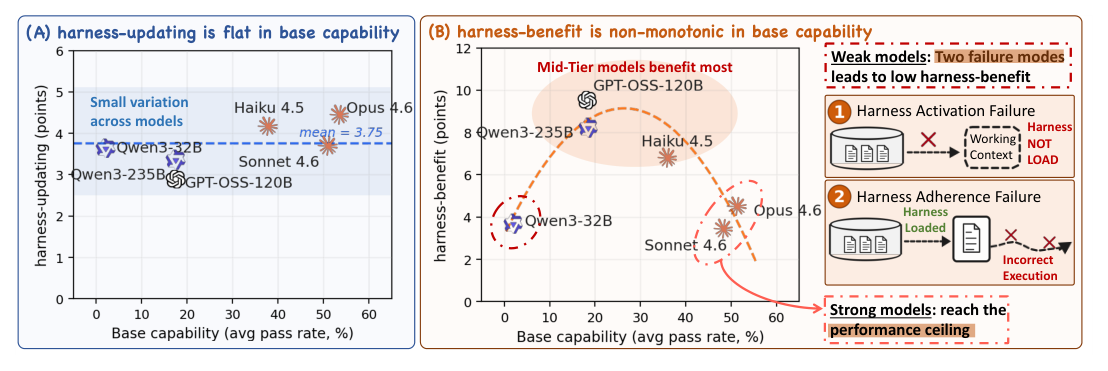
7개 LLM을 에이전트와 evolver 양쪽에 짝지어 3개 벤치마크에서 돌린 결과, 두 가지 어긋남이 나온다.
첫째, 갱신 능력은 base 능력(진화 없이 과제를 푸는 능력)과 무관하게 평평하다.
Qwen3.5-9B가 만든 갱신도 Claude Opus 4.6이 만든 갱신과 비슷한 이득을 낸다.
둘째, 득을 보는 능력은 base 능력에 대해 단조롭지 않다.
중간 체급(GPT-OSS-120B 등)이 가장 많이 득을 보고, 강한 모델은 천장에 닿아 덜 득을 본다.
약한 모델(Qwen3-32B 등)은 올라갈 여지가 가장 큰데도 가장 적게 득을 본다.
그 이유로 두 가지 실패 유형을 든다.
harness를 컨텍스트에 불러오지 못하는 activation failure 와, 불러왔는데도 따르지 못하는 adherence failure 다.
여기서 설계 지침 셋이 나온다.
능력 예산은 evolver보다 과제 해결 에이전트에 쓸 것.
harness 호출을 학습 대상으로 넣을 것.
긴 궤적에서의 지시 준수를 강화할 것.
2. Related Work
harness engineering 쪽은 프롬프트, 도구, 메모리, 스킬, 코드 등 어떤 산출물을 에이전트에 노출하느냐로 갈린다.
자기진화 쪽은 Reflexion, Self-Refine 같은 에피소드 단위 언어 피드백에서 출발해, 최근에는 프롬프트·메모리·스킬·도구 자체를 갱신 단위로 삼는다.
논문은 이 계열의 평가가 “갱신 절차 하나 + 에이전트 하나 + 벤치마크 하나”의 end-to-end 점수를 보고하기 때문에, base 능력·갱신 능력·득 능력 세 가지가 섞인다고 본다.
여기서는 에이전트와 evolver를 독립적으로 바꿔 가며 두 능력을 따로 잰다.
3. Harness-Evolution Capabilities
3.1 Preliminaries: Harness State and Evolver
진화 단계 $t$에서 에이전트는 $A_t = (f, H_t)$ 로 쓴다.
$f$는 고정된 모델 백본, $H_t$는 $t$단계 이후의 harness 상태다.
갱신 대상은 프롬프트·스킬·메모리 같은 편집 가능한 부분이고, 도구 인터페이스와 실행 정책은 고정한다.
evolver $e$는 직전 harness $H_{t-1}$과 누적 실행 증거 $D_t$를 받아 갱신 $\Delta H_t = e(H_{t-1}, D_t)$ 를 내고, 이를 적용해 $H_t$를 만든다.
3.2 Evolution Protocol
과제 풀기와 harness 갱신을 번갈아 도는 루프다.
초기 harness $H_0$에서 시작해 $T$단계를 돈다.
각 단계에서 에이전트 $A_{t-1}$이 과제 배치 $X_t$를 풀고, 궤적 $\tau$와 최종 출력 $y$를 낸다.
이 (과제, 궤적, 출력) 묶음이 실행 증거 $D_t$가 되고, evolver가 이걸로 $H_t$를 만든다.
3.3 Capability Metrics
세 가지를 잰다.
base 능력 $M_{base}(f)$는 초기 harness $H_0$로 과제 집합 $X$를 풀었을 때의 성능이다.
에이전트 $f$와 evolver $e$ 짝의 진화 이득 $\Delta(f,e)$는, $T$단계 진화 후 harness로 푼 성능에서 base 성능을 뺀 값이다.
harness-updating 능력 $\Delta_{update}(e)$는 고정된 anchor 에이전트 집합 $F^\star$에 대해 $\Delta(f,e)$를 평균한 값이다.
harness-benefit 능력 $\Delta_{benefit}(f)$는 고정된 anchor evolver 집합 $E^\star$에 대해 $\Delta(f,e)$의 최댓값이다.
-> updating은 평균, benefit은 최댓값이다. benefit을 최댓값으로 잡으면 anchor evolver 셋 중 하나만 잘 맞아도 점수가 올라간다. 약한 모델의 benefit이 낮다는 결론에는 유리한 정의인데, 평균 대신 최댓값을 고른 이유는 본문에 설명이 없다.
4. Experiments
4.1 Experimental Setup
벤치마크는 셋이다.
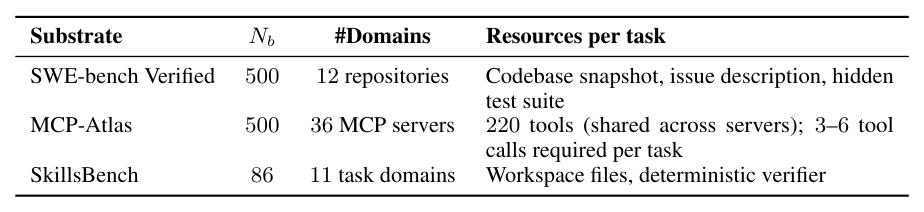
SWE-bench Verified(SWE, 실제 GitHub 이슈를 패치로 고치는 소프트웨어 엔지니어링 벤치마크, 500개), MCP-Atlas(MCP, 실제 MCP 서버 36개·도구 220개 위에서 3~6번의 도구 호출로 과제를 푸는 벤치마크, 500개), SkillsBench(SB, 11개 도메인에서 스킬을 써서 과제를 푸는 벤치마크, 86개)다.
세 벤치마크의 구성은 아래 표에 있다.
모델은 7개다.
Claude Opus 4.6, Claude Sonnet 4.6, Claude Haiku 4.5, Qwen3-235B-A22B, Qwen3-32B, GPT-OSS-120B 여섯이 에이전트 쪽 분석에 쓰이고, evolver 쪽 분석에는 여기에 가장 작은 Qwen3.5-9B를 더한다.
지표는 pass rate 다.
SWE는 과제별 0/1, MCP는 최종 답이 기준 claim을 모두 만족하면 pass, SB는 과제당 5회 시도 평균이다.
평가는 in-situ 방식이다.
진화를 돌리는 과제 스트림이 곧 평가 집합이다.
단계 $t$의 과제는 직전 harness $H_{t-1}$로 점수를 매기고, 그 점수를 잠근 뒤에야 그 과제의 궤적이 증거로 들어간다.
그래서 한 과제의 점수가 그 과제에서 나온 갱신의 영향을 받지는 않는다.
-> 다만 같은 스트림 안에서 앞 과제가 뒤 과제의 harness를 만드니, 과제 순서와 유사 과제의 밀도가 결과에 들어간다. 별도 held-out 평가는 없다.
구현은 solve-evolve 루프 하나로 고정한다.
에이전트와 evolver의 프롬프트 템플릿, 궤적 윈도우, 초기 harness, 과제 스트림, 진화 예산, 과제당 턴 제한을 모든 짝에서 같게 두고 백본만 바꾼다.
갱신 가능한 부분은 SWE와 SB에서는 스킬 디렉터리만, MCP에서는 스킬·프롬프트·append-only 메모리다.
evolver 시스템 프롬프트는 부록 Table 10에 있고, “작고 재사용 가능한 갱신을 선호하라”, “평가 스크립트·모델 가중치는 건드리지 말라” 정도의 일반 지시다.
4.2 Evolver-side Analysis
에이전트를 Opus 4.6, Sonnet 4.6, Qwen3-235B 셋으로 고정하고 evolver를 7개로 바꿔 가며 $\Delta_{update}$를 잰다.
아래는 벤치마크별 evolver의 갱신 능력이다.
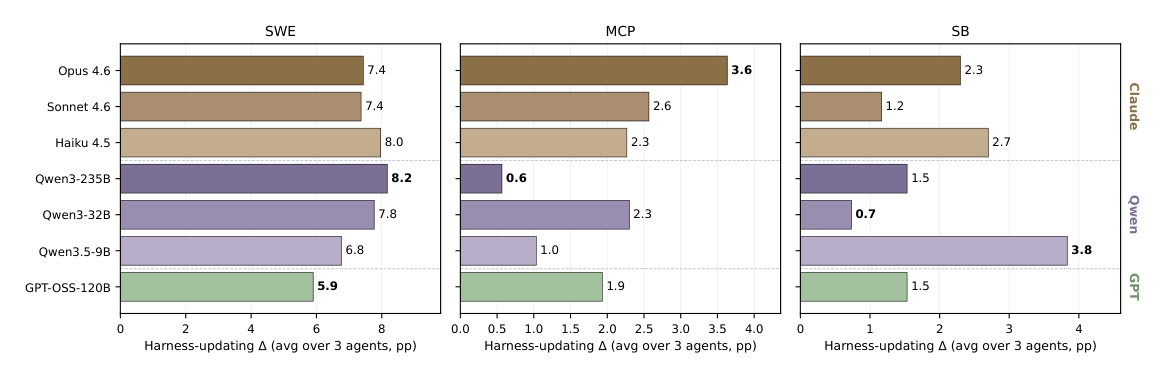
Observation 1은 갱신 능력이 base 능력과 무관하게 평평하다는 것이다.
벤치마크 안에서 가장 좋은 evolver와 가장 나쁜 evolver의 차이는 3.1pp를 넘지 않는다.
벤치마크를 넘어 이기는 모델도 없다.
Qwen3-235B는 SWE에서 1등(8.2pp)이지만 MCP에서 꼴찌(0.6pp)다.
모델 크기도 예측력이 없다.
가장 작은 Qwen3.5-9B가 SB에서 3.8pp로 1등이고, Opus 4.6(2.3pp)과 Qwen3-235B(1.5pp)를 앞선다.
사례로 SB의 flink-query 과제를 든다.
에이전트를 Opus 4.6으로 고정하고 evolver 없음, Qwen3.5-9B, Opus 4.6 세 조건을 비교한다.
스킬이 없으면 에이전트가 FINISH 이벤트 필터를 빠뜨려 0.67점에 그친다.
어느 쪽이 쓴 스킬이든 넣으면 1.0점이 된다.
두 스킬은 같은 다섯 단계를 처방하고, 구현 세부(세션 윈도우를 배치로 자를지 KeyedProcessFunction을 쓸지)와 장황함만 다르다.
논문은 이를 procedurally isomorphic 이라 부른다.
Observation 2는 진화 후 점수가 evolver보다 에이전트의 base 능력에 좌우된다는 것이다.
MCP에서 한 에이전트가 7개 evolver 아래서 보이는 점수 폭은 최대 5.1pp(Qwen3-235B)인데, Opus와 Qwen3-235B의 base 차이는 36.0pp다.
가장 약한 anchor 에이전트에 가장 잘 맞는 evolver를 붙이고 가장 강한 에이전트에 가장 안 맞는 evolver를 붙여도, 강한 에이전트가 모든 벤치마크에서 18.6~35.2pp 앞선다.
세 벤치마크, 세 anchor 에이전트, 7개 evolver의 전체 pass rate는 아래 표에 있다.
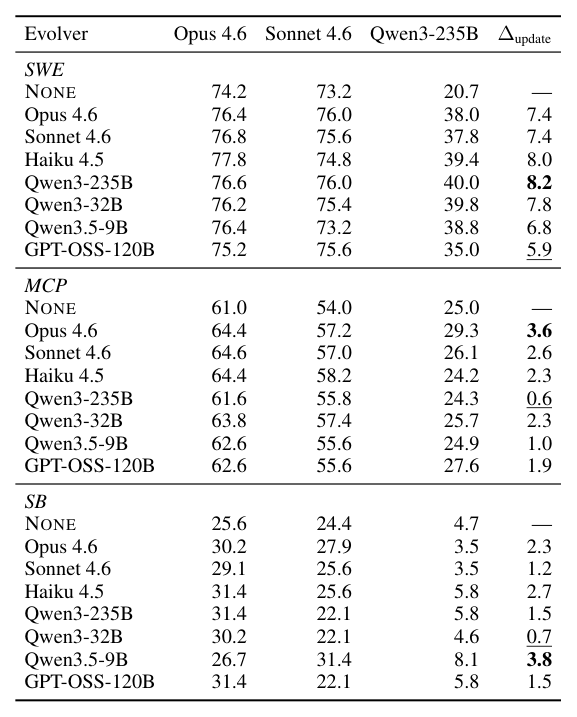
표를 보면 SB에서 Qwen3.5-9B는 Opus 에이전트에게는 가장 나쁜 evolver(26.7)이면서 Qwen3-235B 에이전트에게는 가장 좋은 evolver(8.1)다.
같은 갱신이 받는 쪽에 따라 다르게 작동한다.
-> 평균 3.8pp라는 숫자 뒤에 이런 편차가 있다. SB는 과제가 86개뿐이라 한두 과제 차이가 pp로 크게 보이는 점도 같이 봐야 한다.
Take-away는 능력 예산을 evolver 대신 과제 해결 에이전트에 쓰라는 것이다.
4.3 Agent-side Analysis
이번에는 evolver를 Opus 4.6, Sonnet 4.6, Qwen3-235B 셋으로 고정하고 에이전트를 6개로 바꿔 $\Delta_{benefit}$을 잰다.
아래는 벤치마크별 base pass rate와 득, 그리고 SWE에서 base 대비 득을 그린 그림이다.
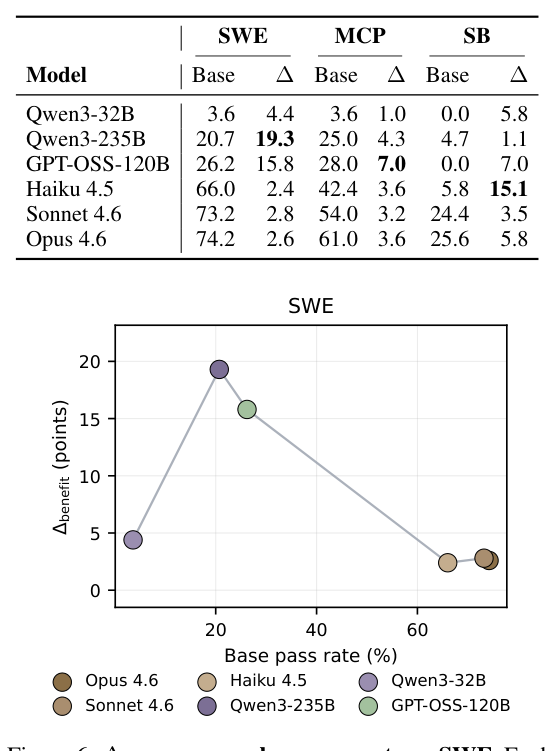
Observation 1은 득이 base 능력에 대해 단조롭지 않다는 것이다.
SWE에서 득은 Qwen3-235B에서 19.3pp로 정점이고, 더 약한 Qwen3-32B는 4.4pp, 더 강한 Opus 4.6은 2.6pp다.
MCP에서는 정점이 GPT-OSS-120B(7.0pp)로 옮겨 가지만 양 끝이 낮은 모양은 같다.
강한 쪽이 낮은 건 천장 효과로 설명된다.
약한 쪽이 낮은 건 다른 병목이고, 이걸 SB에서 파고든다.
부록 D.2를 보면 SB는 base가 0에 가까운 모델이 여럿이라 저점 구간이 더 흔들린다.
Haiku 4.5가 15.1pp로 가장 크고 Qwen3-235B는 비슷한 base에서 1.1pp에 그친다.
논문도 SWE와 MCP가 비단조 패턴의 가장 깨끗한 증거이고 SB는 변동이 크다고 적는다.
Observation 2는 약한 모델이 두 가지 실패 유형 때문에 득을 못 본다는 것이다.
첫째는 activation failure 다.
SB에서 스킬 로드율 SLR(궤적 중 스킬을 하나라도 컨텍스트에 불러온 비율)을 재면, Opus·Sonnet·Qwen3-235B는 0.957~0.961인데 GPT-OSS-120B는 0.446, Qwen3-32B는 0.251이다.
Qwen3-32B는 어떤 스킬이 필요한지는 알아보는데, 로드 요청을 analysis·plan과 함께 한 JSON에 묶어 낸다.
SB 환경은 단일 키 액션만 받으므로 이걸 거부하고, 스킬 본문은 컨텍스트에 들어가지 못한다.
둘째는 adherence failure 다.
스킬이 로드된 궤적만 모아, LLM 판정자(Claude Sonnet 4.6)가 스킬 지시를 따랐는지 판단한 비율을 HFR(Harness-Following Rate)이라 한다.
Opus 4.6은 0.757, Qwen3-32B는 0.142다.
로드가 충분조건이 아니라는 걸 Qwen3-235B가 보여 준다.
로드율은 0.961로 Opus와 같은데 HFR은 0.350이고, 로드했을 때의 pass rate(LPR)도 0.022로 Opus의 0.177과 크게 벌어진다.
두 실패의 실제 궤적은 아래 그림에 있다.
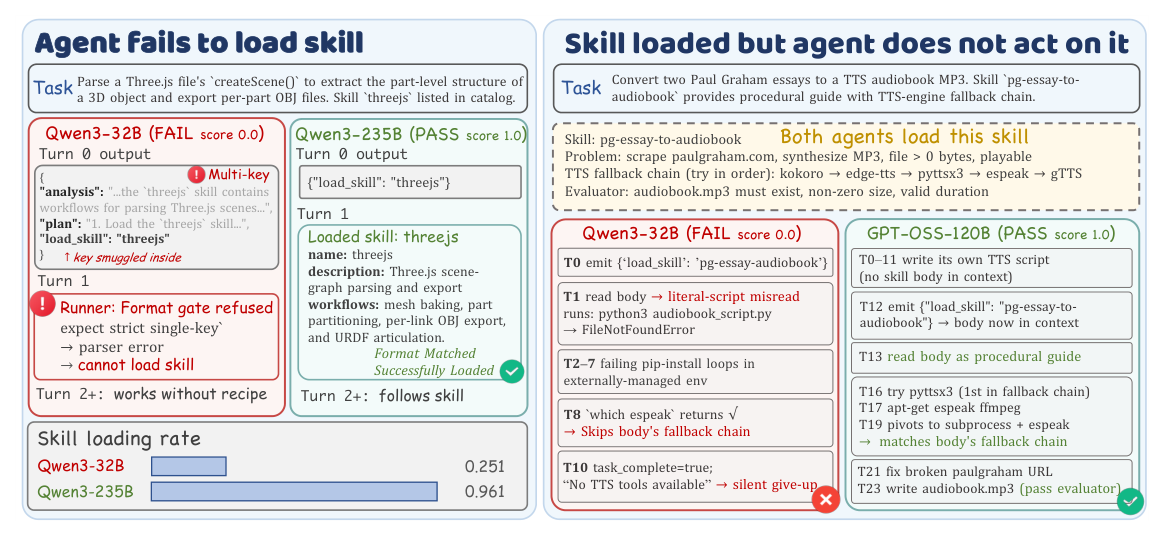
오른쪽 사례에서 Qwen3-32B는 스킬을 “따라야 할 절차”가 아니라 “그대로 실행할 스크립트”로 읽는다.
첫 단계에서 FileNotFoundError가 나자 스킬이 적어 둔 TTS fallback 체인(kokoro, edge-tts, pyttsx3, espeak, gTTS 순)을 시도하지 않고, 10턴째에 task_complete를 내고 끝낸다.
반면 GPT-OSS-120B는 처음 11턴을 스킬 없이 헤매다가 12턴에 로드한 뒤 체인을 따라가서 통과한다.
부록 D.1은 이를 “weak-tier models do not fail to read the harness, they fail to operate under it.” 라고 정리한다.
Diagnosis 절에서는 준수가 궤적을 따라 떨어지는지를 본다.
LLM 판정자가 harness 로드 직후, 중간, 최종 검증 세 시점에서 0~1 준수 점수를 매긴다.
Qwen3-32B는 0.52에서 0.13으로, GPT-OSS-120B는 0.67에서 0.43으로, Opus 4.6은 0.89에서 0.80으로 간다.
약한 모델은 로드 시점에 잘못 읽은 게 아니라 진행하면서 점점 지시를 잃는다.
논문은 이를 긴 궤적에서의 instruction following 병목이라 부른다.
-> HFR과 단계별 점수 모두 Sonnet 4.6 한 모델의 판정이다. 같은 Claude 계열인 Opus·Sonnet에 유리한 편향이 있는지는 원문에서 확인 못 함. 모델명은 가린다고 했지만 문체는 남는다.
Take-away는 에이전트 학습 목표 둘이다.
harness 호출을 학습에 넣을 것, 긴 궤적에서의 지시 준수를 강화할 것.
5. Conclusion
harness self-evolution을 갱신 능력과 득 능력으로 나눠 7개 모델, 3개 벤치마크에서 쟀다.
갱신 능력은 base 능력과 무관하게 평평하고, 9B evolver도 Opus 4.6 evolver와 비슷한 이득을 낸다.
득 능력은 비단조이고, 약한 모델은 활성화와 준수 두 실패로 득을 못 본다.
예산은 evolver보다 에이전트에, 학습은 harness 호출과 긴 지시 준수에 쓰라는 게 결론이다.
6. Limitations
가중치를 고치는 fine-tuning, RL, 가중치 갱신과 harness 갱신을 섞는 하이브리드는 다루지 않는다.
모델 7개는 대표적이지만 전부는 아니고, 모델 계열·크기·학습 레시피·배포 비용에 따라 두 능력이 어떻게 변하는지는 더 넓은 격자가 필요하다고 적는다.
-> 논문이 안 적은 한계도 있다. evolver 프롬프트는 하나로 고정이고 진화 예산도 같다. 9B가 Opus만큼 한다는 결론은 “이 프롬프트, 이 예산, 이 세 벤치마크에서”라는 조건이 붙는다. 또 benefit의 정점이 SWE에서는 Qwen3-235B, MCP에서는 GPT-OSS-120B로 다르니 “중간 체급”이 어디인지는 벤치마크마다 다르다.
7. Ethics Statement
실험은 벤치마크 과제로만 했고 개인 데이터는 쓰지 않았다.
다만 갱신된 harness가 이후 과제에 남으므로, 틀린 교훈·안전하지 않은 도구 사용 규칙·민감 정보가 harness에 써져 재사용될 수 있다고 적는다.
실험에서는 갱신을 모두 로그로 남기고 evolver가 평가 스크립트와 가중치를 못 건드리게 했지만, 실제 배포에서는 되돌리기·감사·사람 감독을 설계 요건으로 둬야 한다고 쓴다.
8. 지금 관점: evolver에 큰 모델을 쓸 필요가 있나
이 블로그에서 본 자기진화 계열은 Reflexion의 반성문에서 Voyager의 스킬 라이브러리, GenericAgent의 SOP와 코드로 이어진다.
전부 “경험을 harness에 써 넣으면 좋아진다”를 보인 논문이다.
이 논문은 그 좋아짐을 쓰는 쪽과 받는 쪽으로 쪼갠다.
Experience-Following이 메모리에 무엇을 넣느냐가 행동을 바꾼다고 했다면, 여기서는 같은 걸 넣어도 받는 모델에 따라 행동이 달라진다.
바로 가져다 쓸 수 있는 부분은 역할 분리다.
스킬이나 프롬프트를 자동으로 고쳐 쓰는 루프를 돌릴 때, 궤적을 읽고 갱신을 쓰는 evolver 자리에 가장 비싼 모델을 둘 이유가 이 결과로는 약하다.
세 벤치마크에서 evolver 간 차이가 3.1pp 이내였고 9B가 1등인 벤치마크도 있었다.
evolver 호출은 과제마다 궤적 전체를 넣으니 토큰이 많이 든다.
그 자리를 작은 오픈 모델로 바꾸고, 아낀 예산을 과제를 푸는 쪽 모델에 쓰는 게 이 논문의 처방이다.
다만 여기서 evolver가 한 일은 “같은 절차를 스킬로 적는 것”이었다.
flink-query 사례처럼 정답 절차가 궤적 안에 이미 있으면 9B도 그걸 옮겨 적을 수 있다.
궤적에 없는 걸 추론해서 써야 하는 갱신이라면 결과가 같을지는 이 논문으로는 모른다.
받는 쪽 결과는 작은 모델로 에이전트를 돌리는 사람에게 더 아프다.
Qwen3-32B가 스킬을 못 불러온 이유는 이해 부족이 아니었다.
액션 포맷이 문제였다.
단일 키 JSON만 받는 러너에 다중 키를 보냈다.
이건 모델 학습 전에 러너 쪽에서 풀 수 있는 문제다.
포맷을 느슨하게 받거나, 로드 요청만 따로 뽑아내는 파서를 두면 활성화 실패의 일부는 사라진다.
준수 실패는 러너로 못 푼다.
스킬을 스크립트로 읽고 첫 오류에서 포기하는 건 모델 쪽 문제이고, 논문이 긴 궤적 지시 준수를 학습 목표로 꼽은 이유다.
작은 모델에 스킬을 붙여서 성능을 올리려 한다면, 먼저 스킬 로드율과 로드 후 pass rate를 따로 재 보는 게 순서다.
그 두 숫자가 낮으면 스킬을 더 잘 써 봐야 소용이 없다.
그대로 받아들이기 어려운 부분도 있다.
benefit이 최댓값 정의라서 anchor evolver 셋 중 하나만 맞아도 점수가 나오고, SB는 과제 86개에 base 0%인 모델이 둘이라 저점 구간 숫자가 흔들린다.
준수 판정은 Sonnet 4.6 한 모델에 맡겼다.
“중간 체급이 가장 득을 본다”는 결론은 SWE와 MCP에서 분명하고 SB에서는 흐리다.
그래도 “진화 루프가 안 먹히면 evolver를 바꾸기 전에 에이전트가 harness를 불러오는지, 불러온 뒤 따르는지부터 보라”는 순서는 지금 바로 적용할 수 있다.
Leave a comment