
RBC Paper review
Reliable Memory from Unstable Growth: Curating Self-Written Agent Playbooks with Randomized Experiments
https://arxiv.org/abs/2610.18427
RBC(Randomized Block Curation)는 Nanyang Technological University와 VinUniversity에서 만든 플레이북 큐레이션 방법이다.
에이전트가 과제를 풀고 나서 스스로 적어 둔 교훈(playbook) 중 무엇을 다음 과제의 프롬프트에 넣을지를, 에이전트의 판단이 아니라 연습 과제 위의 무작위 실험으로 정한다.
저자 5명, 2026년 10월 13일에 arXiv에 올라온 논문이다.
앞에서 본 Experience-Following에서는 메모리에 전부 넣으면 고정 메모리보다 못하다는 걸 봤는데, 이 논문은 그 “무엇을 뺄지”를 측정으로 정하는 쪽이다.
1. Introduction
LLM 에이전트가 재학습 없이 나아지는 방법 중 하나가 텍스트 메모리다.
과제를 끝낸 뒤 교훈을 적어 두고, 다음 과제의 프롬프트에 읽어 넣는다.
이 논문은 그 교훈 모음을 playbook이라 부른다.
ACE(교훈을 한 줄씩 덧붙여 키우는 시스템), Dynamic Cheatsheet(플레이북 전체를 매번 다시 쓰는 시스템), ReasoningBank(과제와 비슷한 교훈을 검색해 쓰는 시스템)가 유지 방식은 다르지만 설계 하나는 같다.
교훈을 쓴 에이전트가 무엇을 남길지도 판단한다.
이 판단을 실제 과제 성공률과 대조한 연구는 적고, 있어도 메모리 전체 단위로만 비교했다고 한다.
저자들은 ACE와 Dynamic Cheatsheet의 플레이북이 불안정하다는 것부터 보인다.
통째로 넣으면 플레이북 없는 것보다 최대 69.6점 낮을 수 있고, 같은 학습 과제를 순서만 바꿔 다시 키우면 도움이 되던 플레이북이 해로운 플레이북으로 바뀐다.
에이전트에게 해로운 교훈을 지우게 해도 해가 사라지지 않는다.
교훈 하나를 판단하려면 그게 있을 때와 없을 때를 비교해야 하는데, 에이전트는 그 교훈을 쓴 에피소드만 보기 때문이다.
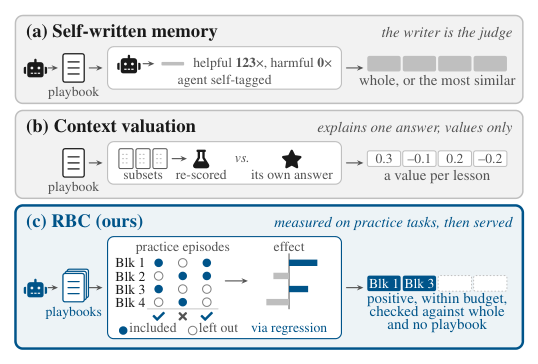
RBC는 이 비교를 연습 과제 위의 무작위 실험으로 공급한다.
관련 교훈을 블록으로 묶고, 연습 과제마다 각 블록을 동전 던지듯 넣거나 뺀다.
무작위로 넣었으니 블록이 있던 과제와 없던 과제가 비교 가능해지고, 두 쪽 성공률의 차이가 그 블록의 효과가 된다.
도움이 되는 블록만 남기고, 플레이북을 여러 개 키워서 큐레이션한 것·통째·없음 중 새 연습 에피소드에서 가장 잘 나온 것을 서빙한다.
두 메모리 시스템, 세 모델, 세 벤치마크에서 평균 성공률 66.9를 보였고, 통째 플레이북은 55.5, 플레이북 없음은 54.1, 에이전트 자체 판단으로 고른 것은 53.8이었다.
2. Related Work
Self-written memory 계열(ACE의 태그, Dynamic Cheatsheet의 사용 횟수, Reflexion, ExpeL의 투표 점수 등)은 모두 쓴 쪽이 판단한다는 점이 같다.
성공률로 재는 가장 가까운 일은 RSEA인데, 메모리 재작성 전체를 held-out 성공률이 안 떨어질 때만 받아들이는 방식이다.
RBC는 블록 단위로 한 번에 재고, 성장 실행(growth run) 사이와 플레이북 없음까지 포함해 고른다.
Context valuation 계열(ContextCite, Data Shapley, SkillSV, DG-Mem)은 항목별 값을 내고 멈추는데, 교훈 하나는 몇백 에피소드의 잡음을 넘길 만큼 성공률을 못 움직인다고 한다.
블록의 효과는 Banzhaf value(다른 블록들의 무작위 조합 위에서 평균한 한계 기여)이며, 무작위 포함이 모든 블록의 값을 한 번에 추정한다.
프롬프트 최적화(DSPy, GEPA)와 데모 선택도 개발 셋 점수로 고르는 점이 같지만, RBC는 교훈을 다시 쓰지 않고 고르기만 하므로 큐레이션 단계에서 LLM을 부르지 않는다.
3. Background and Setup
3.1 Memory systems
메모리 루프는 세 단계다.
Grow: 학습 과제 배치마다 모델이 자기 궤적을 읽고 짧은 교훈을 써서 플레이북 $P$를 만든다.
Judge: 모델이 어떤 교훈이 도움이 되는지 판단한다.
Serve: 부분집합 $S \subseteq P$가 다음 과제의 프롬프트에 들어간다.
부분집합 $S$를 서빙했을 때의 가치는 평균 성공률 $V(S)$이고, 플레이북은 $V(S) > V(\emptyset)$일 때만 도움이 된다.
기준점 둘은 No playbook($S=\emptyset$)과 Whole($S=P$)이다.
한 번의 growth run은 학습 과제로 플레이북 하나를 처음부터 키우는 것이고, 과제 순서와 샘플링이 바뀌면 같은 절차가 다른 플레이북을 쓴다.
목표는 judge와 serve를 측정으로 바꾸는 것이다.
토큰 예산 $B$ 안에서 $V(S)$를 최대로 하는 $S^\star$를 찾고, 여러 growth run이 있으면 그들의 큐레이션 집합·통째·없음 중 최선을 찾는다.
$V$는 잡음 섞인 에피소드로만 보이므로 연습 과제에서 추정한다.
두 시스템을 쓴다.
ACE는 Reflector가 궤적과 피드백을 읽어 새 교훈을 쓰고, 에피소드에서 쓰인 교훈에 helpful/harmful 태그를 단다.
교훈은 절대 지워지지 않고, 플레이북은 통째로 서빙된다.
Dynamic Cheatsheet는 배치마다 모델 호출 한 번으로 치트시트 전체를 새로 쓴다.
보상 없이 스스로 어느 시도가 성공했는지 판단해 항목별 성공 사용 횟수를 세고, 역시 통째로 서빙한다.
3.2 Benchmarks and models
AppWorld(앱 9개의 API를 상대로 코드를 쓰는 과제), WebShop(설명에 맞는 상품을 찾아 사는 과제), ALFWorld(텍스트 가정 환경에서 목표를 달성하는 과제)를 쓴다.
각 벤치마크는 학습·연습·평가 과제 세 묶음이 겹치지 않고, 평가 과제는 AppWorld 168개, WebShop 500개, ALFWorld 134개다.
모델은 Qwen3.8-27B, Qwen3.5-9B, Gemma-4-31B 셋이다.
setting은 시스템·모델·벤치마크 한 조합이다.
ACE는 AppWorld에서 Reflector가 통과 여부만 보는 pass/fail과 단위 테스트별 결과를 보는 per-test를 따로 세고, 9B는 ALFWorld를 거의 못 풀어 빼서 ACE 11개, Dynamic Cheatsheet 8개 setting이다.
setting마다 growth run이 셋이다.
4. Self-Written Memory Is Unreliable
고치기 전에 고칠 필요가 있는지부터 본다.
ACE 11개 setting에서 growth run 셋씩 돌리고, 루프의 각 단계를 성공률과 대조했다.
플레이북 없음보다 5점 넘게 낮으면 harmful로 부르는데, 같은 플레이북을 다시 평가해도 최대 5.0점만 움직였으므로 그 차이는 잡음이 아니라고 한다.
Finding 1: 통째로 서빙하면 해로울 수 있다.
27B ALFWorld에서는 첫 플레이북이 74.9를 97.5로 올렸고, 27B AppWorld pass/fail에서는 세 run 모두 해로웠으며 하나는 69.6점을 깎았다.
11개 setting의 첫 run 중 5개는 돕고, 2개는 비슷하고, 4개는 해롭다.
Finding 2: 어느 growth run이냐가 해를 결정한다.
27B AppWorld per-test에서 세 run은 82.5, 58.9, 30.0이고 플레이북 없음은 78.4다.
같은 과제를 순서만 바꿔 다시 키웠는데 하나는 돕고 둘은 해친다.
이런 흔들림은 해로운 run이 있는 6개 setting 중 3개에서 나왔고, Dynamic Cheatsheet도 9B WebShop에서 한 run은 13.2점 이득, 다른 run은 14.0점 손해였다.
Finding 3: 에이전트의 자체 판단은 해를 놓친다.
helpful 태그가 많은 교훈만 남기고 잘라 보면(토큰의 40%), 첫 플레이북이 해로운 4개 setting 중 3개에서 잘라낸 플레이북도 여전히 해롭다.
가장 해로운 블록에 든 규칙이 하나 인용돼 있다.
“When calling complete_task, always pass a concrete, non-empty string literal as the answer argument.”
조심스러워 보이는 규칙인데, AppWorld 과제 다수는 답을 기대하지 않는다.
이 규칙이 프롬프트에 있으면 27B는 그런 과제의 69.0%에 답을 넣고, 없으면 37.5%다.
모든 과제가 이 호출로 끝나니 규칙은 모든 에피소드에 관여하고, Reflector는 이걸 helpful 123번, harmful 0번으로 태그했다.
per-test 피드백으로 실패한 테스트를 보여주면 이런 규칙을 안 쓴다고 한다.
-> pass/fail만 보는 Reflector가 “상상 속 검증기”에 맞춰 규칙을 쓰고 있었다는 건데, 피드백의 해상도가 메모리 품질을 정한다는 얘기로 읽힌다. 이건 RBC와 별개로 가져갈 교훈이다.
세 발견이 요구 사항 셋이 된다.
도움이 되는 부분만, 또는 아예 서빙하지 않기(1), 여러 플레이북을 키워 새 연습 에피소드로 고르기(2), 각 부분의 효과를 성공률로 재기(3).
5. Method: Randomized Block Curation
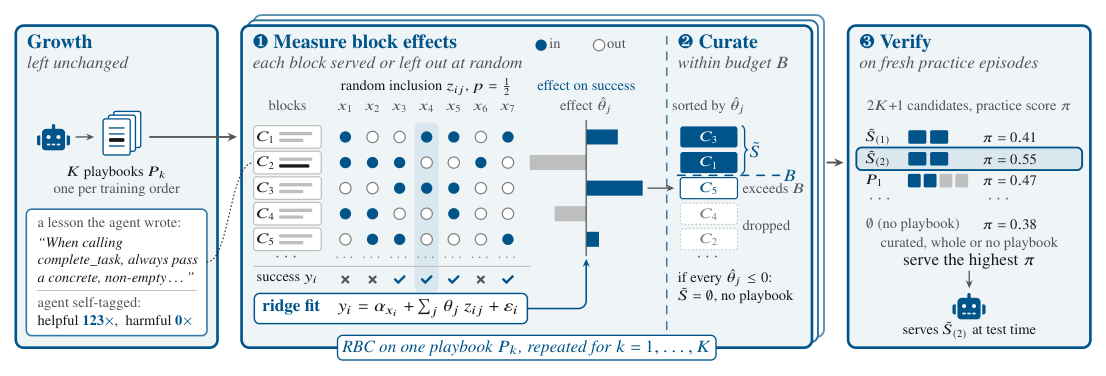
RBC는 성장이 끝난 뒤 평가 과제와 분리된 연습 과제 $D_{pr}$ 위에서 돈다.
교훈 목록만 있으면 되므로 ACE의 교훈이든 Dynamic Cheatsheet의 항목이든 똑같이 쓸 수 있다.
5.1 Measuring the effect of each block
교훈 하나는 효과가 너무 작아 몇백 에피소드로는 잡음을 못 넘는다.
그래서 교훈을 all-mpnet-base-v2로 임베딩하고 Ward 방법으로 $m=8$개 블록에 묶는다.
한 블록은 한 주제의 교훈을 담고, 같이 돕거나 같이 해치는 경향이 있다.
블록 수는 별로 중요하지 않았다고 한다.
연습 에피소드 $i$마다 과제 $x_i$를 뽑고 블록 $j$를 확률 $p=\tfrac12$로 독립적으로 포함한다($z_{ij} \sim \text{Bernoulli}(p)$).
에피소드 하나가 에이전트의 보통 실행이면서 동시에 $m$개 블록에 대한 2수준 요인 설계의 시행 하나가 된다.
블록의 효과는 다른 블록 조합 위에서 평균한 이득으로 정의한다.
이게 Banzhaf value이고, $p=\tfrac12$이면 블록을 넣은 에피소드와 뺀 에피소드의 평균 성공률 차이가 정확히 $\theta_j$가 된다(Proposition 1).
$V$에 대한 가정이 없고, 블록 간 상호작용은 평균에 녹아 들어간다.
블록 하나씩 빼 보는 방식이면 같은 정밀도에 $(m+1)/2 = 4.5$배의 에피소드가 든다.
실제 추정은 과제별 절편 $\alpha_x$로 난이도를 흡수하는 ridge 회귀로 한다.
$\lambda$는 과제 하나씩 빼는 교차검증으로 고르고, 균형 설계에서는 penalty가 모든 추정치를 거의 같은 비율로 줄여 부호와 순서가 유지된다고 한다.
5.2 Curating under a budget
큐레이션은 $\hat\theta$의 부호와 순서만 쓴다.
$\hat\theta_j > 0$인 블록을 큰 것부터 취하고, 그 교훈들을 순서대로 넣되 예산 $B$를 넘기는 교훈은 건너뛴다.
양수인 추정치가 하나도 없으면 플레이북 없음이 된다.
예산은 상한이지 목표가 아니어서, 도움이 되는 블록이 하나면 그 블록만 남는다.
블록 효과가 더해지는 경우 이 규칙이 최적이고, 예산 안에서는 크기 같은 블록에 대해 greedy knapsack 해와 같다.
토큰당 효과로 줄 세우면 작은 블록의 잡음이 커져서 효과 자체로 줄 세운다.
5.3 Verifying across growth runs
학습 과제 순서를 바꿔 $K$개 플레이북을 키우고 각각 큐레이션한다.
그리고 후보 $2K+1$개(큐레이션 $K$개, 통째 $K$개, 없음)를 새 연습 에피소드로 채점해 가장 높은 것을 서빙한다.
추정에 쓴 에피소드는 다시 쓰지 않고 평가 과제는 건드리지 않는다.
없음이 후보에 들어 있으니 선택이 안전하다는 게 Proposition 2다.
후보 $C$개를 $n$ 에피소드로 채점하면 확률 $1-\delta$로 선택된 후보의 기대 성공률이 최선보다 $2\sqrt{\log(2C/\delta)/(2n)}$ 이상 낮지 않다.
이 범위는 저자들 샘플 크기에서 느슨해서 척도의 1/4 정도라고 하는데, 실제 평가에서는 ACE에서 플레이북 없음보다 0.8점 넘게 떨어진 적이 없다.
RSEA의 수용 규칙을 Best-Full이라 부르고, 같은 플레이북들을 키워 통째 중 최선 또는 없음을 같은 $\pi$로 고른다.
Best-Full은 RBC에서 큐레이션만 뺀 것이어서, 둘의 차이가 큐레이션의 몫이 된다.
6. Experiments
RBC의 상수는 ACE 4개 setting에서 평가 과제를 쓰지 않고 정한 뒤 나머지 15개에서 그대로 썼다.
$K=3$, 예산은 토큰의 40%(20%와 60%는 더 낮았다), 블록 8개다.
모든 점수는 평가 시드 3개와 growth run 3개 평균이다.
베이스라인은 같은 플레이북·같은 과제·같은 시드에서 서빙 결정만 다르다.
Own(ACE의 태그 또는 Dynamic Cheatsheet의 사용 횟수), Top-k(ReasoningBank처럼 과제와의 유사도), Random이 같은 40% 예산으로 자른다.
Best-Full은 통째 중 최선 또는 없음을 고른다.
RBC-cut은 growth run 하나를 큐레이션한 것이고, RBC는 거기에 run 사이 선택을 더한 것이다.
6.1 Measuring before serving lifts both memory systems on every model
주 결과 표(Table 1)는 두 시스템 19개 setting에서 방법별 성공률을 적은 것인데, 잘라 둔 이미지가 깨져서 수치로 적는다.
19개 setting 평균에서 RBC는 66.9, 통째는 55.5, 없음은 54.1, Own은 53.8이다.
RBC는 19개 중 15개에서 통째보다 높고, 모든 모델·두 시스템에서 기준점 둘보다 높다.
Dynamic Cheatsheet에서는 튜닝 없이 통째 61.3, 없음 53.8에서 66.5로 올렸다.
ACE에서 통째는 없음보다 최대 69.6점 떨어지고, 모든 베이스라인이 어딘가에서 적어도 5.4점 떨어지는데 RBC는 최대 0.8점이다.
Dynamic Cheatsheet에서는 Best-Full과 같은 AppWorld 두 setting에서 없음 아래로 떨어진다.
6.2 Measuring beats judging
같은 예산에서 자체 판단·유사도·무작위는 통째보다 나을 게 없다.
ACE에서 셋 모두 최대 50.9이고 통째가 51.2, Dynamic Cheatsheet에서는 58.9 대 61.3이다.
growth run 하나만 측정한 RBC-cut은 ACE에서 61.9다.
각 judge는 어느 ACE setting에서는 없음보다 60.3점 이상 떨어지고, 자체 태그가 가장 멀리(72.6) 떨어진다.
판단이 실패하는 이유는 태그가 블록이 실제로 하는 일을 추적하지 않기 때문이다.
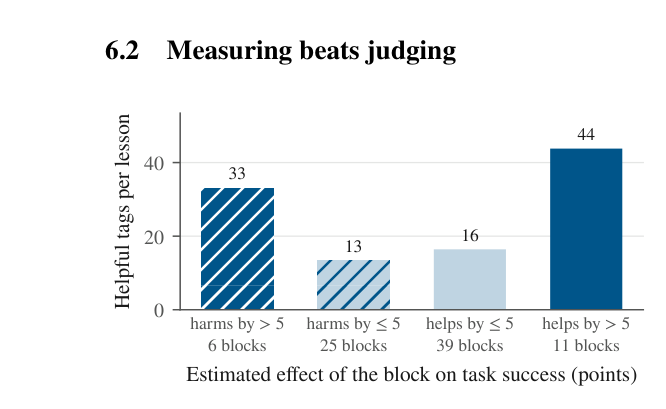
81개 블록에서 ACE 태그와 측정 효과의 순위 상관은 0.21이다.
가장 해로운 블록들이 가장 도움 되는 블록들 다음으로 helpful 태그를 많이 받았다.
judge에게 유리하게 해 줘도(유사도를 평가 과제에서 튜닝, LLM 큐레이터에게 결과를 알려줌) RBC-cut보다 낮았고, 같은 에피소드에서 DG-Mem의 subset-Shapley 추정으로 큐레이션하면 RBC의 회귀보다 나빴다(Appendix E.2).
6.3 Curating adds to choosing the best whole playbook, with fewer tokens
Best-Full처럼 run 사이에서 고르기만 해도 해의 대부분을 피한다.
큐레이션은 해로운 플레이북 안의 도움 되는 블록을 건지는 몫을 더한다.
ACE에서 RBC 67.2 대 Best-Full 66.1이고, 서빙 토큰은 통째의 60% 대 78%다.
둘의 선택이 다른 6개 setting 중 5개에서 RBC가 앞서고, 상수 조정에 쓰지 않은 7개 setting에서 +1.9다.
모든 통째가 해로운 곳에서 가장 많이 번다(9B WebShop 49.6 대 43.8, Gemma AppWorld pass/fail 69.8 대 65.3).
run 수를 늘리는 것이 큐레이션을 대신하지는 못한다.
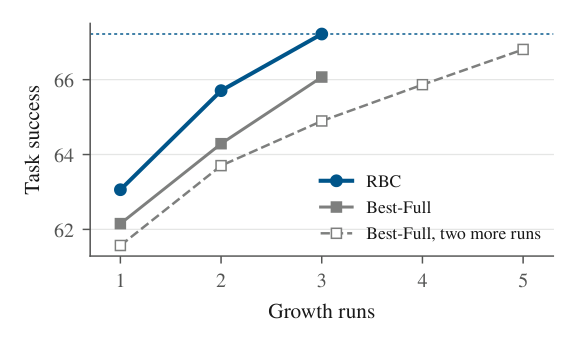
Best-Full이 66.8로 따라오려면 run이 둘 더 필요하고 토큰은 27% 더 쓴다.
성장·연습 비용을 맞추면(RBC 2 run 대 Best-Full 3 run) 65.7 대 66.1로 비슷하고, Best-Full이 토큰을 23% 더 쓴다.
부분별 기여는 ACE에서 큐레이션만 61.9, 선택만 62.2, 한 run에서 둘 다 63.1, 세 run에서 67.2다.
큐레이션이 돈이 되는 곳에서만 큐레이션한다.
Dynamic Cheatsheet는 플레이북을 통째로 다시 쓰므로 교훈이 덜 분리되고, 큐레이션한 치트시트는 통째와 비슷하다(61.1 대 61.3).
RBC는 이걸 연습 과제에서 감지해 8개 중 7개 setting에서 Best-Full과 같은 통째를 서빙한다.
그래서 둘이 66.5 대 66.9로 비슷하다.
-> 큐레이션이 안 먹히는 시스템에서는 선택으로 후퇴한다는 건 설계상 안전장치인데, 뒤집어 보면 “전체 재작성” 메모리에서는 RBC가 토큰을 못 줄인다는 뜻이기도 하다.
6.4 Curating pays most when playbooks grow long
ACE는 교훈을 지우지 않으니 플레이북이 계속 자란다.
9개 setting에서 최대 10 pass까지 키운 새 run 셋을 돌렸고, 통째는 표준 크기의 1.0~2.3배가 됐다.
AppWorld per-test에서 통째는 더 이상 돕지 않는다(27B 46.6 대 없음 78.4, 9B 17.7 대 19.8).
선택은 없음이나 약한 run으로 후퇴할 수밖에 없지만, RBC는 도움 되는 블록을 찾는다(27B 84.9 대 Best-Full 78.4, 9B 32.3 대 21.2).
통째가 최선인 setting에서는 Best-Full과 같은 것을 서빙하고, 나머지 6개 setting에서는 토큰 44% 이하의 큐레이션 집합을 서빙해 평균 4.7점 높다.
Best-Full 대비 3.1점 차이는 전부 큐레이션에서 온다.
6.5 Practice tasks should come from the tasks the agent will face
교훈은 “과제를 어떻게 끝내는가” 같은 일반 규칙이라 연습 과제와 평가 과제가 비슷하면 선택이 옮겨 간다.
연습 성공률이 setting의 후보 7개를 평가 성공률과 거의 같은 순서로 세우고(Spearman 중앙값 0.89), ACE 11개 setting 중 6개에서 평가 기준 최선을 골랐으며 7개에서 반 점 이내다.
빗나간 곳은 과제가 다른 곳이다.
AppWorld의 연습 과제는 다른 split에서 왔고, Dynamic Cheatsheet의 AppWorld 두 setting이 없음 아래에 머문 것이 대부분 이것으로 설명된다.
평가 split의 held-out 과제로 고르면 Dynamic Cheatsheet에서 2.2점, ACE에서 0.4점 더 오른다.
7. Conclusion
스스로 쓴 플레이북은 불안정하고, 에이전트의 판단은 어느 쪽인지 구별하지 못한다.
RBC는 연습 과제에서 블록을 무작위로 서빙해 각 블록이 하는 일을 보고, 큐레이션 집합을 통째·없음과 대조한 뒤 서빙한다.
성공률은 통째 55.5에서 66.9로 올랐고, 큐레이션은 선택 위에 적은 토큰으로 몫을 더하며 긴 성장에서 가장 크다.
마지막 문장은 “An agent’s memory should be measured, not judged.”이다.
Limitations
증거는 메모리 시스템 둘, 벤치마크 셋, 오픈 모델 셋과 저자들이 직접 키운 플레이북에 한정된다.
다른 시스템, 도메인, 더 큰 모델이나 프로프라이어터리 모델은 남아 있다.
블록의 가치를 다른 블록 위의 평균 이득으로 정하므로 효과가 더해질 때 정확하고, 교훈이 분리되지 않는 전체 재작성 메모리에서는 통째 선택으로 후퇴해 컨텍스트를 못 줄인다.
신뢰성의 대가로 에피소드를 더 쓴다.
플레이북 여러 개를 키우고, 연습 라운드를 돌리고, 결과를 관측할 수 있는 연습 과제가 필요하다.
Appendix E.4를 보면 $K=3$에서 RBC-cut 대비 에피소드 3.3~4.1배, Best-Full은 1.8~2.6배다.
보장은 연습 과제 위의 것이라 연습 과제가 실제 과제와 비슷할 때 잘 된다.
그리고 한 번 키운 뒤 고정된 플레이북만 다뤘고, 서빙 중에 자라는 메모리로 확장하는 건 다음 과제다.
-> “서빙 중에 자라는 메모리”가 빠진 건 실무에서 가장 큰 공백이다. 대부분의 에이전트 메모리는 배포 뒤에도 계속 쌓이는데, 그때마다 연습 라운드를 다시 돌릴 수 있는가는 원문이 답하지 않는다.
8. 지금 관점: 메모리에 A/B 테스트 붙이기
이 논문은 Reflexion에서 시작한 “말로 남기는 교훈” 계열에 측정을 붙인 것이다.
The Past Is Prologue가 메모리 갱신을 옛것과 새것 중 나은 쪽을 남기는 배포 결정으로 봤다면, 여기서는 그 단위가 메모리 전체에서 블록으로 내려갔고 후보에 “없음”이 항상 들어간다.
Harness Benefit에서 본 “갱신을 잘 만드는 능력과 갱신으로 득을 보는 능력은 다르다”는 결과와도 맞물린다.
helpful 123번, harmful 0번으로 태그된 규칙이 가장 해로운 블록에 있었다는 건 그 차이를 교훈 한 줄 단위로 보여준 사례다.
지금 가져다 쓸 수 있는 건 방법 전체보다 그 뼈대다.
큐레이션에 LLM 호출이 없고, 필요한 건 교훈 목록·임베딩 클러스터링·동전 던지기·ridge 회귀뿐이다.
결과를 관측할 수 있는 연습 과제 묶음이 있다면 지금 쓰는 메모리 시스템이 무엇이든 서빙 직전에 끼워 넣을 수 있다.
무엇보다 “플레이북 없음”을 후보에 넣는 것만으로 최악을 막는다는 결과는 바로 적용할 수 있다.
Best-Full, 즉 통째 중 최선 또는 없음을 고르기만 해도 평균 66.4로 RBC의 66.9에 거의 붙는다.
메모리를 추가했다가 성능이 떨어졌다는 경험이 있다면, 블록 단위 실험 전에 이 선택 단계부터 두는 게 순서다.
그대로 받아들이기 어려운 부분은 비용과 전제다.
에피소드가 3~4배 든다는 건 과제 하나가 수십 턴인 에이전트에서는 작지 않다.
벤치마크 셋 다 성공 여부가 자동으로 나오는 환경이고, 고객 응대처럼 성공을 사람이 판정해야 하는 곳에서는 “연습 과제 수백 개”의 비용이 전혀 다르다.
Appendix E.8에서 과제 성공을 LLM judge로 대체해 보니 큐레이션이 실패했다고 하므로, 관측 가능한 결과가 없는 도메인에서는 이 방법의 전제 자체가 빠진다.
또 블록 8개라는 거친 단위는 교훈 수십 개짜리 플레이북에 맞춘 것이고, 수천 개짜리 메모리에서 블록이 어떻게 나뉘어야 효과가 측정되는지는 원문에서 확인 못 함.
연습 과제가 실제 과제와 다르면 선택이 빗나간다는 6.5의 결과는, 실무에서는 “연습 과제를 어디서 가져오는가”가 이 방법의 성패를 반쯤 정한다는 뜻으로 읽힌다.
Leave a comment