
LLM Agent Survey Paper review
A Survey on Large Language Model based Autonomous Agents
https://arxiv.org/abs/2308.11432
이 논문은 중국 인민대학교(Renmin University of China)의 Lei Wang 등이 쓴 LLM 기반 자율 에이전트 서베이다.
2023년 8월 arXiv에 처음 나왔고, 이후 Frontiers of Computer Science 저널에 실렸다.
CoALA 리뷰에서 CoALA가 자기와 구분하려고 “empirical survey”로 인용한 정리들이 있었는데, 이 논문이 그중 하나다.
CoALA가 인지 아키텍처 이론에서 출발했다면, 이 서베이는 2021~2023년에 나온 에이전트 연구들을 읽고 공통점을 묶어 정리했다.
같은 대상을 반대 방향에서 정리한 두 논문이라 같이 읽어보면 좋다.
1. Introduction
예전 자율 에이전트 연구(강화학습 계열)는 고립된 환경에서 제한된 지식으로 정책을 학습했다.
LLM 기반 에이전트는 출발점이 다르다. 웹 지식을 학습한 모델이 중심 제어기가 되니까, 도메인 데이터로 학습하지 않아도 행동할 수 있고 자연어로 상호작용할 수 있다.

2021년 1월부터 2023년 8월까지 나온 에이전트 논문 수를 누적한 그래프다. 첫 이름은 WebGPT(2021-12, 웹 검색을 하며 답하는 GPT-3)이고, 2023년에 들어 확 늘어난다.
Toolformer(2023-2), Generative Agents(2023-4), Voyager(2023-5), ToT(2023-5, Tree of Thoughts)도 전부 이 타임라인 위에 있다.
이렇게 따로따로 나온 연구들을 하나의 틀로 정리하는 게 이 논문의 목표다.
2. LLM-based Autonomous Agent Construction
2.1 Agent Architecture Design
에이전트를 4개 모듈로 나눈다.
- Profile : 누구인가
- Memory : 무엇을 기억하는가
- Planning : 어떻게 계획하는가
- Action : 무엇을 하는가

Profile이 Memory와 Planning에 영향을 주고, 셋이 모여서 Action을 정한다.
CoALA에는 Profile에 해당하는 모듈이 없다.
-> 과제를 푸는 에이전트라면 역할 설정은 부차적인데, 사람 행동을 시뮬레이션하는 쪽(Generative Agents 등)에서는 에이전트가 누구인지가 출발점이다. 서베이가 시뮬레이션 쪽까지 담으려다 보니 모듈이 하나 더 필요했던 것 같다.
2.1.1 Profiling Module
에이전트의 역할을 정하는 모듈이다.
나이, 직업 같은 인구통계 정보, 성격, 다른 에이전트와의 관계가 들어가고, 보통 프롬프트에 써서 LLM의 행동을 바꾼다.
만드는 방법은 셋이다.
- 수작업 (Generative Agents의 스몰빌처럼 사람이 자연어로 직접 씀)
- LLM 생성 (시드 몇 개로 대량 생성)
- 데이터셋 정렬 (실제 인구 분포에 맞춤)
2.1.2 Memory Module
세 가지로 나눠서 본다.
- 구조 : 단기 기억만 쓰는 unified, 단기+장기를 나누는 hybrid
- 형식 : 자연어, 임베딩, DB, 구조화 리스트
- 연산 : 읽기, 쓰기, 반성
읽기는 기존 연구들을 수식 하나로 묶는다.
\[m^* = \arg\max_{m \in M} \left( \alpha \cdot s^{rec}(q,m) + \beta \cdot s^{rel}(q,m) + \gamma \cdot s^{imp}(m) \right)\]recency(최근성), relevance(관련성), importance(중요도)의 가중합이다.
Generative Agents 리뷰에서 본 3점수 회상을 일반형으로 쓴 모양이다.
쓰기에서는 같은 기억이 중복 저장되는 문제와 저장 한도를 넘는 문제를 다룬다.
반성의 예로는 Generative Agents(최근 기억에서 질문 3개를 뽑고 인사이트 5개를 만듦), GITM(마인크래프트 에이전트), ExpeL(성공·실패 궤적에서 교훈을 뽑는 방법)을 든다.
-> Reflexion은 2.1.2 본문의 반성 예시엔 없지만, Table 1은 반성 연산(②)으로도 표시한다. 본문에서는 2.1.3의 모델 피드백 계획에 나온다.
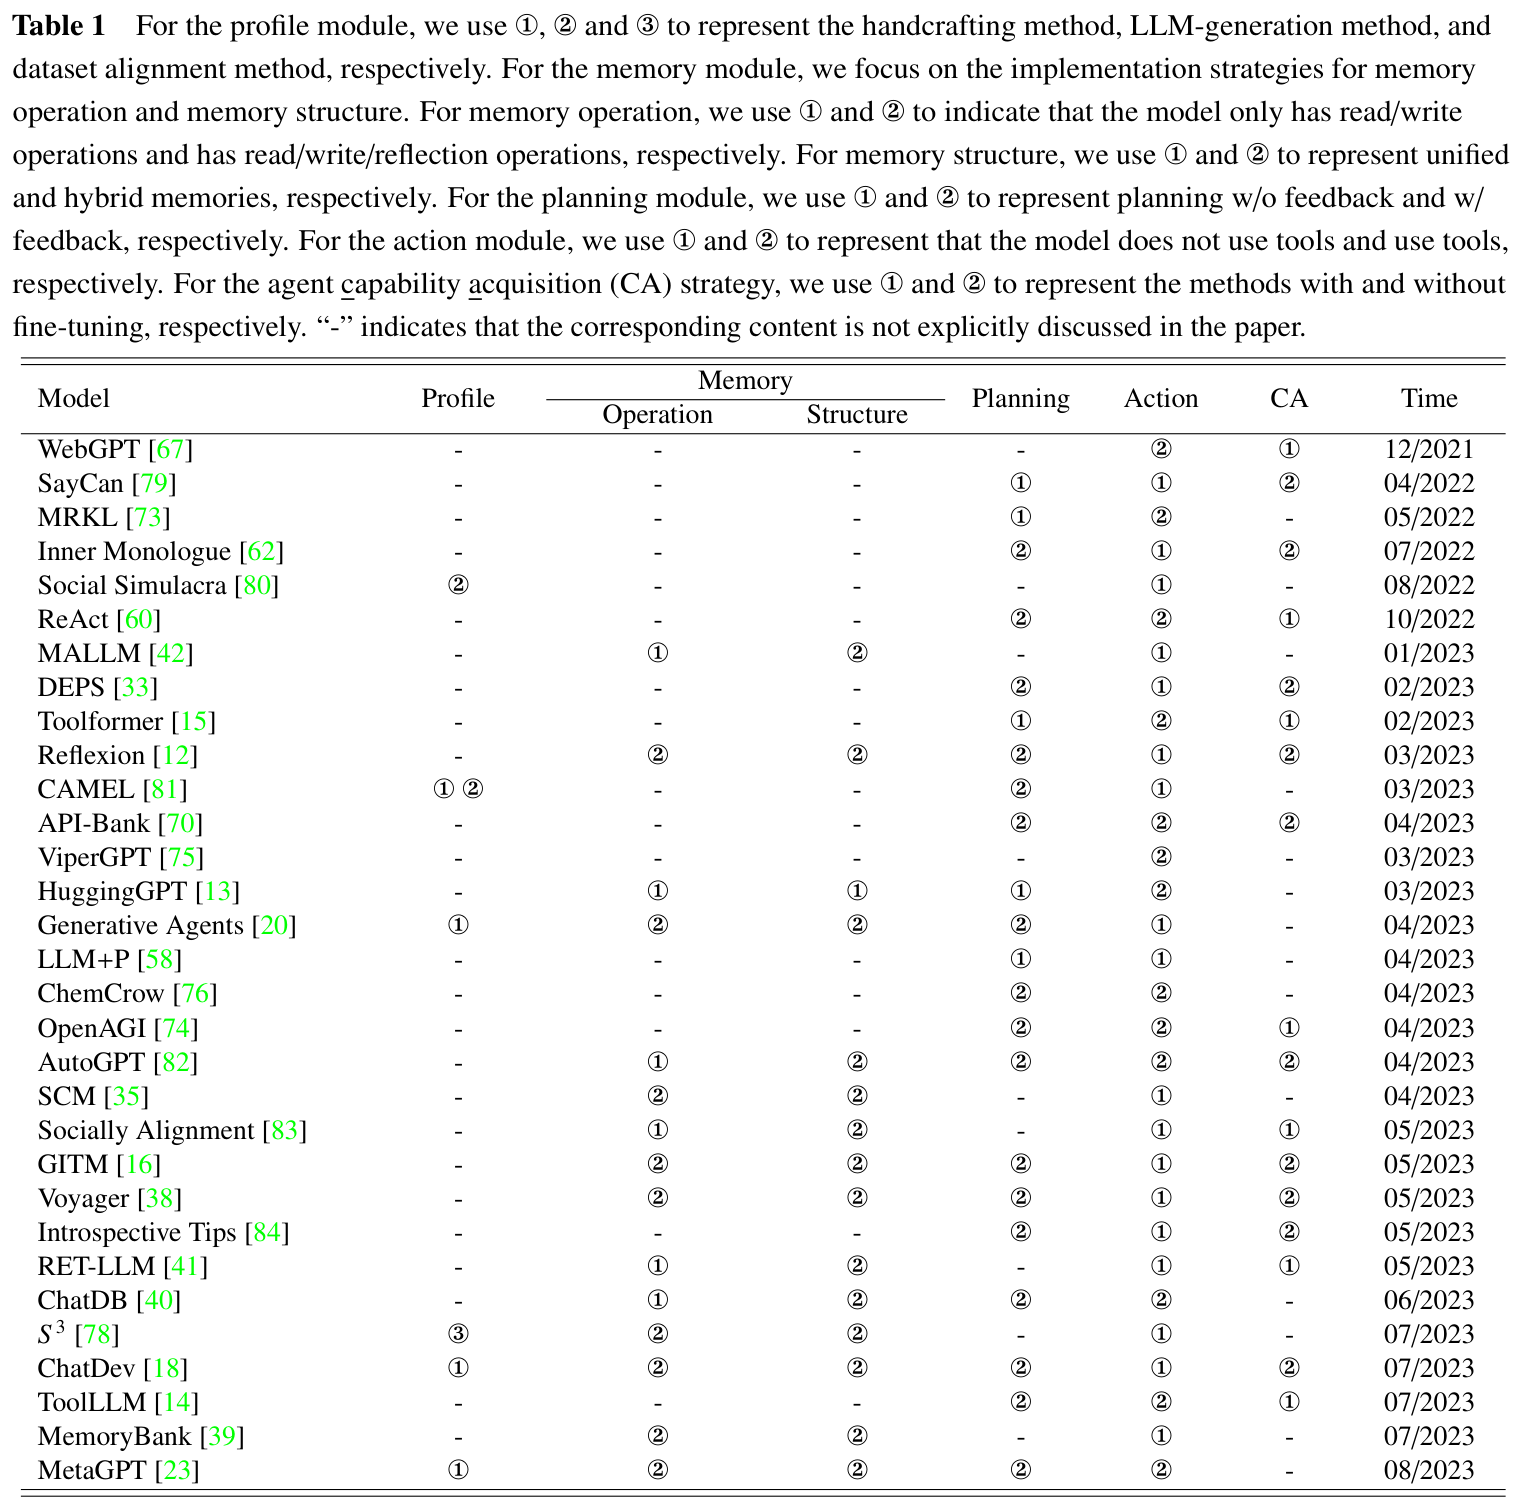
Table 1은 2023년 8월까지의 에이전트들을 4모듈과 능력 획득(CA) 전략 칸으로 분류한 표다. Reflexion 행의 Memory Operation 칸이 ②(읽기·쓰기·반성)다.
2.1.3 Planning Module
계획을 피드백이 있는지 없는지로 나눈다.
피드백 없는 계획은 이렇다.
- 단일 경로 추론 : CoT(Chain-of-Thought), 한 줄로 쭉
- 다중 경로 추론 : CoT-SC(여러 번 뽑아 다수결), ToT, 트리로 탐색
- 외부 플래너 : LLM이 문제를 PDDL 같은 형식 언어로 바꾸고 고전 플래너가 푼다

피드백 있는 계획은 이렇다.
- 환경 피드백 : ReAct, Voyager
- 사람 피드백
- 모델 피드백 : Reflexion처럼 에이전트 스스로 만든 내부 피드백 (보통 사전학습 모델로 생성)
CoALA에서는 ToT를 의사결정 방식으로 설명했는데, 여기서는 “피드백 없는 다중 경로 계획” 칸에 들어간다.
2.1.4 Action Module
행동 모듈은 질문 4개로 정리한다.
- 무엇을 위해 행동하는가 (과제 완수, 탐색, 소통)
- 행동을 어떻게 만드는가 (기억 회상, 계획 따르기)
- 무엇을 할 수 있는가 (도구, 모델 자체 지식)
- 행동의 결과는 무엇인가 (환경 변화, 새 행동 유발, 내부 상태 변화)
2.2 Agent Capability Acquisition
능력을 얻는 전략이 시대마다 쌓여왔다고 본다.

- 머신러닝 시대 : 파라미터 학습
- LLM 시대 : 파라미터 학습 + 프롬프트 엔지니어링
- 에이전트 시대 : 여기에 mechanism engineering이 더해짐
mechanism engineering은 모듈과 동작 규칙을 설계해서 능력을 올리는 방법을 통틀어 부르는 말이다.
논문은 네 가지 예를 든다.
- 시행착오 : 행동하고 비평을 받아 고침 (DEPS 등)
- 크라우드소싱 : 여러 에이전트가 토론해서 답을 맞춤
- 경험 축적 : 성공한 행동을 기억에 쌓아 재사용 (GITM, Voyager의 스킬 라이브러리)
- 자기 주도 진화 : 스스로 목표를 세우고 피드백으로 개선
-> 가중치를 안 바꾸고 에이전트를 강하게 만드는 방법들에 이름을 붙였다. 이 시리즈에서 본 논문들 상당수가 여기 들어간다.
3. LLM-based Autonomous Agent Application
응용은 세 분야로 나눈다.
- 사회과학 : 사회 시뮬레이션, 심리, 법
- 자연과학 : 문서 관리, 실험 보조, 교육
- 공학 : SW 개발, 로봇, 산업 자동화

그림 오른쪽은 다음 장에서 다루는 평가 전략이다.
4. LLM-based Autonomous Agent Evaluation
평가는 두 가지로 나눈다.
- 주관 평가 : 사람 채점, 튜링 테스트류
- 객관 평가 : 메트릭, 프로토콜, 벤치마크
스몰빌의 believability(사람다워 보이는 정도) 인터뷰가 주관 평가, Voyager의 테크 트리 진행이 객관 평가다.
5. Related Surveys
LLM 전반, 응용, alignment, reasoning, 도구를 쓰는 Augmented Language Models, 평가를 다룬 기존 서베이들을 소개한다.
다만 LLM 기반 에이전트만 따로 다룬 서베이는 이 논문 전에는 없었다고 한다.
6. Challenges
서베이가 꼽은 풀리지 않은 과제 6개다.
- Role-playing : 웹에 잘 안 나오는 역할이나 새로 생긴 역할은 잘 연기하지 못한다.
- Generalized human alignment : 시뮬레이션에는 나쁜 가치관을 가진 사람도 필요한데, 지금 모델은 한 가지 가치관에 맞춰 정렬돼 있다.
- Prompt robustness : 모듈마다 프롬프트가 있어서 하나를 고치면 다른 모듈까지 흔들린다.
- Hallucination : 코드 에이전트라면 틀린 코드나 보안 문제로 이어진다.
- Knowledge boundary : 일반 사용자를 연기해야 하는데 모델이 너무 많이 안다.
- Efficiency : 행동 하나에 LLM 호출이 여러 번이라 느리다.
-> 2번이랑 5번은 모델이 좋아질수록 시뮬레이션이 더 어려워지는 쪽의 문제다. 성능이 올라간다고 다 풀리진 않을 것 같다.
7. Conclusion
2021년부터 2023년까지의 LLM 에이전트 연구를 Profile, Memory, Planning, Action 4모듈로 정리하고, 응용과 평가까지 묶은 서베이다.
새 기법을 만든 논문은 아니고, 흩어져 있던 기법들을 한 틀로 모아 이름을 붙인 논문이다.
능력 획득을 파라미터 학습, 프롬프트 엔지니어링, mechanism engineering으로 나눈 구분도 기억해둘 만하다.
8. 지금 관점: CoALA와 비교
이 서베이(2023-8)와 CoALA(2023-9)는 한 달 차이로 나온 같은 분야의 정리다.
서베이는 나온 논문들을 읽고 공통점을 묶었고, CoALA는 인지 아키텍처라는 오래된 이론에서 틀을 가져와 적용했다.
나누는 방식도 다르다. 서베이는 Profile, Memory, Planning, Action 4개, CoALA는 기억, 행동 공간, 의사결정 3개다.
흔히 보는 Planning, Memory, Tool Use 3분류는 둘 다와 또 다르다. Lilian Weng의 2023년 블로그 글 “LLM Powered Autonomous Agents”에서 나온 정리다.
제일 크게 갈리는 건 역할과 학습이다.
서베이는 역할(Profile)을 첫 모듈로 두고 학습은 2.2에 따로 떼어놨다. CoALA는 역할이 없고 학습을 행동의 한 종류로 넣었다.
-> 사람을 시뮬레이션하는 쪽과 과제를 푸는 쪽의 관점 차이가 그대로 나온 것 같다.
Profile, Memory, Planning, Action이라는 용어는 이후 에이전트 설명에서 자주 보인다.
뭐가 있었는지 찾아볼 때는 이 서베이, 구조를 어떻게 짤지 생각할 때는 CoALA를 보면 될 것 같다.
다음은 메모리 쪽으로 넘어가서 MemGPT다. 컨텍스트 창을 RAM, 외부 저장소를 디스크로 보고 LLM이 스스로 기억을 옮기게 한 논문이다.
Leave a comment