
Toolformer Paper review
Toolformer: Language Models Can Teach Themselves to Use Tools
https://arxiv.org/abs/2302.04761
Toolformer는 Meta AI에서 만든, 도구 쓰는 법을 스스로 배우는 언어모델이다. 2023년 2월 arXiv에 올라온 논문이다.
ReAct와 Reflexion은 프롬프팅으로 도구를 쓰게 했는데, Toolformer는 파인튜닝으로 모델이 도구를 쓰게 만든다.
그리고 그 학습 데이터를 사람 어노테이션 없이 모델이 스스로 만든다.
1. Introduction
LLM은 few-shot으로 새로운 태스크를 풀 만큼 잘하는데, 사칙연산이나 최신 정보 조회 같은 기본적인 건 계산기나 검색엔진보다 못하다.
도구를 붙이면 되긴 하는데, 기존 방법들은 사람 어노테이션이 많이 필요하거나 특정 태스크에서만 동작했다.
그래서 Toolformer는 조건을 두 가지 세운다.
- 도구 사용을 self-supervised로 배울 것. 사람이 유용하다고 생각하는 호출과 모델에게 실제로 유용한 호출은 다를 수 있다.
- 모델의 일반성을 잃지 않을 것. 언제 어떤 도구를 쓸지는 모델이 스스로 정한다.

학습이 끝난 모델은 텍스트를 생성하다가 필요한 곳에서 [QA(...)], [Calculator(400 / 1400)] 같은 API 호출을 스스로 넣는다.
그리고 결과를 받아서 이어서 생성한다.
2. Approach
API 호출을 텍스트로 표현하는 게 출발점이다.
호출은 [API(입력) → 결과] 형태의 특수 토큰 시퀀스로 일반 텍스트 사이에 끼워 넣는다. 이렇게 하면 도구 사용 학습이 그냥 language modeling이 된다.
학습 데이터는 3단계로 만든다.

- Sample : few-shot 프롬프트로 LM이 일반 텍스트(CCNet, 웹 크롤링 말뭉치)에 API 호출 후보를 넣게 한다
- Execute : 후보 API 호출을 실제로 실행해서 결과를 받는다
- Filter : 호출이 쓸모 있었는지 보고 쓸모없는 호출은 버린다
이 논문에서 제일 중요한 게 3번 필터 기준이다.
API 호출과 그 결과를 프리픽스로 줬을 때, 뒤에 오는 토큰들의 loss가 충분히 줄어드는지를 잰다.
- $L_i^+$ : 호출+결과를 줬을 때의 loss
- $L_i^-$ : 호출을 아예 안 했을 때와, 결과 없이 호출만 했을 때의 loss 중 작은 것
“이 도구 호출이 다음 토큰 예측에 도움이 됐는가”를 모델 자신의 loss로 판단한다. 사람이 판단할 자리가 없다.
이 필터를 통과한 호출만 원문에 끼워 넣어 증강 데이터셋을 만들고, 그걸로 모델(GPT-J 6.7B)을 파인튜닝한다.
필터링으로 학습 예시의 분포가 조금 바뀌긴 하지만, 원래 분포와 충분히 가까워서 언어 모델링 능력은 그대로 남는다고 가정한다(각주 4). 이 가정은 4.3에서 perplexity로 확인한다.
1번 Sample 단계에서 QA 도구에 쓰는 프롬프트는 아래와 같다.

도구마다 필요한 건 이런 프롬프트 하나랑 예시 몇 개가 전부다.
3. Tools
도구는 5개를 붙였다.
- QA 시스템 (Atlas, 검색 기반 QA 모델)
- 계산기
- Wikipedia 검색 (BM25, 키워드 기반 검색)
- 기계번역 (NLLB 600M, Meta의 다국어 번역 모델)
- 달력
전부 입출력을 텍스트로 표현할 수 있는 것들이다.
4. Experiments
모든 태스크를 zero-shot으로 평가한다.
4.1 Experimental Setup
언어 모델링 데이터는 CCNet 일부, 모델은 GPT-J를 쓴다.
비용을 줄이려고 도구별 휴리스틱으로 API 호출이 도움될 만한 텍스트만 골라 호출을 붙이고, 그 데이터로 파인튜닝한다.
비교 대상은 네 가지 GPT-J 계열과, 훨씬 큰 OPT(66B), GPT-3(175B)다.
- GPT-J : 파인튜닝 안 한 원래 모델
- GPT-J + CC : API 호출 없는 같은 CCNet 텍스트로만 파인튜닝한 모델
- Toolformer : API 호출을 끼워 넣은 CCNet으로 파인튜닝한 모델
- Toolformer (disabled) : Toolformer와 같은 모델인데 디코딩할 때 API 호출만 막은 것
GPT-J + CC가 있어서, 성능 차이가 추가 학습 때문인지 API 호출 데이터 때문인지 나눠 볼 수 있다.
4.2 Downstream Tasks
4.2.1 LAMA
LAMA는 “OO의 수도는 ___” 같은 빈칸을 채우는 사실 조회 태스크다.
SQuAD 기준으로 GPT-J 17.8 → Toolformer 33.8이다. 6.7B 모델이 GPT-3 175B(26.8)를 넘는다.
아래 표는 LAMA 중 SQuAD, Google-RE, T-REx 세 부분집합의 정답률이다.
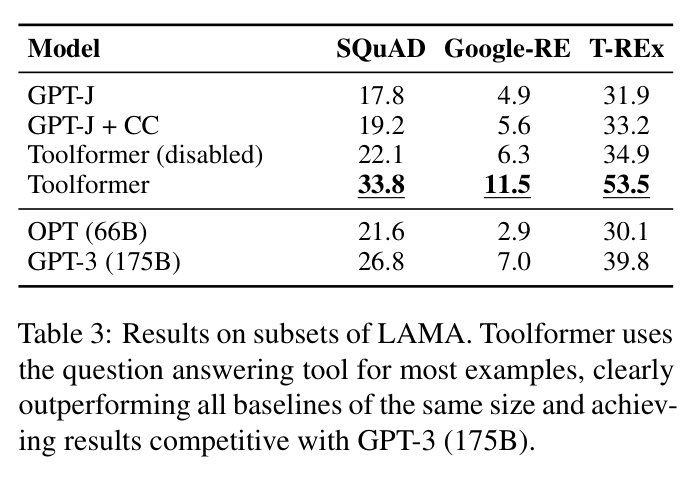
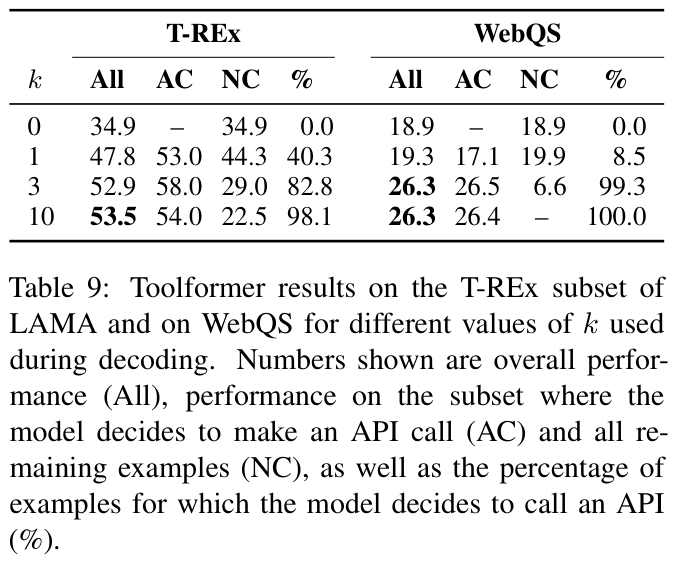
모델은 예제의 98.1%에서 QA 도구를 부르기로 스스로 정했다.
4.2.2 Math Datasets
ASDiv, SVAMP, MAWPS(초등 수준 문장형 수학 문제) 전부에서 OPT랑 GPT-3를 크게 이긴다. 계산기 호출 비율은 97.9%다.
아래 표는 세 벤치마크에서 모델이 처음 낸 숫자가 정답인 비율이다.
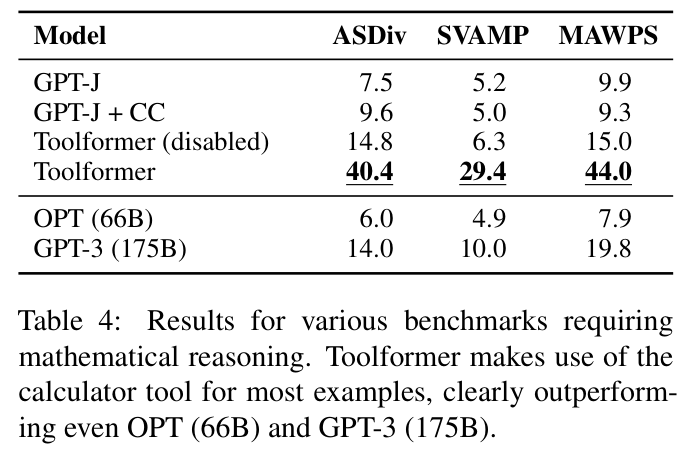
API를 끈 Toolformer(disabled)도 베이스라인보다 오르는데, API 호출을 허용하면 그 두 배 이상이 된다.
논문은 API 호출과 결과가 담긴 예시를 많이 보고 학습해서 모델 자체의 계산 능력이 오른 걸로 추정한다.
-> 그럼 계산기 결과를 보면서 산수를 따라 배운 건가?? GPT-J + CC는 거의 안 오른 걸 보면 추가 학습 때문은 아닌 것 같다.
4.2.3 Question Answering
WebQS, NQ, TriviaQA에서는 같은 크기 베이스라인은 이기는데 GPT-3 175B에는 진다.
아래 표는 세 QA 데이터셋에서 모델이 낸 앞 20단어 안에 정답이 들어 있는 비율이다. 이 태스크에서는 QA 도구를 막고 Wikipedia 검색만 쓰게 했다.

논문은 원인을 두 가지로 든다.
- 검색엔진이 단순해서 결과 품질이 낮다
- 결과가 나쁠 때 질의를 고쳐서 다시 검색하는 상호작용이 안 된다
-> 2번은 검색 → 결과 확인 → 재검색 루프가 없다는 건데, ReAct가 프롬프팅으로 풀었던 문제랑 같다.
4.2.4 Multilingual Question Answering
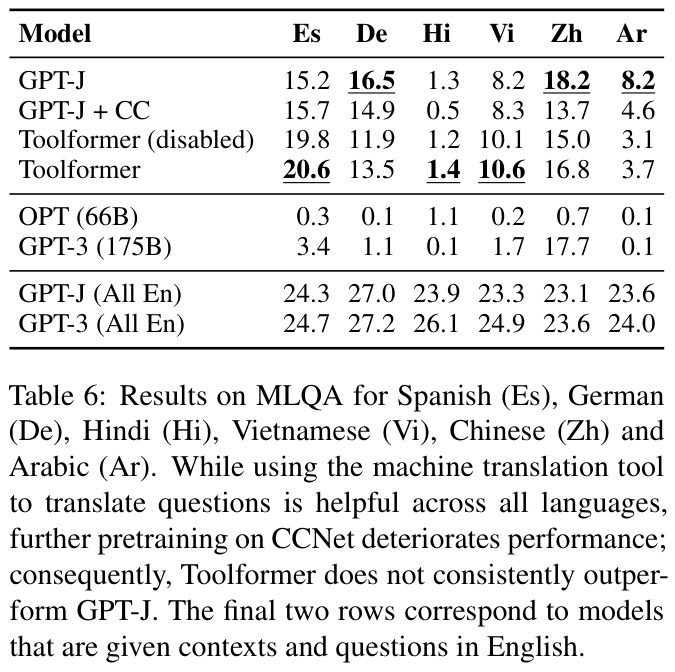
MLQA(영어 문단 + 다른 언어 질문)에서는 번역 도구를 쓰긴 하는데 GPT-J를 일관되게 이기지는 못한다.
논문은 CCNet으로 추가 학습한 게 다국어 성능을 떨어뜨렸다고 본다.
GPT-J와 GPT-J + CC 행을 비교하면 추가 학습으로 떨어진 폭이, Toolformer (disabled)와 Toolformer 행을 비교하면 번역 도구로 오른 폭이 보인다.
4.2.5 Temporal Datasets
달력 도구의 효과는 TempLAMA(시기마다 답이 바뀌는 사실 조회)와 새로 만든 Dateset(“30일 전은 무슨 요일이었나” 같은 날짜 질문)으로 본다.
Toolformer가 두 데이터셋 모두 가장 높다. TempLAMA 16.3, Dateset 27.3이고 GPT-3 175B는 각각 15.5, 0.8이다.
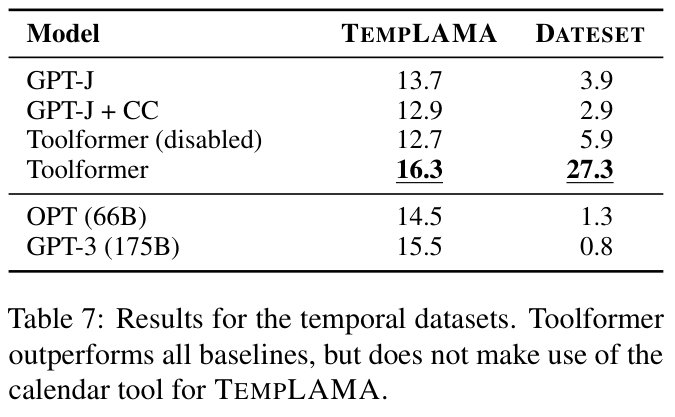
그런데 TempLAMA에서 달력 도구를 부른 건 0.2%뿐이다. 오른 건 대부분 Wikipedia 검색과 QA 도구 덕분이다.
Dateset에서는 54.8%에서 달력을 불렀고, 오른 폭은 달력 도구 덕분이다.
TempLAMA에 맞는 방법은 달력으로 오늘 날짜를 얻고 그 날짜로 QA를 부르는 건데, 예시당 호출을 한 번으로 제한해서 이게 안 된다. 아래 Limitations의 연쇄 문제와 같은 얘기다.
4.3 Language Modeling
API 호출을 넣어 학습해도 원래 언어 모델링 능력이 떨어지지 않는지 perplexity로 확인한다.
WikiText와, 학습에 안 쓴 CCNet 문서 1만 개로 잰다. 결과는 GPT-J 9.9 / 10.6, GPT-J + CC 10.3 / 10.5, Toolformer (disabled) 10.3 / 10.5 (WikiText / CCNet, 낮을수록 좋음)다.
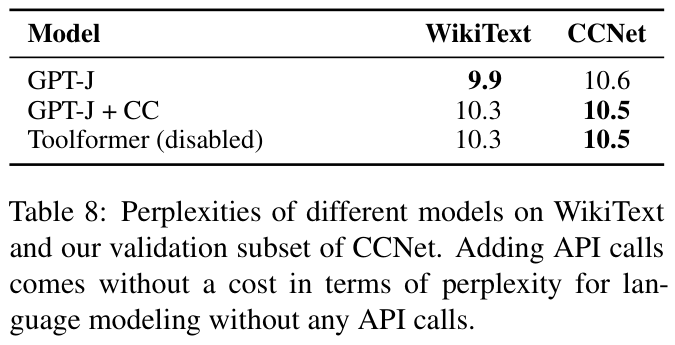
CCNet으로 학습하면 WikiText에서 조금 나빠지긴 하는데, API 호출을 넣은 데이터로 학습한 것과 안 넣은 것은 perplexity가 같다. 도구 호출을 배우느라 생긴 손해는 없다는 얘기다.
4.4 Scaling Laws
GPT-2 계열 작은 모델들(124M~1.6B)로 같은 실험을 해보면, 도구를 활용하는 능력은 775M 부근에서야 나타난다. 그보다 작은 모델은 도구가 있든 없든 성능이 비슷하다. 쓰기 쉬운 Wikipedia 검색만 예외다.

도구가 도움이 되기 시작하는 건 언어 능력이 어느 정도 있는 모델부터다.
그리고 모델이 커져도 도구 유무에 따른 차이는 크게 남는다.
5. Analysis
디코딩 때 <API> 토큰이 상위 k개 안에만 들어도 호출하게 하는 방식을 k를 바꿔가며 본다. k를 키우면 호출하는 예시가 늘고, k=1일 때는 모델이 API 없이 못 풀 만한 예시에서 호출하는 경향이 어느 정도 있다고 한다.
아래 표에서 % 열이 호출 비율이고, AC/NC는 호출한 예시와 안 한 예시 각각의 성능이다.
생성된 API 호출 예시도 직접 보여준다. 필터 점수가 높은 호출은 대체로 쓸모 있고 낮은 호출은 쓸모가 없으며, 걸러지지 않은 약간의 잡음은 모델이 호출 결과를 무조건 따르지 않게 해줘서 오히려 도움이 될 수 있다고 한다.
6. Related Work
사전학습에 추가 텍스트(메타데이터, HTML 태그, 검색 문서 등)를 넣는 연구, 도구 사용 연구, self-training·bootstrapping 연구를 정리한다.
기존 도구 사용 연구는 사람 감독이 많이 필요하거나 태스크별 few-shot 프롬프트에 기대는데, Toolformer는 self-supervised로 언제 어떻게 도구를 쓸지 스스로 배운다고 한다. 가장 가까운 연구로 TALM을 든다.
7. Limitations
- 도구를 연쇄(chain)할 수 없다.
- 검색 결과를 훑어보거나 다시 질의하는 상호작용이 안 된다.
- 도구를 부를지 말지가 입력 문구에 민감하다.
- 필터를 통과하는 호출이 적어서 sample-inefficient하다.
- 호출 비용을 고려하지 않는다.
연쇄는 한 도구의 출력을 다른 도구의 입력으로 넣는 걸 말한다. 예를 들어 “미국 1인당 GDP”를 구하려면 검색으로 GDP와 인구를 얻고 그 두 값을 계산기에 넣어야 한다.
그런데 데이터를 만들 때 도구별로 API 호출을 따로 샘플링해서, 이런 예시가 학습 데이터에 없다.
sample-inefficient는 계산기에서 특히 심하다. 문서 100만 개 이상을 처리해도 쓸모 있는 계산기 호출은 몇천 개만 나온다고 한다.
8. Conclusion
사람 어노테이션 없이, “이 도구 호출이 다음 토큰 예측을 쉽게 하는가”라는 필터 하나로 도구 사용 학습 데이터를 만들 수 있다는 걸 보여준다.
6.7B 모델이 175B를 이기는 태스크도 나왔고, 언어 모델링 perplexity는 나빠지지 않았다.
대신 연쇄가 안 되고, 상호작용이 안 되고, 도구가 단순하면 큰 모델에 진다.
호출 한 번은 잘 넣는데, 여러 번 부르고 결과를 보며 고치는 건 이후 연구들이 루프로 풀었다.
9. 지금 관점: 요즘 function calling 학습과 비교
요즘 모델들이 기본으로 갖고 있는 native function calling은 도구 호출 데이터로 학습한 결과다.
후보 생성 → 실행 → 필터 → 파인튜닝 순서는 지금 tool-use 학습 데이터를 만드는 방식과 구조가 비슷해 보인다.
실행해보고 도움이 된 것만 남기는 것도 rejection sampling으로 데이터를 거르는 것과 같은 발상이다.
다른 점은 필터 기준이다. 정답 라벨 대신 모델 자신의 loss를 쓴다.
그래서 정답이 없는 일반 텍스트에서도 데이터를 만들 수 있다.
한계였던 연쇄와 상호작용은 ReAct나 Reflexion 같은 프롬프팅 루프 쪽이 채웠다.
-> 지금 agent는 파인튜닝으로 배운 function calling을 프롬프팅 루프가 돌리는 모양이라, 두 계열이 합쳐진 것 같다.
다음은 Generative Agents다. LLM 에이전트 25명을 가상 마을에 풀어놓고, 기억·회상·반성·계획 구조가 믿을 만한 행동을 만드는지 본 논문이다.
Leave a comment