
Voyager Paper review
Voyager: An Open-Ended Embodied Agent with Large Language Models
https://arxiv.org/abs/2305.16291 / 데모 사이트
Voyager는 NVIDIA, Caltech 등에서 만든 마인크래프트 에이전트다. 2023년 5월 arXiv에 올라온 논문이다.
Generative Agents는 에이전트의 경험을 자연어 기억으로 쌓았는데, Voyager는 성공한 행동을 실행 가능한 코드로 쌓는다.
목표도 정해진 과제 하나를 푸는 게 아니다. 끝이 없는 세계에서 계속 탐험하면서 강해지는 lifelong learning(평생 학습)을 노린다.
베이스라인으로 앞에서 리뷰한 ReAct랑 Reflexion이 나온다. 결과부터 말하면 둘 다 나무 도구도 못 만들었다.

가로축은 프롬프팅 반복 횟수, 세로축은 찾은 고유 아이템 수다. 주황색이 Voyager다.
Voyager는 160번 반복하는 동안 고유 아이템 63종을 찾고 다이아몬드 도구까지 간다.
1. Introduction
마인크래프트는 정해진 엔딩이 없다. 나무를 캐고, 도구를 만들고, 더 좋은 도구로 더 깊이 내려가는 테크 트리를 스스로 올라가야 한다.
논문은 이런 세계에서 사람 개입 없이 계속 배우는 에이전트의 조건을 세 가지로 든다.
- 자기 실력과 세계 상태에 맞는 다음 과제를 스스로 정할 것 (사막에 있으면 철보다 모래, 선인장부터)
- 환경 피드백으로 스킬을 다듬고, 완성된 스킬을 저장해서 다시 쓸 것
- 새 과제를 찾아서 계속 탐험할 것
2. Method
위 세 가지를 세 구성 요소로 만든다.
GPT-4를 블랙박스 API로만 부르고, 파인튜닝이나 gradient 업데이트는 없다.

왼쪽부터 자동 커리큘럼, 반복 프롬프팅, 스킬 라이브러리다.
커리큘럼이 새 과제를 내면 스킬을 꺼내 코드를 짜고, 아래쪽 self-verification이 성공을 확인하면 그 코드가 새 스킬로 라이브러리에 들어간다.
2.1 Automatic Curriculum
뭘 배울지부터 모델이 정한다.
“최대한 다양한 것을 발견하라”는 목표 아래에서, GPT-4가 에이전트의 현재 상태(인벤토리, 장비, 주변 블록, 바이옴, 체력)와 지금까지 성공/실패한 과제 목록을 보고 다음 과제를 낸다.
프롬프트에 “너무 어려운 과제는 내지 마라. 아직 자원과 스킬이 부족할 수 있다”는 지시가 들어 있다. 그래서 실력에 맞춰 난이도가 올라가는 커리큘럼이 된다.

상황에 따라 제안이 달라진다.
- 나무 곡괭이와 돌이 있으면 돌 곡괭이로 업그레이드
- 강 바이옴에서 낚싯대가 있으면 낚시
- 배고픔이 0인데 근처에 돼지가 있으면 사냥
- 밤에 돌검과 방패를 들고 있으면 좀비 사냥
목표는 같아도(“다양한 것을 발견하라”) 상태가 다르면 다른 과제가 나온다.
논문은 이걸 in-context 형태의 novelty search(새로운 상태를 찾는 쪽으로 탐색하는 방법)라고 부른다.
-> 탐험 자체를 보상으로 쓰는 강화학습의 오래된 아이디어를, 학습 없이 프롬프트로 만든 거다.
2.2 Skill Library
과제를 푼 코드는 버리지 않고 스킬로 저장한다.
스킬 하나는 Mineflayer(마인크래프트 봇을 JavaScript로 조종하는 라이브러리) API를 부르는 함수다. 예를 들어 combatZombie(bot)은 무기를 챙기고, 없으면 만들고, 좀비랑 싸우는 절차 전체를 담는다.

저장할 때는 GPT-3.5가 코드 설명을 만들고, 그 설명의 임베딩을 key로, 코드를 value로 벡터 DB에 넣는다.
새 과제가 오면 GPT-3.5가 만든 해결 방향과 환경 피드백을 쿼리로 관련 스킬 top-5를 찾아서 코드 생성 프롬프트에 넣어준다.
논문이 드는 장점은 두 가지다.
- 복잡한 스킬이 단순한 스킬을 불러서 조합되니까 능력이 쌓인다
- 완성된 코드는 안 바뀌니까 catastrophic forgetting(새로 배우면서 예전 것을 잊는 문제)이 없다
2.3 Iterative Prompting Mechanism
코드가 한 번에 완성되지는 않는다. 세 종류의 피드백으로 고쳐 나간다.

- 환경 피드백 : “막대기를 못 만든다. 판자 2개가 더 필요하다” 같은 게임 안 중간 결과
- 실행 에러 : 인터프리터 에러. 없는 아이템(acacia axe)을 만들려던 코드가 에러를 보고 wooden axe로 고쳐짐
- Self-verification(자기 검증) : 별도의 GPT-4가 현재 상태와 과제를 보고 성공 여부를 판단, 실패면 비평을 남김
3번 자기 검증은 이렇게 동작한다.
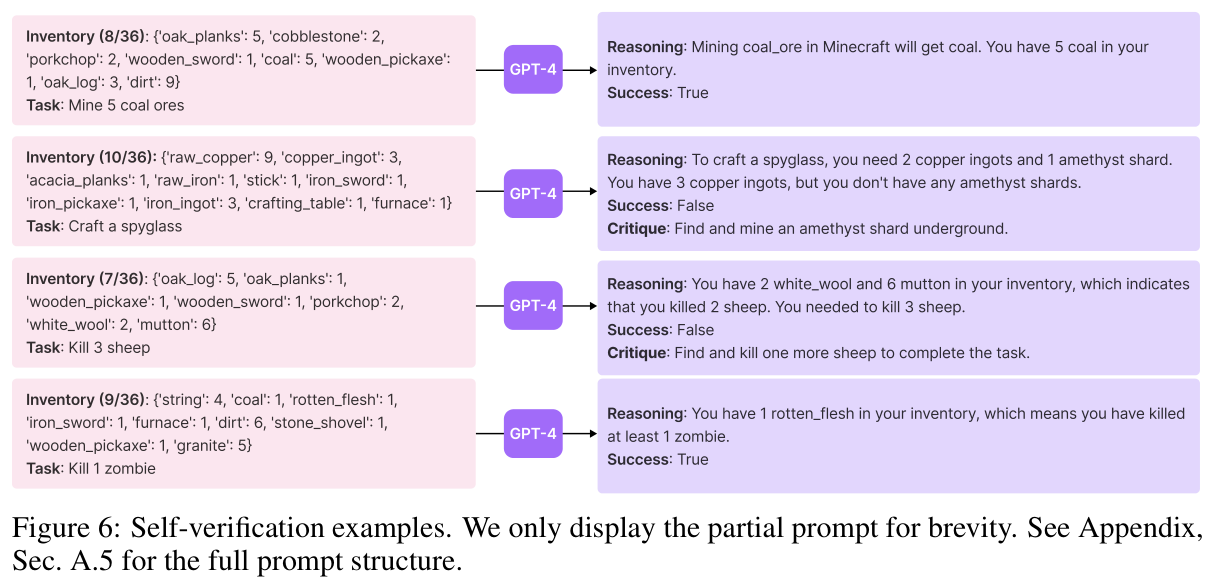
GPT-4가 인벤토리와 과제를 보고 근거(Reasoning)와 성공 여부를 낸다.
양 3마리를 잡는 과제에서는 양털과 양고기 수를 보고 2마리만 잡았다고 판단해 실패로 보고, “한 마리 더 잡아라”는 비평을 남긴다.
생성 → 실행 → 피드백 반영을 반복하다가 자기 검증이 성공을 확인하면 스킬 라이브러리에 넣는다. 계속 실패하면 커리큘럼이 다른 과제를 낸다.
논문은 자기 검증이 Reflexion의 self-reflection보다 포괄적이라고 본다. 실수를 되돌아보는 것에 더해 성공 판정까지 하기 때문이다.
3. Experiments
3.1 Experimental Setup
텍스트 생성에는 gpt-4-0314와 gpt-3.5-turbo-0301, 임베딩에는 text-embedding-ada-002를 쓴다. temperature는 전부 0인데, 과제 다양성을 위해 automatic curriculum만 0.1이다.
환경은 MineDojo 위에 만들고, 캐릭터 조작은 Mineflayer JavaScript API로 한다.
3.2 Baselines
베이스라인은 ReAct, Reflexion, AutoGPT(큰 목표를 하위 목표로 쪼개 스스로 실행하는 오픈소스 에이전트 도구)다. 전부 같은 GPT-4와 같은 Mineflayer API를 쓴다.
3.3 Evaluation Results
탐험 결과는 앞의 Figure 1이다. 고유 아이템 63종으로 베이스라인의 3.3배다.
ReAct와 Reflexion이 거의 못 나아간 이유로 논문은 “다양한 것을 발견하라” 같은 열린 목표가 커리큘럼 없이는 실행하기 어렵다는 점을 든다.
아래 표는 테크 트리 단계(나무 → 돌 → 철 → 다이아몬드 도구)별로 처음 도달하기까지 걸린 프롬프팅 반복 횟수와, 3번 시도 중 성공 횟수다.

나무 도구는 AutoGPT보다 15.3배 빨리 뚫는다(6회 vs 92회 반복). 돌은 8.5배, 철은 6.4배다.
다이아몬드 도구는 Voyager만 도달했다. 다만 3번 중 1번 성공이다.
지도 탐사에서는 여러 지형을 넘나들며 베이스라인의 2.3배 거리를 이동했다. 베이스라인은 좁은 지역에 갇히는 경우가 많다.

주황색 원이 Voyager의 이동 범위다.
-> 커리큘럼이 새 자원을 요구하니 새 지형으로 가야 하고, 이동 스킬이 쌓이니 멀리 갈 수 있게 되는 식으로 도는 것 같다.
새 월드 일반화 실험은 인벤토리를 비우고 처음 보는 월드에서 다이아몬드 곡괭이, 황금 검, 용암 양동이, 나침반을 만들게 한다.
아래 표는 과제 4개 각각의 성공 횟수(3번 중)와 걸린 반복 횟수이고, 그래프는 그중 두 과제의 진행 과정이다. 반복은 최대 50번까지 준다.

Voyager는 4개 전부 3/3 성공이고, 베이스라인은 전부 0/3이다.
그리고 Voyager의 스킬 라이브러리를 AutoGPT에 붙이면 AutoGPT도 일부 과제를 풀기 시작한다. 나침반은 2/3, 다이아몬드 곡괭이와 황금 검은 1/3이다.
쌓아둔 스킬을 다른 에이전트에 옮겨서도 쓸 수 있다는 결과다.
3.4 Ablation Studies
설계 선택 6가지(자동 커리큘럼, 스킬 라이브러리, 환경 피드백, 실행 에러, self-verification, GPT-4)를 하나씩 빼거나 바꿔서 탐험 성능이 어떻게 되는지 본다.

커리큘럼을 랜덤 순서로 바꾸면 발견 아이템이 93% 줄어든다. 순서가 안 맞으면 너무 어려운 과제를 먼저 만나서다. 사람이 직접 짠 커리큘럼도 자동 커리큘럼보다 못한데, 에이전트의 지금 상황을 반영하지 못해서다.
스킬 라이브러리를 빼면 후반에 성장이 멈춘다. 왼쪽 그래프에서 스킬 라이브러리 없는 선이 중반 이후 평평해진다.
피드백 3종 중에서는 self-verification이 제일 중요하다. 빼면 발견 아이템이 73% 줄어든다. 성공인지 판단해야 다음 과제로 갈지 다시 할지를 정할 수 있다.
코드 생성을 GPT-4에서 GPT-3.5로 바꾸면 고유 아이템이 5.7배 적다.
-> self-verification 결과는 Reflexion 리뷰에서 본 Table 3(테스트 생성 없이 반성만 시키면 HumanEval Rust 정확도가 60%에서 52%로 떨어진 실험)이랑 같은 방향이다. 성공했는지 판정하는 부분이 빠지면 나머지 피드백이 있어도 잘 안 된다.
3.5 Multimodal Feedback from Humans
Voyager는 화면을 못 본다. 논문을 쓸 당시 GPT-4 API가 텍스트만 받았기 때문이다.
그래서 사람이 self-verification(눈으로 보고 비평)과 커리큘럼(큰 건축을 단계로 나누기) 역할을 대신하는 실험을 했다.
사람 피드백을 받으면 네더 포탈이나 집 같은 3D 건축까지 한다.

왼쪽에서 오른쪽으로 피드백을 반영하면서 건물이 완성된다.
공간 구조가 틀린 건 Voyager가 직접 알 수 없어서 사람이 봐줘야 한다.
-> 모듈 두 개를 사람으로 바꿔 끼울 수 있을 만큼 역할이 나뉘어 있다는 뜻 같다.
4. Limitations and Future Work
- 비용 : GPT-4 API가 GPT-3.5의 15배. 논문은 그래도 GPT-4 수준의 코드 품질이 필요하다고 봄(GPT-3.5로 바꾸면 고유 아이템 5.7배 감소)
- 환각 : 커리큘럼이 게임에 없는 아이템(구리 검)을 과제로 내거나, 코드가 연료로 못 쓰는 조약돌을 연료로 넣거나 없는 함수를 부름
- 자기 검증 실패 : 거미를 잡았다는 신호인 거미줄을 성공으로 알아보지 못하는 경우
- 시각 없음 : 3.5절에서 본 것처럼 봇 API의 텍스트 상태만 읽음
5. Related work
마인크래프트 의사결정 에이전트(저수준 controller 학습, LLM을 high-level planner로 쓰는 연구), 에이전트 planning에 LLM을 쓰는 연구, 실행 결과를 활용하는 코드 생성 연구를 정리한다.
기존 연구들에는 더 복잡한 행동을 쌓아가는 스킬 라이브러리가 없고, Voyager는 bottom-up 커리큘럼과 환경 피드백·실행 에러·자기 검증을 합친 iterative prompting이 다르다고 한다.
6. Conclusion
스스로 과제를 정하고(automatic curriculum), 성공한 코드를 저장해서 다시 쓰고(skill library), 세 종류의 피드백으로 코드를 다듬는(iterative prompting) 에이전트다.
파인튜닝 없이 마인크래프트 테크 트리를 다이아몬드까지 올라갔고, 쌓은 스킬은 새 월드에서도, 다른 에이전트에 옮겨도 동작했다.
대신 비용이 크고, 환각이 남아 있고, 다이아몬드는 3번 중 1번이다.
모델 가중치는 그대로 두고 검증된 코드를 쌓아서 강해진다는 점이 앞의 에이전트들과 다르다.
7. 지금 관점: 요즘 에이전트의 스킬 저장과 비교
앞에서 본 Reflexion은 실패의 교훈을 자연어 반성문으로, Generative Agents는 경험을 자연어 관찰과 반성으로 저장했다.
Voyager는 실행 가능한 코드로 저장한다.
자연어 기억은 다음 판단 때 참고하는 자료다. 코드 스킬은 그대로 다시 실행되고, 다른 스킬의 부품이 된다.
대신 코드로 남길 수 있는 건 성공 여부를 판정할 수 있는 절차뿐이다.
-> 그래서 self-verification이 이 구조에서 빠지면 안 되는 부분 같다.
검증을 통과한 절차를 스킬로 저장하고, 필요할 때 찾아서 조합한다.
요즘 코딩 에이전트들이 도구나 스킬을 쌓아 두는 방식과 비슷해 보인다. 직접 이어진 건지는 모르겠다.
ReAct와 Reflexion은 과제가 정해져 있을 때는 잘 된다.
뭘 할지부터 정해야 하는 열린 세계에서는 방향을 잡아 줄 커리큘럼과 쌓이는 스킬이 따로 있어야 하는 것 같다.
다음은 CoALA다. 지금까지 본 에이전트들을 기억, 행동, 의사결정 세 가지로 다시 정리한 논문이다.
Leave a comment