
ReAct Paper review
ReAct: Synergizing Reasoning and Acting in Language Models
https://arxiv.org/abs/2210.03629
ReAct는 프린스턴 + Google Brain에서 만든 논문이다. (ICLR 2023)
LLM이 생각(Thought)과 행동(Action)을 번갈아 하면서 문제를 풀게 하는 프롬프팅 방법이다.
LangChain, LangGraph의 ReAct agent도 이 논문 이름을 그대로 쓴다.
1. Introduction
LLM은 reasoning(CoT prompting)과 acting(action plan 생성)이 각각 따로 연구가 되어왔다.
CoT는 모델 내부 지식만으로 생각한다.
외부와 단절된(closed) 상태라 hallucination이 생기고, 초반 reasoning이 틀리면 계속 틀린 방향으로 간다. (error propagation)
Act-only는 계획과 목표 추적 없이 행동만 하니까 복잡한 task를 못 푼다.
그래서 이 논문은 action space를 확장해서 언어로 된 “thought”도 하나의 action처럼 생성하게 한다.
thought는 환경을 바꾸지 않고 context만 업데이트한다.
2. ReAct: Synergizing Reasoning + Acting
Thought → Action → Observation 루프를 반복한다.
- Thought: 현재 context 보고 뭘 해야할지 reasoning (목표 분해, 계획 수정, 예외 처리)
- Action: 외부 환경에 액션 실행
- Observation: 액션 결과를 context에 추가하고 다시 Thought로
논문은 이걸 action space 확장($\hat{A} = A \cup L$)이라고 표현한다.
풀어보면 간단하다.
원래 에이전트가 고를 수 있는 행동은 search[...], finish[...]처럼 정해진 목록($A$)뿐이었다.
여기에 “아무 문장이나 혼잣말하기”($L$)를 행동 목록에 추가했다. 생각하기도 행동의 한 종류로 친다.
차이는 혼잣말은 환경을 바꾸지 않고, 다음 판단에 쓸 context에만 쌓인다는 점이다.
그런데 정해진 행동은 몇 개 안 되지만 할 수 있는 혼잣말은 무한하다.
이 중에서 지금 도움이 되는 문장을 골라내는 건 처음부터 학습시키기엔 너무 어렵고, 이미 언어를 잘 아는 LLM(강한 언어 prior)을 가져다 쓰니까 가능하다고 한다.
-> LLM 이전에 RL로 이 구조를 만들려 했으면 탐색할 문장이 너무 많아서 안 됐을 것 같다.
논문이 예시로 드는 thought의 역할은 이렇다.
- 목표를 subgoal로 분해하고 action plan 수립
- 태스크에 필요한 상식 주입 (“후추통은 캐비닛이나 조리대에 있을 것”)
- observation에서 중요한 부분 추출
- 진행 상황 추적과 plan 전환
- 예외 처리와 plan 수정

CoT(1b)는 그럴듯하게 추론하다가 환각으로 틀린다.
Act-only(1c)는 검색만 하다가 답을 못 찾는다.
ReAct(1d)는 검색 결과를 보고 생각을 고쳐가며 정답에 도달한다.
(2)의 ALFWorld도 같은 패턴이다.
Act-only(2a)는 후추통을 찾으려고 서랍과 싱크대를 뒤지다가 안 되는 행동만 반복한다(“Nothing happens”).
ReAct(2b)는 Think로 “후추통은 캐비닛이나 조리대에 있을 확률이 높다”고 위치부터 추론해서 조리대에서 찾는다. 찾은 뒤엔 “이제 서랍에 넣어야지”라고 다음 subgoal을 세워서 성공한다.
few-shot 예시는 사람이 직접 작성한 trajectory 몇 개가 전부다. (HotpotQA 6개, FEVER 3개, ALFWorld 2개, WebShop 1개)
trajectory는 Thought/Action/Observation으로 문제를 푸는 전체 풀이 과정 기록이다.
모델은 PaLM-540B 사용. 학습 없이 prompting만으로 동작.
task 성격에 따라 thought 배치를 다르게 한다.
- 지식 task(QA): 매 스텝마다 thought-action 교차 (dense)
- 의사결정 task(ALFWorld): 필요할 때만 thought 생성 (sparse). 언제 생각할지는 모델이 스스로 정한다
논문은 이 설계의 특징을 4가지로 정리한다.
첫째는 Intuitive and easy to design. 어노테이터가 자기가 한 행동 위에 생각을 언어로 적기만 하면 되고, 특별한 포맷 설계나 예시 선정 기법은 쓰지 않았다.
둘째는 General and flexible. thought space가 자유로워서 QA, 사실 검증, 텍스트 게임, 웹 탐색처럼 액션 스페이스가 전혀 다른 태스크에 모두 적용된다.
셋째는 Performant and robust. in-context 예시 1~6개만으로 새 태스크 인스턴스에 일반화되고, reasoning만 하거나 acting만 하는 베이스라인보다 성능이 좋다.
넷째는 Human aligned and controllable. 추론 과정을 사람이 읽고 검사할 수 있고, 중간에 thought를 고쳐서(thought editing) 에이전트 행동을 바로잡을 수도 있다.
-> 4번은 지금으로 치면 agent 관측가능성(observability)과 human-in-the-loop이다. 에이전트가 왜 그 행동을 했는지 로그로 추적할 수 있는 것도 thought를 언어로 남기기 때문이다.
3. Knowledge-Intensive Reasoning Tasks
HotpotQA랑 FEVER 두 가지로 실험한다.
3.1 Setup
HotpotQA는 위키 문서 두 개 이상을 넘나들어야 답이 나오는 multi-hop QA다.
FEVER는 주장에 대해 SUPPORTS / REFUTES / NOT ENOUGH INFO를 판정하는 사실 검증 태스크다.
둘 다 질문(주장)만 주어지는 세팅이라, 모델이 근거를 직접 검색해서 찾아야 한다.
액션은 Wikipedia API 3개가 전부다.
search[entity]: 해당 entity 페이지 첫 5문장 or 유사 페이지 top-5lookup[string]: 페이지 내 문자열 검색 (Ctrl+F 같은거)finish[answer]: 답 제출
3.2 Methods
ReAct 말고 ReAct랑 CoT-SC(CoT 답을 여러 개 뽑아 다수결하는 self-consistency)를 섞는 방법도 두 가지 넣었다.
- ReAct → CoT-SC : ReAct가 정해진 스텝(HotpotQA 7, FEVER 5) 안에 답을 못 찾으면 CoT-SC로 fallback
- CoT-SC → ReAct : CoT-SC 다수결 confidence가 낮으면 ReAct로 전환
왜 섞는지는 아래 결과를 보면 나온다.
finetuning도 해본다. HotpotQA에서 ReAct trajectory 3,000개로 작은 모델(PaLM-8B, 62B)을 finetuning 했다.
3.3 Results and Observations
아래는 PaLM-540B를 프롬프팅해서 HotpotQA(EM, 정답과 정확히 일치한 비율)와 FEVER(정확도)를 잰 결과다.
HotpotQA EM 기준: Standard(생각 없이 바로 답) 28.7 / CoT 29.4 / Act-only 25.7 / ReAct 27.4

ReAct 단독은 HotpotQA에서 CoT보다 오히려 낮다.
논문은 이 결과도 그대로 두고 분석한다.
반대로 FEVER에서는 ReAct(60.9)가 CoT(56.3)를 이긴다. 사실 검증은 최신의 정확한 지식을 가져오는 게 중요해서라고 본다.
HotpotQA에서 진 이유는 error analysis에 나온다. HotpotQA에서 ReAct와 CoT가 맞히거나 틀린 궤적을 사람이 보고 유형별로 나눈 것이다.
- CoT 실패의 56%가 hallucination이다. 대신 reasoning 구조는 유연하다
- ReAct는 사실 기반이다. 맞힌 것 중에 hallucination이 섞인 비율이 ReAct 6%, CoT 14%다
- 대신 ReAct는 검색 결과가 안좋으면 reasoning이 같이 망가진다(실패의 23%가 search error). 같은 thought-action을 반복하는 루프에 빠지기도 한다

-> 그러면 HotpotQA에서 ReAct가 진 건 검색 도구가 Wikipedia API 3개뿐이라서 그런 건가??
그래서 둘을 섞은 방법이 prompting 방법 중 제일 높다. HotpotQA는 ReAct → CoT-SC가 35.1, FEVER는 CoT-SC → ReAct가 64.6이다.

CoT-SC 샘플 3~5개만 써도 순수 CoT-SC가 샘플 21개로 내는 성능에 도달한다.
내부 지식과 외부 지식을 상황에 맞게 섞어 쓰는 게 효과가 있다는 결과다.
finetuning 결과는 이렇다.
- prompting에서는 작은 모델일수록 ReAct가 4가지 방법 중 최하위다. 형식을 따라하기가 어렵다
- finetuning 하면 역전된다. finetuned PaLM-8B ReAct가 prompted PaLM-62B를 이기고, finetuned 62B가 prompted 540B를 이긴다
- Standard/CoT를 finetuning하는 건 지식 암기를 배우는 거라 효과가 적고, ReAct finetuning은 “지식을 찾는 방법”을 배우는 거라 일반화가 잘된다고 한다

-> 요즘 작은 모델을 agent trajectory로 SFT하는 방식도 이 실험과 같은 방향이다.
4. Decision Making Tasks
두 태스크 모두 성공률(%)로 비교한다.
ALFWorld(텍스트 기반 집안일 시뮬레이터): ReAct 71% vs Act-only 45% vs BUTLER(전문가 궤적을 따라 배우는 imitation learning 에이전트) 37%
WebShop(쇼핑 사이트 시뮬레이터): ReAct 40% vs IL(imitation learning, 사람 시연 1,012개로 학습) 29.1% vs IL+RL(여기에 강화학습을 더함) 28.7%
in-context 예시 1~2개 프롬프팅으로 학습 기반 방법을 이겼다.
아래는 ALFWorld 태스크 유형별 성공률(Table 3)과 WebShop 점수·성공률(Table 4)이다.

2022년 기준으로는 꽤 큰 결과다.
thought가 goal을 subgoal로 분해하고 진행 상황을 추적해준 덕분이다. Act-only는 중간에 자기가 뭘 하고 있었는지 잊어버린다.
ablation으로 Inner Monologue(환경 피드백을 언어로 받아 다음 행동을 정하는 이전 방법) 스타일(ReAct-IM)과도 비교한다.
IM처럼 “환경 상태 관찰 + 목표 확인” 수준의 생각만 하게 하면 ALFWorld가 71 → 53으로 떨어진다.
목표를 subgoal로 분해하는 것과 물건이 어디 있을지 상식으로 추론하는 게 빠지기 때문이라고 한다.
-> 생각을 시키는 것 자체보다 어떤 생각을 시키느냐가 중요한 것 같다.
다만 WebShop에서 인간 전문가(점수 82.1 / 성공률 59.6)와는 차이가 크다.
사람은 상품 탐색과 질의 재구성을 훨씬 능동적으로 한다. 2022년의 프롬프팅으로는 아직 못 따라가는 부분이었다.
부록(A.1)에서 GPT-3(text-davinci-002)로도 재현한다.
ReAct 프롬프팅 기준으로 GPT-3가 HotpotQA 30.8 vs PaLM-540B 29.4, ALFWorld 78.4 vs 70.9로 더 높다 (논문 Table 5).
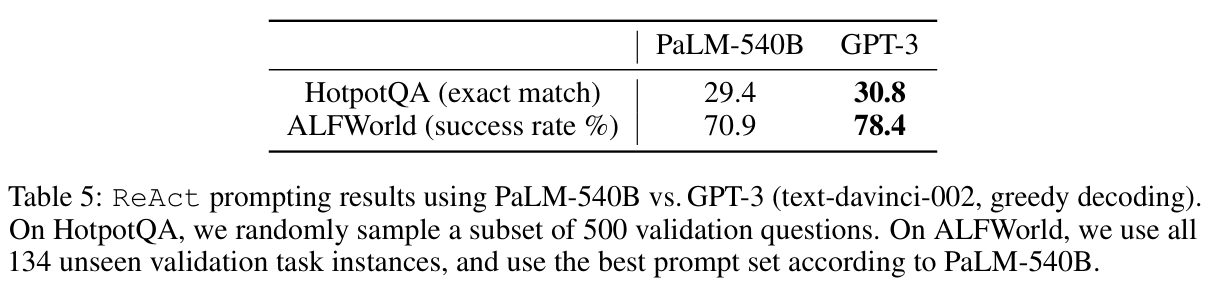
HotpotQA는 검증셋에서 무작위로 뽑은 500문제로 따로 잰 것이라, PaLM ReAct 점수가 Table 1의 27.4와 다르다.
instruction following으로 파인튜닝된 모델이라 그럴 수 있다고 추정하고, ReAct가 특정 모델에만 통하는 방법은 아니라는 근거로 든다.
5. Related Work
reasoning 쪽(CoT, least-to-most, self-consistency, STaR 등)과 decision making 쪽(WebGPT, SayCan, Inner Monologue 등) 연구를 정리한다.
ReAct는 고정된 reasoning에 그치지 않고 action과 observation을 같은 입력 흐름에 넣는다는 점, 비싼 사람 피드백 없이 reasoning 과정의 언어 설명만으로 정책을 배운다는 점이 다르다고 한다.
6. Conclusion
thought와 action을 한 루프에서 번갈아 돌리면 CoT의 환각과 Act-only의 계획 부족을 서로 보완한다고 한다.
단독으로 만능은 아니다. HotpotQA에서는 CoT보다 낮아서, CoT-SC fallback이나 finetuning으로 보완한다.
여태까지 reasoning과 acting을 따로 연구했다면, 이 방법은 thought를 action의 하나로 넣어서 한 루프 안에서 같이 돌린다.
덧붙이면 1저자 Shunyu Yao는 이후 Tree of Thoughts를 냈고 SWE-bench에도 참여했다.
7. 지금 관점: LangChain create_agent와 비교
논문의 Thought → Action → Observation 루프가 코드로는 어떻게 되어 있는지 보자.
LangChain v1의 create_agent로 논문의 HotpotQA 세팅을 흉내내면 이렇다.
from langchain.agents import create_agent
from langchain_core.tools import tool

@tool
def search(entity: str) -> str:
    """위키피디아에서 entity를 검색해 첫 5문장을 반환한다."""
    return wiki_api.search(entity)

@tool
def lookup(keyword: str) -> str:
    """현재 페이지에서 keyword가 포함된 다음 문장을 반환한다."""
    return wiki_api.lookup(keyword)

agent = create_agent(
    model="anthropic:claude-sonnet-4-6",
    tools=[search, lookup],
    system_prompt="질문에 답하기 위해 검색 도구를 사용해라.",
)

result = agent.invoke(
    {"messages": [{"role": "user", "content": "Apple Remote와 호환되는 다른 기기는?"}]}
)
논문의 finish[answer]는 tool로 안 만들어도 된다. 이유는 뒤에 나온다.
7.1 내부 루프
create_agent는 model 노드와 tools 노드를 가진 graph를 만든다.
model 노드가 메시지 리스트로 LLM을 호출한다.
응답 AIMessage에 tool_calls가 있으면 tools 노드가 실행되고, 결과를 ToolMessage로 메시지 리스트에 추가한다. 그리고 다시 model 노드 호출.
tool_calls가 없는 응답이 나올 때까지 반복한다.
의사코드로 쓰면 이게 전부다.
def agent_loop(messages):
    while True:
        ai_msg = model.invoke(messages)      # Thought + Action 생성
        messages.append(ai_msg)

        if not ai_msg.tool_calls:            # Action이 없으면 = finish
            return messages

        for tc in ai_msg.tool_calls:         # Action 실행
            result = tools[tc["name"]].invoke(tc["args"])
            messages.append(ToolMessage(result, tool_call_id=tc["id"]))
                                             # Observation 추가
7.2 논문 ↔ 구현 매핑
Thought는 AIMessage의 content에 들어간다. tool_calls와 같이 생성된다.
Action은 AIMessage의 tool_calls, Observation은 ToolMessage다.
finish[answer]는 따로 없다. tool_calls가 없는 AIMessage가 나오면 루프가 끝난다.
trajectory(context 누적)는 messages 리스트 그대로다.
7.3 논문과 달라진 점
원논문(2022)은 function calling이 없던 시절이라 순수 텍스트로 동작했다.
Thought 1: Apple Remote를 검색해서 호환 기기를 찾아야겠다.
Act 1: Search[Apple Remote]
Obs 1: The Apple Remote is a remote control ...
이 텍스트를 정규식으로 파싱해서 Search[...]를 뽑아 실행했다.
그래서 모델이 형식을 조금만 틀려도 파싱이 깨졌다.
-> finetuning 부분에서 작은 모델이 ReAct 형식을 잘 못 따라했던 것도 이 파싱 문제와 연결되는 건가??
지금은 모델의 native function calling으로 Action이 구조화된 JSON(tool_calls)으로 나오니 파싱이 필요없다.
sparse thought도 그냥 된다.
모델이 content 없이 tool_calls만 뱉으면 Act-only 스텝이고, content를 채우면 Thought가 있는 스텝이다. 논문에서 “모델이 스스로 언제 생각할지 결정한다”고 했던 부분이다.
create_agent는 ReAct 루프에서 텍스트 파싱을 function calling으로 바꾸고 graph로 감싼 형태다.
-> 프레임워크는 바뀌었지만 안에서 도는 루프는 논문 때와 같다.
다음은 Reflexion이다. ReAct 루프가 실패하면 그 실패를 언어로 반성해 두고 다음 시도에 넣는다.
Leave a comment