
Reflexion Paper review
Reflexion: Language Agents with Verbal Reinforcement Learning
https://arxiv.org/abs/2303.11366
Reflexion은 Northeastern, MIT, Princeton에서 만든 언어 에이전트 연구로, arXiv에 올라온 논문이다.
지난 ReAct 리뷰의 저자 Shunyu Yao가 공저자로 들어간 후속 연구다.
ReAct의 Thought → Action → Observation 루프에 실패에서 배우는 단계를 붙인다.
1. Introduction
LLM 에이전트도 시행착오로 배우게 하고 싶다.
그런데 전통적인 강화학습(RL)으로 하려면 문제가 있다. 샘플이 대량으로 필요하고, 모델 파인튜닝 비용이 비싸다.
LLM 에이전트는 보통 API 뒤에 있는 거대 모델이라 가중치 업데이트 자체가 어렵기도 하다.
그래서 이 논문은 가중치 대신 말로 강화하자고 한다.
실패하면 “왜 실패했는지”를 언어로 반성하고, 그 반성문을 메모리에 쌓아두고, 다음 시도의 컨텍스트에 넣어준다.
gradient 업데이트가 한 번도 없는데 시도할수록 잘해진다.

의사결정, 코딩, 추론 세 도메인 모두 같은 패턴이다.
시도 → 실패 신호 → 반성(“팬이 stoveburner 1에 없었으니 2를 봐야 했다”) → 다음 시도에서 교정.
2. Related work
reasoning·decision making 쪽(Self-Refine, critic 모델 파인튜닝, beam search 등)과 프로그래밍 쪽(AlphaCode, CodeT, Self-Debugging, CodeRL) 연구를 정리한다.
이 방법들은 자기 평가나 실행 피드백은 쓰지만, 자기 반성을 쌓아두는 기억으로 실수에서 교훈을 남기지는 않는다고 한다.
3. Reflexion: reinforcement via verbal reflection
프레임워크는 모듈 3개와 메모리로 구성된다.
- Actor : 텍스트와 행동을 생성하는 LLM. CoT나 ReAct를 그대로 Actor로 쓴다
- Evaluator : Actor가 만든 trajectory(한 번 시도한 행동·관찰 기록)에 점수를 매긴다. exact match, 휴리스틱 룰, LLM 판정 중 태스크에 맞는 걸 쓴다
- Self-Reflection : 실패 신호 + trajectory를 보고 “무엇이 잘못됐고 다음엔 어떻게 해야 하는지”를 언어로 생성하는 LLM
Evaluator는 꼭 LLM이 아니다. 추론은 정답 문자열 비교, ALFWorld는 손으로 짠 휴리스틱을 쓴다.
메모리는 두 층이다.
- 단기 기억: 현재 trial의 trajectory
- 장기 기억: 같은 태스크를 여러 trial 푸는 동안 쌓인 반성문 (최대 1~3개로 제한)
여기서 장기 기억은 trial 사이에 넘겨주는 기억이다. 세션을 넘어 저장하는 기억은 아니다.

알고리즘은 단순하다.
시도하고, 평가하고, 실패면 반성문을 메모리에 추가하고, 통과하거나 max trial에 걸릴 때까지 반복한다.
논문은 반성문이 스칼라 reward보다 정보가 많다고 본다.
RL의 reward는 “0점이었다”만 알려주지만, 반성문은 “어디서 무엇을 잘못했고 대신 뭘 해야 하는지”를 알려준다. 이게 논문 제목의 verbal reinforcement다.
피드백은 형태(scalar 값 또는 자유형 텍스트)와 출처(외부 또는 내부에서 시뮬레이션)를 가리지 않고 받을 수 있다고 한다.
실제 실험에서 쓴 건 세 가지다.
- 환경이 주는 binary 피드백
- 자주 나오는 실패를 잡는 사전 정의 휴리스틱
- 자기 평가 (의사결정은 LLM의 binary 분류, 코딩은 스스로 만든 unit test)
4. Experiments
의사결정, 추론, 코딩 세 도메인에서 실험한다.
4.1 Sequential Decision Making: ALFWorld
ReAct 리뷰에서 봤던 그 텍스트 집안일 시뮬레이터다. Actor로 ReAct를 쓰고 Reflexion을 얹었다.
같은 행동을 3번 넘게 반복하거나 행동이 30번을 넘으면 실패로 보고 반성하게 하는 간단한 휴리스틱을 Evaluator로 쓴다.

12번의 trial을 거치며 134개 태스크 중 130개(97%)를 푼다.
ReAct 단독은 trial 6~7 사이에서 더 이상 나아지지 않는다.
오른쪽 그래프는 실패 원인을 나눠본 것이다.
ReAct 단독은 hallucination 비율이 22%에 수렴한 채 회복하지 못한다. Reflexion은 trial이 거듭될수록 hallucination과 비효율적 계획이 거의 사라진다.
장기 기억이 도움이 되는 경우는 두 가지라고 한다.
- 긴 trajectory 초반의 실수를 반성으로 찾아내는 것
- “어디를 이미 뒤져봤는지”를 여러 trial에 걸쳐 기억해서 방을 차례대로 수색하는 것
4.2 Reasoning: HotpotQA
HotpotQA(위키피디아 문서 여러 개를 거쳐 답하는 multi-hop QA)에서 100문제를 뽑아 추론이 좋아지는지 본다.
피드백은 exact match(정답 문자열과 일치하는지)의 binary 신호뿐이고, 반성문이 이 빈약한 신호를 키워준다.
Actor는 위키피디아 검색을 하는 ReAct, 검색 없이 푸는 CoT, 정답 문맥(ground truth context)을 같이 주는 CoT (GT) 세 가지다.

Reflexion을 붙이면 baseline보다 20% 오른다.
CoT (GT)는 정답 문맥을 받고도 39%를 틀리는데, Reflexion을 붙이면 정답을 보지 않고도 14% 오른다.
부록 Table 5에서 모델별로 보면 ReAct + gpt-4는 0.39 → 0.51, CoT (GT) + gpt-4는 0.68 → 0.80이다.
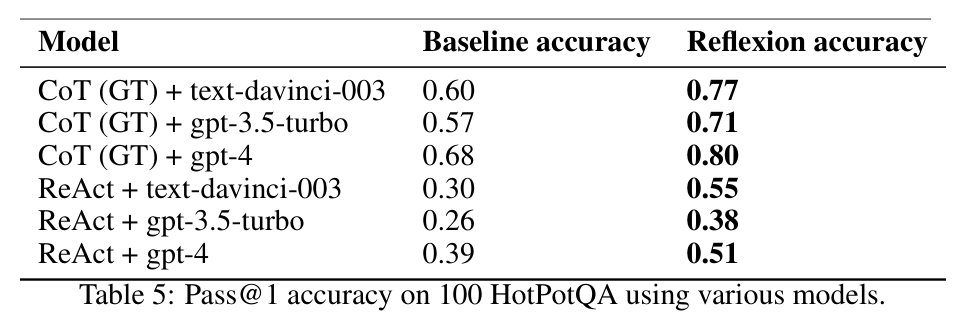
baseline의 재시도는 다르다. ReAct-only, CoT-only에 temperature 0.7로 재시도를 시켜도 첫 trial에 틀린 문제는 하나도 더 못 푼다.
-> 그냥 다시 굴리는 걸로는 안 되고, 뭐가 틀렸는지 말로 알려줘야 나아지는 것 같다.
ablation도 있다.
반성문 없이 직전 trajectory만 컨텍스트에 넣어주는 episodic memory(EPM)와 비교하면, self-reflection이 8%p를 더 얻는다.
-> 기억을 주는 것과 교훈을 주는 것은 다르다.
4.3 Programming
HumanEval, MBPP(둘 다 함수 하나를 짜는 Python 코딩 벤치마크)와 이를 Rust로 옮긴 버전, 그리고 LeetcodeHardGym으로 본다.
LeetcodeHardGym은 이 논문이 새로 만든 벤치마크로, GPT-4 사전학습 컷오프(2022-10-08) 이후 나온 Leetcode hard 문제 40개다.
코딩은 Reflexion에게 유리한 도메인이다. 스스로 unit test를 만들어 실행하면 근거 있는 내부 피드백을 얻을 수 있기 때문이다.
테스트 만드는 방법은 이렇다.
- CoT로 테스트를 생성한다
- AST(파이썬 구문 트리)로 문법 검증을 한다
- 최대 6개를 추린다
정답 테스트를 참조하지 않으니 pass@1(한 번 낸 답이 정답 테스트를 통과하는 비율)로 보고할 수 있다.
Table 1은 벤치마크·언어별 pass@1을 이전 SOTA, GPT-4 단독과 비교한 것이다.

HumanEval Python에서 pass@1 91.0으로 당시 SOTA였던 GPT-4(80.1)를 크게 넘었다.
Rust에서도 60.0 → 68.0으로 오른다. 언어에 종속된 방법은 아닌 것 같다.
Leetcode hard 문제에서도 7.5 → 15.0으로 두 배가 된다.
MBPP Python은 77.1로 GPT-4(80.1)보다 낮다.
원인은 자기가 만든 테스트의 신뢰도라고 한다.
테스트를 다 통과했는데 실제로는 틀린 코드일 확률(false positive)이 HumanEval은 1.4%인데 MBPP는 16.3%나 된다.
Table 2는 HumanEval·MBPP에서 base와 Reflexion의 정확도, 그리고 자체 생성 테스트의 오판 비율을 같이 보여준다.
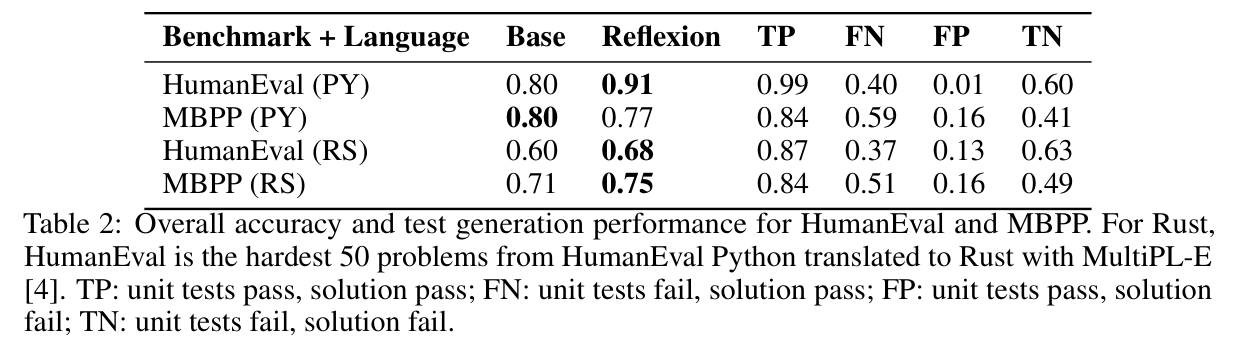
FP 열이 “테스트는 통과했는데 코드는 틀린” 비율이다.
Python 두 벤치마크 중 FP가 큰 MBPP Python에서만 Reflexion이 Base보다 낮다.
-> 테스트가 틀린 코드를 통과시키면 반성할 기회 자체가 없다.
Table 3은 HumanEval Rust에서 가장 어려운 50문제로 테스트 생성과 반성을 하나씩 뺀 ablation이다. 모델은 GPT-4.

테스트 실행 없이 반성만 시키면 0.60 → 0.52로 base보다 떨어진다.
지금 코드가 맞는지 판단할 수 없어서 멈추지 못하고 계속 고치다 망가뜨린다고 한다.
반성 없이 테스트만 돌리면 0.60 그대로다. 둘 다 있어야 0.68로 오른다.
이 실험에서는 근거 없는 반성이 오히려 성능을 떨어뜨렸다. 다만 50문제짜리 ablation 하나라 어디까지 일반화되는지는 모르겠다.
5. Limitations
- 전체가 Evaluator의 정확도에 의존한다. 코딩의 false positive 문제가 대표적
- 장기 기억을 최대 개수가 정해진 sliding window로 잘라서 쓴다. 논문은 벡터 DB나 SQL DB 같은 구조로 넓히는 걸 향후 과제로 둔다
- 국소최적에 빠질 수 있다. 반성이 잘못된 방향을 가리키면 그쪽으로 계속 판다
- 테스트 기반 방식은 비결정적 함수, 외부 API를 부르는 함수, 병렬 코드처럼 입출력을 정하기 어려운 경우에 약하다
-> 반성이 잘못됐는지는 누가 판단하지??
6. Broader impact
에이전트가 외부 환경과 더 많이 상호작용하게 되면 자동화가 늘어나는 만큼 오용 위험도 커져서, 안전·윤리 쪽 노력이 더 필요하다고 한다.
반대로 언어로 된 반성은 블랙박스였던 RL 정책보다 해석하기 쉬워서, 도구를 쓰기 전에 반성 내용을 보고 의도를 확인하는 식으로 쓸 수 있다고 한다.
7. Conclusion
Reflexion은 ReAct 루프에 실패에서 배우는 단계를 더했다.
가중치를 하나도 안 바꾸고, 실패 경험을 반성문으로 바꿔 메모리에 쌓는 것만으로 시도할수록 잘해지는 에이전트가 된다.
강화학습의 스칼라 reward 대신 언어를 학습 신호로 쓰는 verbal RL이다.
단, 반성은 근거가 있을 때 효과가 있었다. 테스트 없이 반성만 시킨 실험에서는 base보다 떨어졌다 (Table 3).
8. 지금 관점: LangGraph로 만들 때와 비교
지금 보면 Reflexion 루프는 낯설지 않다.
코딩 에이전트가 테스트를 돌리고, 실패하면 에러 로그를 읽고, 어디서 틀렸는지 정리한 뒤 코드를 고쳐서 다시 시도한다.
Actor(코드 생성) → Evaluator(테스트 실행) → Self-Reflection(에러 분석) → 재시도와 같은 순서다.
ReAct는 LangChain create_agent 한 줄로 만들 수 있었는데, Reflexion은 agent 루프 바깥에 평가와 반성을 두는 구조라 LangGraph(LangChain의 그래프 기반 에이전트 라이브러리)로 그래프를 직접 짠다.
LangChain 공식 블로그 Reflection Agents는 이 계열을 Basic Reflection(생성과 비평 반복), Reflexion(비평을 구조화하고 검색 근거를 붙임), LATS(트리 탐색까지 붙인 방법) 순서로 정리해뒀다.
아래는 블로그가 링크한 공식 노트북에서 출력 스키마와 그래프 조립만 일부 발췌한 것이다.
원본은 지금은 사라진 MessageGraph 기반이라 그래프 부분은 현재 API(StateGraph + add_messages)로 바꿔 적었다.
from pydantic import BaseModel, Field

class Reflection(BaseModel):
    missing: str = Field(description="답변에서 부족한 점에 대한 비평")
    superfluous: str = Field(description="답변에서 불필요하게 과한 점에 대한 비평")

class AnswerQuestion(BaseModel):
    """답변, 자기 비평, 개선용 검색 쿼리를 한 번에 생성한다."""
    answer: str = Field(description="질문에 대한 250단어 내외의 상세한 답변")
    reflection: Reflection = Field(description="초안 답변에 대한 자기 비평")
    search_queries: list[str] = Field(description="비평을 해소하기 위해 조사할 검색 쿼리 1~3개")

class ReviseAnswer(AnswerQuestion):
    """검색 근거를 인용하며 이전 답변을 수정한다."""
    references: list[str] = Field(description="수정된 답변의 근거가 되는 인용 출처들")
한 번의 호출에서 답변, 부족한 점(missing), 과한 점(superfluous), 검색 쿼리가 구조체로 같이 나온다. 수정 단계에서는 인용(references)까지 필드로 강제한다.
from typing import Annotated
from typing_extensions import TypedDict
from langgraph.graph import StateGraph, START, END
from langgraph.graph.message import add_messages

class State(TypedDict):
    messages: Annotated[list, add_messages]

# first_responder / execute_tools / revisor 는 위 스키마로 LLM과 검색 도구를 부르는 노드 (정의는 노트북 참고)
MAX_ITERATIONS = 5
builder = StateGraph(State)
builder.add_node("draft", first_responder.respond)
builder.add_node("execute_tools", execute_tools)
builder.add_node("revise", revisor.respond)
builder.add_edge(START, "draft")
builder.add_edge("draft", "execute_tools")
builder.add_edge("execute_tools", "revise")

def event_loop(state: State):
    num_iterations = sum(m.type == "tool" for m in state["messages"])  # 도구 실행 횟수 = 반복 수
    return END if num_iterations > MAX_ITERATIONS else "execute_tools"

builder.add_conditional_edges("revise", event_loop, ["execute_tools", END])
graph = builder.compile()
논문과 맞춰 보면 draft·revise 노드가 Actor, 스키마의 reflection 필드가 Self-Reflection, execute_tools의 웹 검색이 반성의 근거(논문 코딩 실험에서는 unit test), MAX_ITERATIONS가 max trials다.
다른 점도 있다. 논문은 Evaluator가 따로 있는데 여기서는 비평을 Actor 출력에 합쳤다.
그리고 누적되는 메시지 리스트는 한 번의 실행 안에서만 유지되니, 논문으로 치면 trial을 넘어가는 장기 기억보다 단기 기억(trajectory)에 가깝다.
-> Table 3에서 테스트 없이 반성만 시키면 떨어졌는데, 이 구현에서는 검색 결과가 그 테스트 자리를 대신하는 것 같다.
에이전트에 붙는 memory 설계도 비슷하다.
세션에서 얻은 교훈을 파일로 남겨두고 다음 세션 컨텍스트에 넣어주는 패턴은 Reflexion의 장기 기억과 같은 발상이다.
논문은 한 태스크의 trial 사이에서만 넘겨줬고, 이건 세션을 넘어간다.
판정이 부정확한 상태(멋대로 만든 테스트, 어설픈 LLM-judge)에서 반성을 붙이면 기대만큼 안 오를 수 있다.
Table 3은 작은 실험이지만 그 방향을 보여준다.
-> 에이전트 루프를 만들 때 반성 프롬프트보다 판정이 얼마나 확실한지를 먼저 봐야 할 것 같다.
다음은 Toolformer다. 모델이 API를 언제 부를지 스스로 배우게 한다.
Leave a comment