
Dynamic Concurrency Paper review
When Sub-Agents Work in Parallel: The Promises and Pitfalls of Dynamic Concurrency in Long-Horizon Coding Tasks
https://arxiv.org/abs/2610.10263
이 논문은 난징대(Nanjing University)와 UIUC 등에서 쓴 실증 연구다.
Codex, Claude Code, Kimi Code 세 코딩 에이전트에 들어 있는 “메인 에이전트가 실행 중에 서브에이전트를 띄울지 스스로 정하는” 기능, 논문 용어로 dynamic concurrency 를 켠 경우와 끈 경우를 같은 과제에서 비교한다.
arXiv 에 올라온 논문이고 저자는 4명이다.
앞에서 본 GenericAgent에서는 Claude Code 같은 범용 에이전트의 컨텍스트 밀도를 다뤘는데, 이 논문은 같은 에이전트의 병렬 실행 쪽을 본다.
1. Introduction
코딩 에이전트가 다루는 과제가 길어지면 에이전트 하나의 컨텍스트와 실행 용량이 모자라게 된다.
그래서 여러 서브에이전트로 일을 나누는 멀티에이전트가 나왔는데, 논문은 이걸 두 세대로 나눈다.
앞 세대는 static concurrency 다. TRAE, OpenHands 처럼 서브에이전트의 수와 역할, 동기화 지점을 개발자가 미리 워크플로로 정해 둔다.
최근의 frontier 코딩 에이전트는 dynamic concurrency 로 간다. 메인 에이전트가 실행 도중에 과제 상태를 보고 서브에이전트를 띄울지, 언제, 어떻게 띄울지 정한다.
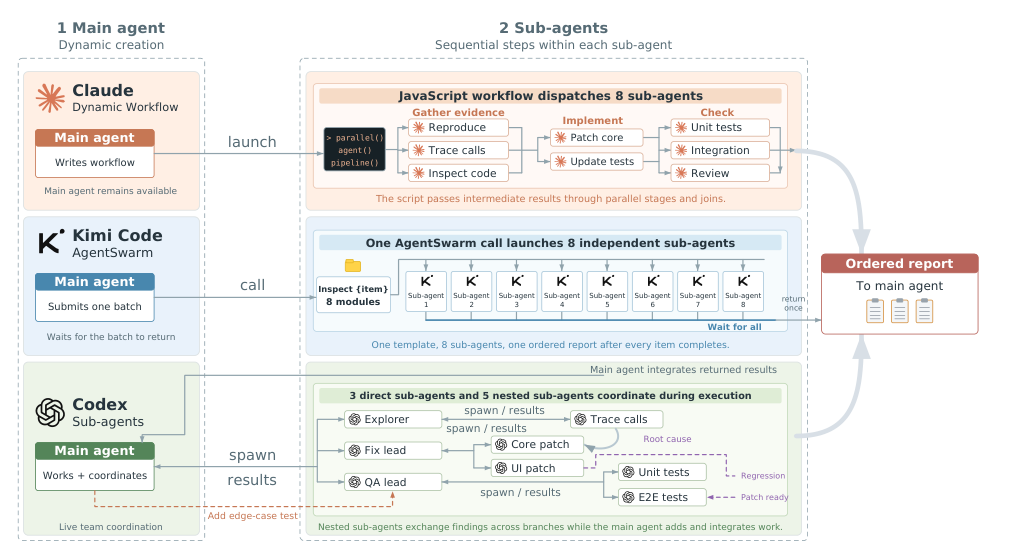
Claude Code 의 Dynamic Workflow 는 메인 에이전트가 JavaScript 워크플로 스크립트를 직접 써서 병렬 단계와 의존성, 합류 지점을 지정한다.
Kimi Code 의 AgentSwarm 은 같은 템플릿에서 서브에이전트 한 배치를 띄운 뒤 전부 끝나길 기다려 정렬된 보고서를 받는다.
Codex 는 서브에이전트를 직접 또는 중첩해서 띄우면서 메인 에이전트 자신도 계속 일하고 메시지를 주고받는다.
기존 평가는 단일 에이전트거나 미리 정해진 협업 프로토콜을 쓰는 멀티에이전트에 몰려 있었고, 과제도 SWE-bench 처럼 수십 줄 패치로 끝나는 것이 대부분이었다.
dynamic concurrency 는 레포지토리 생성이나 릴리스 개발처럼 수만 줄을 써야 하는 long-horizon 과제를 겨냥한 기능인데, 거기서 어떻게 동작하는지는 알려진 게 없었다.
그래서 long-horizon 벤치마크 4개(RepoZero, ProgramBench, NL2Repo, LoopsBench)에서 254개, 비교용으로 SWE-bench Verified 에서 100개, 합계 354개 과제를 세 에이전트 × 두 모드로 돌렸다.
실행 2,124건, 기록된 토큰 112억 개, 표준 API 단가로 20,780.02달러다.
과제 통과율의 변화는 11.9 퍼센트포인트 하락에서 2.3 포인트 상승 사이고, 토큰은 순차 모드의 1.41~3.31배다.
가장 긴 과제인 LoopsBench 에서는 이득이 있고 SWE-bench Verified 에서는 없다.
실패 궤적을 사람이 읽어 4개 대분류, 13개 소분류, 28개 패턴의 분류표를 만들었다(Cohen’s κ = 0.77).
이득이 나는 조건으로는 상보적 작업, 대안 탐색, 독립 검증 셋을 꼽는다.
2. Background and Related Work
ChatDev, MetaGPT 는 역할과 개발 워크플로를 미리 정하고, CodeR 은 태스크 그래프를 미리 정하고, Multiagent Debate 와 SWE-Debate 는 토론 라운드를 반복한다.
전부 static 쪽이다.
실패 분석 쪽으로는 단일 에이전트 궤적을 본 TRAJEVAL 계열, 멀티에이전트의 정보 손실과 실패 전파를 본 MAST·AgentFail, 자동 진단을 하는 TrajAudit·CodeTracer 를 든다.
이 논문은 그중 아무도 안 다룬 dynamic concurrency 를 대상으로 삼는다.
Related Work 안에 예시가 하나 들어 있다. ProgramBench 의 seqtk(생물 서열 처리용 커맨드라인 도구) 재구현 과제를 Kimi Code 가 AgentSwarm 으로 푸는 과정이다.
메인 에이전트가 서열 리더와 명령 디스패처, 빌드 스크립트를 먼저 쓰고, 40분 예산 중 17.5분 지점에서 22개 서브커맨드를 20개 서브에이전트에 한 배치로 나눠준다.
서브에이전트 타임아웃을 2시간으로 잡아서 과제 예산 40분을 넘긴다.
listhet 와 split 두 서브에이전트가 22.3분, 26.7분에 완료를 보고하지만 메인 에이전트는 배치 전체를 기다리느라 그 뒤로 도구 호출을 한 번도 안 한다.
마감에 나머지 18개가 중단되고, seq 담당은 구현을 쓰지도 못해서 공식 테스트가 “unrecognized command” 를 받는다.
440개 테스트 중 92개 통과다.
-> 병렬화 자체는 합리적이었는데 합류 시점 하나 때문에 통합과 최종 테스트 단계에 아예 못 간 사례다. 뒤의 분류표에서 B1 Wrong Start, Join, or Result Timing 의 대표 예시로 다시 나온다.
3. Methodology
3.1 Research Questions
- RQ1: 켰을 때 과제 결과와 자원 사용이 어떻게 달라지는가
- RQ2: 에이전트가 서브에이전트를 언제 얼마나 띄우고 어떻게 조율하는가
- RQ3: 어떤 실패 패턴이 생기는가
- RQ4: 어떤 메커니즘과 조건에서 이득이 나는가
3.2 Studied Agents
2026년 7월 시점의 조합을 쓴다. Codex 에 GPT-5.4, Claude Code 에 Claude Opus 5, Kimi Code 에 Kimi K3 다.
모델을 바꿔 끼우지 않은 이유를 적어 뒀다. agentic post-training 의 RL 이 모델을 그 스캐폴드의 도구 인터페이스에 맞춰 놨을 수 있어서, 다른 모델을 넣으면 그 적합성이 깨질 수 있다는 설명이다.
전부 native 스캐폴드를 쓰고 reasoning effort 는 가장 높게 둔다.
3.3 Benchmarks
단순한 과제에는 서브에이전트를 여럿 띄울 필요 자체가 적다는 판단으로 long-horizon 벤치마크를 주로 쓴다.
RepoZero 는 Python 패키지를 JavaScript 로(Py2JS), C 인터페이스를 Rust 로(C2Rust) 다시 만드는 과제다.
ProgramBench 는 참조 실행파일과 문서만 보고 커맨드라인 프로그램 전체를 다시 만든다.
NL2Repo 는 자연어 명세와 빈 작업공간에서 레포지토리를 만든다.
LoopsBench 는 서로 의존하는 개발 단위를 이어서 수행하는 지속 개발 과제다.
비교군은 SWE-bench Verified 로, 기존 레포지토리의 이슈 하나를 고치는 bounded 과제다.
전체를 다 돌리기엔 비싸다. LoopsBench 전체를 한 번 도는 데 11,354달러가 든다고 적혀 있다.
그래서 각 벤치마크가 자체 정의한 난이도 그룹(easy, medium, hard)별로 층화 무작위 추출을 한다. long-horizon 넷은 25%, SWE-bench Verified 는 20% 다.
표본 분포는 아래 표에 있다.
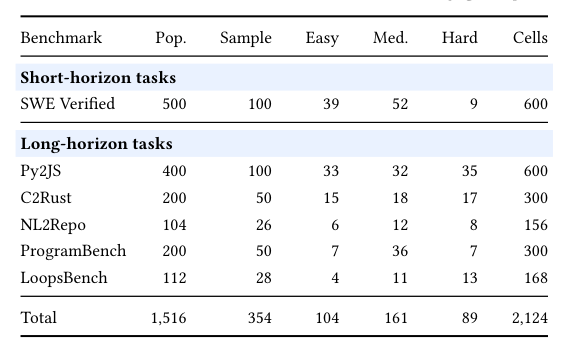
Figure 3 은 정답 구현의 코드 줄 수 분포다.
SWE-bench Verified 평균이 14줄인 반면 RepoZero 2.5K, NL2Repo 3.8K, ProgramBench 8.4K, LoopsBench 26.8K 줄이다.
3.4 Experimental Process
과제마다 세 에이전트 × 두 모드로 돌린다. concurrent 모드는 dynamic concurrency 를 켠 것, sequential 모드는 끈 것이다.
백본 모델, 프롬프트, 환경, 시간 예산을 두 모드에서 같게 둔다.
Codex 는 multi_agent 와 multi_agent_v2 옵션을, Claude Code 는 ultracode 로 Dynamic Workflow 를 켜고 끌 때는 Workflow·Task·Agent 도구를 막는다. Kimi Code 는 swarm_mode 플래그다.
끈 모드에서는 어느 에이전트도 서브에이전트를 만들지 않는 걸 보장한다.
메인과 서브에이전트 전체 궤적, 제출물, 공식 테스트 결과를 모은다.
4. Effectiveness and Efficiency (RQ1)
주 결과는 Table 2 에 있다.
Task pass 는 전부 해결한 과제의 비율이고 Test pass 는 과제별 테스트 통과율의 평균이다.
4.1 Effectiveness
LoopsBench 에서 이득이 가장 넓다.
Codex 는 21.4% 에서 25.0% 로, Claude Code 는 7.1% 에서 21.4% 로 오르고(14.3 포인트), Kimi Code 는 25.0% 그대로다.
Test pass 는 셋 다 오르고 최대 6.0 포인트다.
다른 long-horizon 벤치마크는 섞여 있다.
NL2Repo 에서 Codex(34.6 → 57.7)와 Claude Code(57.7 → 65.4)는 오르고 Kimi Code(57.7 → 46.2)는 내린다.
ProgramBench 는 세 에이전트 모두 양쪽 모드에서 Task pass 0% 다. 다만 Test pass 로 보면 Codex 와 Kimi Code 는 부분 진척이 는다.
같은 벤치마크 안에서도 갈린다. Codex 의 RepoZero 는 Py2JS 에서 2개 잃고 C2Rust 에서 3개 얻어서 150개 중 1개 차이(40.0 → 40.7%)로 끝난다.
SWE-bench Verified 에서는 이득이 없다.
Codex 는 71.0% 그대로, Claude Code 는 83.0% 에서 59.0% 로 24.0 포인트, Kimi Code 는 77.0% 에서 59.0% 로 내린다.
Claude Code 는 같은 기능을 켜고 SWE-bench Verified 에서 24.0 포인트 잃고 LoopsBench 에서 14.3 포인트 얻는다.
두 그룹을 합쳐 exact McNemar 검정(짝지은 이진 결과의 변화를 보는 검정)에 Holm 보정을 하면 Claude Code(p = 5.08 × 10⁻⁷)와 Kimi Code(p = 0.013)의 전체 하락은 유의하고 Codex 의 상승(p = 0.229)은 유의하지 않다.
long-horizon 넷을 구현 크기 순으로 세우고 세 에이전트 평균 Test pass 차이를 보면 RepoZero −8.29, NL2Repo −0.04, ProgramBench +1.24, LoopsBench +4.31 포인트다.
구현이 클수록 병렬화의 평균 이득이 커지는 방향이다.
-> 점 네 개로 그린 추세다. 벤치마크마다 과제 성격도 다르니 “크기 때문”이라고 읽기엔 근거가 얇다. 논문도 associated 라고만 쓴다.
통과율만 보면 두 모드가 같은 과제를 푸는지 모른다. 그래서 Figure 4 에서 겹침을 본다.
거의 모든 에이전트·벤치마크 조합에서 concurrent 모드만 푼 과제가 있다.
Claude Code 는 LoopsBench 4개를 concurrent 에서만 풀고 sequential 에서만 푼 건 없다.
SWE-bench Verified 에서 Claude Code 는 전체 통과율이 내려갔는데도 5개를 concurrent 에서만 풀고, Codex 는 전체 수치가 같은데 양쪽에서 각각 9개씩 다른 과제를 푼다.
Finding 1: dynamic concurrency 는 long-horizon 과제에서 sequential 이 못 푸는 과제를 열어 주고, 구현 크기가 클수록 평균 이득이 크다.
4.2 Resource Efficiency
Shell calls 는 메인과 서브에이전트 호출을 합친 수다. 모든 에이전트·벤치마크에서 concurrent 가 더 많고, 몇 배씩 는다. 예를 들어 Claude Code 의 LoopsBench 는 107.4 에서 791.6 회다.
토큰은 에이전트별로 sequential 의 1.41~3.31배다.
푼 과제 하나당 토큰으로 정규화하면 셋 다 늘어난다. 전체적으로 소폭 이득을 본 Codex 도 푼 과제당 7.69M 토큰에서 24.12M 토큰이 된다.
실행 시간도 줄지 않는다.
15개 에이전트·벤치마크 조합 중 14개에서 평균 시간이 늘었다.
Claude Code 는 SWE-bench Verified 한 과제에 17.5분 걸리던 것이 27.8분이 되면서 덜 푼다.
다만 양쪽 모드가 모두 푼 366개 과제만 보면 102개(27.9%)에서 concurrent 가 더 빨랐고, 46개(12.6%)는 20% 이상 빨랐다.
Finding 2: 평균적으로 자원과 시간을 많이 쓰고 이득은 제한적이지만, 12.6% 의 과제에서처럼 제대로 되면 속도가 난다.
5. Delegation and Coordination Behavior (RQ2)
결과 대신 과정을 본다. concurrent 모드의 실행 354개 × 3 에이전트 궤적에서 서브에이전트가 언제 몇 개 만들어지고 얼마나 겹치는지 잰다.
5.1 Delegation Scale
생성·종료 타임스탬프로 두 서브에이전트의 시간 창이 겹치면 overlap 으로 센다.
생성 수는 누적이고 peak 는 동시에 살아 있는 수라서, 여러 차례 나눠 띄우면 생성 수만 늘고 peak 는 안 는다.
난이도가 올라가면 더 많이 띄운다.
전체 평균으로 생성 수는 easy 6.69, medium 7.53, hard 15.84 개, peak 는 3.66, 4.61, 6.70 개다.
LoopsBench 가 가장 크다. 세 에이전트 평균 생성 수가 easy 16.25 에서 hard 68.18 로, peak 는 6.00 에서 21.77 로 오른다.
LoopsBench 는 hard 과제의 14.6% 인데 hard 과제에서 만들어진 서브에이전트의 62.9% 를 차지한다.
다만 Spearman 순열 검정에 Holm 보정을 하면 30개 비교 중 유의한 건 Claude Code 의 ProgramBench(ρ = 0.470)와 Codex 의 SWE-bench Verified(ρ = 0.316) 둘이다.
과제가 어려운 이유가 “한 부품이 커서”일 수도 있고 “다른 부품이 그걸 기다려야 해서”일 수도 있어서, 독립 서브태스크 수는 그대로인 채 일만 느는 경우가 있다고 설명한다.
에이전트별 성향이 다르다.
Codex 는 peak 가 1.21~3.00 개로 작은 팀을 유지한다. 구현 일부를 메인이 직접 들고 있어서다.
Claude Code 는 hard LoopsBench 에서 과제당 평균 133.69개를 만들고 peak 는 25.46 이다. 워크플로 단계마다 새 그룹을 만들어서 총수가 커진다.
Kimi Code 는 67.00개로 더 적게 만들지만 peak 는 37.46 으로 더 높다. 한 배치를 한꺼번에 띄워서다.
5.2 Temporal Dynamics and Context Overlap
궤적을 처음 타임스탬프부터 마지막까지 0~100% 로 정규화하고, 서브에이전트 둘 이상이 동시에 살아 있는 구간의 비율을 overlap fraction 으로 정한다. 메인 에이전트는 뺀다.
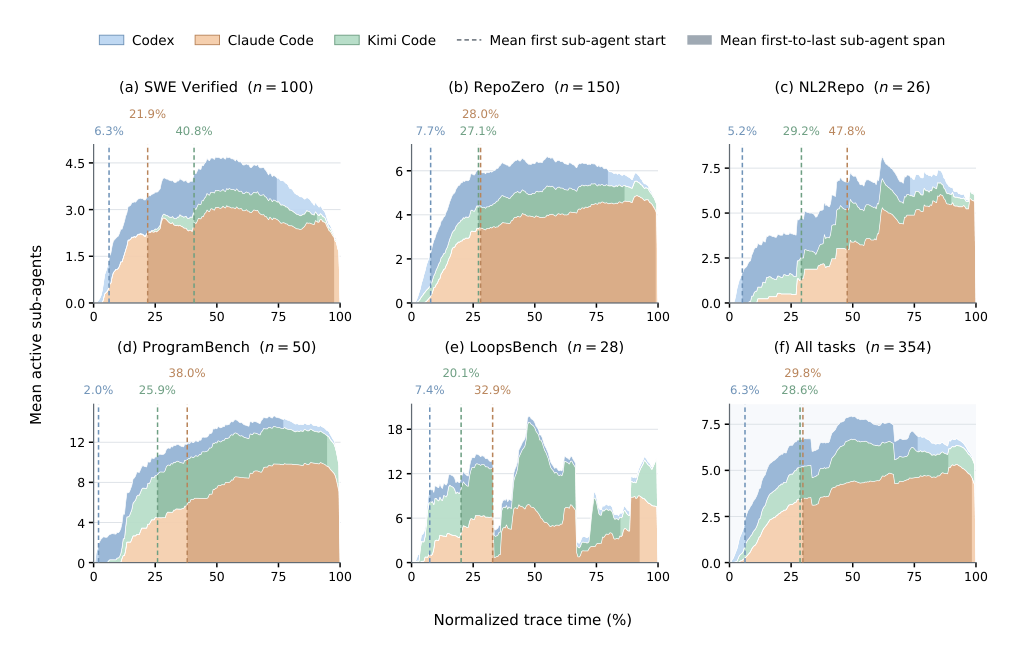
아래 그림은 정규화한 시간 위에서 평균 활성 서브에이전트 수를 에이전트별로 쌓은 것이다.
시작 시점이 다르다.
Codex 는 첫 서브에이전트를 궤적의 4.0%(중앙값) 지점에 띄우고, Claude Code 는 22.1%, Kimi Code 는 26.0% 다.
Codex 의 spawn 인터페이스는 과제 하나를 던지고 바로 제어를 돌려줘서 나머지 계획이 끝나기 전에 서브에이전트가 일을 시작할 수 있다.
Claude Code 는 스크립트에 에이전트 호출과 의존성을 다 적어야 하고, Kimi Code 는 배치 제출 전에 탐색과 분해를 하도록 지시가 돼 있다.
서브에이전트를 만들었다고 병렬로 도는 건 아니다. Codex 실행의 24.3% 는 서브에이전트를 만들었지만 서로 겹치는 구간이 없다. Claude Code 는 1.7%, Kimi Code 는 2.8% 다.
겹치는 길이도 다르다.
overlap fraction 중앙값은 Codex 23.9%, Claude Code 52.7%, Kimi Code 15.6% 다.
Claude Code 는 늦게 시작하지만 실행의 절반 이상에서 서브에이전트가 겹친다.
마지막 서브에이전트가 끝나는 지점 중앙값은 Codex 83.3%, Claude Code 100.0%, Kimi Code 93.6% 다.
Codex 는 결과가 하나씩 오고 메인이 그때그때 재개할 수 있어서 서브에이전트 없이 마무리하는 구간이 남는다. Claude Code 는 뒤쪽 리뷰 단계에서도 에이전트를 더 만들고, Kimi Code 는 배치가 끝날 때까지 메인이 기다린다.
Finding 4: 세 에이전트의 시간 전략이 다르다. Codex 는 일찍 띄우고 적게 겹치고, Claude Code 는 늦게 띄우고 오래 겹치고, Kimi Code 는 짧게 겹친다.
6. Taxonomy of Concurrency Failure Patterns (RQ3)
6.1 Methodology
concurrent 모드 궤적 1,062개를 전부 사람이 읽는다.
각 궤적을 같은 에이전트·같은 과제의 sequential 궤적과 나란히 놓고, 메인과 중첩 서브에이전트까지 전체 궤적, 워크플로 기록, 산출물, 공식 테스트 결과를 함께 본다.
두 명이 50개로 open coding 을 해서 코드북을 만들고, 세 명 중 두 명씩 독립 주석을 단다.
패턴 라벨 하나 이상을 고르고 근거를 적는다. 패턴은 소분류와 대분류에 하나씩 속하니 상위 라벨은 따라온다.
Cohen’s κ 는 0.77 이고, 불일치는 토론 뒤 선임 저자가 조정한다.
6.2 Taxonomy
4개 대분류, 13개 소분류, 28개 패턴이다.
1,062개 중 650개 궤적에서 패턴이 나왔고 인스턴스는 804건이다. 한 궤적에 여러 패턴이 붙을 수 있고 아래 비율은 804건 기준이다.
소분류마다 failure type 이 있다. functional 은 소유권·정보 교환·격리·관측·수용 같은 조율 요건을 어긴 것이고, performance 는 주어진 실행 예산 안에서 조율이 비효율적이었던 것이다.
아래 표가 전체 분류표다.
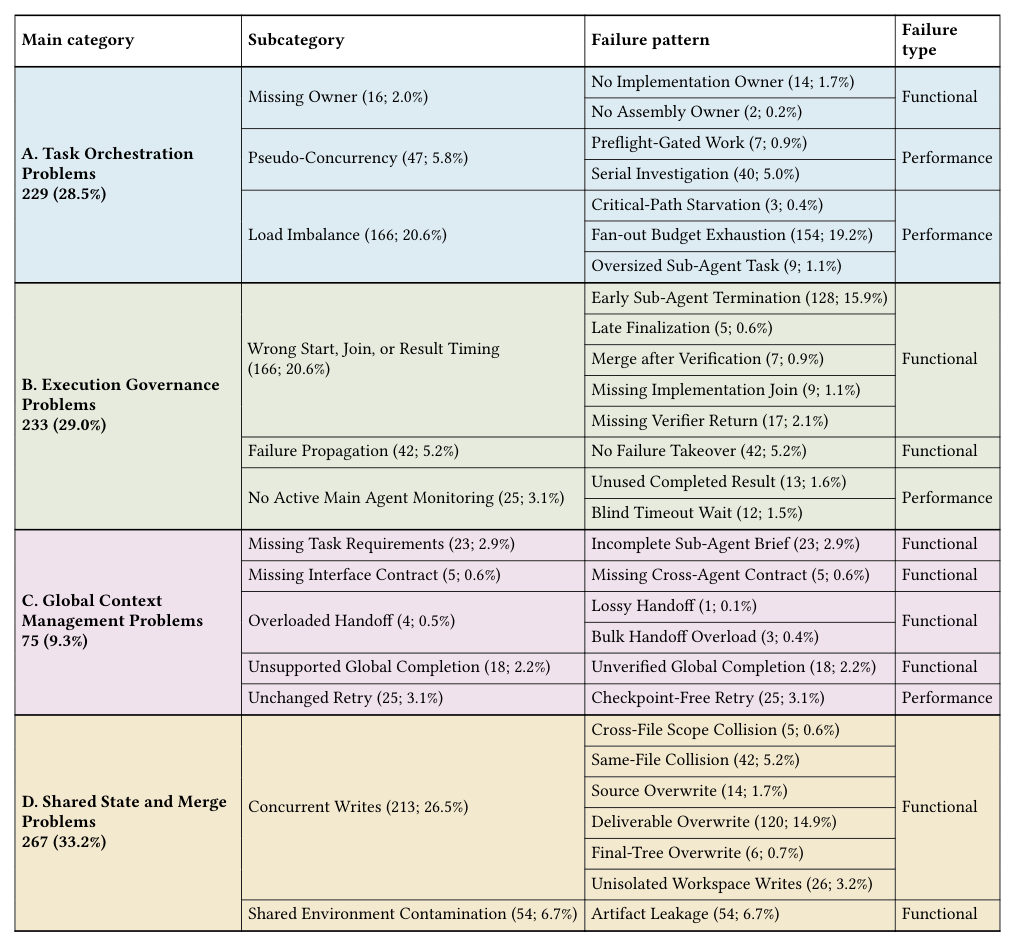
A. Task Orchestration Problems (229건, 28.5%)
메인 에이전트가 일을 자신과 서브에이전트에 잘못 나눈 경우다.
A1 Missing Owner 는 필요한 일을 아무에게도 안 준 것이다. Kimi Code 가 NL2Repo 의 verifiers 과제에서 다섯 서브에이전트에 파서, 유틸, 문서, 예제 환경, 목 클라이언트를 주고 정작 verifiers/envs 모듈은 아무도 안 맡았다. 공식 테스트 0개 통과다.
A2 Pseudo-Concurrency 는 서브에이전트가 병렬로 돌지만 완료를 결정하는 일은 순차인 경우다. Kimi Code 가 ProgramBench tailspin 에서 17개 서브에이전트에 조사만 시키고 구현은 보고를 다 받은 뒤 메인이 하려다 계획 단계에서 끝났다. 785개 중 0개다.
A3 Load Imbalance 는 가장 많다(20.6%). Claude Code 에서 나온 패턴의 39.8% 가 여기다. 서브에이전트를 너무 많이 띄우거나 한 서브에이전트에 너무 많이 줘서 정작 구현에 쓸 예산이 없어지는 경우다. 하위 패턴 Fan-out Budget Exhaustion 이 154건으로 단일 패턴 중 두 번째로 많다.
B. Execution Governance Problems (233건, 29.0%)
위임한 뒤 관리가 안 된 경우다.
B1 Wrong Start, Join, or Result Timing(20.6%)은 시작·합류·결과 반영 시점이 틀린 것이다. 하위의 Early Sub-Agent Termination 이 128건(15.9%)으로 가장 많고, seqtk 사례가 여기 속한다.
B2 Failure Propagation 은 서브에이전트가 실패했는데 메인이 재시도도, 재배정도, 인수도 안 한 것이다. rate limit 에 걸린 검증 서브에이전트를 그냥 둬서 148개 중 147개만 통과한 예가 있다.
B3 No Active Main Agent Monitoring 은 메인이 진행을 다시 보지 않는 경우다. 산출물을 다 만들어 두고 마감 직전에 끝나지 않은 서브에이전트를 10분 블로킹으로 기다리다 최종 응답 없이 종료된 예가 있다. 그 산출물은 39개 테스트를 전부 통과했다.
C. Global Context Management Problems (75건, 9.3%)
분리된 컨텍스트 사이에 필요한 정보가 안 넘어간 경우다.
C1 Missing Task Requirements 는 서브에이전트가 요구사항을 다 못 받은 것이다.
C2 Missing Interface Contract 는 관련 부품을 만드는 서브에이전트끼리 인터페이스 합의가 없는 경우다. permissions 담당은 정수를 돌려주는데 테스트 담당은 “755” 같은 문자열을 기대한 예가 있다.
C3 Overloaded Handoff 는 넘긴 정보가 너무 크거나 손실된 경우다. 프로브당 60개 발견을 모은 80K 자 브리프를 받은 서브에이전트가 구현 대신 조사를 다시 했다.
C4 Unsupported Global Completion 은 통합 결과를 다 확인 안 하고 완료를 선언한 것이다. stderr 를 안 본 예가 있다.
C5 Unchanged Retry 는 교체 서브에이전트가 이전 진척을 물려받지 못하고 같은 브리프로 같은 조사를 반복하는 경우다. 네 번 반복하고 Cargo.toml 만 남았다.
D. Shared State and Merge Problems (267건, 33.2%)
가장 큰 대분류다. 전통적 동시성 프로그램의 데이터 레이스와 비슷하다고 쓴다.
D1 Concurrent Writes 는 26.5% 이고 Codex 에서 나온 패턴의 62.9% 가 여기다. 메인이 test5.rs 를 쓰고 빌드까지 했는데 서브에이전트가 다른 모듈 구조로 같은 파일과 Cargo.toml 을 덮어쓴 예가 있다. 하위의 Deliverable Overwrite 가 120건(14.9%)이다.
D2 Shared Environment Contamination 은 공유 환경을 격리 없이 건드린 것이다. 두 서브에이전트가 /tmp/t1 을 각자 지우고 다시 만들어 한쪽이 엉뚱한 픽스처로 계속 진행한 예, 서브에이전트가 시스템 Git 실행파일을 바꿔치기한 예가 있다.
-> 가장 큰 대분류가 “나누는 법”이나 “관리하는 법”이 아니라 파일 쓰기 충돌이다. 서브에이전트에게 작업공간을 따로 주는 것만으로 1/3 을 줄일 수 있는지는 논문이 실험하지 않아서 모른다.
Finding 5: dynamic concurrency 는 sequential 실행에는 없는 실패 패턴을 들여온다.
7. Benefit Analysis of Dynamic Concurrency (RQ4)
concurrent 가 더 나았던 쌍 131개를 고른다. 기준은 Test pass 가 높거나, sequential 이 못 푼 과제를 풀었거나, Test pass 를 안 떨어뜨리면서 시간을 60초 이상·20% 이상 줄인 경우다.
세 가지 상황이 반복해서 나온다.
Complementary Work 는 서브에이전트가 서로 다른 부분을 맡고 메인이 통합에 성공한 경우다. NL2Repo justext 에서 Kimi Code 의 서브에이전트 8개가 전달 파일과 점검을 맡고 메인이 본문 추출 알고리즘을 짰다. 양쪽 다 전부 통과했지만 시간이 734초에서 468초로 줄었다.
Alternative Attempts and Selection 은 같은 문제를 여럿이 다르게 풀어 메인이 고르거나 합치는 경우다. Codex 의 ProgramBench Halite 에서 메인과 서브에이전트가 각자 게임 환경을 만들었고, 메인이 서브의 맵 동작과 자기 프로토콜 처리를 합쳐 391개 중 292개를 통과했다. sequential 은 빌드가 안 돼 0개다.
Independent Validation 은 서브에이전트가 가정이나 구현을 따로 검증해서 메인의 실수를 고칠 증거를 주는 경우다. LoopsBench 의 보안 랩 과제에서 crypto 서브에이전트가 ECDSA nonce 재사용의 P-256 곡선 차수 조건을 찾아줬고, 메인이 복구 알고리즘을 일반화해서 전부 통과했다.
Finding 6: 메인 에이전트가 병렬 결과를 실제로 쓸 때, 즉 통합하거나 고르거나 교정 증거로 삼을 때 이득이 난다.
8. Discussion
8.1 Implications
연구자 쪽으로는 분류표의 네 대분류가 그대로 네 과제다. 분해·소유권·부하 균형, 런타임 모니터링과 개입, 컨텍스트 간 요구사항·인터페이스·진척 전달, 그리고 공유 파일과 환경의 격리·동기화·충돌 감지다.
실무자 쪽으로는 기본값으로 켜지 말고 선택적으로 켜라고 권한다.
어렵고 긴 과제, 독립 부품으로 명확히 나뉘는 과제, 같은 문제를 여러 번 시도할 수 있는 과제, 서브에이전트가 메인 구현을 독립 검증할 수 있는 과제에서 고려하라고 한다.
그 이득을 토큰·도구 호출·시간 증가와 같이 놓고 보라는 말이 붙는다.
8.2 Threats to Validity
외적 타당성은 에이전트 셋과 벤치마크 다섯에 한정된다.
내적 타당성에서 가장 큰 건 실행이 확률적인데 각 설정을 한 번씩만 돌렸다는 점이다.
비용 때문에 반복을 못 했고, 대신 Codex 의 LoopsBench sequential 결과가 원 LoopsBench 논문의 보고치와 가깝다는 점, 원 논문이 반복 시도에서 안정적 추세를 보고한다는 점을 근거로 든다.
수작업 주석의 주관성은 50개 파일럿, 2인 독립 주석, 근거 기록, 선임 조정으로 다뤘다고 쓴다.
-> 단일 실행이라는 점은 수치를 읽을 때 계속 붙여 둬야 한다. NL2Repo 는 표본이 26개라 과제 2개 차이가 7.7 포인트다. Claude Code 의 SWE-bench Verified 24포인트 하락은 100개 표본에 McNemar 유의성이 붙어 있어 노이즈로 보기 어렵지만, 벤치마크별 작은 차이들은 방향만 참고하는 게 맞다.
9. Conclusion
세 frontier 코딩 에이전트의 dynamic concurrency 를 2,124회 실행으로 비교했다.
켜면 토큰이 늘고 성공률 변화는 도구와 과제에 따라 갈린다.
실패 분류표는 task orchestration, execution governance, global context management, shared state and merge 네 대분류다.
이득은 complementary work, alternative attempts and selection, independent validation 세 메커니즘에서 나오며, 공통점은 메인 에이전트가 병렬 결과를 통합·선택·교정에 실제로 썼다는 점이다.
궤적, 주석 코드북, 재현 스크립트를 GitHub 에 공개한다.
10. 지금 관점: 서브에이전트 병렬화를 언제 켤까
이 블로그에서 Claude Code 가 등장한 건 GenericAgent와 Harness Benefit이었다.
둘 다 에이전트 하나의 컨텍스트와 스킬을 다뤘고, 이 논문은 에이전트를 여럿으로 늘리는 쪽이다.
ARIA가 “언제 비싼 모델에게 물을까”를 워크플로 신호로 배웠다면, 이 논문이 비운 자리는 “언제 서브에이전트를 띄울까”다.
지금은 메인 에이전트가 그 판단을 프롬프트와 모델 감각으로 하고 있고, 그 결과가 SWE-bench Verified 에서 24포인트 하락이다.
가져다 쓸 수 있는 건 분류표 쪽이다.
28개 패턴 중 상위 셋이 Concurrent Writes(26.5%), Fan-out Budget Exhaustion(19.2%), Early Sub-Agent Termination(15.9%)이고, 셋 다 모델의 추론 능력 문제가 아니다.
작업공간 격리, 서브에이전트 수 상한, 과제 예산보다 짧은 서브에이전트 타임아웃은 스캐폴드 레벨에서 넣을 수 있는 것들이다.
seqtk 사례처럼 두 개가 끝났는데 메인이 아무 일도 안 하는 상황은 “배치 전체를 기다린다”는 설계 하나에서 나왔다.
자기가 만드는 에이전트에 서브에이전트 기능이 있다면 이 분류표를 궤적 리뷰 체크리스트로 쓰는 게 가장 빠른 활용이다.
그대로 받아들이기 어려운 부분도 있다.
첫째, 각 설정을 한 번씩만 돌렸다. 세 에이전트의 성향 차이(Codex 는 일찍·적게, Claude Code 는 늦게·오래)는 구현 코드를 읽어 설명했으니 믿을 만하지만, 벤치마크별 통과율 차이는 반복 실행이 있어야 폭을 알 수 있다.
둘째, 2026년 7월 시점의 세 조합이다. Codex 의 Concurrent Writes 비중 62.9% 나 Claude Code 의 Load Imbalance 39.8% 는 그 버전의 스캐폴드 특성이고, 다음 릴리스에서 바뀔 수 있다.
셋째, 이득이 난 131쌍은 “어떤 조건에서 되는가”를 보여주지만 그 조건을 실행 전에 판별하는 방법은 없다. 과제가 독립 부품으로 나뉘는지는 풀어 봐야 아는 경우가 많다.
서브에이전트 병렬화는 기본값으로 켜 두는 기능이 아니라 과제 크기를 보고 켜는 기능이다.
수십 줄 패치에는 끄고, 수천 줄 이상 새로 쓰는 과제에만 켜되, 토큰이 1.4~3.3배 든다는 걸 예산에 미리 넣어야 한다.
-> 이 논문의 Table 2 는 세 에이전트에 대해 “켜면 손해 보는 벤치마크”와 “켜면 이득 보는 벤치마크”를 같은 표에 놓는다. 그 경계가 구현 크기 몇 천 줄쯤인지는 벤치마크 네 점으로는 못 정하고, 다음 논문이 답할 자리다.
Leave a comment