
GenericAgent Paper review
GenericAgent: A Token-Efficient Self-Evolving LLM Agent via Contextual Information Density Maximization (V1.0)
https://arxiv.org/abs/2604.17091
GenericAgent(GA)는 Advantage AI Agent Lab(A3 Lab, Shenzhen Aquaintelling Technology 와 Fudan University 의 공동 연구실)에서 만든 범용 자기진화 에이전트 시스템이다.
저자 18명이 쓴 47쪽짜리 기술 보고서로, arXiv 에 올라온 논문이다.
코드는 GitHub에 공개돼 있다.
주장은 한 줄이다.
에이전트 성능은 컨텍스트 길이보다 컨텍스트 안에 결정에 필요한 정보가 얼마나 밀도 있게 들어 있느냐로 정해진다.
이걸 도구 9개, 4계층 메모리, SOP·코드로의 자기진화, 컨텍스트 절단·압축 네 가지로 구현하고 Claude Code, OpenClaw, Codex 와 비교한다.
앞에서 본 MemGPT가 컨텍스트 창을 유한한 메모리로 봤다면, 이 논문은 그 창에 무엇을 남길지를 시스템 전체의 설계 기준으로 삼는다.
1. Introduction
Introduction 은 장기 과제를 푸는 에이전트의 문제를 둘로 나눈다.
첫째는 컨텍스트 폭발이다.
도구 정의, 검색된 메모리, 중간 관찰, 환경 피드백이 턴마다 쌓이면서 프롬프트가 계속 커진다.
토큰 비용으로 끝나지 않고, 오래되거나 관련 없는 내용이 컨텍스트의 더 큰 비중을 차지하면서 결정에 필요한 정보에 주의가 가지 않게 된다.
둘째는 경험 축적이다.
사용자 선호, 도구의 실제 동작, 잘 먹히는 행동 패턴은 시행착오로 알게 되는데, 세션이 끝나면 사라져서 토큰은 쓰지만 능력은 제자리인 정체 루프에 빠진다.
기존 프레임워크는 대부분 에피소드마다 상태를 지우고, 메모리를 붙여도 가공 안 된 로그를 저장하며, 틀린 메모리를 고치는 피드백이 없다는 게 저자들의 진단이다.
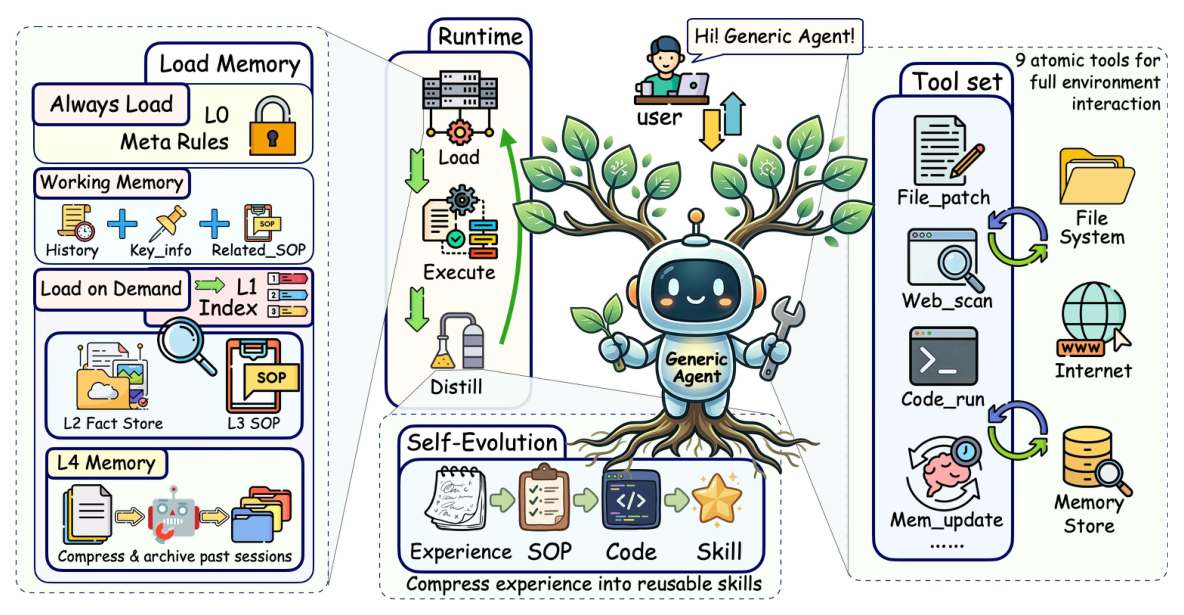
GA 는 이를 네 가지 메커니즘으로 푼다.
최소 원자 도구 집합, 검증된 지식만 남기는 계층 메모리, 궤적을 SOP(Standard Operating Procedure, 작업 절차서)·코드·스킬로 압축하는 자기진화, 예산을 넘으면 오래된 것부터 지우는 절단·압축이다.
2. GenericAgent
2.1 Design Principles
이 절의 첫 문장이 논문의 슬로건이다.
“Context information density is all a self-evolving LLM agent needs.”
근거로 드는 선행 연구는 셋이다.
긴 입력에서 중간에 놓인 정보를 잘 못 찾는 위치 편향(lost in the middle), 관련 없는 내용이 주의를 분산시키는 현상, 그리고 모델의 실효 컨텍스트 길이가 명목 창보다 훨씬 짧다는 관측이다.
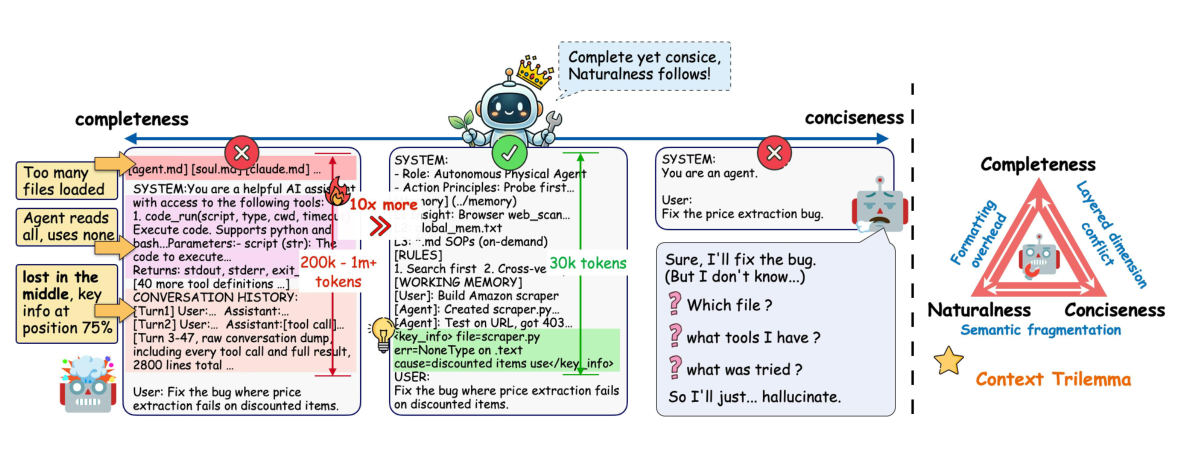
저자들은 컨텍스트 품질을 두 개의 주 요건과 하나의 부차 제약으로 정리한다.
완전성(Completeness)은 지금 결정에 필요한 정보가 전부 명시적으로 있어야 한다는 것, 간결성(Conciseness)은 관련 없고 중복된 정보를 빼야 한다는 것, 자연스러움(Naturalness)은 압축한 표현이 모델이 읽을 수 있는 형태여야 한다는 것이다.
최신성(recency)과 관련성(relevance)은 독립된 기준으로 두지 않고 앞의 두 요건 안에서 설명한다.
완전성과 간결성의 긴장은 창이 무한해도 남는 구조적인 것이라고 한다.
그래서 셋을 동등한 트릴레마로 두지 않고, 자연스러움을 제약으로 둔 완전성·간결성 사이의 제약 최적화 문제로 본다.
2.1.1 Tool Minimality
도구가 늘면 비용이 두 군데서 생긴다.
프롬프트 수준에서는 도구 스키마와 설명이 턴마다 컨텍스트를 차지하고, 정책 수준에서는 행동 공간이 커져 도구 선택이 모호해지고 재시도가 는다.
GA 는 각 도구를 더 쪼갤 수 없는 기본 능력(atomicity)으로 제한하고, 복잡한 행동은 그 조합(compositional generalization)으로 만든다.
그러면 쌓이는 운영 지식도 새 도구 대신 기본 도구를 어떤 순서로 엮는가의 형태가 되어 경험 압축이 가벼워진다.
2.1.2 Hierarchical Memory
메모리 문제는 저장보다 활성 컨텍스트에 얼마나 남기느냐에 있다고 본다.
늘 보이는 층은 지식 범주의 존재만 적은 작은 안내 정보로 두고, 사실·절차·이력은 깊은 층에 두었다가 필요할 때 도구 호출로 읽는다.
LLM 이 압축기이자 복호기다. 새 지식을 정리할 때 단어 수 제한 프롬프트로 존재 요약을 만들고, 꺼낼 때는 그 압축된 포인터를 따라가 깊은 층을 읽는다.
2.1.3 Self-Evolution as Experience Consolidation
계층 메모리가 한 과제 안에서의 정보 유지를 다룬다면, 자기진화는 과제가 끝난 뒤에도 쓸모가 남는가를 다룬다.
GA 는 모델 가중치를 건드리지 않고 모델이 보는 정보 환경을 갱신하는 방식으로 진화하며, 성공한 실행에 근거한 정보만 남긴다.
2.1.4 Context Truncation and Compression
1M 토큰 창을 믿는 프레임워크가 많지만 비싸고 환각이 는다고 한다.
저자들은 환각 없이 쓸 수 있는 실효 길이가 명목의 10분의 1 정도라고 보고, GA 의 목표 예산을 30k 토큰 아래로 잡는다.
도구 출력은 앞뒤만 남기는 절단, 오래된 메시지는 태그 수준 압축, 전체 예산 초과 시 오래된 메시지부터 삭제, 그리고 매 턴 주입되는 working-memory anchor 로 과제 상태를 유지한다.
2.2 Overview of GenericAgent
GA 는 로컬 컴퓨팅 환경에서 브라우저, 터미널, 파일 시스템, 키보드·마우스, 화면, 모바일 기기를 어댑터로 다루는 시스템이다.
루프는 하나다.
전역 메모리와 과제를 합쳐 컨텍스트를 만들고, 모델이 출력이나 도구 호출을 내고, 도구 결과가 구조화된 신호로 돌아오며, 과제가 끝나면 실행 흔적을 압축해 공유 메모리에 넣는다.
실행 모드는 사용자가 시작하는 Interact 모드와, 환경 변화를 감시하다가 조건이 맞으면 스스로 과제를 띄우는 Reflect 모드 둘이다.
2.3 Core Components of GenericAgent
2.3.1 Minimal Atomic Toolset
도구는 9개, 다섯 부류다.
파일(file_read, file_patch, file_write), 코드 실행(code_run, Python 또는 Bash), 웹(web_scan, web_execute_js), 메모리(update_working_checkpoint, start_long_term_update), 사람 개입(ask_user).
file_read 는 구간·키워드 앵커·줄번호 읽기를 지원하고, file_patch 는 old_content 가 정확히 한 곳에만 맞을 때만 적용된다.
web_scan 은 DOM 을 복제해 가시성을 계산하고 가려지거나 숨은 요소를 빼서 원시 DOM 대비 토큰을 한 자릿수 줄인다.
이론상 code_run 하나로 모든 일을 할 수 있으므로 나머지 8개는 능력 확장이 아니라 결정 비용을 줄이는 지름길이라고 설명한다.
2.3.2 Hierarchical Memory Architecture
메모리는 기능으로 셋, 구현으로 넷이다.
기능 분류는 매 턴 주입되는 working memory(목표·제약·진행), 늘 보이지만 최소로 압축한 always-on memory, 기본 컨텍스트 밖에 있다가 사후 정리로만 갱신되는 long-term memory 다.
구현 계층은 L1 인덱스(진입점·키워드 매핑·소수의 하드 제약), L2 사실(실행으로 검증되고 여러 과제에서 재사용된 것만), L3 SOP(절차·전제조건·실패 사례·복구 전략), L4 원시 세션 아카이브(추적용, 거의 주입 안 함)다.
그 위에 메모리 지도와 갱신 규칙을 적은 meta-memory 가 있고, 기본으로 주입되는 건 meta-memory 와 L1 뿐이다.
L2·L3 가 커져도 L1 은 유계라는 게 설계 불변식이다.
각 항목이 내용 대신 범주의 존재만 적기 때문이다.
-> L1 길이가 “지식 집합의 범주 구조의 Kolmogorov 복잡도에 근접한다”는 표현이 있는데, 측정한 수치는 없다. 선언에 가깝다.
2.3.3 Self-Evolution Capability in GA
진화하는 건 도구가 아니라 전략이다.
도구 층은 고정이고, 과제별 능력은 SOP 파일과 스크립트에 들어가며 에이전트가 자기 도구로 읽고 고친다.
쌓이는 방식은 L1 인덱스가 새 L2 사실과 L3 절차를 자동으로 추적하는 것이다.
품질은 원시 흔적을 L4 에만 두고, 하위 목표 달성이나 오류 복구 같은 이정표에서만 명시적 정리 단계를 돌리는 것으로 지킨다.
이때 성공한 도구 실행으로 확인된 것만 남기고, 추측·중간 상태·실패한 분기는 “No Execution, No Memory” 규칙으로 버린다.
실패 처리는 세 단계로, 오류 메시지를 보고 국소 수정 후 재시도, 그래도 안 되면 접근 자체를 바꾸거나 환경에서 정보를 더 찾기, 그래도 안 되면 사람에게 묻기다.
2.3.4 Context Truncation and Compression
토큰 수를 직접 못 세므로 문자 수로 예산을 잡는다.
대화 전체의 JSON 직렬화 문자 길이가 토큰 창에 3을 곱한 문자 예산을 넘으면 압축이나 삭제가 돈다.
4단계다.
1단계 도구 출력 절단은 임계치(code_run 10,000자, web_scan 텍스트 10,000자, HTML 35,000자, file_read 줄당 약 1,280자에 총 20,000자)를 넘으면 앞뒤 절반씩만 남긴다.
2단계 태그 수준 압축은 다섯 턴마다 돌면서 반복되는 working-memory 블록을 자리표시자로 바꾸고 thinking·tool_use·tool_result 안의 내용을 약 800자 창으로 줄인다.
최근 10개 메시지는 제외하고, 다섯 턴 간격 덕에 약 80% 턴에서 프롬프트 캐시가 맞는다고 한다.
3단계 메시지 삭제는 예산 초과 시 더 엄격한 압축(최근 4개만 제외)을 한 번 더 돌린 뒤, 오래된 것부터 전체 예산의 60% 아래가 될 때까지 지운다.
4단계 anchor 는 도구 호출 뒤마다 다음 사용자 메시지에 붙는데, 최근 20턴의 한 줄 요약(각 100자 정도), 현재 턴 번호, 에이전트가 update_working_checkpoint 로 관리하는 key_info 블록이 들어가며, 삭제 뒤에는 이 anchor 가 과제 상태의 유일한 출처가 된다.
-> 2단계는 오래된 메시지를 건드려 캐시를 깨는 작업인데, 다섯 턴에 한 번만 건드리니 적중이 유지된다는 논리다. 압축 시점마다 캐시가 한 번씩 무효화되는 비용은 따로 안 잰 것 같다.
3. From Minimal Architecture to Emergent Capabilities
3.1 Minimal Architecture
중심 코드가 약 3,300줄, 에이전트 루프가 92줄이라고 한다.
OpenClaw 는 약 530,000줄로 160배 이상이라고 비교한다.
인터페이스는 CLI 하나이고, 과제 제출, 진행 확인, 개입 전부 CLI 로 한다.
3.2 Compositional Capabilities
CLI 로 노출되면 두 능력이 따라온다고 한다.
서브에이전트는 터미널 명령으로 GA 인스턴스를 백그라운드에 띄우는 것이라, 각자 프로세스와 대화 이력을 가지니 컨텍스트 격리가 저절로 된다.
Reflect 모드는 가벼운 스크립트가 조건을 주기적으로 확인하다가 규칙이 맞으면 반환 문자열을 GA CLI 에 과제로 넘기는 것이다.
환경 변화를 보는 Watchdog 과 시간 규칙으로 도는 Scheduled Task 가 그 응용이다.
3.3 Autonomous Exploration Capability
사용자 지시만으로는 스킬이 느리게 쌓이므로 유휴 시간에 스스로 탐색한다.
스킬 트리는 범주(web_automation, data_processing 등) 아래 이름 있는 스킬이 있고, 각 스킬에 스크립트와 사용 횟수가 붙는 2단 구조다.
과제 후보는 폭(스킬이 평균보다 적은 범주 채우기), 깊이(많이 쓰인 스킬 강화), 효용, 참신성 네 점수의 가중합으로 고르고, 앞의 둘은 트리 통계로, 뒤의 둘은 LLM 이 1~10으로 매긴다.
실행은 컨텍스트 로드, 스킬 검색, 샌드박스 임시 디렉터리에서 실험, 메타데이터 태그가 붙은 마크다운 보고서 작성, 트리 갱신 순이며 실패한 실험도 기록한다.
이 절 끝에 Limitations 가 따로 있다.
30라운드 실행 상한 때문에 복잡한 탐색은 여러 세션에 걸치고, 세션 사이 연속성은 보고서와 과제 목록 주석에만 의존한다.
가중치 적응은 예비 설계라 효과를 보일 만큼 장기 데이터가 없고, 자기개선 로그와 스킬 트리 정리는 사용자가 손으로 한다.
4. Evaluation
평가 항목은 과제 완료와 토큰 효율, 도구 사용 효율, 메모리 효과, 자기진화, 웹 브라우징 다섯이다.
4.1 Task completion and token efficiency
베이스라인은 Claude Code, OpenClaw(오픈소스 다중 도구 프레임워크), Codex 다.
백본은 Claude Sonnet 4.6, Claude Opus 4.6, MiniMax M2.7, GPT-5.4 를 섞어 쓴다.
벤치마크는 SOP-Bench(다단계 SOP 실행), Lifelong AgentBench(과제 간 의존이 있는 순차 과제), RealFin-Benchmark(금융 워크플로) 셋이다.
지표는 정확도, 입력·출력·총 토큰, 그리고 정확도를 백만 토큰으로 나눈 Efficiency 다.
세 벤치마크에서 각 시스템의 정확도와 토큰을 잰 표다.
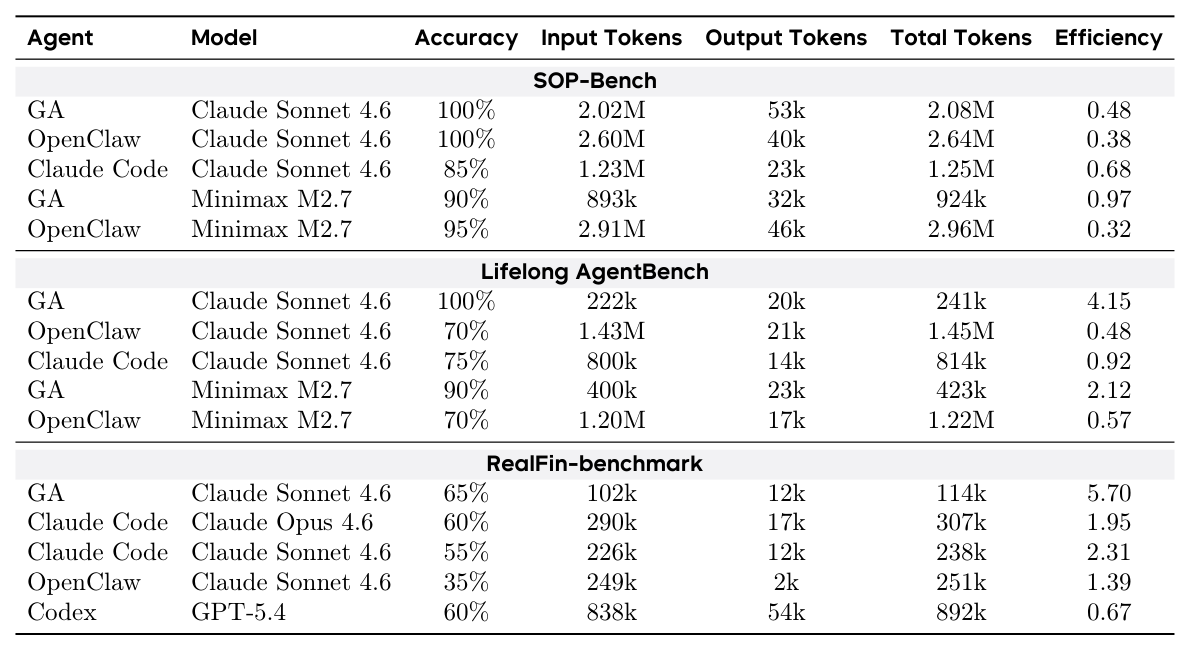
Claude 계열 설정에서 GA 는 SOP-Bench 와 Lifelong AgentBench 에서 100% 를 찍는다.
SOP-Bench 에서는 OpenClaw 도 100% 이고, Claude Code 는 85% 지만 토큰은 GA 보다 적게 써서 Efficiency 는 0.68 로 GA 의 0.48 보다 높다.
Lifelong AgentBench 에서는 GA 가 222k 입력 토큰으로 100%, Claude Code 는 800k 로 75%, OpenClaw 는 1.43M 으로 70% 다.
RealFin 에서는 GA 65%, Claude Code 60%(Opus) 와 55%(Sonnet), Codex 60%, OpenClaw 35% 다.
MiniMax M2.7 로 바꾸면 SOP-Bench 에서 OpenClaw 95% 가 GA 90% 보다 높고, 토큰은 GA 가 3분의 1 수준이다.
-> 벤치마크별 과제 수가 본문에 없다. RealFin 65% 대 60% 가 몇 문제 차이인지 알 수 없어서 “comfortably exceeding” 이라는 표현을 그대로 받기 어렵다.
4.2 Tool-use efficiency
세 시스템 모두 Claude Sonnet 4.6 을 쓴다.
소스 수준 도구 목록을 나란히 놓은 표다.
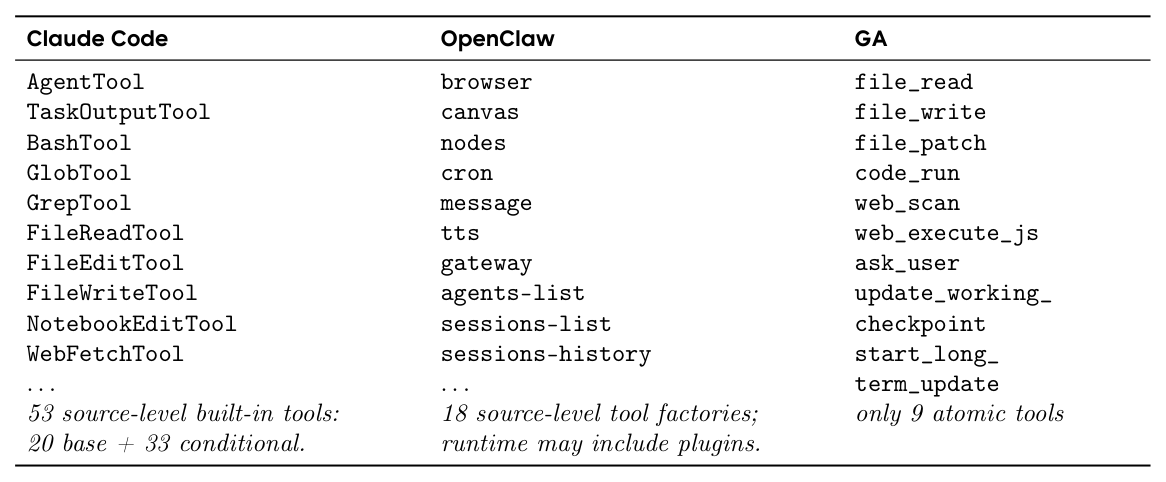
과제는 두 묶음이다.
특화 도구를 원자 도구 조합으로 재현할 수 있는지 보는 단순 과제와, 문서 생성(PDF/PPT), SQL 쿼리 생성, 실험 분석 보고서, 웹 검색이 섞인 구매 결정, 논문 재현 가능성 분석 다섯 개의 장기 과제다.
장기 과제 5개에서 GA 와 Claude Code 는 100%, OpenClaw 는 80% 다.
GA 의 총 토큰은 188,829 로 Claude Code 의 35.1%, OpenClaw 의 29.8% 이고, 모델 요청은 32.6에서 11.0으로, 도구 호출은 22.6에서 12.8로 준다.
도구 사용 분포(Figure 3)를 보면 Claude Code 는 AgentTool 이 50.4%, WebFetchTool 22.1%, FileReadTool 10.6% 로 몇 개에 몰려 있고 나머지 47개는 꼬리다.
수십 개 도구가 프롬프트를 차지하면서 실제로는 거의 안 불린다는 게 저자들의 해석이다.
-> 장기 과제가 5개뿐이고 저자들이 만든 과제라 100% 대 80% 는 한 과제 차이다.
4.3 Memory System Effectiveness
네 실험이다.
첫째는 반복 사용에 따른 효율 개선으로, GPT-5.4 백본으로 HuggingFace 데이터셋 5개를 내려받는 과제를 매번 새 세션에서 5회 반복한다.
Codex, Claude Code, OpenClaw 는 5회 내내 비슷한데 GA 는 실행 시간이 102초에서 약 66초로, 토큰이 200,439에서 100,000으로 줄었다(Figure 4).
둘째는 압축 메모리 ablation 으로, SOP-Bench 의 dangerous_goods 부분집합에서 메모리 없음, SOP 원문 전체, 압축본에 배경 설명을 덧붙인 것, 행동 규칙만 남긴 압축본 넷을 비교한다(Table 5).
메모리 없음은 TSR(Task Success Rate) 13.87%, 전체 SOP 575토큰은 52.44%, 중복 포함 288토큰과 압축본 165토큰은 둘 다 66.48% 다.
원문 전체를 넣는 것보다 규칙만 남긴 쪽이 더 잘 되고, 배경 설명을 더 붙여도 안 오른다.
셋째는 장기 사실 기억으로, LoCoMo 첫 번째 부분집합(요약 범주 제외)에서 GPT-5.4 로 Mem0, A-MEM(둘 다 text-embedding-3-small 사용), OpenClaw, GA 를 비교한다(Table 6).
GA 가 Multi-Hop F1 43.33, Temporal 52.23, Open-Domain 20.41, Single-Hop 45.69 로 네 범주 모두 가장 높고, 임베딩 모델이나 벡터 DB 없이 그렇다.
넷째는 컨텍스트 폭발 방지로, 네 시스템에 같은 스킬 20개를 설치하고 한참 쓴 뒤 “Hello” 한 마디를 넣었을 때 전체 프롬프트 길이를 잰 표다.
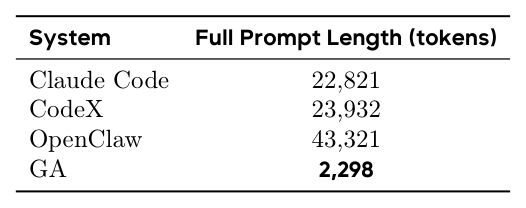
Claude Code 22,821, Codex 23,932, OpenClaw 43,321 토큰인데 GA 는 2,298 토큰이다.
메모리를 기본 주입하지 않고 필요할 때만 읽기 때문이라고 설명한다.
-> Table 5 결과는 앞에서 본 Experience-Following의 “전부 넣으면 오히려 못하다”와 같은 방향이다. 다만 SOP-Bench 한 부분집합, 백본 하나라 범위는 좁다.
-> LoCoMo 의 Mem0 수치(Multi-Hop F1 39.32)가 저자들이 다시 돌린 값인지 원문에서 확인 못 함.
4.4 Self-Evolution Capability
GA 와 OpenClaw 둘 다 Claude Opus 4.6 을 쓴다.
같은 유형의 GitHub 조사 과제를 9라운드 반복하는 종단 실험과, 8개 웹 과제를 각 3회 실행하는 교차 과제 실험 두 설정이다.
진화 단계는 자연어 실행, SOP 증류, 코드 실행 셋으로 나누고, 단계 전환은 수동 개입 없이 메모리 메커니즘이 스스로 일으킨다고 한다.
9라운드(Table 8)에서 1라운드는 7분 30초, LLM 호출 32회, 총 222,203 토큰이었고 9라운드는 1분 38초, 5회, 23,010 토큰으로 각각 78.2%, 84.4%, 89.6% 감소다.
2~5라운드의 텍스트 SOP 단계에서는 66k 에서 36k 로 줄어들다 오르내리고, 6라운드부터 코드화되면 23k±1k 로 수렴한다.
줄어든 건 응답 길이보다 호출 횟수다.
캐시 읽기 토큰이 183,375에서 19,034로, 입력 토큰이 15,581에서 1,323으로 떨어진다.
8개 과제(Figure 5)에서는 두 번째·세 번째 실행이 첫 실행보다 61.0%~92.4% 적은 토큰을 쓰고 평균 79.3% 감소다.
OpenClaw 는 같은 과제 B2 에서 1,370k, 2,330k, 2,130k 로 실행마다 다시 탐색한다.
-> 9라운드 실험은 라운드마다 새 과제 인스턴스라고 하는데 같은 LangChain 저장소에서 PR 을 조사하는 과제다. 인스턴스가 얼마나 다른지는 본문에 없고, 거의 같은 과제의 반복이라면 코드화 후 23k 수렴은 당연한 결과다.
4.5 Web Browsing Capability
GA 와 OpenClaw, 둘 다 Claude Opus 4.6 이다.
벤치마크는 WebCanvas(기본 브라우저 조작, 12개 무작위 추출), BrowseComp-ZH(중국어 웹 다중홉 검색, 10개 추출), 그리고 저자들이 만든 Custom Tasks 22개다.
채점은 WebCanvas 자동, BrowseComp-ZH 는 LLM 심판, Custom 은 GPT-5.4 보조 사람 검토다.
세 벤치마크의 점수와 과제당 평균 토큰을 잰 표다.
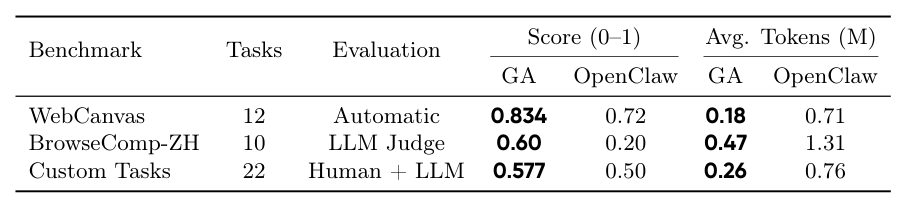
WebCanvas 에서 GA 0.834 와 0.18M 토큰, OpenClaw 0.72 와 0.71M.
BrowseComp-ZH 에서 GA 0.60 과 0.47M, OpenClaw 0.20 과 1.31M.
Custom 에서 GA 0.577 과 0.26M, OpenClaw 0.50 과 0.76M 으로, 토큰은 2.9~3.9배 적게 쓴다.
OpenClaw 는 원시 HTML 과 DOM 요소에 묻혀 상태 혼동과 컨텍스트 넘침이 생기고, GA 는 web_scan 으로 관찰을 압축해 다중홉 추론을 이어간다는 설명이다.
-> 과제 수가 12, 10, 22다. BrowseComp-ZH 10문제에서 0.6 대 0.2 는 6문제 대 2문제라, 방향은 보이지만 “3배”로 읽기엔 표본이 작다.
5. Discussion
통제된 ablation 보다 개발 경험에서 뽑은 다섯 가지 주장이다.
첫째, 컨텍스트 정보 밀도는 LLM 을 추론 엔진으로 쓰는 모든 에이전트의 구조적 제약이며, 도구나 메모리를 더 붙여도 우회할 수 없다.
둘째, 에이전트에 필요한 최소 능력 집합은 도구 인터페이스, 컨텍스트 관리, 메모리 형성 셋이며, 이 셋에 기여하지 않는 복잡성은 밀도를 낮춘다.
셋째, 장기 과제에서는 토큰을 적게 쓰는 쪽이 더 잘 푼다.
토큰을 많이 쓰는 에이전트는 깊이 생각하고 있다기보다 컨텍스트 관리 실패를 추가 상호작용으로 메우고 있을 가능성이 높다고 본다.
넷째, 권한이 능력의 상한이다.
탐색 단계에서 행동 범위를 잠그면 안전하지만 쓸모없는 시스템이 된다.
다섯째, 최소 구조는 자율 진화의 전제조건이다.
수십만 줄 코드는 에이전트가 읽거나 고칠 수 없지만 몇천 줄이면 가능하고, 다음 단계로 구조 자체의 자기 갱신을 검증 안 된 추측으로 열어 둔다.
-> 셋째 주장은 인과로 읽기 어렵다. 같은 모델에서 컨텍스트가 짧은 쪽이 잘 됐다는 관찰을 설계 원칙으로 바꾼 것인데, 탐색이 꼭 필요한 과제에서 토큰을 아끼면 성능이 떨어지는 경우는 이 논문 범위에서 안 보인다.
6. Related Work
ReAct, Reflexion, AutoGPT, MetaGPT 에서 CodeAct, SWE-agent, OpenHands, 그리고 Claude Code, Codex, Manus, OpenClaw 로 이어지는 시스템 계열과, MemGPT, A-MEM, LongLLMLingua 의 메모리·압축 계열, Agent-Pro, Voyager, EvolveR 등의 자기진화 계열을 정리한다.
GA 의 차이는 세 계열을 정보 밀도라는 하나의 목표로 함께 설계했고, 메모리를 저장·검색보다 검증·선택 문제로 다루며, 반성의 끝을 자연어 지침 대신 코드로 둔다는 점이라고 한다.
7. Conclusion
GA 는 컨텍스트 정보 밀도 최대화라는 원칙 하나로 도구, 메모리, 자기진화, 압축을 설계한 시스템이다.
다섯 평가 항목에서 기존 시스템과 같거나 나은 완료율을 더 적은 토큰과 상호작용으로 얻었고, 반복 실행에서 토큰을 최대 89.6% 줄였다.
장기 에이전트 능력은 도구·메모리·컨텍스트를 더하는 것보다 실행 중 정보를 어떻게 표현하고 유지하느냐에 달려 있다는 게 결론이다.
한계는 3.3절에 따로 있고 실험 전체에 대한 한계 절은 없다.
베이스라인이 저자들과 무관한 제품들이라 설정 차이(도구 구성, 시스템 프롬프트, 권한)가 결과에 얼마나 들어갔는지는 원문에서 확인 못 함.
8. 지금 관점: 컨텍스트 예산을 30k 로 잡으면 무엇이 달라지나
이 논문은 앞선 리뷰 몇 편을 한 시스템에 눌러 담은 모양이다.
Reflexion의 반성문이 L3 SOP 가 되고, Voyager의 코드 스킬 라이브러리가 “SOP 에서 코드로” 단계가 되고, MemGPT의 페이징이 L1 인덱스에서 L2·L3 로 가는 온디맨드 읽기가 된다.
Mem0와 A-MEM은 여기서 LoCoMo 비교 대상으로 나오는데, 임베딩 없이 파일 읽기만으로 이겼다는 결과는 ReFind의 “구조보다 검색”과 묶어서 볼 만하다.
새로운 부품은 거의 없고, 새로운 건 상시 노출은 인덱스뿐이라는 기본값과 30k 토큰 예산을 끝까지 지킨다는 결정이다.
지금 가져다 쓸 수 있는 건 2.3.4절의 4단계 절단·압축이다.
도구 출력 앞뒤 절반 남기기, 오래된 메시지의 tool_result 를 800자로 줄이기, 예산 초과 시 60% 까지 비우기, 매 턴 붙는 anchor 에 최근 20턴 요약과 key_info 넣기는 어느 프레임워크에서든 하루면 붙일 수 있다.
Table 7 의 “Hello” 테스트도 그대로 쓸 수 있는 진단이다.
스킬을 다 설치한 에이전트에 한 마디 넣었을 때 프롬프트가 몇 토큰인지 재 보면 메모리가 기본 주입인지 온디맨드인지 바로 드러난다.
Table 5 의 메시지도 분명해서, SOP 를 메모리에 넣을 거면 원문 대신 행동을 바꾸는 규칙만 추려서 넣어야 하고, 배경 설명은 토큰만 먹는다.
그대로 받아들이기 어려운 부분은 수치의 범위다.
장기 과제 5개, 웹 과제 12·10·22개, 반복 실험은 저장소 하나에서 9라운드다.
베이스라인은 저자들이 통제하지 않는 제품이라 도구 구성과 권한 설정이 어떻게 맞춰졌는지 알 수 없다.
토큰을 적게 쓰는 쪽이 더 잘 푼다는 Discussion 의 주장은 이 논문의 과제 범위에서 관찰된 상관이고, 탐색이 꼭 필요한 과제에서 30k 예산이 완전성을 깎는 경우는 다루지 않는다.
ask_user 한 번으로 끝나는 사람 개입과 권한이 능력의 상한이라는 입장은, 사용자 데이터와 외부 서비스를 만지는 에이전트를 운영하는 입장에서는 그대로 따르기 어렵다.
도구 9개와 30k 예산이라는 제약을 내 과제에 걸어 보고 완료율이 어디서 떨어지는지 재 보는 게, 이 논문의 주장을 확인하는 가장 빠른 길이다.
Leave a comment