
EFRE Paper review
From a Prompt to Repertoires: Evolving Functional REpertoires Enable LLM Continual Learning
https://arxiv.org/abs/2610.11373
EFRE 는 홍콩중문대(선전)·상하이 AI Lab·USTC·NJIT 저자들이 만든 continual learning 방법이다.
모델 가중치는 건드리지 않고, 프롬프트 여러 개로 이루어진 repertoire 를 키워 가며 새 과제를 배운다.
앞에서 본 The Past Is Prologue에서는 메모리 갱신을 옛 메모리와 붙여 보고 나은 쪽만 남겼는데, 이 논문은 같은 생각을 프롬프트 최적화에 적용한다.
arXiv 에 올라온 논문이다. 저자는 7명이고 코드 공개 여부는 재료에서 확인 못 함.
1. Introduction
LLM continual learning 은 새 지식과 기술을 배우면서 이미 배운 것을 잃지 않아야 한다.
기존 방법은 대부분 파라미터를 어떻게 갱신할지를 설계한다. LoRA(저랭크 어댑터 학습), replay(옛 데이터를 섞어 다시 학습), GRPO(그룹 내 상대 보상으로 하는 강화학습) 같은 것들이다.
효과는 있지만 학습 비용이 크다.
한편 프롬프트 최적화는 파라미터를 안 건드리고도 지식·추론 과제에서 GRPO 에 맞먹거나 넘는 성능을 보여 왔다.
그러면 프롬프트 최적화를 continual learning 에 그대로 쓰면 되지 않나.
저자들의 분석과 앞선 연구(Harrington et al., 2026)는 안 된다고 한다.
과제가 순서대로 들어오면 프롬프트를 다시 쓸 때마다 앞 과제용 지시가 덮어써지고, 프롬프트에는 일반 원칙 대신 사례별 규칙이 쌓인다.
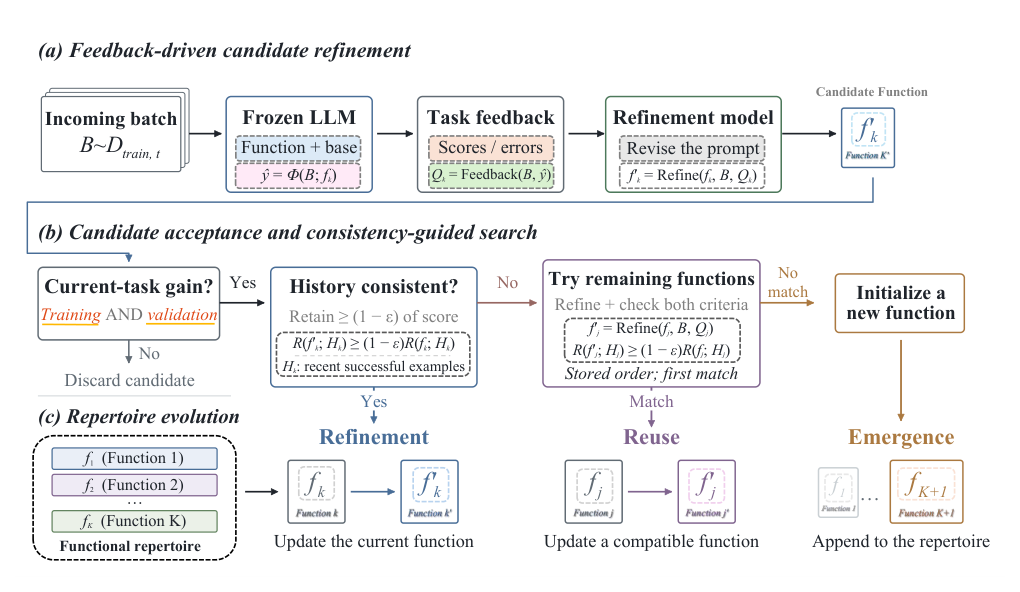
그래서 프롬프트 하나 대신 function 여러 개로 이루어진 repertoire 를 둔다.
function 하나가 프롬프트 하나다.
갱신이 기존 function 의 과거 성공 사례와 양립하면 그 function 을 다듬고, 양립 못 하면 새 function 이 생긴다.
이 과정에서 특화와 재사용이 저절로 나온다는 주장이다.
숫자로 보면 ToolUse → FinQA → SciKE-Bio 세 과제를 순서대로 배운 뒤 Qwen3-8B 기준 최종 평균 58.75 로 GRPO 와 GEPA 를 넘고, Bio 를 배운 뒤 앞 과제 하락은 1.57점이다. GRPO 는 8.32, GEPA 는 11.82.
Continual Learning Bench 의 환경 여섯 개에서 만든 최소 에이전트에서도 Qwen3-8B 로 18.0, GPT-5.6-Luna 로 36.3 을 기록해 ICL 과 GEPA 를 넘는다.
기여는 세 가지로 정리한다. 프롬프트 최적화의 두 한계(덮어쓰기, 사례별 규칙 축적) 확인, EFRE 제안, 그리고 continual learning 과 단일 과제 양쪽에서의 실증.
2. Related Work
Continual learning 쪽은 replay·정규화·파라미터 격리·PEFT·RL 로 stability–plasticity 트레이드오프를 다뤄 왔고, 최근에는 LLM 과 언어 에이전트로 범위가 넓어졌다.
비파라미터 최적화 쪽은 프롬프트·컨텍스트·메모리 같은 텍스트 상태를 피드백과 반성으로 고치는 방법들이다. GEPA 와 ACE 가 대표다.
EFRE 는 이 텍스트 상태를 하나가 아니라 function 들의 repertoire 로 조직한다는 점이 다르다.
3. Methodology
3.1 Problem Statement
파라미터가 고정된 모델 Φ 가 있다.
단계 t 마다 학습 배치가 들어오고, 학습기는 외부 텍스트 상태 S 를 갱신한다. S 에는 프롬프트·스킬 같은 텍스트가 들어간다.
평가는 각 단계의 held-out 평가셋에서 하고, 이 평가셋은 S 갱신에 절대 쓰지 않는다.
지표는 continual learning 의 고전 두 가지다.
plasticity 는 현재 과제 점수가 학습 전후로 얼마나 올랐는가.
stability 는 이전 과제들의 점수가 이번 단계 전후로 평균 얼마나 변했는가. 음수면 잊은 것, 0 이면 변화 없음, 양수면 뒤로 전이된 것이다.
부록을 보면 stability 는 “이번 단계 직전 대비”라서, 처음 배웠을 때 대비로 재는 누적 backward transfer 와는 다르다고 명시한다.
3.2 Prompt Optimization for Continual Learning
프롬프트 최적화를 continual learning 에 쓰면 이렇게 된다.
현재 프롬프트로 학습 배치를 돌리고, 환경이 점수와 텍스트 피드백(테스트 결과, 오류 메시지 등)을 돌려주면, 별도의 refinement 모델이 프롬프트를 다시 쓴다.
후보는 학습 배치와 별도 검증셋 양쪽에서 점수가 오를 때만 채택된다.
문제는 이 채택 규칙이 현재 과제만 본다는 것이다.
이전 과제에서의 유지는 전혀 확인하지 않으니, 반복해서 다시 쓰다 보면 앞 과제를 지탱하던 지시가 사라진다.
동시에 프롬프트에는 사례별 규칙이 쌓여서 새 요구를 받아들이기 어려워진다.
부록 E 에 GEPA 와 ACE 가 세 과제를 거치며 만든 프롬프트 예시가 있는데, “이전에 성공한 예와 비슷하면 그때 절차를 따르라”, “revenue 질문은 마지막 표의 마지막 열을 보라” 같은 규칙이 영역별로 길게 붙어 있다.
3.3 EFRE: Evolving Functional Repertoires
function f_k 는 추론 절차나 특정 입력 처리법 같은 학습된 능력을 담은 프롬프트다.
repertoire F_t 는 단계 t 에 쓸 수 있는 function 들의 집합이다.
function 마다 최근에 그 function 이 성공적으로 흡수한 예시를 최대 H 개(기본 20) 보관하는 history 가 있다.
function 과 과제는 미리 짝지어 두지 않는다. 한 function 이 여러 과제를 맡을 수 있고, 한 과제가 여러 function 을 쓸 수 있다.
갱신은 이렇게 돈다.
repertoire 는 function 하나로 시작한다.
배치가 들어오면 현재 function 으로 돌려 피드백을 받고, refinement 모델이 후보 f’_k 를 만든다.
후보는 먼저 학습 배치와 검증셋 양쪽에서 원래 function 보다 점수가 올라야 한다. 동점도 탈락이다. 여기서 떨어지면 다른 function 은 보지 않고 그 배치는 끝난다.
현재 과제 개선을 통과한 후보는 historical consistency 검사를 받는다.
그 function 의 history 에서 후보 점수가 원래 점수의 (1 − ε) 배 이상이어야 한다. 기본 ε = 0.1, 즉 과거 사례 점수의 90% 이상을 지켜야 한다.
history 가 비어 있으면 검사를 건너뛴다.
통과하면 현재 function 을 교체하고 성공한 예시를 history 에 붙인다. 이것이 refinement.
현재 과제는 개선되는데 history 를 못 지키면, 나머지 function 을 저장된 순서대로 돈다.
각 function 으로 배치를 돌려 피드백을 받고 그 function 용 후보를 새로 만든다. 원래 가지에서 떨어진 후보를 복사해 오는 게 아니다.
그 function 자신의 학습·검증·history 세 조건을 모두 처음 통과하는 것을 채택하고 멈춘다. 전부 다 보고 최댓값을 고르지 않는다. 이것이 reuse.
어느 function 도 못 받으면 refinement 모델이 실패한 시도들의 피드백까지 넣어 새 function 을 만든다.
이번 갱신 전 현재 프롬프트보다 학습·검증 점수가 올라야 추가되고, history 는 새 function 이 성공한 예시로 초기화된다. 이것이 emergence.
repertoire 는 최대 50개까지이고, 꽉 찼을 때 기존 function 이 못 받는 갱신은 버린다.
어느 경로로든 채택된 가지가 다음 배치의 현재 function 이 된다.
추론 때는 고정 지시문을 가진 텍스트 selector σ 가 입력과 현재 function 프롬프트들을 보고 하나를 고른다.
고른 function 과 공유 base 지시를 붙여 frozen LLM 이 답을 낸다.
과제 라벨은 필요 없다. selector 의 지시문은 학습 중 바뀌지 않고, 고를 수 있는 function 목록만 바뀐다.
-> 학습은 “가장 최근 채택된 가지”에서 이어가고 추론은 입력마다 selector 가 고른다. 학습 때 마이크로배치(기본 3개) 안의 예시를 selector 로 나눠 보내지는 않는다고 부록에 적혀 있다. 배치 안에 성격이 다른 입력이 섞이면 어느 function 에 흡수되는지가 순서에 좌우될 것 같다.
-> historical consistency 는 “직전 버전 대비 10% 이내 하락”이다. 부록 D.2 에서 저자들도 이 손실이 갱신을 거듭하며 누적될 수 있다고 인정하고, 그래서 시스템 수준 유지는 held-out 셋의 stability 로 따로 잰다고 쓴다.
4. Experiments
4.1 Experimental Setup
continual learning 열은 ToolUse(ToolAlpaca 에서 뽑은 도구 선택·인자 구성) → FinQA(재무 보고서 표·텍스트에서 수치 계산) → SciKE-Bio(SciKnowEval 의 생물 객관식) 순서다. 데이터와 평가 프로토콜은 Harrington et al.(2026)을 따른다.
단계마다 끝나면 현재 과제와 이전 과제를 모두 평가한다.
단일 과제 실험은 HotpotQA(위키 기반 다중홉 QA), IFBench(검증 가능한 제약을 지키는 지시 따르기), AIME-2025(2025년 미국 수학 초청 시험 30문제), LiveBench-Math 네 개.
에이전트 continual learning 은 Continual Learning Bench 의 환경 여섯 개다.
비교 대상은 파라미터를 바꾸는 쪽으로 SFT, SDFT(시연 조건부 자기 자신을 교사로 쓰는 on-policy 자기증류), SDPO(피드백 조건부 자기 교사의 예측을 증류), GRPO, In-Place TTT(추론 중 일부 MLP 가중치를 고치는 test-time training).
텍스트 상태를 바꾸는 쪽은 GEPA(실행 흔적과 평가 피드백을 자연어로 반성해 프롬프트를 진화)와 ACE(생성·반성·큐레이션으로 playbook 을 쌓는 방법).
백본은 Qwen3-8B 와 GPT-5.6-Luna 두 개를 쓰고, refinement 모델도 이 둘 중 하나다. † 표시는 GPT-5.6-Luna 로 refinement 했다는 뜻이다.
ablation 은 Qwen3-8B 백본 + GPT-5.6-Luna refinement 고정.
모든 모델은 reasoning effort low. ε = 0.1, H = 20.
function 선택은 refinement 모델에 라우팅 프롬프트를 줘서 한다.
단일 과제 최적화는 한 번만 돌리고, 나머지 실험은 세 번 반복해 평균과 표준편차를 낸다.
-> selector 를 refinement 모델이 맡는다는 말은, EFRE† 라면 Qwen3-8B 가 답을 내기 전에 GPT-5.6-Luna 가 입력마다 한 번씩 호출된다는 뜻이다. 추론 비용 비교는 논문에 없다.
4.2 Main Results
Figure 3 은 열두 가지 설정에서 세 과제 점수가 단계별로 어떻게 움직이는지 보여 준다.
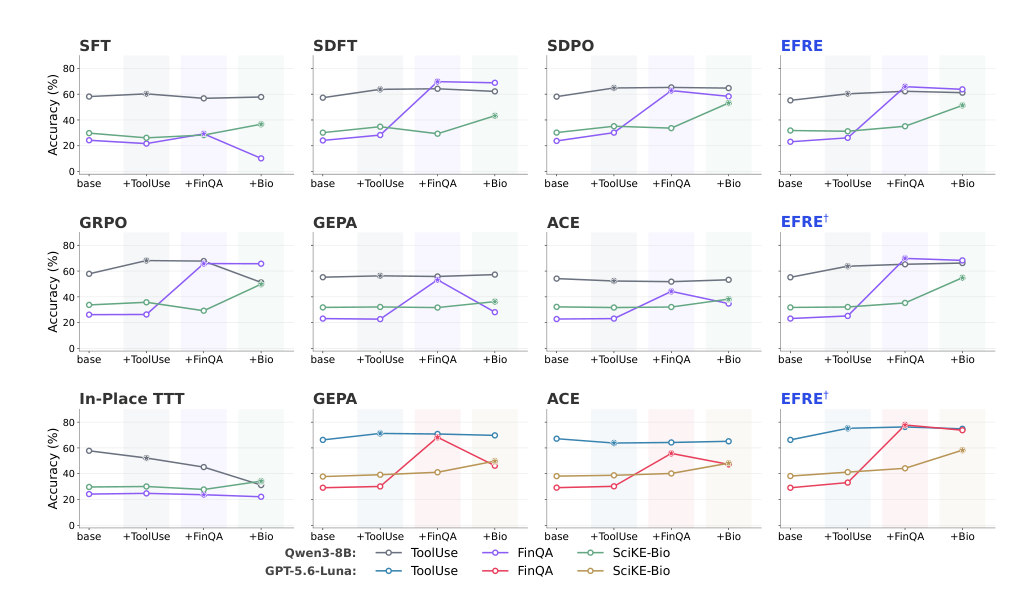
Qwen3-8B 백본에서 EFRE† 는 Bio 를 배운 뒤 FinQA 가 1.56점 떨어진다. GEPA 는 25.10점, ACE 는 9.43점 떨어진다.
최종 ToolUse/FinQA/Bio 점수는 66.21/68.26/54.83.
GPT-5.6-Luna 백본에서는 FinQA 73.76% 를 유지한다. GEPA 는 46.24%, ACE 는 47.28%.
그림에서 GEPA 와 ACE 는 FinQA 를 배운 직후 보라색 선이 올라갔다가 Bio 를 배우면서 다시 꺾이는데, EFRE 는 거의 평평하다.
파라미터 쪽도 보면 SFT 는 Bio 를 배운 뒤 FinQA 가 10점대로 무너지고, GRPO 는 ToolUse 가 67에서 51로 떨어진다. SDFT 와 SDPO 는 비교적 잘 버틴다.
단계별 전체 수치는 부록 Table 7 에 있다. 세 과제 정확도와 Bio 이후 최종 평균이다.
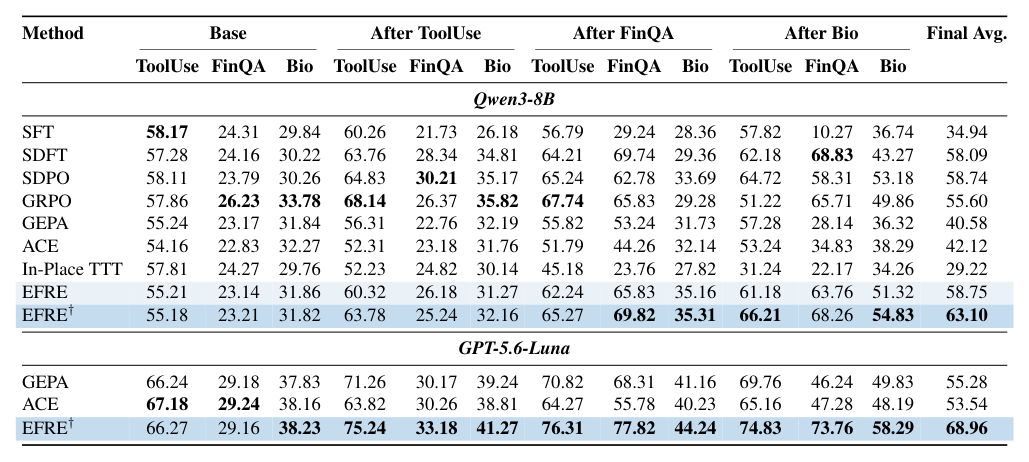
Qwen3-8B 에서 최종 평균은 EFRE† 63.10, EFRE 58.75, SDPO 58.74, SDFT 58.09, GRPO 55.60, GEPA 40.58.
GPT-5.6-Luna 에서는 EFRE† 68.96, GEPA 55.28, ACE 53.54.
-> Base 열을 보면 같은 Qwen3-8B 인데 ToolUse 가 54.16 에서 58.17 까지 방법별로 다르다. 세 번 반복한 분산이라기엔 큰데, 방법마다 scaffold 나 base 프롬프트가 달라서인지 원문에서 확인 못 함.
Figure 2 와 Table 1 은 repertoire 가 어떻게 조직됐는지 보여 준다.
continual learning 에서 f1, f3, f5 는 각각 ToolUse, FinQA, Bio 를 주로 맡고, f6 은 세 과제에서 17%, 16%, 19% 씩 쓰인다.
Table 1 에 따르면 Qwen3-8B refinement 는 function 7개 중 2개가 두 과제 이상에서 쓰이고 cross-task reuse 는 41.7%, GPT-5.6-Luna refinement 는 19개 중 6개, 56.3% 다.
학습된 function 예시로는 “다음 행동을 정하고 도구를 고른 뒤 스키마에 맞춰 인자를 확인하라”, “재무 수치와 단위를 뽑아 계산식을 쓰고 원 표와 대조하라” 같은 것이 나온다.
과제별로 프롬프트 하나씩 배정된 구조와는 다르다는 근거로 제시한다.
4.3 Ablation Study and Mechanism Analysis
Table 2 는 ToolUse → FinQA → Bio 열에서 history 크기, ε, 선택 전략을 하나씩 바꿔 plasticity 와 stability 를 잰 표다.
history 는 최근 20개(Last-20), 50개, 20개 + 검증셋 세 가지를 비교한다.
Last-20 이 모든 단계에서 plasticity 가 가장 높고 Bio 이후 stability 도 −0.31 로 가장 덜 떨어진다. history 를 늘린다고 좋아지지 않는다.
ε 는 0, 0.1, 0.2, 0.5, 1.0 을 본다.
0.1 이 모든 단계에서 가장 좋다. Bio 단계 plasticity 가 +19.52 인데, 과거 점수를 한 점도 못 잃게 하는 ε = 0 은 +11.46, 제약을 아예 없앤 ε = 1 은 +13.04 다.
같은 설정에서 GEPA 는 +4.59, GRPO 는 +20.58 이고 stability 는 각각 −11.82, −8.32. EFRE 는 plasticity 에서 GRPO 에 근접하면서 stability 는 −0.31 이다.
-> ε = 1 이면 history 검사가 사실상 없으니 reuse 와 emergence 가 거의 안 일어나고 프롬프트 하나를 계속 고치는 것에 가까울 텐데, 그래도 stability 가 −2.57 로 GEPA 의 −11.82 보다 훨씬 낫다. GEPA 와의 차이가 history 검사만은 아니라는 뜻이다. selector 와 다중 프롬프트 구조 자체의 효과인지 refinement 프롬프트 차이인지는 이 표만으로는 가를 수 없다.
선택 전략은 First(항상 첫 function), Random, Embedding-20/50(Qwen3-Embedding-0.6B 를 function 당 20/50개 history 로 파인튜닝해 검색), LLM-selector, Oracle(모든 function 을 돌려 보고 가장 높은 점수를 고르는 상한)을 비교한다.
LLM-selector 가 Oracle 을 뺀 것 중 모든 단계에서 plasticity 가 가장 높다. Embedding-50 은 Bio 단계 stability 가 −0.29 로 아주 조금 낫지만 plasticity 는 내내 낮다.
Oracle 은 Bio 단계 plasticity 를 +19.52 에서 +24.35 로 올린다. 같은 repertoire 안에서도 선택을 더 잘하면 5점 가까이 남아 있다는 뜻이다.
단일 과제 네 벤치마크 결과가 Table 3 이다. 백본은 Qwen3-8B 고정, refinement 모델만 두 가지다.
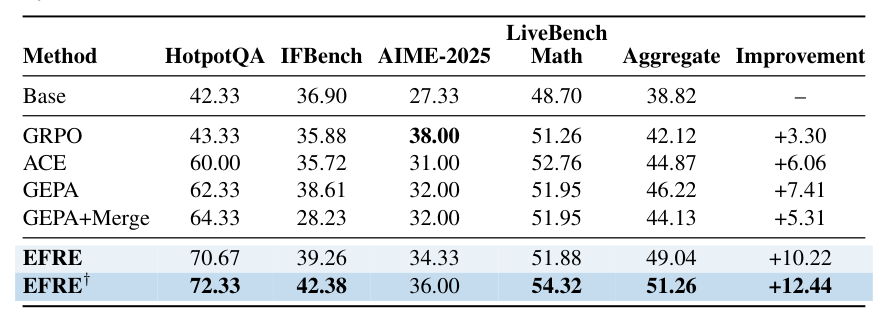
EFRE 는 평균 49.04 로 GEPA 46.22, ACE 44.87, GRPO 42.12 를 넘고, GPT-5.6-Luna refinement 면 51.26 이다.
단일 과제인데도 function 이 8개, 12개 생기고 사용량이 여러 function 에 흩어진다(Figure 2c).
과제 전환이 없어도 한 과제 안에서 여러 절차로 갈라질 수 있다는 것이다.
-> AIME-2025 는 GRPO 가 38.00 으로 가장 높고 EFRE† 는 36.00 이다. 수학 추론에서는 프롬프트로 바꿀 수 있는 폭이 작아 보인다. 또 “GEPA+Merge” 행이 무엇인지 본문·부록 어디에도 설명이 없다. ??
5. Extension: EFRE for Agent Continual Learning
Continual Learning Bench 의 가벼운 scaffold 를 그대로 쓰고, 모든 방법을 같은 agent–environment 루프에 넣는다.
EFRE 에서는 frozen LLM 하나가 과제 실행, function 선택, refinement 를 다 한다.
관찰이 들어오면 function 을 고르고 그 프롬프트 아래서 행동을 만든다.
상호작용 피드백으로 function 을 갱신하고, 과거 상호작용을 재생(replay)해서 historical consistency 를 확인한다.
여섯 환경은 Blind Spectrum Monitoring, Codebase Adaptation, Cohort Studies, Database Exploration, Exploitable Poker, Sales Prediction 이다.
점수는 벤치마크가 정한 기준 보상을 0, 상한 보상을 100 으로 둔 정규화 보상이라 음수가 나올 수 있다. 정확도가 아니다.
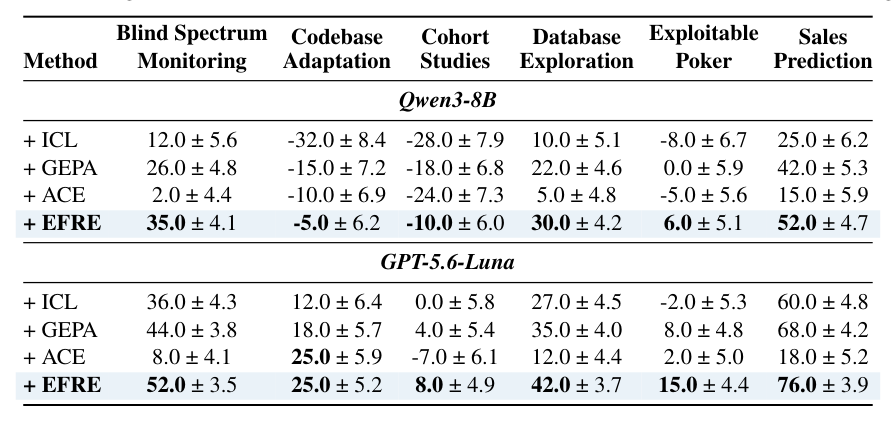
Qwen3-8B 에서 EFRE 는 여섯 환경 모두 평균이 가장 높고, 전체 평균 18.0 대 GEPA 9.5, ICL −3.5 다.
GPT-5.6-Luna 에서는 36.3 대 GEPA 29.5, ICL 22.2. 다섯 환경에서 가장 높고 Codebase Adaptation 은 ACE 와 25.0 으로 같다.
-> ACE 는 두 백본 모두에서 ICL 보다 못한 환경이 여럿이다(Qwen3-8B 의 Blind Spectrum 2.0, Sales 15.0). ACE 쪽 설정이 이 scaffold 에 맞지 않았을 가능성도 있어 보이는데, 원문에는 이유가 없다.
-> 표준편차가 4~8 인데 Qwen3-8B 의 Exploitable Poker(6.0 ± 5.1 대 GEPA 0.0 ± 5.9)처럼 차이가 표준편차 안에 드는 칸도 있다. 세 번 반복한 결과다.
6. Conclusions
EFRE 는 LLM 을 고정한 채 프롬프트로 표현된 function 들의 repertoire 를 진화시키는 비파라미터 continual learning 방법이다.
historical consistency 검사가 refinement·reuse·emergence 를 결정한다.
실험에서 망각이 줄고 최종 평균이 오르며, 단일 과제에서도 이득이 있었고, 최소 에이전트 확장에서도 개선을 봤다고 정리한다.
원문에 Limitations 절은 없다. 부록 곳곳에 흩어진 단서를 모으면 이렇다.
continual learning 열은 과제 세 개짜리 하나뿐이고, 순서를 바꾼 실험은 없다.
historical consistency 는 직전 버전 대비라 손실이 누적될 수 있다(D.2).
reuse 탐색이 실패했다는 것은 “만든 후보들이 조건을 못 넘었다”는 것이지 “어떤 수정도 양립 불가”라는 뜻은 아니다(D.2).
비용 표(Table 10)는 API 입력 토큰을 뺀 금액이고, 추론 시 selector 호출 비용은 어디에도 없다.
단일 과제는 한 번만 돌렸다.
-> 50개 상한에 실제로 닿은 경우가 있는지, 닿으면 어떻게 되는지는 실험이 없다. 과제 세 개에서 최대 19개까지 생겼으니 과제가 열 개쯤 되면 상한이 문제가 될 수 있다.
7. 지금 관점: 프롬프트 갱신에 회귀 테스트를 붙이는 방법
이 논문을 메모리 글로 읽으면 “갱신을 언제 받아들일 것인가”의 문제다.
The Past Is Prologue는 후보 갱신을 옛 메모리와 비교해 나은 쪽을 남겼고, RBC는 playbook 의 어떤 교훈을 남길지를 무작위 실험으로 정했다.
EFRE 는 여기에 “과거에 성공한 사례 20개에서 점수가 10% 넘게 빠지면 반려”라는 규칙을 둔다.
소프트웨어로 치면 프롬프트 변경 PR 에 회귀 테스트를 붙인 것이고, 테스트가 깨지면 다른 모듈에 넣어 보고, 그래도 안 되면 모듈을 새로 판다.
Voyager가 성공한 행동을 코드로 저장해 skill library 를 키웠다면, 여기서는 프롬프트가 그 단위다.
지금 가져다 쓸 수 있는 부분은 규칙 자체다.
시스템 프롬프트나 스킬 문서를 LLM 이 고쳐 쓰게 하는 자기진화 루프를 돌리고 있다면, 최근 성공 사례 20개를 붙여 두고 갱신 후 점수를 재는 것만으로 Table 2 의 ε = 0 과 ε = 1 사이 어딘가는 얻을 수 있다.
history 를 50개로 늘린다고 좋아지지 않았다는 결과도 실무에 편하다. 검증 비용이 20개 분량으로 묶인다.
Table 10 을 보면 Qwen3-8B 로 refinement 까지 로컬에서 돌린 EFRE 가 세 단계 전체에 6.8 GPU 시간, GEPA 가 6.0 GPU 시간 + API 호출 1,400회다. reuse 탐색과 history 검사가 붙어도 학습 비용은 GEPA 와 같은 자릿수다.
그대로 받아들이기 어려운 부분도 있다.
첫째, selector 다. ablation 에서 selector 는 GPT-5.6-Luna 였고, Oracle 과의 차이가 Bio 단계 plasticity 5점이다. 작은 모델이 selector 를 맡는 설정은 Qwen3-8B 단독(EFRE, †없음)뿐인데 그 설정의 ablation 은 없다.
실제 서비스라면 입력마다 selector 를 한 번 더 부르는 비용과 지연이 붙고, function 이 19개쯤 되면 프롬프트 19개를 전부 selector 컨텍스트에 넣어야 한다.
둘째, 벤치마크 범위다. 과제 세 개, 순서 하나, 세 번 반복이다. Harrington et al. 의 데이터를 그대로 썼기 때문에 비교는 깔끔하지만, 과제가 십수 개로 늘고 비슷한 과제가 섞여 들어올 때 function 이 쪼개지기만 하는지 합쳐지기도 하는지는 모른다. 합치는 연산 자체가 없다.
셋째, Harness Benefit에서 봤듯 갱신을 잘 만드는 능력과 갱신으로 득을 보는 능력은 다르다. 부록 Table 9 의 교차 실험을 보면 GPT-5.6-Luna 가 만든 repertoire 를 Qwen3-8B 가 쓰면 63.10 에서 65.02 로 오르지만, 같은 repertoire 를 GPT-5.6-Luna 가 쓰면 68.96 이다. 프롬프트가 옮겨 다닐 수는 있어도 결과는 실행 모델이 좌우한다.
그래서 내가 보는 이 논문의 쓸모는 “프롬프트를 몇 개로 쪼갤까”보다 “갱신 채택 조건을 어떻게 둘까”에 있다.
학습·검증 개선 + 과거 사례 90% 유지 + 안 되면 다른 가지 + 그래도 안 되면 새 가지. 이 네 단계는 모델이나 벤치마크와 무관하게 옮길 수 있는 절차다.
function 이 몇 개가 적당한지는 이 논문도 답하지 않는다. 50개는 상한일 뿐이고, 실제로는 7개와 19개가 나왔다.
Leave a comment