
From Human Memory to AI Memory Paper review
From Human Memory to AI Memory: A Survey on Memory Mechanisms in the Era of LLMs
https://arxiv.org/abs/2504.15965
From Human Memory to AI Memory는 Huawei Noah’s Ark Lab에서 쓴 LLM 메모리 서베이 논문이다.
사람의 기억 분류에서 출발해서, AI 메모리를 대상·형태·시간 세 축으로 8분면에 나눈다. 2025년 4월 arXiv에 올라왔다.
뒤에서 볼 서베이(Memory in the Age of AI Agents)보다 8개월 먼저 나왔고, 같은 대상을 다르게 나눈다. 두 서베이 비교는 글 맨 끝 지금 관점 절에 적었다.
1. Introduction
기존 리뷰들이 메모리 메커니즘은 자세히 정리했지만, 대부분 단기/장기라는 시간 기준 하나로만 나눴다고 한다.
논문은 시간 기준만으로는 부족하다고 보고, 대상(object)과 형태(form)를 더한다.
LLM 기반 AI 시스템의 메모리와 사람 기억이 어떤 관계인지, 사람 기억에서 아이디어를 얻어 더 나은 메모리를 어떻게 만들 수 있는지를 정리한 리뷰도 아직 없다고 본다.
그래서 사람 기억 분류부터 시작해서 AI 메모리와 연결한다.
2. Overview
2.1 Human Memory
인간 기억 쪽부터 본다.
Atkinson-Shiffrin 다중저장 모델로 단기와 장기를 나눈다.
단기 기억은 적은 양의 정보를 짧게(초~분) 들고 있는 임시 저장이다. 두 가지로 나뉜다.
- 감각 기억 : 바깥에서 들어온 감각 정보를 수 밀리초~수 초 동안 잠깐 저장
- 작업 기억 : 문제 풀기나 학습 같은 걸 하려고 정보를 직접 처리하고 조작
장기 기억은 몇 분에서 평생까지 가는 저장이다. 역시 두 가지로 나뉜다.
- 명시적 기억(서술 기억) : 말로 꺼낼 수 있는 기억. 개인 경험인 일화 기억(점심에 뭘 먹었는지)과 사실·지식인 의미 기억(지구는 둥글다)으로 나뉨
- 암묵적 기억(비서술 기억) : 말로 설명하기 어려운 습관·기술. 자전거 타기 같은 절차 기억이 대표적
뒤에서 볼 서베이도 7.8절에서 Atkinson-Shiffrin과 Tulving을 가져오는데, 거기서는 마지막 절에 두고 여기서는 시작점에 둔다.
2.2 Memory of LLM-driven AI Systems
2.2.1 Fundamental Dimensions of AI Memory
AI 메모리를 대상(personal/system), 형태(non-parametric/parametric), 시간(short-term/long-term) 세 차원으로 나눈다. 모달리티나 정적/스트리밍 같은 기준도 있지만 여기서는 주 기준으로 두지 않는다고 한다.
2.2.2 Parallels Between Human and AI Memory
사람 기억 범주를 AI 메모리에 하나씩 짝지어 그림으로 보여준다.
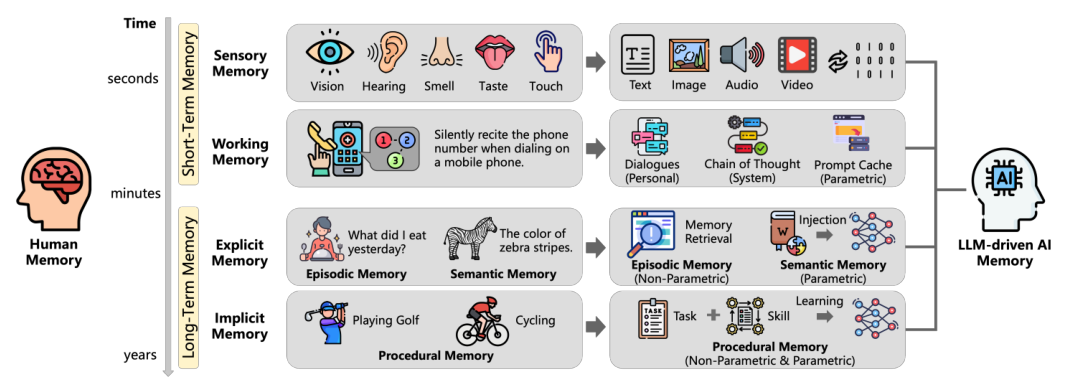
왼쪽이 사람 기억, 오른쪽이 LLM 기반 AI 메모리다. 감각 기억은 텍스트·이미지·오디오·비디오 입력으로, 작업 기억은 대화·CoT·프롬프트 캐시로 이어진다.
장기 기억 쪽은 일화 기억이 비파라미터 검색으로, 의미 기억이 파라미터 주입으로, 절차 기억이 태스크와 스킬 학습으로 대응된다.
2.2.3 3D-8Q Memory Taxonomy
세 축으로 나눈다.
- Object (대상) : personal / system
- Form (형태) : non-parametric / parametric
- Time (시간) : short-term / long-term
2×2×2 = 여덟 분면이다. 논문 Table 1은 분면마다 사람 기억 쪽 이름(Working, Episodic 등)을 붙여 둔다. Role 열이 그 이름이고, Function 열이 분면별 역할이다.
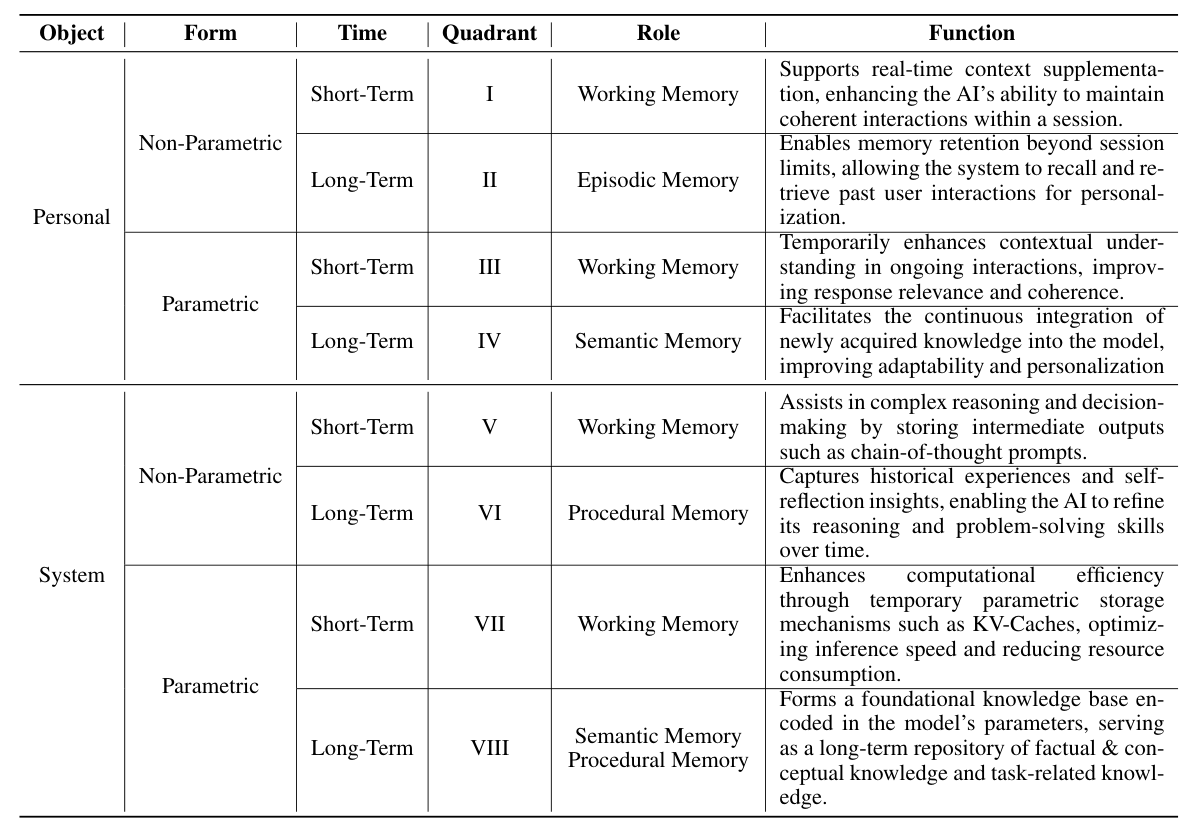
- I (Working, personal·비파라미터·단기) : 세션 안에서 실시간으로 맥락을 보충
- II (Episodic, personal·비파라미터·장기) : 세션을 넘어 과거 사용자 대화를 떠올려서 개인화
- III (Working, personal·파라미터·단기) : 지금 대화의 맥락 이해를 잠깐 강화
- IV (Semantic, personal·파라미터·장기) : 새로 얻은 지식을 모델에 계속 넣음
- V (Working, system·비파라미터·단기) : CoT 같은 중간 출력을 저장해서 추론·결정을 도움
- VI (Procedural, system·비파라미터·장기) : 과거 경험과 자기반성에서 얻은 걸로 추론·문제해결을 다듬음
- VII (Working, system·파라미터·단기) : KV 캐시 같은 임시 파라미터 저장으로 추론 속도 최적화
- VIII (Semantic·Procedural, system·파라미터·장기) : 모델 파라미터에 들어 있는 기반 지식
personal과 system은 이렇게 나눈다.
Personal memory는 사용자와 주고받는 입력·응답처럼 모델이 바깥에서 받은 데이터다. system memory는 추론·계획 과정이나 검색 결과처럼 과제를 하면서 시스템 안에서 생긴 중간 결과다.
뒤에서 볼 서베이에는 이 구분이 없다. 거기는 Forms(어디에 담는가)와 Functions(무엇을 위해)로 나누고, 누구의 것인지는 따로 두지 않는다.
-> 이 구분은 쓸모 있을 것 같다. 사용자 정보와 에이전트 자기 작업 기록은 수명도 삭제 정책도 다르다.
이 시리즈 논문과 논문 Table 2·3 예시를 8분면에 넣어보면 이렇다. 자리는 Table 2, 3을 따르되 I의 MemGPT는 내 배치다.
- I : MemGPT의 FIFO 큐 같은 세션 대화 히스토리
- II : MemGPT, A-MEM, Mem0, HippoRAG. 논문 Table 2도 이 논문들을 II에 넣는다
- V : ReAct의 중간 추론, Reflexion
- VI : Voyager의 스킬 라이브러리
- VII : vLLM, H2O 같은 KV 캐시 관리
- VIII : 모델 가중치, 지식 편집
MemGPT의 working context도 사용자 정보를 담으니 system보다는 personal 쪽(I)이다.
뒤에서 볼 논문 중에서는 NEMORI가 사용자 대화를 다루니 II, Experience-Following과 Janus는 에이전트 자기 작업 기록을 다루니 VI 쪽이다.
비파라미터 쪽 II와 VI에 몰려 있고, 이 시리즈에서 다룬 시스템 중에는 파라미터 쪽(III·IV·VII·VIII)을 직접 구현한 게 없다.
3. Personal Memory
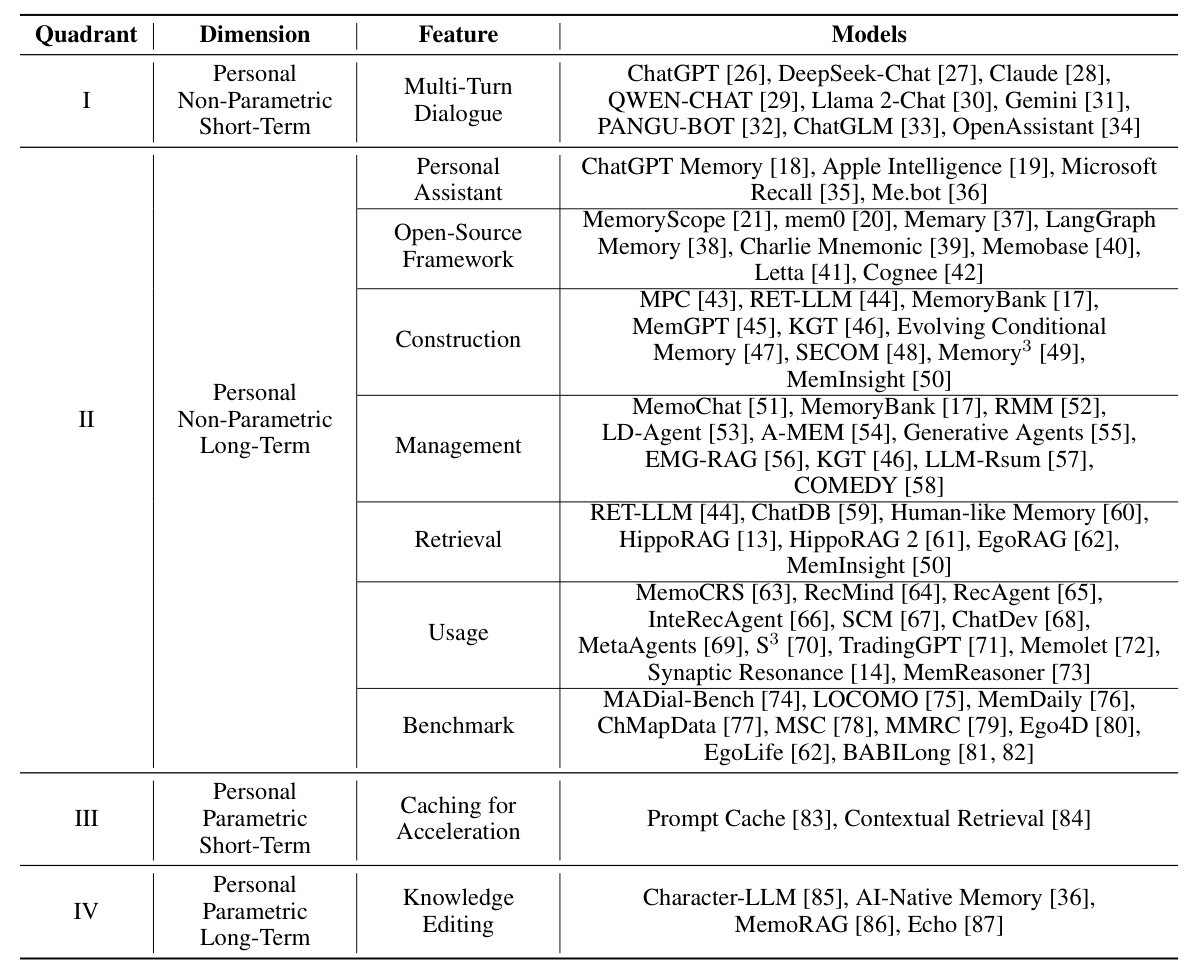
사용자와 주고받은 데이터를 담는 메모리다. 개인화가 목적이다. 논문 Table 2에 분면별 연구를 정리해 뒀다. II 분면은 Construction, Management, Retrieval 같은 단계별로 다시 나뉜다.
3.1 Contextual Personal Memory
비파라미터 쪽이다.
I은 지금 세션의 여러 턴 대화를 그대로 넣는 방식이다. ChatGPT, Claude 같은 채팅 모델이 예시이고, 대화가 너무 길어지면 턴 수를 잘라 길이 제한을 맞춘다고 한다.
II는 이전 세션 대화에서 필요한 걸 검색해 오는 방식이다. 논문은 construction, management, retrieval, usage 네 단계로 나눈다. MemoryBank가 대화 요약을 쌓고 망각 곡선으로 지우는 쪽, A-MEM이 메모를 서로 잇는 쪽이 예시다. LoCoMo, MSC 같은 벤치마크도 여기 들어간다.
3.2 Parametric Personal Memory
사용자 데이터를 파라미터 쪽에 담는다.
III은 사용자 대화 히스토리를 프롬프트 캐시로 들고 있다가 다시 쓰는 방식이다. 개인 메모리용 캐싱 연구는 아직 적다고 한다.
IV는 PEFT 같은 지식 편집으로 사용자 데이터를 모델에 학습시킨다. Character-LLM이 특정 인물을 학습해 역할극을 하는 게 예시다. 사용자마다 파인튜닝해야 해서 계산 비용이 커서 확장하기 어렵다고 한다.
3.3 Discussion
personal memory 연구는 비파라미터 장기 메모리를 만들고 관리하고 검색하는 시스템 쪽에 몰려 있다고 정리한다. 최근에는 파라미터 메모리와 비파라미터 메모리를 같이 쓰는 흐름이 늘고 있다고 한다.
4. System Memory
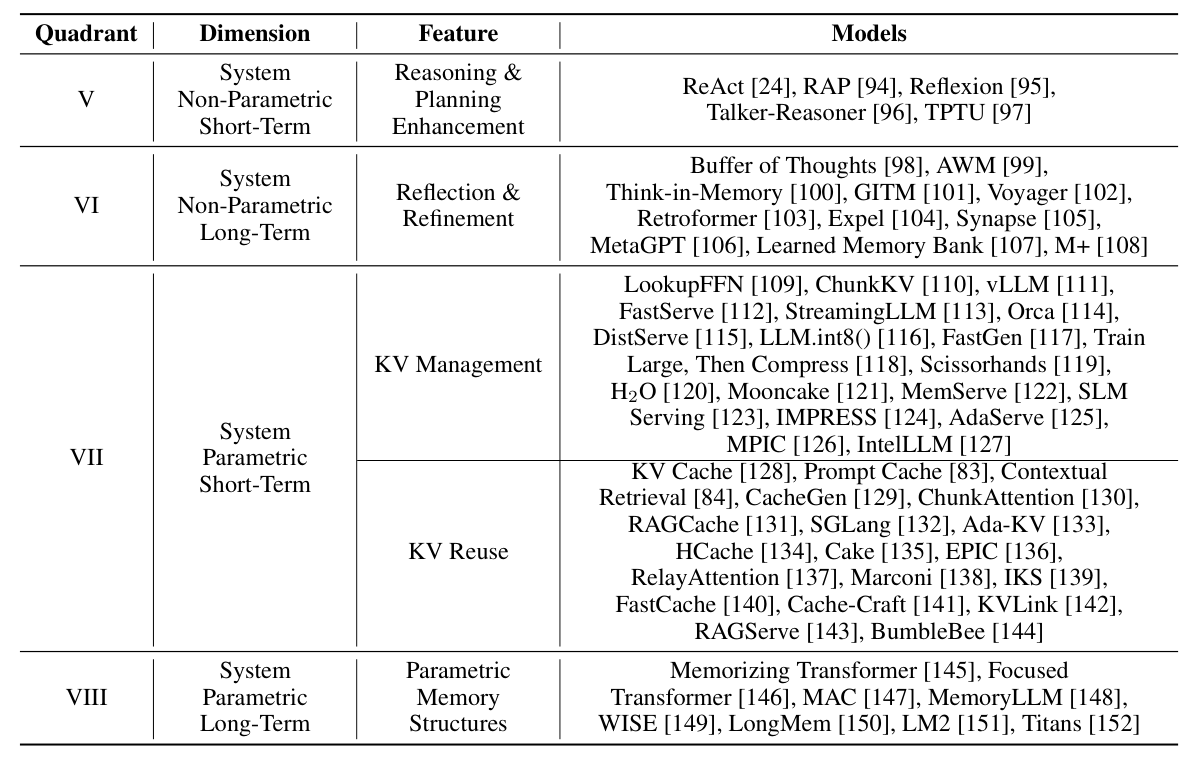
과제를 하면서 생긴 중간 결과를 담는 메모리다. 추론·계획을 돕고 시스템이 스스로 나아지게 하는 게 목적이다. 논문 Table 3에 분면별 연구가 정리돼 있다. VII 분면이 KV Management와 KV Reuse로 나뉘어 제일 길다.
4.1 Contextual System Memory
V는 지금 과제 안에서 나온 추론·행동 기록이다. 논문은 ReAct와 Reflexion을 예로 든다.
VI는 그 기록을 모아 다음 과제에 다시 쓰는 쪽이다. Buffer of Thoughts는 이전 과제의 추론을 템플릿으로 만들고, Voyager는 스킬을 라이브러리로 쌓고, ExpeL은 성공·실패 궤적에서 교훈을 뽑는다. 셋 다 지난 경험을 다음 과제의 참고 자료로 남긴다.
4.2 Parametric System Memory
VII는 KV 캐시 관리와 재사용이다. vLLM(PagedAttention으로 KV 캐시 낭비를 줄인 서빙 시스템), ChunkKV 같은 압축, Prompt Cache 같은 재사용이 들어간다. 추론 비용과 지연을 줄이는 게 목적이다.
VIII는 모델 파라미터 자체를 장기 메모리로 본다. MemoryLLM, WISE처럼 새 지식을 파라미터에 넣거나 편집하는 방법이 예시다.
-> VII는 메모리라기보다 서빙 최적화에 가까워 보이는데, 8분면을 채우려고 넣은 건지 잘 모르겠다??
4.3 Discussion
비파라미터 system memory는 지금 과제의 추론·계획을 돕고 지난 경험을 다시 쓰게 해준다. 파라미터 쪽은 단기면 추론 비용을 줄이고, 장기면 오랜 기간의 정보를 쌓는 지식 체계가 된다고 정리한다.
5. Open Problems and Future Directions
From X to Y 형식으로 여섯 가지를 제시한다.
- Unimodal → Multimodal : 텍스트만 다루던 데서 이미지·음성·영상·센서 데이터까지. 의료 예시로 진료 기록·의료 영상·진료 대화를 합치는 경우를 든다
- Static → Stream : 정해진 때에 묶음으로 처리하는 메모리에서, 들어오는 대로 실시간으로 갱신하는 메모리로
- Specific → Comprehensive : 단기 추론용이나 도메인 지식 저장처럼 좁은 부분만 다루던 데서, 여러 메모리를 함께 다루는 쪽으로
- Exclusive → Shared : 시스템마다 따로 쓰던 메모리를 도메인끼리 공유하는 쪽으로. 의료 모델과 금융 모델이 메모리를 나누는 예시를 든다
- Individual Privacy → Collective Privacy : 데이터 공유가 늘면서 프라이버시 보호 대상이 개인에서 집단으로 넓어진다
- Rule-Based Evolution → Automated Evolution : 사람이 만든 규칙으로 과거 경험을 반영하던 데서, 시스템이 스스로 병목을 찾아 고치는 쪽으로
6. Conclusion
conclusion 부분을 보면, 사람 기억과 LLM 기반 AI 메모리의 관계를 정리하고, 사람의 인지 원리가 더 효율적이고 유연한 메모리 구조를 만드는 데 어떻게 도움이 될 수 있는지 살펴봤다고 한다.
지각 기억, 작업 기억, 장기 기억 같은 사람 기억 범주를 AI 메모리 모델과 비교하고, 그 위에 대상·형태·시간 세 차원으로 8분면 분류를 만들었다.
이 논문은 누구의 기억인지(personal/system)까지 분류 기준에 넣었다. 8분면으로 나눠두니 어느 칸이 비어 있는지도 보인다.
한계는 벤치마크도 프레임워크 비교도 없다는 점이다. 분류만 있고 “그래서 뭘 쓰면 되나”는 없다.
7. 지금 관점: 뒤에 나온 서베이와 비교
8개월 뒤에 나온 서베이(Memory in the Age of AI Agents)와 나란히 놓고 보면 제일 큰 차이는 시간 축이다.
이 논문은 단기/장기를 세 축 중 하나로 세운다. 뒤의 서베이는 이전 서베이들의 long-term/short-term 이분법이 거칠다고 보고, 그 자리에 Functions(factual, experiential, working)를 넣는다.
-> 다만 이 논문은 시간만으로 나누지 않고 대상·형태랑 섞어서 8분면을 만들었다. 그 비판이 이 논문에 그대로 맞지는 않는 것 같다.
personal/system 구분은 뒤의 서베이에 없다. 지금 메모리를 설계할 때도 이 구분은 그대로 쓸 수 있을 것 같다. 사용자에게서 온 정보와 에이전트가 일하면서 만든 기록은 누가 지울 수 있는지, 얼마나 보관할지가 다르다. 이 얘기는 뒤에서 볼 Memory Portability에서 다시 나온다.
분량도 다르다. 이 논문은 26쪽이고 벤치마크·프레임워크 비교가 없다. 뒤의 서베이는 107쪽이고 6장 전체를 벤치마크와 프레임워크 정리에 쓴다.
다음은 Experience-Following이다. 메모리에 무엇을 넣고 무엇을 지우는지가 에이전트 행동을 어떻게 바꾸는지를 네 에이전트로 잰 논문이다.
Leave a comment