
Mem0 Paper review
Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory
https://arxiv.org/abs/2504.19413
Mem0는 Mem0 팀에서 만든 장기 메모리 시스템이다. 2025년 4월 arXiv에 올라온 논문이다.
대화에서 사실을 뽑아서 메모리에 추가, 수정, 삭제하는 방식이고, 제목에 production-ready가 들어간 것처럼 정확도보다 지연이랑 비용을 앞에 내세운다.
원문 대화를 두지 않고 뽑은 사실만 메모리로 두고, 모순이면 기존 사실을 지운다. 이렇게 원본을 버리는 압축이 뭘 잃는지는 나중에 볼 Rate-Distortion 논문에서 다시 나온다.
1. Introduction
LLM은 컨텍스트 창 크기가 정해져 있어서, 세션이 끊기거나 창이 넘치면 정보를 이어갈 방법이 없다.
Figure 1 예시가 이 논문의 동기다. 사용자가 채식이고 유제품을 못 먹는다고 말했는데, 다음 세션에서 시스템이 그걸 잊고 맞지 않는 추천을 한다. 메모리가 있으면 그 조건이 유지된다.
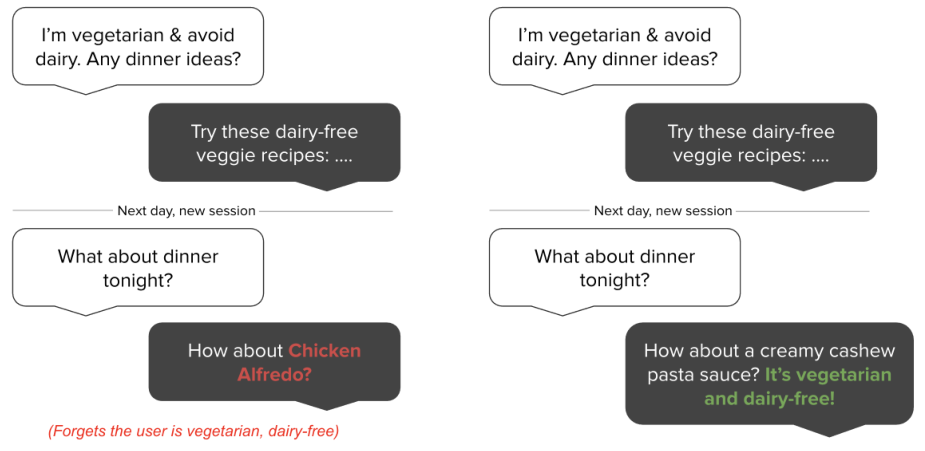
왼쪽이 메모리가 없는 경우로, 다음 세션에서 Chicken Alfredo를 추천한다. 오른쪽이 메모리가 있는 경우다.
2. Proposed Methods
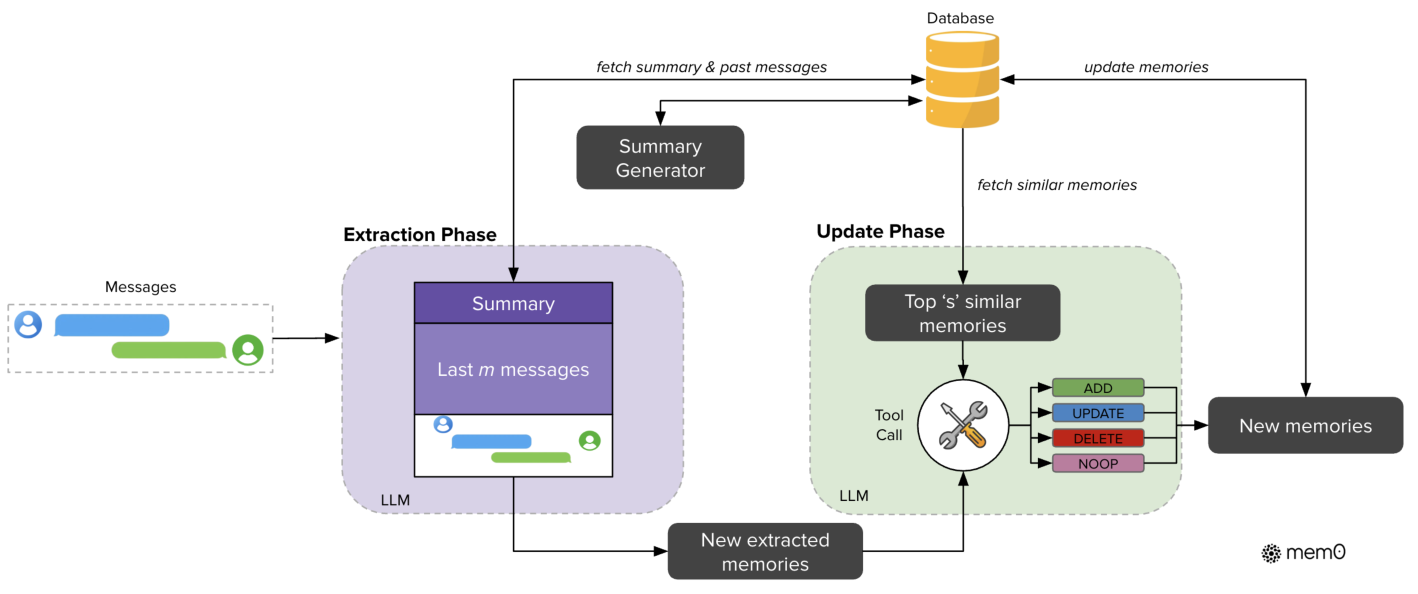
사실을 뽑는 추출 단계와, 그걸 메모리에 반영하는 갱신 단계로 나뉜다.
2.1 Mem0
먼저 추출 단계다.
새 메시지 쌍 (m_{t-1}, m_t)가 들어오면 시작한다. 보통 사용자 발화랑 어시스턴트 응답 한 쌍이다.
맥락은 두 가지를 같이 준다.
- 대화 요약
S: DB에서 가져온 전체 대화 이력 요약 - 최근 메시지
{m_{t-m}, ..., m_{t-2}}:m은 최근 몇 개를 볼지 정하는 하이퍼파라미터(실험에서는 10)
S로 전체 주제를 알고, 최근 메시지로 아직 요약에 안 들어간 세부를 챙긴다고 한다.
요약은 비동기로 따로 돌린다. 메인 파이프라인이랑 별개로 주기적으로 갱신해서, 추출할 때 최신 맥락을 쓰면서도 지연이 안 생기게 했다.
다음은 갱신 단계다.
뽑은 사실마다 기존 메모리랑 비교한다.
벡터 임베딩으로 비슷한 기존 메모리 상위 s개(실험에서는 10)를 꺼내고, 새 사실이랑 같이 LLM에게 tool call로 넘긴다. LLM이 네 가지 중 하나를 고른다.
- ADD : 같은 뜻의 메모리가 없으면 새로 만든다
- UPDATE : 기존 메모리에 정보를 보탠다
- DELETE : 새 정보랑 모순되는 메모리를 지운다
- NOOP : 아무것도 안 한다
따로 분류기를 두지 않고 LLM이 직접 판단하게 했다. 추출과 갱신 모두 GPT-4o-mini를 쓴다.
질문이 들어왔을 때 base Mem0가 메모리를 어떻게 꺼내는지는 본문에 자세히 안 나온다. 질문과 관련된 메모리만 골라 가져온다(selective retrieval)고만 적었다.
2.2 Mem0g
메모리를 방향이 있는 레이블 그래프 G = (V, E, L)로 둔 버전이다.
- 노드
V: 엔티티 (Alice, San_Francisco) - 엣지
E: 관계 (lives_in) - 레이블
L: 노드 타입 (Alice → Person, San_Francisco → City)
엔티티 노드마다 타입, 임베딩 벡터, 생성 타임스탬프가 있고, 관계는 (v_s, r, v_d) 트리플이다.
추출은 두 단계다.
- 엔티티 추출기가 사람, 장소, 사물, 개념, 사건, 속성을 뽑는다
- 관계 생성기가 엔티티 쌍마다 관계가 있는지 보고 트리플을 만든다
갱신할 때는 충돌을 찾아서 해소하는 과정이 돈다.
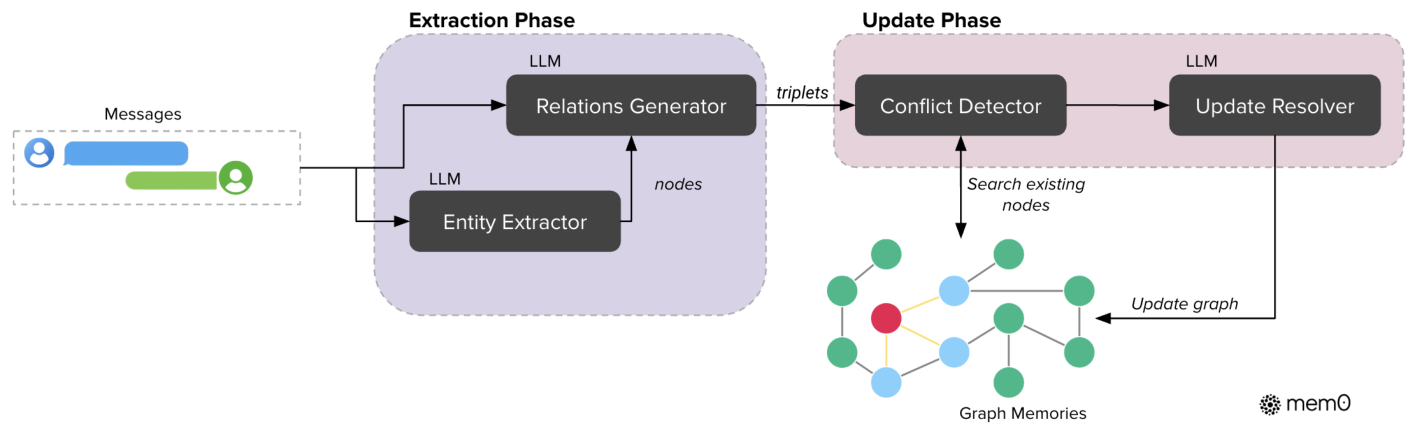
추출 단계에서 Entity Extractor와 Relations Generator가 노드와 트리플을 만들고, 갱신 단계에서 Conflict Detector와 Update Resolver가 기존 그래프에 반영한다. Mem0의 Figure 2와 두 단계 구성은 같고, 저장 단위가 사실 대신 트리플이다.
충돌한 관계는 지우지 않고 무효(invalid) 표시만 한다고 한다. 시간 추론에 쓰려고 그랬다고 한다. base Mem0의 DELETE와 다르고, 앞에서 본 Zep의 무효화와 비슷하다.
검색은 두 가지를 같이 쓴다. 질문에서 엔티티를 찾아 그 노드의 들어오고 나가는 관계를 모으는 방식, 질문 전체를 임베딩해서 트리플 텍스트와 비교하고 임계값을 넘는 것만 가져오는 방식이다.
3. Experimental Setup
LOCOMO 벤치마크에서 여섯 종류의 베이스라인이랑 비교한다. 메모리 증강 시스템, 청크 크기랑 k를 바꾼 RAG, 전체 컨텍스트, 오픈소스 메모리(LangMem), 상용 모델(OpenAI ChatGPT 메모리), 메모리 플랫폼(Zep)이다.
지표는 F1, BLEU-1(B1), LLM-as-a-Judge(J, LLM이 정답과 비교해 맞다/틀리다를 판정한 비율) 세 가지다.
4. Evaluation Results, Analysis and Discussion
4.1 Performance Comparison Across Memory-Enabled Systems
LOCOMO 질문 유형별 결과다(논문 Table 1). 유형마다 F1·B1·J 세 열이 있고, 아래 이야기는 J 열 기준이다. J는 A-Mem* 줄부터 아래에만 있다.
A-Mem*의 별표는 Mem0 팀이 A-Mem을 temperature 0으로 다시 돌려서 J 점수를 낸 결과라는 뜻이다. 앞에서 본 A-MEM 논문은 LLM-as-a-Judge(J) 점수를 보고하지 않아서 J가 없었다.
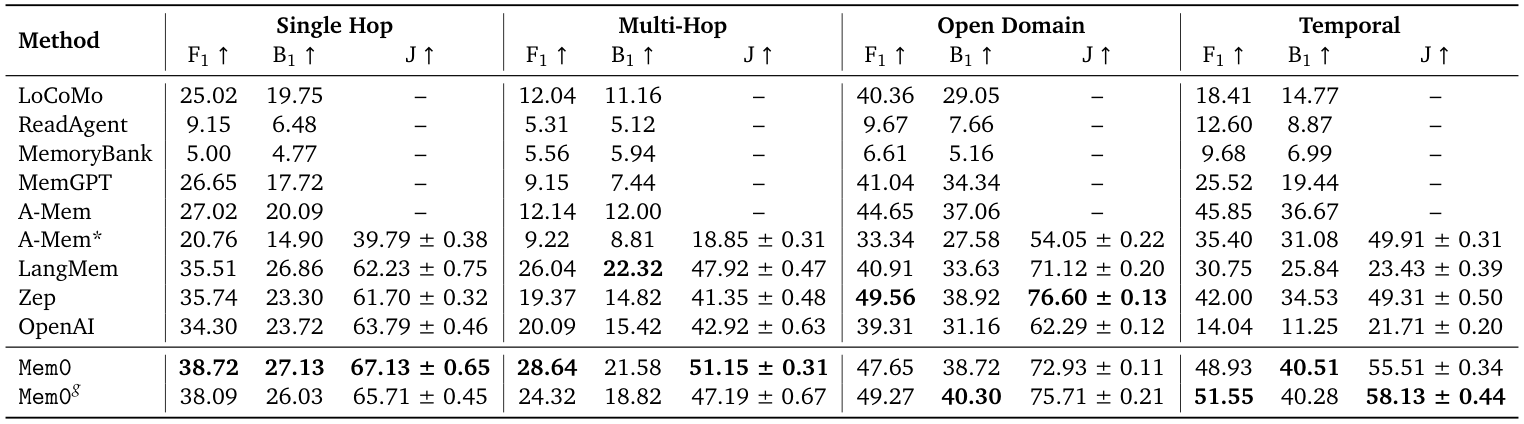
Mem0는 Single Hop(67.13)과 Multi-Hop(51.15)에서 제일 높다. 여러 세션에 흩어진 사실을 엮는 Multi-Hop에서도 Mem0가 앞선다.
그래프 버전이 항상 좋은 건 아니다. Mem0g는 temporal(58.13)에서 제일 높고 open-domain(75.71)에서 Mem0보다 높은데, multi-hop에서는 Mem0보다 낮다(47.19 vs 51.15). 논문은 그래프 표현의 비효율이나 중복 때문일 수 있다고 한다.
temporal에서 OpenAI가 크게 낮다. 프롬프트로 시키는데도 만들어진 메모리 대부분에 타임스탬프가 빠져 있었다고 한다.
-> 시간 정보를 저장할 때 안 넣으면 나중에 시간 질문은 못 푸는 것 같다.
open-domain은 Zep이 76.60으로 Mem0g(75.71)보다 조금 높다. 논문도 Zep이 작지만 의미 있는 차이로 앞선다고 인정한다.
A-MEM 논문에서는 A-MEM이 full-context 기준선(LoCoMo 논문 방식)보다 높았는데, 여기 재현에서는 A-Mem*가 Single Hop·Multi-Hop과 아래 Table 2의 전체 J(48.38)에서 J가 있는 방법 중 제일 낮다. 같은 벤치마크라도 누가 어떻게 돌렸느냐에 따라 순위가 바뀐다.
4.2 Cross-Category Analysis
질문 유형별 결과를 다시 정리한다. 자연어 사실로 저장하는 Mem0는 single-hop·multi-hop에 강하고, 그래프를 붙인 Mem0g는 관계나 시간 순서가 얽힌 질문에서 낫다고 한다.
4.3 Performance Comparison of Mem0 and Mem0g Against RAG Approaches and Full-Context Model
청크 크기(128~8192 토큰)와 k(1, 2)를 바꾼 RAG 설정 중 가장 좋은 것도 전체 J가 61% 정도인데, Mem0는 약 67%, Mem0g는 68%를 넘는다. 원문 청크를 가져오기보다 중요한 사실만 뽑아두는 게 낫다고 본다.
4.4 Latency Analysis
지연과 비용이다. LOCOMO 전체에서 잰 값이다(논문 Table 2). 위쪽 RAG 열네 줄은 4.3절의 청크 크기·k 실험이고, 여기서는 Full-context 줄부터 아래를 보면 된다. memory tokens 열은 검색해서 가져온 메모리의 토큰 수다. Search는 메모리를 꺼내는 시간, Total은 답변 생성까지의 시간(초)이다. p50은 중앙값, p95는 느린 쪽 5% 경계다.
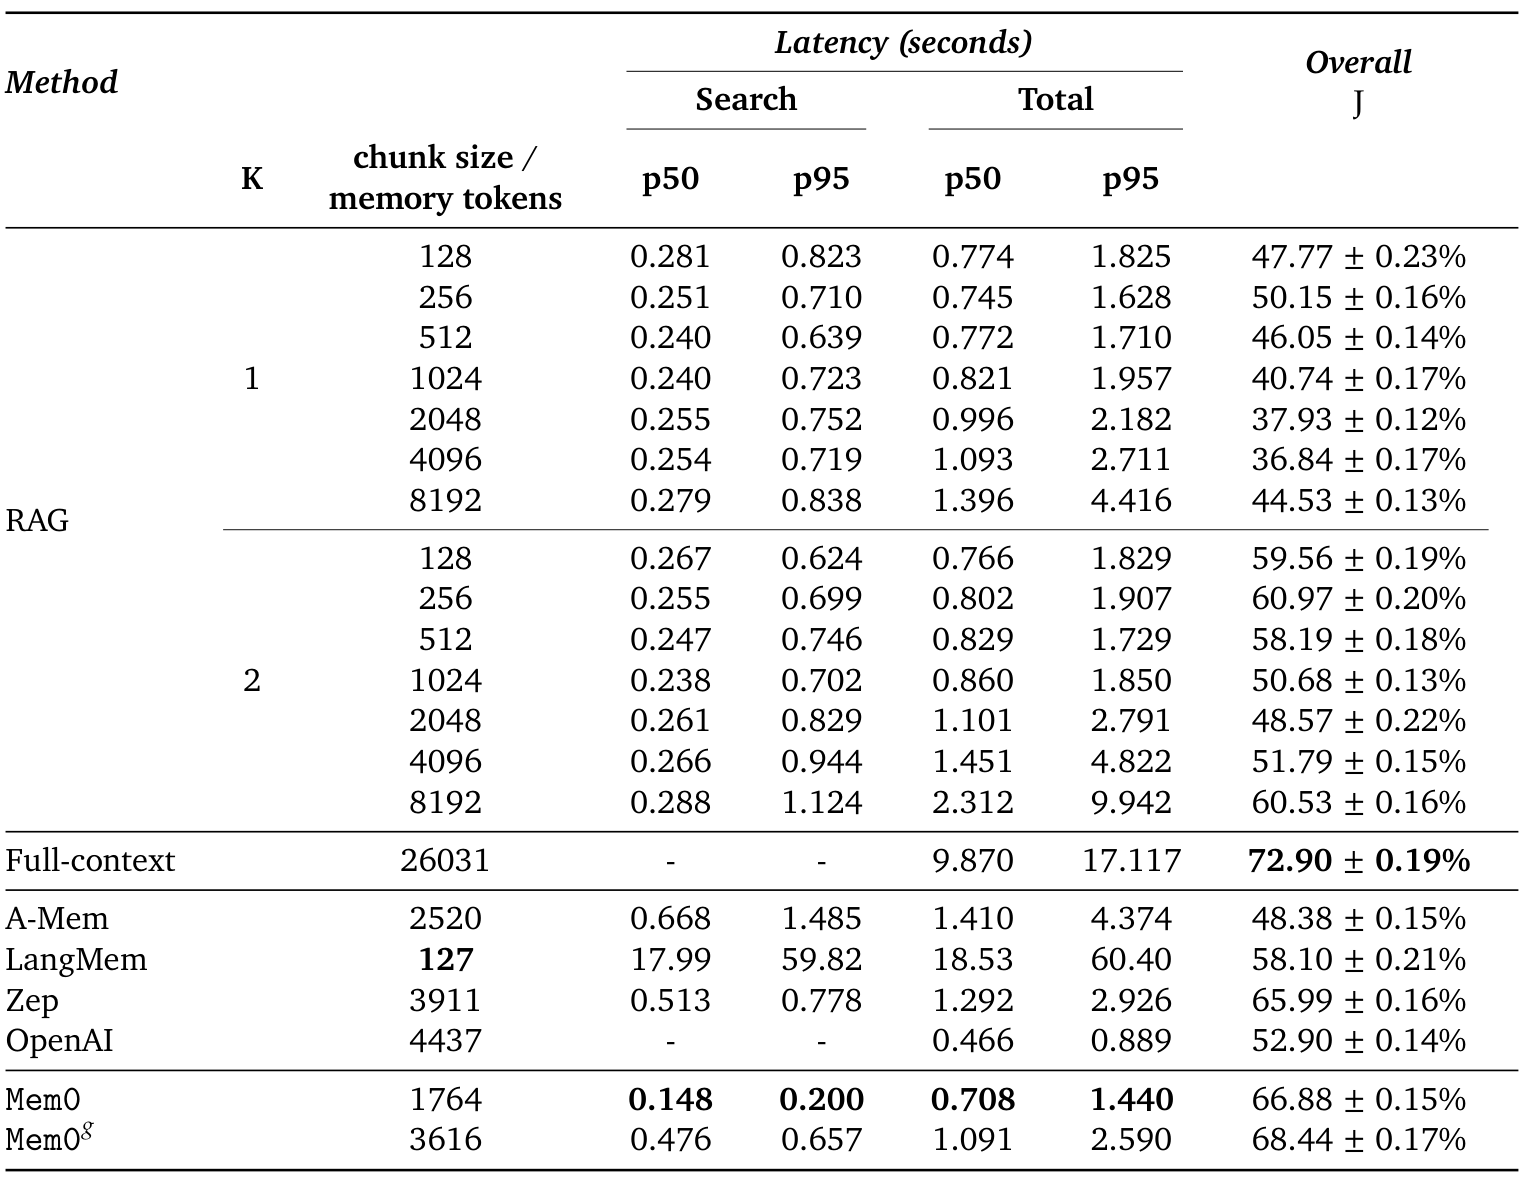
이 논문이 제일 내세우는 부분이다.
J 점수는 Full-context가 72.90으로 제일 높다. 대화를 전부 넣으면 제일 잘 맞힌다. 대신 p95가 17.1초고 토큰이 26,031개다.
Mem0는 J를 72.90 → 66.88로 6점 정도 내주고, p95를 17.1초 → 1.44초로 줄인다. 토큰은 26,031 → 1,764다. abstract에 나오는 “p95 지연 91% 감소, 토큰 90% 이상 절감”이 여기서 나온 숫자다.
LangMem은 메모리 토큰을 127개까지 줄였는데 p95가 59.82초다. 토큰이 적다고 빠른 건 아니다.
4.5 Memory System Overhead: Token Analysis and Construction Time
메모리 저장소 크기는 대화당 평균 Mem0 7k 토큰, Mem0g 14k 토큰이고, Zep 그래프는 600k 토큰을 넘는다고 한다. 노드마다 요약을 두고 엣지에도 사실을 저장해서 중복이 많다는 설명이다.
Zep은 메모리를 넣고 바로 검색하면 답을 잘 못 했고, 몇 시간 뒤 다시 검색하면 나아졌다고 한다. Mem0 그래프 구성은 최악의 경우에도 1분 안에 끝난다고 한다.
5. Conclusion and Future Work
고정된 컨텍스트 창 문제를 두 가지 구조로 푼다.
Mem0는 단순한 질문에서 빠르게 검색하고 토큰이랑 연산을 아낀다. Mem0g는 그래프로 관계를 정리해서 복잡한 사건 순서나 맥락을 엮는 데 쓴다.
LOCOMO 기준으로 단일홉 5%, 시간 11%, 다중홉 7% 상대 개선이고, full-context보다 p95 지연이 91% 줄었다고 한다.
정확도를 조금 내주고 지연을 크게 줄이는 쪽을 택한 논문이다. 그게 맞는지는 서비스마다 다를 것 같다. 한 턴 응답에 쓸 수 있는 시간이 1~2초 정도로 빠듯하면 맞고, 몇 초 더 걸려도 정확도가 먼저면 대화를 통째로 넣는 쪽이 낫다.
6. 지금 관점: Mem0 방식을 쓸 때 따져볼 것
Mem0 논문만 놓고 보면 주고받는 게 분명하다. 대화 전체를 넣는 것보다 J를 6점 정도 내주고, 응답 p95를 17초에서 1.4초대로 줄인다.
검색만 보면 p95 0.2초로 표에서 제일 빠르다. 매 턴 메모리를 봐야 하는 챗봇에서는 이 차이가 크다.
대신 뽑은 사실만 남기고 원문은 두지 않는다. 사용자 프로필이나 선호처럼 사실로 줄여도 괜찮은 건 잘 맞는다. 원문 세부가 나중에 필요한 질문은 추출에서 빠지면 복구가 안 된다.
-> DELETE가 특히 걸린다. 모순이라고 판단해서 지웠는데 그 판단이 틀렸으면 되돌릴 방법이 있나?? 같은 논문의 Mem0g는 관계를 지우지 않고 무효 표시만 하는데, base Mem0는 왜 지우는 쪽으로 했는지 설명이 없다.
평가가 LOCOMO 하나뿐이라는 것도 걸린다. 다른 벤치마크에서 Mem0가 어떻게 나오는지는 나중에 볼 ReFind의 비교표에서 다시 본다.
둘을 섞어서 쓰면 어떨까 싶다. Mem0로 뽑은 사실은 빠르게 쓰고, 원문은 따로 보관해뒀다가 사실로 답이 안 나오면 원문을 검색하는 식이다.
다음은 From Human Memory to AI Memory다. 사람의 기억 분류에서 출발해서, AI 메모리를 대상·형태·시간 세 축으로 8분면에 나누는 서베이다.
Leave a comment