
Experience-Following Paper review
How Memory Management Impacts LLM Agents: An Empirical Study of Experience-Following Behavior
https://arxiv.org/abs/2505.16067
Experience-Following은 Harvard, University of Georgia, Michigan State, University of Minnesota에서 같이 쓴 논문이다. 2025년 5월 arXiv에 올라왔다.
에이전트 메모리에 무엇을 넣고 무엇을 지우느냐에 따라 에이전트 행동이 어떻게 바뀌는지를 실험으로 잰다.
앞의 일곱 편은 주로 메모리를 어떻게 저장하고 꺼낼지를 다뤘는데, 여기서는 무엇을 넣고 무엇을 지울지를 본다. 뒤에서 볼 서베이(Memory in the Age of AI Agents)의 분류로는 경험 메모리를 만들고 지우는 쪽에 들어간다.
결론부터 말하면 실행 결과를 전부 넣으면 고정 메모리보다 못하다.
1. Introduction
memory addition(추가)이랑 memory deletion(삭제) 두 가지 연산만 본다. 많은 에이전트 프레임워크가 쓰는 제일 기본적인 조작이다.
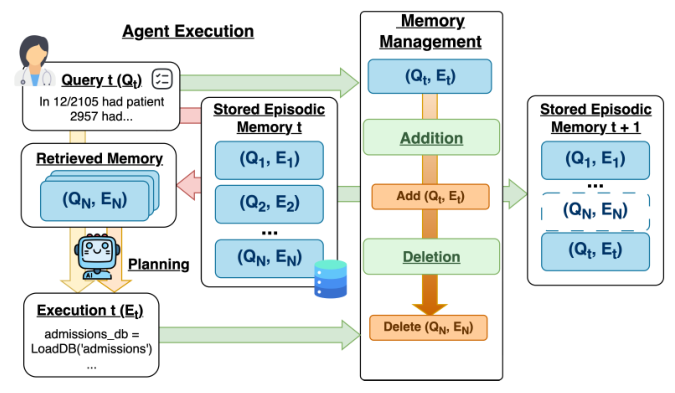
실행이 끝날 때마다 (질의, 실행) 쌍을 메모리에 넣을지, 기존 레코드를 지울지 정하는 흐름이다.
다음 질의는 이렇게 바뀐 메모리에서 비슷한 레코드를 꺼내 데모로 쓴다.
논문이 찾은 현상이 하나 있고, 거기서 문제가 두 개 나온다.
현상은 Experience-following property다. 태스크 입력이 검색된 메모리 레코드의 입력이랑 비슷하면, 에이전트 출력도 그 레코드랑 매우 비슷해진다.
여기서 나오는 문제 두 가지.
- Error propagation (오류 전파) : 과거 경험에 있던 오류가 쌓여서 미래 성능을 떨어뜨림
- Misaligned experience replay (어긋난 경험 재생) : 제대로 된 실행처럼 보여도 경험으로 다시 쓰면 도움이 안 되거나 잘못 이끎
2. Background and Related Works
에이전트 메모리를 단기·장기로 나누고, 장기 메모리 중 과거 태스크 경험을 담는 episodic memory만 다룬다고 밝힌다.
메모리 연산은 질의와 비슷한 (질의, 실행) 쌍 K개를 꺼내 데모로 쓰는 읽기, 그리고 추가·삭제로 정리한다. 기존 연구는 특정 에이전트용 설계가 많고 추가·삭제가 장기 성능에 주는 영향은 보지 않았다고 한다.
3. Addition of Memory
3.1 Setup
에이전트 네 개를 쓴다. 하나는 통제용으로 만든 합성 에이전트고, 셋은 실제 에이전트다.
- RegAgent (합성) : 데모를 보고 선형 함수의 출력을 회귀로 근사
- EHRAgent : 전자의무기록 질의
- AgentDriver : 자율주행
- CIC-IoT Agent : IoT 네트워크
RegAgent는 입력 벡터 x랑 근처 입력에 대한 과거 추측들을 받아서 wᵀx를 맞힌다.
모델이 주어진 데모에만 기대는 상황을 일부러 만든 것이다. 이러면 저장된 메모리에 노이즈를 얼마나 넣을지 조절할 수 있고, 결과 오차도 바로 잴 수 있다.
백본은 대부분 GPT-4o-mini.
추가 전략은 네 가지를 비교한다.
- Fixed : 메모리를 늘리지 않는 베이스라인
- Add all : 전부 넣음
- Coarse : 자동 평가기(C1/C2/C3)로 골라서 넣음
- Strict : 사람 평가를 흉내 내 정답과 맞는 실행만 넣음
자동 평가기 C1~C3는 에이전트마다 다르다. RegAgent에서는 예측 오차 허용치를 1.6, 1.4, 1.2로 점점 좁힌 것이고, 나머지 셋에서는 C1이 GPT-4o-mini, C2가 GPT-4.1-mini, C3가 판정 데이터 300개로 파인튜닝한 GPT-4.1-mini 판정기다.
Strict는 사람이 매번 보는 대신 출력을 정답과 비교해서 흉내 낸다.
3.2 Execution quality and memory size jointly determine long-term agent performance
전부 넣으면 나빠진다.
아래는 논문 Table 1이다. 네 에이전트에서 추가 전략별 성능과 최종 메모리 크기(레코드 수)를 쟀다. SR은 성공률(RegAgent는 오차 1 이내면 성공), ACC는 정확도다.
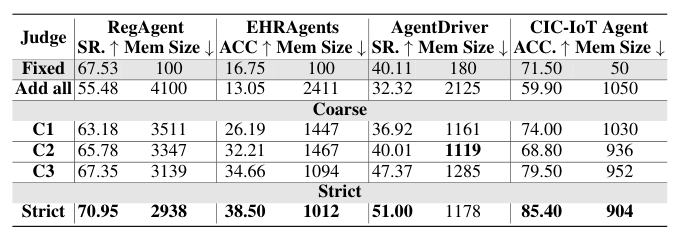
표를 보면,
- Add all이 네 에이전트 전부에서 꼴찌다. RegAgent는 메모리를 41배(100 → 4,100) 늘렸는데 성능이 67.53 → 55.48로 떨어졌다.
- Fixed가 coarse 평가기 일부보다 낫다. RegAgent, AgentDriver에서는 C1·C2보다 낫거나 비슷하고, CIC-IoT에서는 C2(68.80)보다는 낫지만 C1(74.00)보다는 낮다.
- Strict가 네 에이전트 전부에서 제일 좋다. 품질 좋은 레코드만 골라서 늘리면 좋아진다.
노이즈가 있거나 품질이 낮은 걸 추가하면 오히려 메모리가 손해가 된다고 한다. 그래서 장기 성능은 실행 품질이랑 메모리 크기가 같이 정한다.
C3처럼 판정기를 300개만으로 파인튜닝해도 다른 coarse 평가기나 Add all보다 낫다.
3.3 Experience-Following Property
질의마다 검색된 메모리 레코드와의 입력 유사도, 출력 유사도를 둘 다 재고, 질의 스트림 전체에 대해 누적 평균을 낸다.
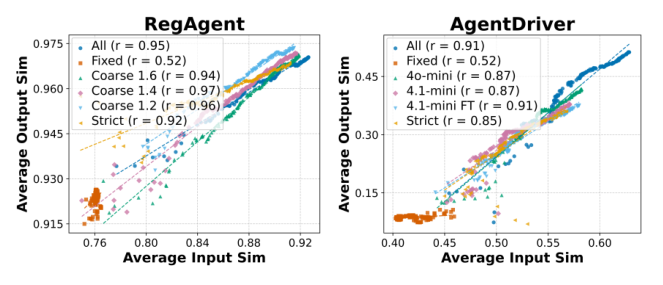
왼쪽이 RegAgent, 오른쪽이 AgentDriver다. 점 하나가 누적 평균 한 지점이다.
Fixed만 왼쪽 아래에 몰려 있고, 나머지는 오른쪽 위로 뻗는다. 고정 메모리는 입력 유사도도 출력 유사도도 낮고, 추가하는 방법들은 입력 유사도가 커질수록 출력 유사도도 높아진다.
이 상관관계를 experience-following이라고 부른다. GPT-4o나 DeepSeek-V3로 백본을 바꿔도 같은 패턴이 나온다.
지금 질의가 과거 예시랑 비슷할수록 에이전트는 검색된 경험을 더 그대로 따라 한다. 메모리가 커져서 경험이 다양해질수록, 새 질의랑 아주 비슷한 레코드가 검색될 확률도 커진다.
RegAgent에서는 메모리가 커지면 입력·출력 유사도 상관이 거의 1(Pearson r ≈ 1)까지 간다. 반대로 고정 메모리에서는 데모를 베끼기보다 규칙을 추론하기 때문에, 노이즈 섞인 coarse 평가기보다 성능이 오히려 높게 나온다고 한다.
좋은 경험을 넣으면 그대로 따라 하고, 나쁜 경험을 넣어도 그대로 따라 한다.
3.4 Error Propagation in Agent Memory
잘못됐거나 노이즈가 섞인 레코드가 데모로 검색되면 지금 실행에 영향을 준다. 그 실행이 다시 메모리에 저장되면 오류가 다음 태스크로 넘어간다.
이걸 보려고, 추가 전략마다 검색 예시는 똑같이 쓰고 LLM 실행만 정답 출력으로 바꾼 “오류 없는 버전”이랑 비교한다.
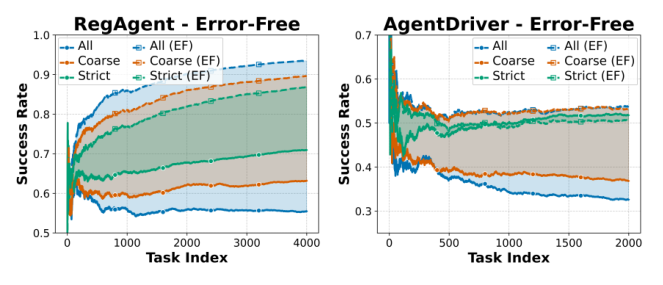
실선이 에이전트 출력을 그대로 메모리에 쓴 경우, 점선(EF)이 정답 출력으로 바꾼 경우다. 여기서 Coarse는 C1 평가기다.
같은 색 실선과 점선 사이 간격이 오류 때문에 잃은 만큼이다.
두 에이전트(RegAgent, AgentDriver) 모두 처음부터 오류 없는 버전보다 성능이 벌어지고, 실행이 계속될수록 add-all이랑 coarse selective addition은 그 차이가 더 커진다.
예외는 AgentDriver의 strict selective addition 하나다. 처음엔 뒤처지다가 점점 따라잡고, 약 2,000번 실행 뒤에는 오히려 오류 없는 버전을 앞선다.
-> 메모리를 다시 쓰는 루프에서는 손실이 계속 쌓이는 것 같다. 뒤에서 볼 Rate-Distortion 리뷰에서 비슷한 이야기가 다시 나온다.
4. Deletion of Memory
4.1 Setup for Memory Deletion Experiments
삭제 전략은 세 가지다.
- Periodical : 일정 기간 동안 검색 횟수가 기준 이하인 레코드를 지움
- History-based : n번 이상 검색됐는데 그때 실행 결과 평균 효용이 기준보다 낮으면 지움
- Combined : 둘 중 하나라도 걸리면 지움
Periodical의 기간과 기준은 RegAgent 기준 500스텝, 검색 0회다. 한동안 한 번도 안 불린 레코드를 지우는 셈이라 오래된 순서로 지우는 FIFO와는 다르다.
History-based의 효용은 추가할 때 쓴 평가기를 그대로 쓸 수 있다.
4.2 Strategic Memory Deletion Improves the Agent Performance
아래는 논문 Table 2다. 삭제 전략별 성능과 최종 메모리 크기인데, 위쪽은 C1 평가기로 추가한 경우, 아래쪽은 strict 평가기로 추가한 경우다. 아래 설명은 아래쪽 Strict evaluator 부분을 기준으로 한다.
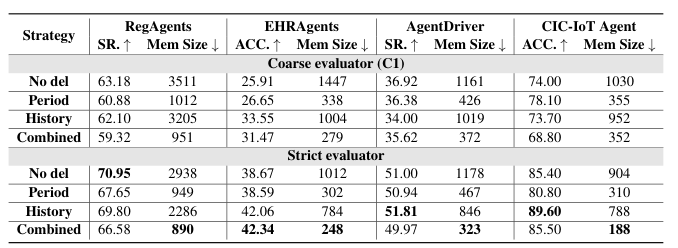
-> No del은 Table 1의 Strict와 같은 설정일 텐데 EHRAgent만 Table 1은 38.50, 여기는 38.67이다. C1 쪽도 26.19와 25.91로 다르다. 논문에 이유는 안 나와 있다??
- 주기적 삭제는 메모리를 많이 줄이는데 성능은 조금만 떨어진다. 메모리는 60~70% 줄고(RegAgent 2,938 → 949), 성능은 최대 4.6점(CIC-IoT 85.40 → 80.80) 떨어진다. 추가만 하는 메모리는 중복 항목이 많이 쌓인다고 한다.
- History-based 삭제는 합성이 아닌 에이전트에서 성능이 오른다. EHRAgent 38.67 → 42.06, CIC-IoT 85.40 → 89.60. 지웠는데 좋아졌다. 합성 에이전트인 RegAgent는 70.95 → 69.80으로 조금 떨어진다.
- Combined가 메모리를 제일 많이 줄인다. EHRAgent에서 1,012 → 248(75% 감소)인데 성능은 42.34로 제일 높다.
C1 평가기로 추가한 경우에는 History-based가 AgentDriver(36.92 → 34.00)처럼 오히려 떨어지기도 한다. 평가기를 얼마나 믿을 수 있느냐에 따라 결과가 갈린다.
평가기별로 추가만 했을 때와 History-based 삭제를 했을 때를 나란히 놓으면 이렇다.
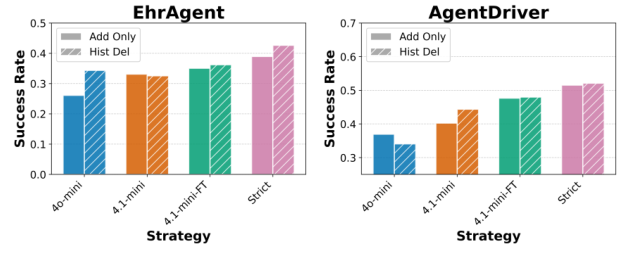
빗금 없는 막대가 추가만 한 경우(Add Only), 빗금 막대가 History-based 삭제(Hist Del)다.
4o-mini(C1) 평가기는 EHRAgent에서는 삭제 뒤 올라가고 AgentDriver에서는 내려간다. 파인튜닝한 4.1-mini-FT는 두 에이전트 모두 삭제 전후가 비슷하다.
4.3 Misaligned Experience Replay
왜 지우면 좋아지는지를 본다.
어떤 레코드는 도움이 별로 안 되거나 해로운 안내를 준다는 가설이다. 처음에 평가기 필터를 통과했더라도, 지금 태스크 분포랑 맞지 않을 수 있다.
어긋나는 원인은 두 가지를 든다.
- 저장된 궤적이랑 지금 실행 맥락이 안 맞음
- 평가기가 완벽하지 않아서 들어온 오류
RegAgent에서는 이걸 직접 볼 수 있다. 예측값이랑 정답값 차이로 레코드 품질을 잴 수 있기 때문이다. 삭제된 레코드랑 남은 레코드의 KDE 곡선을 그리면 품질 차이가 뚜렷하게 난다.
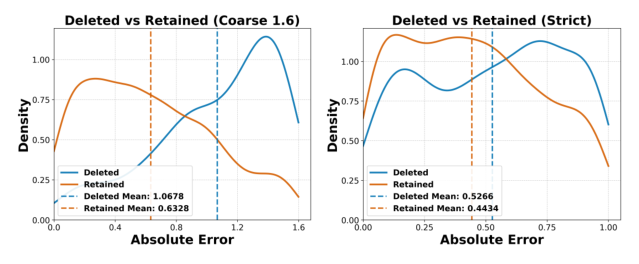
왼쪽은 C1 평가기, 오른쪽은 strict 평가기로 history-based 삭제를 했을 때다. 5번 넘게 검색된 레코드만 그렸다.
두 경우 모두 남은 레코드가 삭제된 레코드보다 오차가 낮은 쪽에 몰려 있다.
그래서 논문은 미래 태스크의 평가 결과가 저장된 메모리의 품질 라벨이 될 수 있다고 한다. 추가 비용 없이.
-> 넣을 때는 좋은 레코드인지 모르지만, 나중에 그 레코드가 검색됐을 때 결과가 어땠는지 기록해두면 라벨이 저절로 쌓인다는 얘기로 읽었다.
5. Memory Management under Challenging Scenarios
어려운 상황 두 가지를 본다.
5.1 Memory Management with Task distribution shift
EHRAgent랑 AgentDriver의 테스트셋 순서를 바꿔서 중간에 분포가 바뀌게 만든다.
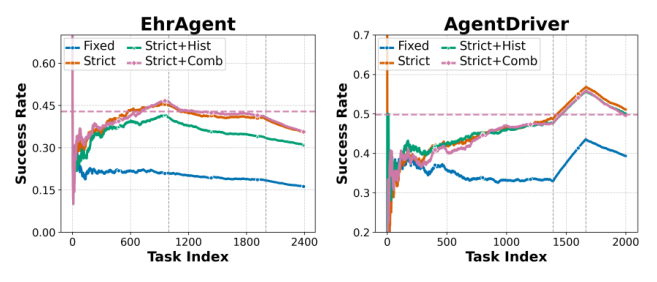
세로 점선이 태스크 분포가 바뀌는 지점이고, 가로 점선은 분포 변화 없이 combined 삭제를 돌렸을 때 성능이다.
결과는 에이전트마다 갈리지만, 분포 변화가 없는 버전과의 차이는 대체로 작다.
AgentDriver에서는 엄격한 평가로 추가만 한 버전(strict addition)이 분포 변화가 없는 버전보다도 좋았고, EHRAgent에서는 history-based가 combined보다 못했다.
그래서 분포가 바뀌는 실제 상황에서는 단순한 주기적 삭제가 성능을 안정시키는 데 도움이 될 수 있다고 한다.
-> 분포가 바뀌면 “예전에 결과가 좋았던 레코드”라는 기준이 흔들리니까 그런 것 같다.
5.2 Memory Management with Resource Constraints
메모리 용량을 초기 크기(EHRAgent 100, AgentDriver 180)로 고정한다. 주기적 삭제를 먼저 하고, 그래도 넘치면 평균 효용이 제일 낮은 레코드 하나만 지우도록 combined 정책을 바꾼다.
이렇게 하면 고정 메모리 버전보다 성능이 높다. 저장 공간이 작아도 관련 있고 품질 좋은 레코드만 남기면 된다.
6. Conclusion
conclusion 부분을 보면, 추가와 삭제로 에이전트 메모리 관리를 연구했고, experience-following 현상과 거기서 나오는 두 문제(오류 전파, 어긋난 경험 재생)를 보였다고 한다.
그리고 평가기를 얼마나 믿을 수 있느냐가 결정적이고, 메모리 관리에 평가기 신호를 같이 써야 한다고 한다.
논문이 밝힌 한계는 두 가지다.
- 추가와 삭제 두 연산만 봄. 구조 변환, 병합, 요약, 반성 같은 더 복잡한 갱신 방식에도 결론이 맞는지는 추가 분석이 필요
- 실험으로만 보였고 이론적인 증명은 없음
앞에서 본 Mem0(UPDATE/DELETE), Zep(무효화), A-MEM(진화)은 전부 “더 복잡한 방식” 쪽이다.
-> 이 결론이 그쪽에도 그대로 맞는지는 모르겠다. 그래도 experience-following은 백본을 바꿔도 나오니까, 무엇을 남기느냐에 따라 행동이 바뀐다는 건 그쪽에서도 마찬가지일 것 같다.
정리하면 메모리를 키우는 것보다 무엇을 넣고 무엇을 지우는지가 성능을 더 크게 바꾼다는 실험 논문이다.
7. 지금 관점: 경험 메모리를 붙일 때 확인할 것
경험 메모리를 붙일 때 제일 먼저 하는 구현이 “일단 다 넣자”인데, Add all이 Fixed보다 못하다는 게 네 에이전트에서 다 나왔다.
평가기 차이도 크다. RegAgent에서 Coarse(C1) 63.18, Strict 70.95로 7점 넘게 차이 난다.
-> 무엇을 넣을지 거르는 평가기를 대충 만들면 메모리를 붙인 의미가 없을 것 같다.
4.3의 공짜 품질 라벨은 바로 해볼 만하다. 레코드마다 검색된 횟수랑 그때 결과를 기록해두면 LLM 호출 없이 나쁜 레코드를 골라낼 수 있다.
다만 4.2에서 C1 평가기로는 History-based가 오히려 떨어진 경우가 있었다. 결과를 판정하는 쪽이 믿을 만해야 한다.
지우는 쪽은 상황마다 답이 달랐다. 분포가 안정적이면 History-based가 네 에이전트 중 둘(AgentDriver, CIC-IoT)에서 제일 좋았고, 분포가 바뀌면 Periodical이 섞인 Combined가 안정적이었다.
주기적 삭제는 오래된 것부터 지우는 FIFO가 아니고, 한동안 안 불린 레코드를 지운다. 이걸로 메모리가 크게 줄었는데 성능은 조금만 떨어졌다.
-> 안 쓰이는 중복이 그만큼 많이 쌓인다는 얘기 같다.
이 논문은 같은 에이전트에서 정책만 바꿔가며 잰다. 서로 다른 메모리 시스템끼리 비교할 때 생기는 문제는 뒤에서 볼 Anatomy 리뷰에서 다룬다.
다음은 What Deserves Memory(NEMORI)다. 무엇을 남길지를 중요도 점수가 아니라 “예측 실패”로 정하는 논문이다.
Leave a comment