
Memory Portability Paper review
Does Your Agent’s Memory Survive a Model Upgrade? A Controlled Study of Memory Portability
https://arxiv.org/abs/2609.05339
Memory Portability는 LinkedIn에서 쓴, 모델을 바꿨을 때 에이전트 메모리가 살아남는지를 실험한 논문이다. 2026년 9월 arXiv에 올라왔다.
논문 첫 문장이 “모델 업그레이드는 일상적이다. 메모리 마이그레이션은 그렇지 않다.”이다.
앞에서 본 A-MEM 리뷰에서 구조를 에이전트에게 맡기면 구조가 모델에 묶인다고 적었고, Anatomy 리뷰에서는 작은 오픈 모델(Qwen-2.5-3B)에서 Nemori의 메모리 연산 형식 오류가 30%였다. 여기서는 모델이 바뀔 때 메모리가 어떻게 되는지를 통제 실험으로 잰다.
1. Introduction
에이전트는 같은 메모리 저장소를 그대로 두고도 잊을 수 있다고 한다.
이유는 세 가지다.
- 새 모델이 옛 노트를 다르게 해석할 수 있다
- 임베딩 버전이 섞이면 검색이 깨질 수 있다
- 원본 증거가 없으면 복구가 안 될 수 있다
2. What does it mean for memory to survive an upgrade?
2.1 Separate the components that change
에이전트 메모리를 경험을 만드는 모델(actor), 메모리를 쓰는 모델(writer), 읽는 모델(reader), 검색용 임베딩 모델(embedder) 네 역할로 나눈다. 업그레이드는 이 중 하나를 바꾸는 것이다.
임베딩 모델을 바꾸면 차원이 같아도 벡터 공간이 달라서 전부 다시 임베딩해야 한다고 한다.
2.2 Memory formats and their trade-offs
같은 이력을 네 가지 방식으로 저장해서 비교한다.
- LC-RAW : 원문 그대로 두고 긴 컨텍스트로 읽음, 쓰기 단계 없음
- RAG : 청크로 나눠서 검색, 쓰는 모델은 없는데 임베딩에 의존
- NOTES : 모델이 자연어 노트로 압축, 쓰기 모델에 의존
- KG-fixed : 고정 스키마 지식그래프로 정리, 쓰기 모델에 의존
LC-RAW와 RAG는 쓰는 모델이 없어서 대조군으로 쓴다.
Figure 1은 형식마다 무엇을 저장하고, 추론 때 어떻게 쓰고, 업그레이드할 때 어디가 위험한지 정리한 그림이다.
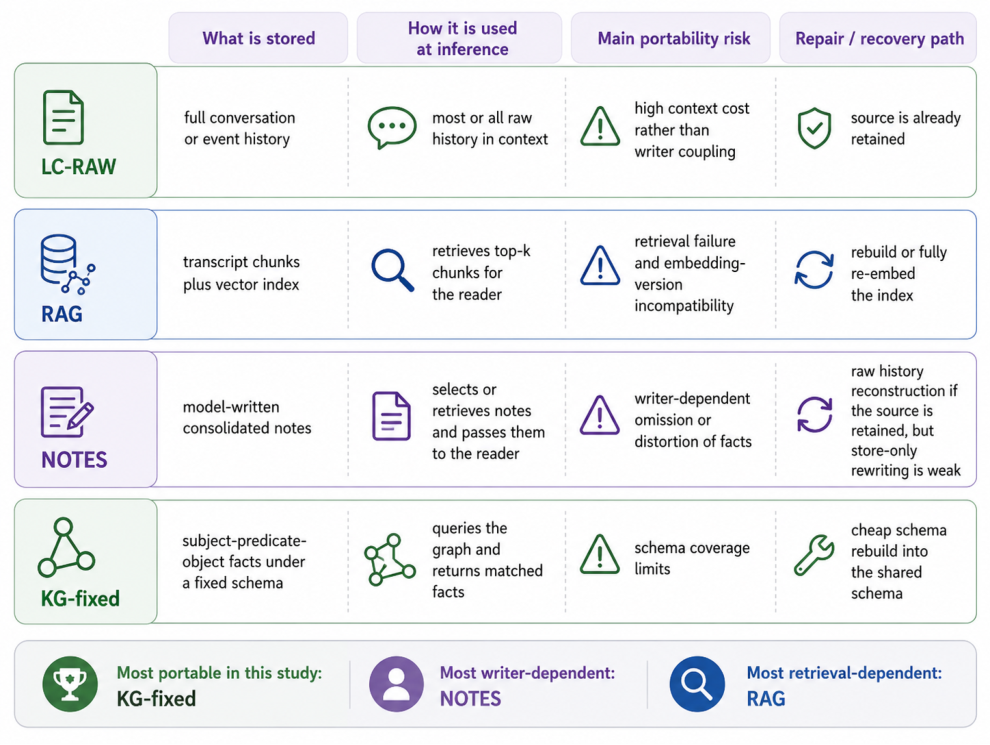
RAG는 검색 실패와 임베딩 버전 불일치, NOTES는 쓰는 모델에 따른 누락·왜곡이 주된 위험이다.
2.3 Measure the migration
지표는 두 개다. RPAS는 다른 모델이 만든 메모리를 물려받았을 때, 리더가 자기가 만든 메모리로 낸 성능 대비 얼마나 남는지다. CTR은 그 성능의 90/95/99%까지 복구하는 데 드는 가장 싼 비용이다.
3. Testing memory migrations
실험 설정은 이렇다.
- 합성 이력 48개에 무작위 정답 코드를 심어서 정확하게 채점
- 100억 파라미터 미만 오픈웨이트 모델 둘(Llama-3.1-8B, Qwen2.5-7B) 사용
- 컨텍스트 예산을 맞춤
- 결과를 보기 전에 가설과 분석 계획을 서명된 Git 태그로 고정
미리 정한 가설은 넷이다. 쓰는 모델·임베딩 쪽 셋은 이렇고, 나머지 하나(H7a, 복구)는 4.1에서 나온다.
- H1 : 쓰는 모델을 바꾸면 NOTES 성능이 떨어진다
- H2 : 50/50 혼합 인덱스가 완전 재임베딩보다 정확도가 낮다
- H4a : 쓰는 모델을 바꿀 때 NOTES가 KG-fixed보다 더 떨어진다
각 가설은 효과 추정치가 5pp(퍼센트포인트)를 넘고, 네 검정을 같이 보정한(Holm) p가 0.05 아래일 때만 지지된 것으로 친다. 이 5pp가 논문이 말하는 임계다.
Figure 2는 고정된 합성 이력을 네 형식으로 바꾼 다음, 모델·임베딩 인덱스·복구 소스·진단용 증거 중 하나씩만 바꿔가며 재는 흐름이다.
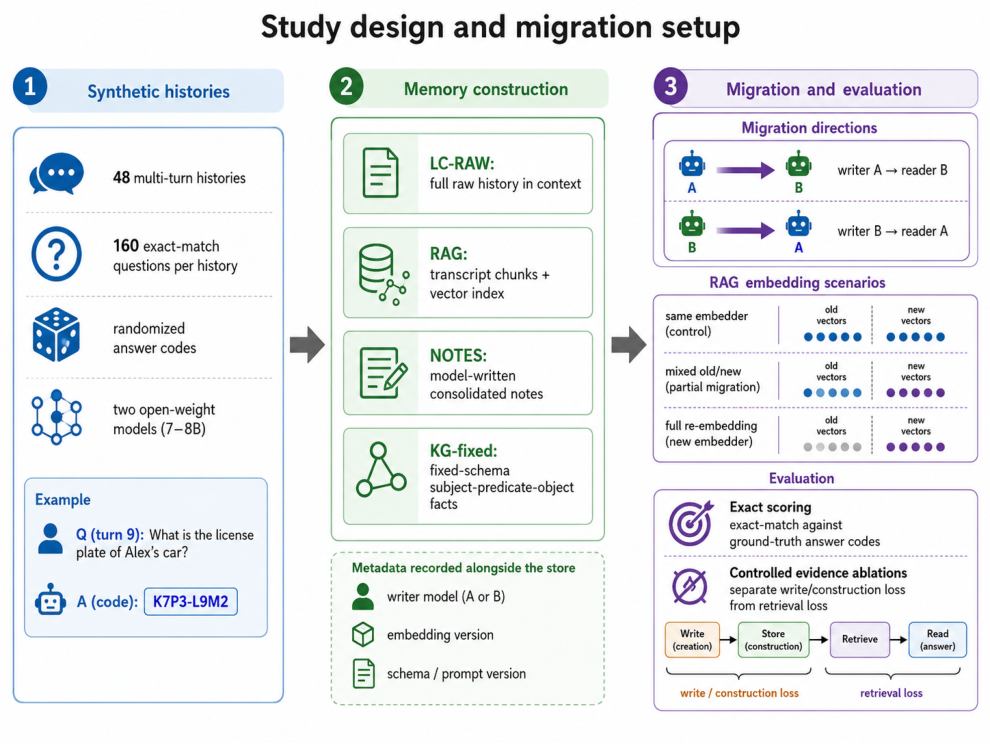
오른쪽 아래처럼 쓰기·저장 단계 손실과 검색 단계 손실을 따로 떼어 보는 것도 설계에 들어가 있다.
4. Results and analysis
논문은 주요 결과 네 개를 그림 한 장에 모아뒀다.
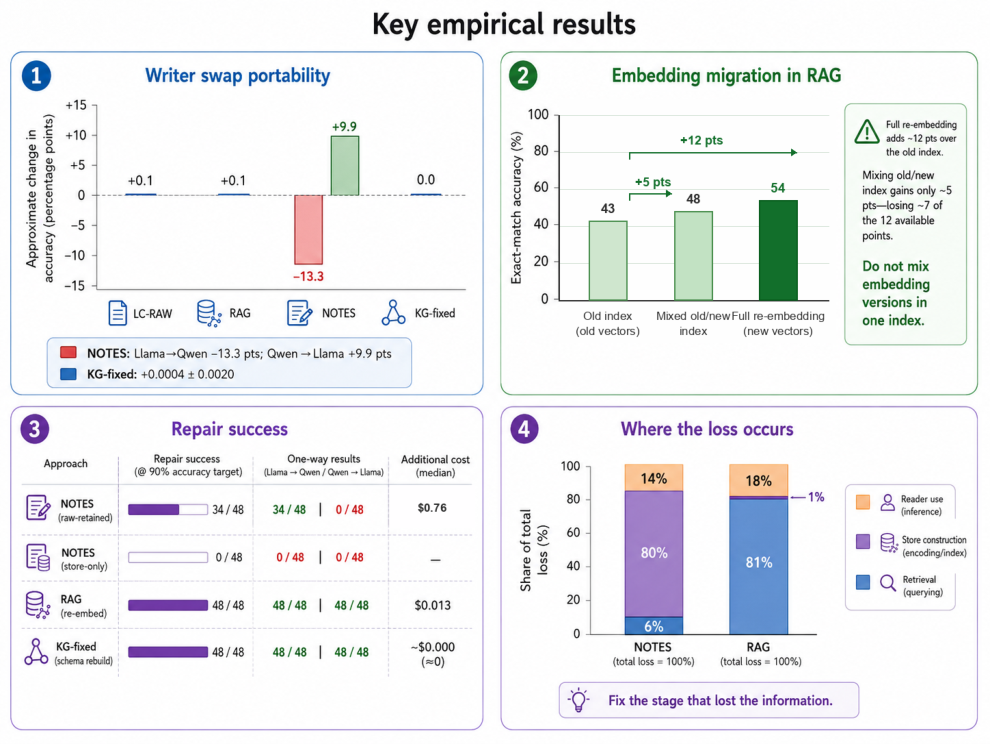
①은 쓰는 모델 교체, ②는 임베딩 마이그레이션, ③은 복구, ④는 손실이 어느 단계에서 생기는지다. 아래 4.2~4.5가 이 순서를 따른다.
4.1 Learnings from the tests
미리 정한 네 검정 결과는 논문 Table 2다. Estimate가 효과 추정치이고, Margin vs. 5 pp는 추정치에서 5pp를 뺀 값, Decision 열이 지지 여부다.
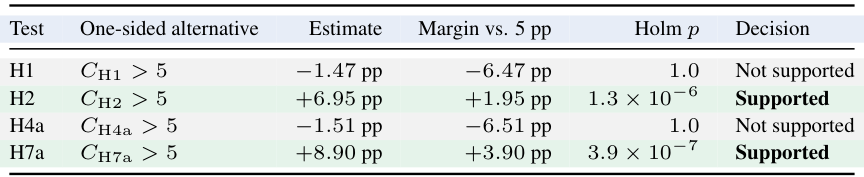
5pp 임계를 넘은 건 혼합 인덱스(H2, +6.95pp)와, 원본 이력으로 복구하는 쪽이 저장소만으로 고치는 쪽보다 낫다는 가설(H7a, +8.90pp) 둘이다. 쓰는 모델 교체(H1, H4a)는 넘지 못했다.
4.2 A fixed schema transfers better than free-form notes
쓰는 모델을 바꾸고 읽는 모델은 고정한 채로 쟀다.
아래는 논문 Table 3, 48개 이력의 정답률이다. 위쪽 네 행을 보면 된다. Own-store는 리더가 직접 쓴 메모리, Inherited-store는 다른 모델이 쓴 메모리다. Swap ∆는 물려받은 쪽에서 자기 쪽을 뺀 값(pp)이다.
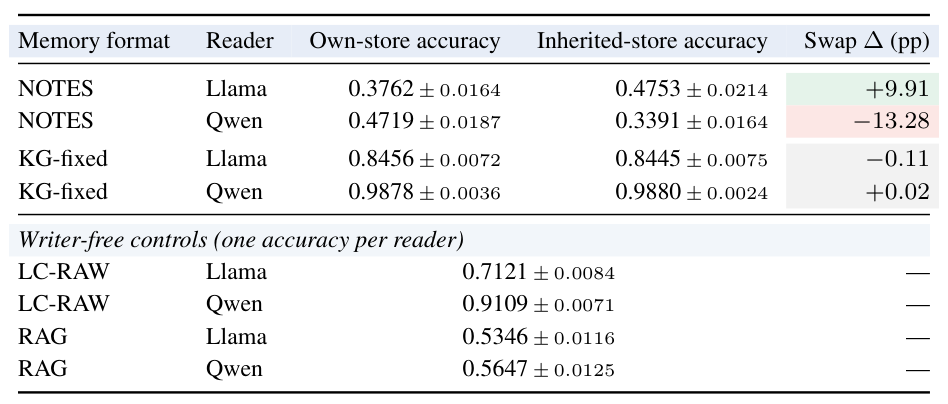
KG-fixed는 거의 변하지 않는다.
abstract에는 KG-fixed 변화가 +0.0004 ± 0.0020로 적혀 있다. pp가 아니라 정확도(0~1) 단위라서 0.04pp이고, ±는 이력 간 95% 신뢰구간 반폭이다.
-> 표의 두 방향(−0.11pp, +0.02pp)을 그냥 평균하면 −0.045pp라서 크기는 맞는데 부호가 반대다. 논문은 두 방향을 어떻게 합쳤는지 따로 적지 않았다.
스키마가 키, 관계 이름, 읽는 규칙을 정해 두고 모델은 값만 채우니까, 누가 썼든 읽는 쪽이 똑같이 해석한다.
NOTES는 방향에 따라 부호가 바뀐다. Llama가 Qwen 노트를 읽으면 +9.91pp 좋아지고, Qwen이 Llama 노트를 읽으면 −13.28pp 나빠진다.
그런데 두 방향을 평균하면 −1.7pp 정도라서 별 차이 없어 보인다. 실제로 H1과 H4a는 추정치가 −1.47pp, −1.51pp로 5pp 임계를 못 넘어서 지지되지 않았다.
논문도 평균이 이런 실패를 숨긴다고 하고, 그래서 방향별 결과를 따로 보여준다. 논문은 이 비대칭이 두 모델의 노트 쓰는 능력 차이에서 온다고 본다. 넉넉한 예산을 줬을 때 필요한 증거를 Qwen은 85.6% 남겼고 Llama는 64.5%만 남겼다.
-> A→B가 괜찮아도 B→A는 무너질 수 있으니, 교체 방향별로 따로 테스트해야 한다.
4.3 Retrieval can fail before the new model sees anything
모델을 바꾸기 전부터 RAG 파이프라인 자체가 병목이었다.
위 Table 3 아래쪽의 Writer-free controls 행을 보면 된다. 쓰는 모델이 끼지 않는 두 방식을 리더별로 잰 값이다.
원본을 그대로 넣는 LC-RAW는 두 리더에서 0.712~0.911인데, RAG는 0.535~0.565에 머문다.
리더 모델과 상관없이 검색이 필요한 증거를 실제로 가져오는 건 약 60%뿐이다. 40%는 못 찾는다.
다만 논문은 이게 RAG 전체의 한계라고 하지는 않는다. 일부러 단순하게 만들었기 때문이다. 단일 단계 dense 검색기, 이벤트 기반 청크, 코사인 top-k=8을 썼고 리랭커나 어휘 검색은 없다.
앞에서 본 MemMachine 리뷰는 이웃 턴 확장으로, SYNAPSE 리뷰는 BM25+dense 이중 트리거로 이 부분을 채웠다. 이 논문의 단일 단계 dense 검색 설정에서는 그런 장치가 없으면 40%를 놓친다는 걸 보여준다.
여기서는 RAG의 임베딩 모델을 바꾸는 경우를 본다.
임베딩을 bge-large-en v1.0에서 v1.5로 바꿀 때 네 가지 방식을 비교한다.
- 옛 인덱스 그대로
- 완전 재구축
- 50/50 혼합
- 어느 인덱스에 답이 있는지 아는 이상적 라우터 (상한선)
결과는 논문 Table 4다. 48개 이력, 리더 두 개 기준이다. Gain vs. old 열에서 50/50 mixed index(+4.96pp)와 Full re-embed(+11.90pp)를 비교하면 된다.
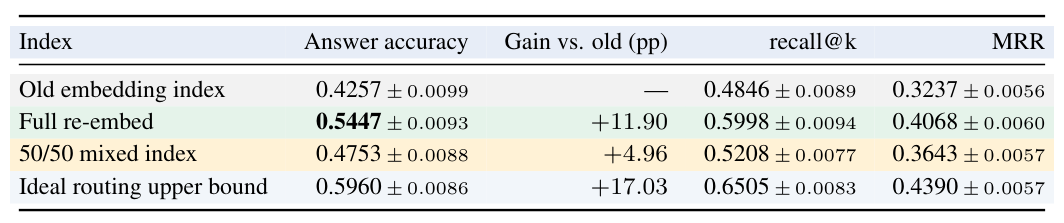
혼합 인덱스는 전체 이득의 절반도 못 가져온다.
H2는 완전 재임베딩과 혼합 인덱스의 정확도 차이다. 이력·리더별 차이를 평균한 추정치가 +6.95pp로 5pp 임계를 넘어서 지지됐다(Holm 보정 p = 1.3 × 10⁻⁶). 표에서 11.90 − 4.96 = 6.94pp와 같은 값이다.
두 버전 모두 1024차원 벡터를 내서 차원 오류 없이 그냥 돌아간다. 그래서 논문은 혼합 인덱스를 “조용한 부분 마이그레이션”이라고 부른다.
-> 임베딩 모델을 바꿀 때 기존 벡터는 그대로 두고 새로 들어오는 것만 새 모델로 넣는 경우가 많은데, 그러면 이렇게 된다.
4.4 Raw history buys a second chance—if the repairer can use it
원본 이력을 남겨두면 메모리를 다시 만들 수 있는지를 본다.
모델이 쓴 노트는 원본을 압축한 사본이다. 쓰는 모델이 사실을 빠뜨렸으면 노트를 다시 써도 되살릴 수 없다.
그래서 원본 이력을 남겨두면 복구가 되는지 시험했다. 목표는 새 리더가 자기 저장소에서 내는 성능의 90%까지 회복하는 것이다.
복구 방식별로 목표를 넘긴 건수와 비용은 논문 Table 7에 있다. 위 블록은 Llama가 쓰고 Qwen이 복구한 경우, 아래 블록은 Qwen이 쓰고 Llama가 복구한 경우다. 90% target 열을 보면 NOTES store-only는 양쪽 다 0/48, NOTES raw-retained는 Qwen이 복구할 때만 34/48(중앙값 $0.76)이다. RAG re-embed와 KG-fixed schema rebuild는 양쪽 다 48/48이고, KG-fixed는 99% 목표에서 45/48, 46/48로 합쳐 96건 중 91건이다.
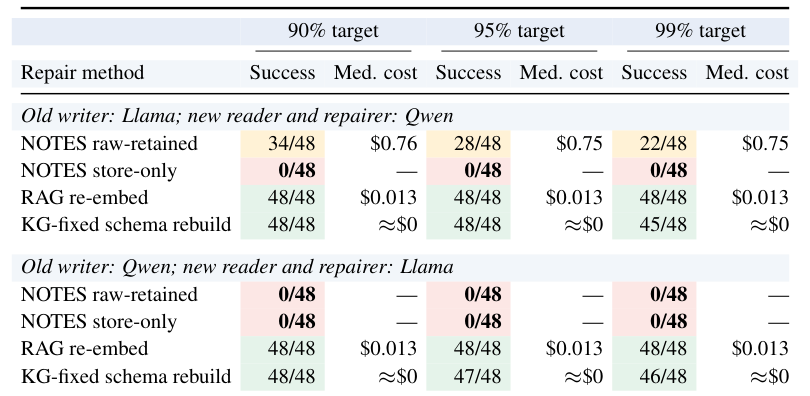
96건은 48개 이력에 교체 방향 두 개(Llama→Qwen, Qwen→Llama)를 곱한 수다. Figure 3의 ③에 방향별로 48건씩 나뉘어 있다. NOTES 복구는 방향마다 복구 모델이 달라서 48건씩 따로 적었다.
원본 없이 노트만 다시 쓰면 48건 중 0건이다. 이미 없어진 증거는 다시 만들 수 없으니까.
원본이 있어도 복구하는 모델이 못 쓰면 소용없다. Llama는 매번 출력 토큰 한도에 걸려서 0건이었다.
논문은 출력 한도를 늘리면 달라질 수 있고, 복구 모델이랑 마이그레이션 방향이 같이 바뀌어서 모델 능력을 깔끔하게 비교한 건 아니라고 한다.
RAG는 재임베딩이 건당 $0.013으로 싸고, KG-fixed는 고정 스키마로 다시 만드는 비용이 거의 0이다.
4.5 Most memory loss happens upstream of the reader
정확도 손실이 쓰기·검색·읽기 중 어느 단계에서 생기는지 나눠서 봤다.
논문 Table 6이 48개 이력을 합친 평균 손실을 단계별로 나눈 것이다. NOTES 행은 Store construction(0.467, 80%)이, RAG 행은 Retrieval(0.364, 81%)이 강조돼 있다. 노트 안에서 검색하다 잃는 건 6%이고, RAG의 저장된 청크 자체는 1%로 거의 0이다.
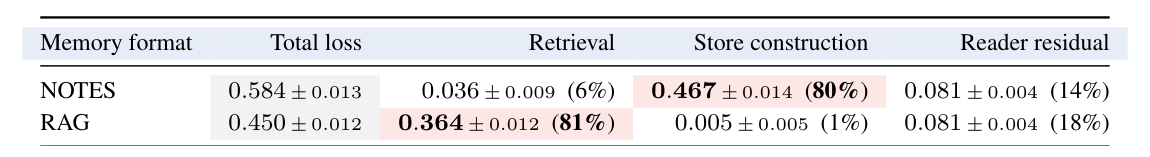
둘이 정반대다.
NOTES는 쓸 때 이미 잃는다. 노트를 새 리더 문체에 맞게 다시 써봤는데 회복이 안 됐다.
낯선 표현보다 빠지거나 망가진 내용이 문제라고 한다.
RAG는 반대로 청크에는 정보가 거의 다 남아 있는데 검색이 못 찾는다. 검색을 건너뛰고 맞는 청크를 바로 주면 두 리더 모두 대체로 잘 푼다.
그래서 리더를 바꾸기 전에, 결정적 증거를 저장했는지, 검색했는지, 전달했는지부터 확인하라고 한다. NOTES는 요약·쓰기 단계를, RAG는 청킹·색인·랭킹을 고쳐야 한다.
4.6 Scope and limits of the findings
논문이 밝힌 범위 한계다.
- KG-fixed 결과는 이 워크로드에서의 이식성일 뿐, 지식그래프가 늘 낫다는 뜻은 아님
- 40% 검색 실패율과 혼합 인덱스 저하는 같은 차원 임베딩 사이를 옮기는 단일 단계 dense 검색기에 한정
- 원본 보존으로 복구가 된 건 한 방향뿐
- 비슷한 크기 모델 두 개, 두 컨텍스트 창에 넉넉히 들어가는 합성 이력만 봄
5. Agent Memory Compatibility Across Model Transitions
모델이 바뀐 뒤에도 메모리를 쓸 수 있게 하려면 볼 것 여덟 가지를 정리한다. 오래 남길 정보를 명시하기, 메모리를 만든 모델·프롬프트·임베딩 같은 출처 기록하기, 전환 방향별로 따로 보기, 업그레이드 뒤 작은 평가 돌려보기 등이다.
6. Conclusion
모델 업그레이드를 단순 교체가 아니라 메모리 마이그레이션으로 다루라고 한다.
- 옛 저장소로 새 모델을 테스트한다
- 벡터 인덱스를 완전히 다시 만든다
- 정책이 허용하면 보호된 원본 이력을 유지한다
- 복구 방법을 고르기 전에 정보가 쓰기·검색·읽기 중 어디서 사라졌는지 확인한다
마지막 문단은 메모리 시스템이 그걸 만든 모델보다 오래 살아야 하고, 나중 모델이 읽고, 출처를 확인하고, 필요하면 다시 만들 수 있어야 한다는 내용이다.
한 모델 안에서만 메모리 성능을 재던 앞의 논문들과 달리, 모델이 바뀐 다음에도 메모리를 쓸 수 있는지를 잰 논문이다.
7. 지금 관점: 모델을 바꿀 때 확인할 것
앞의 논문들은 메모리를 어떻게 만들지를 다뤘고, 이 논문은 만든 다음에 모델이 바뀌면 어떻게 되는지를 다룬다.
세션 요약, 대화 압축, 추출한 사실 같은 건 다 NOTES 쪽이다. 모델을 바꾸면 방향에 따라 +9.91 ~ −13.28pp 흔들릴 수 있고, 손실의 80%가 쓰기 단계에서 생긴다. 원본 없이는 고칠 수 없다.
반대로 KG-fixed는 거의 안 움직였다. 자유롭게 쓰게 하지 말고 정해진 필드에 값을 채우게 하면 모델이 바뀌어도 해석이 안 흔들린다.
-> 꼭 그래프까지 가야 하는 건 아닌 것 같다. 스키마가 고정인 게 중요한 거 아닌가??
임베딩은 전부 다시 만드는 게 맞아 보인다. 50/50 혼합은 전체 이득의 42%만 가져왔고, 논문도 임베딩 공간을 엄격하게 분리하라고 권한다.
원본도 남기는 게 좋다. 원본 없는 복구는 48건 전부 실패했다. 앞에서 본 Rate-Distortion 리뷰의 가역성 얘기가 모델 교체라는 운영 상황에서 다시 나온 것 같다. 대신 전체 이력을 보존하면 프라이버시·보안·보관·삭제 의무가 생긴다고 논문도 적었다.
새 모델이 “잊었다”고 보이면 리더 탓을 하기 전에 저장·검색·전달부터 봐야겠다.
다음은 Agent Memory 논문 21편 회고다. 21편을 논문이 나온 순서대로 다시 늘어놓고 흐름을 정리했다.
Leave a comment