
The Past Is Prologue Paper review
The Past Is Prologue: A Plug-in Controller for Selective Updates in Sequentially Evolving LLM Memory
https://arxiv.org/abs/2606.31121
Janus는 University of Virginia, Princeton, UCF에서 만든 메모리 갱신 컨트롤러다. 2026년 6월 arXiv에 올라온 논문이다.
논문 제목은 The Past Is Prologue이고, 제안하는 방법 이름이 Janus다.
-> 이름 유래는 논문에 따로 없다. 앞뒤를 같이 보는 로마 신 이름이니까 옛 메모리와 새 메모리를 같이 본다는 뜻 같다.
기존 메모리 갱신기가 새 메모리를 제안하면, 그걸 바로 쓰지 않고 옛 메모리랑 비교해서 나은 쪽을 남긴다.
여기서 다루는 메모리는 앞의 리뷰들 대부분(Mem0, Zep 등)처럼 지난 대화를 회상하는 용도가 아니다. MATH500, GPQA 같은 문제를 차례로 풀면서 쌓은 경험(규칙, 치트시트)을 다음 문제에 쓰는 메모리다. 논문은 이걸 다음 태스크에서 LLM의 행동을 바꾸는 test-time 적응 수단으로 본다.
앞에서 본 서베이(Memory in the Age of AI Agents) 분류로 보면 Functions는 experiential memory이고, Dynamics는 evolution에 해당한다.
앞에서 본 Experience-Following 리뷰에서는 전부 넣으면 고정 메모리보다 못하다는 걸 봤고, 거기서는 평가기로 걸러서 넣으라고 했다. 여기서는 넣기 전에 옛 메모리랑 비교해 본다.
1. Introduction
기존 시스템은 메모리 갱신이 앞으로의 행동을 좋게 만드는지 확인하지 않고 그냥 반영한다.
그래서 세 가지 문제가 생긴다.
- 지금 태스크에는 도움이 되는 갱신이 쓸모 있던 지식을 덮어쓴다
- 너무 구체적인 규칙이 들어온다
- 최종 메모리가 최근 예시 쪽으로 치우친다
Figure 1 그래프를 보면 태스크가 진행되면서 테스트 정확도가 오르다가 정체하거나 떨어진다.
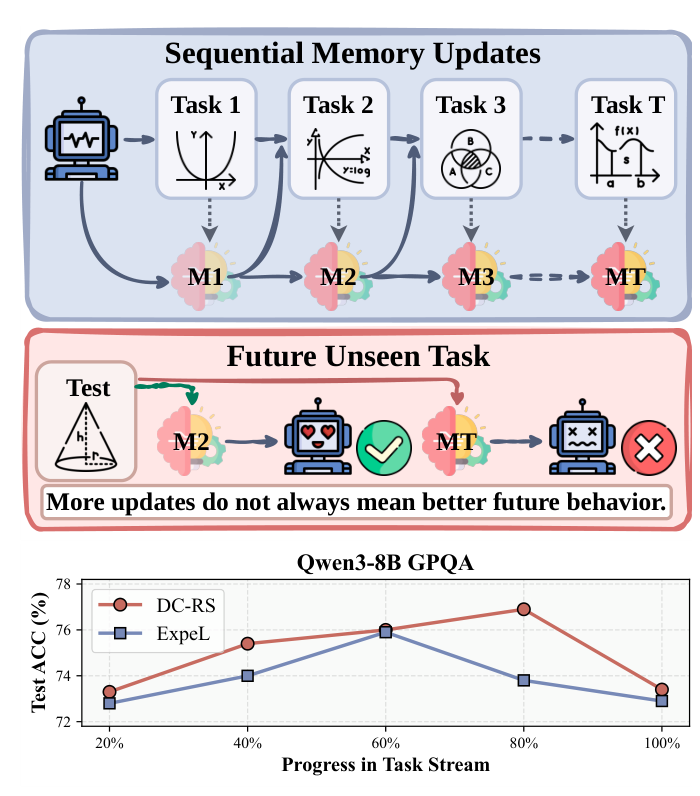
위쪽은 태스크마다 메모리를 M1, M2, …, MT로 갱신하는 흐름이다.
아래쪽은 Qwen3-8B GPQA에서 DC-RS, ExpeL의 중간 메모리 스냅샷으로 잰 테스트 정확도다. DC-RS와 ExpeL은 아래 3.1에서 설명하는 기존 갱신기다.
갱신을 많이 한다고 앞으로의 행동이 항상 나아지지는 않는다.
2. Method
2.1 Problem Setting
LLM이 태스크를 하나씩 풀면서 외부 메모리를 들고 간다. 풀고 나서 피드백을 받으면 기존 갱신기가 새 후보 메모리를 만든다.
기존 방법은 이 후보를 바로 쓰는데, Janus는 이전 메모리와 후보 중 하나를 고르는 배포 결정으로 다룬다.
2.2 Janus: Plug-in Memory Control
ExpeL, DC-RS 같은 기존 갱신기를 감싸는 플러그인이다. 갱신 규칙 자체는 안 바꾼다.
태스크 t에서 기존 갱신기가 후보 메모리 M̂_t를 내놓으면, Janus가 이걸 쓸지 이전 메모리 M_{t-1}을 유지할지 정한다.
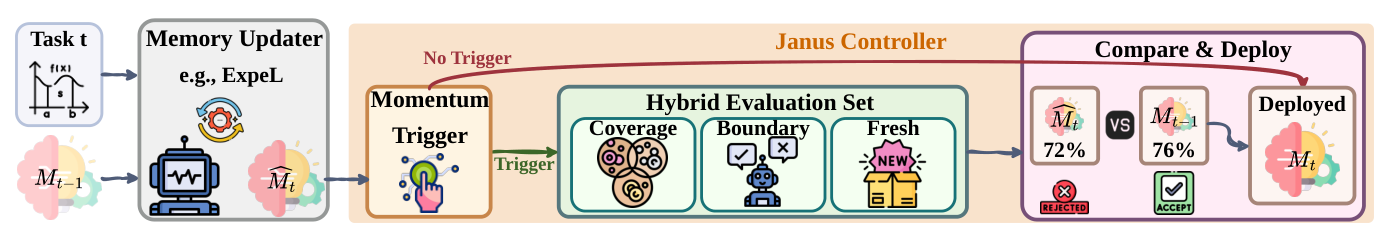
후보 갱신이 Momentum Trigger에 걸리지 않으면 그대로 배포된다.
걸리면 Hybrid Evaluation Set으로 M_{t-1}과 M̂_t를 비교해서 더 나은 쪽을 배포한다.
정해야 할 게 두 가지다.
- 언제 비교할 것인가 (when to compare)
- 무엇으로 비교할 것인가 (what to compare)
Memory Momentum Trigger (MMT)
언제 비교할지를 정하는 부분이다.
매번 비교하면 비싸다. 그래서 후보 갱신이 최근 갱신 흐름에서 벗어날 때만 비교하고, 아니면 후보를 바로 받는다.
재는 방법은 이렇다.
- 메모리 텍스트를 인코더로 임베딩하고, 후보 메모리 임베딩에서 이전 메모리 임베딩을 뺀 벡터를 이번 갱신 방향
z_t로 둔다 - 지난 갱신 방향들의 지수이동평균을 momentum
m_t로 들고 있는다 (β=0.9) z_t와 직전 momentumm_{t-1}의 코사인 유사도가 임계값 τ보다 작으면 비교를 건다 (τ=0.0)
τ=0.0이면 이번 갱신 방향이 최근 흐름과 90도 넘게 틀어졌을 때 비교한다는 뜻이다.
갱신들이 대체로 같은 방향으로 가면 조금씩 다듬는 중이라 비교해 봐야 얻을 게 적고, 방향이 확 틀어지면 쓸 만한 새 지식일 수도 있고 최근 태스크 내용으로 덮어쓰는 중일 수도 있어서 그때 확인한다.
Hybrid Trigger-Time Evaluation Set
무엇으로 비교할지를 정하는 부분이다.
이력 전체를 다시 돌리는 건 비싸서, 작게 만든 평가 집합을 쓴다. 세 가지를 섞는다.
- Coverage : 지금까지 본 태스크를 클러스터링해서 중심에 가장 가까운 것들
- Boundary : 앞선 비교에서 옛 메모리와 새 메모리의 정답 여부가 갈렸던 태스크들
- Fresh : 직전 비교 이후에 새로 들어온 태스크 중 일부
boundary는 따로 고르는 게 아니라 비교를 돌릴 때마다 생긴다. 두 메모리 중 하나로만 맞힌 문제(flip set)를 모아 두고, coverage와 겹치는 건 뺀다. 새 flip이 모자라면 이전 boundary를 남겨 채운다.
이 집합으로 옛 메모리랑 새 메모리를 평가해서 더 나은 쪽을 쓴다.
논문에서는 coverage와 boundary를 합쳐 support set이라 부르고, 여기에 fresh를 더한 걸 evaluation set이라 부른다. 크기는 support set 20개(coverage 12, boundary 8)에 fresh 5개다.
3. Experiment
3.1 Experimental Settings
데이터셋 여섯 개(MATH500, GPQA Diamond, MMLU-Pro Eng./Phy., APIBench-HF, HumanEval), 백본 두 개(Qwen3-8B, DeepSeek-V4-Flash), 갱신기 두 개로 실험했다.
비교 대상은 넷이다.
- Memory-free : 메모리 없이 LLM만으로 푸는 기준선
- ExpRAG : 임베딩이 비슷한 과거 태스크 top-k를 그대로 가져오는 방법
- DC-RS : 과거 경험을 검색·합성해서 치트시트(Dynamic Cheatsheet)로 정리하는 갱신기
- ExpeL : 성공·실패 궤적을 반성해서 재사용할 규칙을 뽑는 갱신기
Janus는 DC-RS와 ExpeL 위에 붙인다.
3.2 Main Results
논문 Table 1이다. 위쪽 묶음이 Qwen3-8B, 아래쪽 묶음이 DeepSeek-V4-Flash에서 여섯 데이터셋 정확도이고, 맨 오른쪽 Avg. 열이 평균이다. 회색 행이 Janus를 붙인 결과다.
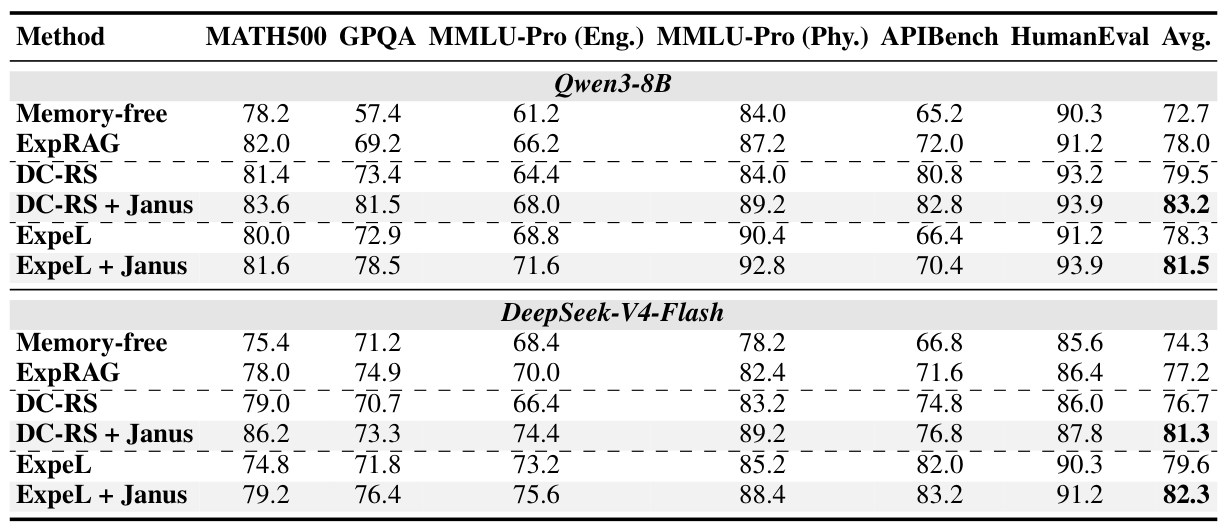
갱신기 두 개, 백본 두 개에서 모두 +2.7 ~ +4.6점 올랐다. 갱신기는 그대로 두고 감싸기만 해서 얻은 거다.
제일 많이 오른 건 GPQA에서 DC-RS 73.4 → 81.5로 8.1점이다.
DC-RS, ExpeL이 단순히 비슷한 과거 문제를 가져오는 ExpRAG를 늘 이기지는 못한다. 논문은 규칙을 뽑는 과정에서 쓸모 있는 세부가 빠지거나 너무 좁은 규칙이 들어가서 그렇다고 본다.
3.3 MMT Trigger Ablation
트리거 시점에 따라 결과가 달라지는지 본다.
MMT를 네 가지 방식이랑 비교했다.
- Base : 비교 안 하고 후보를 바로 받음
- Always : 태스크마다 비교
- Random : Janus와 같은 트리거 확률로 무작위 비교
- Periodic : N단계마다 비교, N은 Janus의 트리거 횟수에 맞춤
Qwen3-8B로 GPQA와 HumanEval에서 정확도와 트리거 비율을 쟀다. Trig. Rate는 옛 메모리와 새 메모리를 비교한 비율이다.
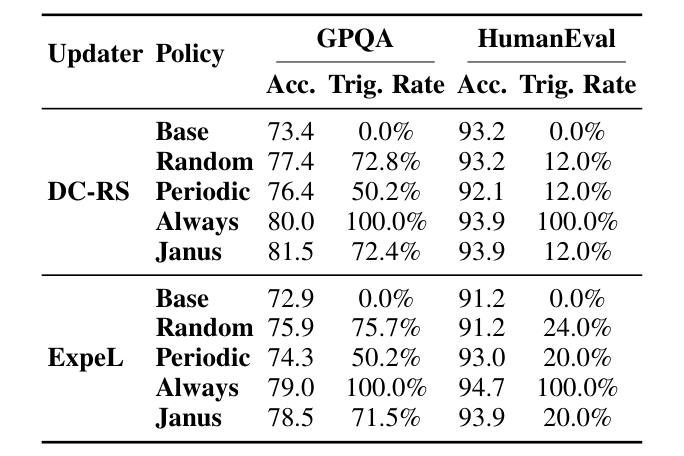
DC-RS GPQA에서 Always는 80.0(비교 100%), Janus는 81.5(비교 72.4%)다. Random은 77.4, Periodic은 76.4였다.
HumanEval에서는 DC-RS의 Always와 Janus가 둘 다 93.9인데, Janus는 태스크의 12%에서만 비교했다.
비교 횟수가 비슷해도 무작위나 주기적으로 거는 것보다 MMT가 낫다. 언제 비교하느냐에 따라 결과가 달라진다.
GPQA의 DC-RS에서 Janus가 Always보다 높은 건, 평가 집합이 작고 잡음이 있어서 자주 비교한다고 꼭 좋지는 않기 때문이라고 논문은 해석한다.
3.4 Support Set Composition Ablation
절 이름은 support set인데, 실제로는 fresh까지 포함한 evaluation set 세 구성요소를 하나씩 빼 봤다.
- coverage 제거 : 일관되게 성능 하락
- boundary 제거 : 일관되게 성능 하락
- fresh 제거 : 가장 크게 하락 (GPQA·HumanEval 둘 다)
Qwen3-8B와 DC-RS 갱신기로 GPQA, HumanEval의 최종 테스트 정확도를 쟀다.
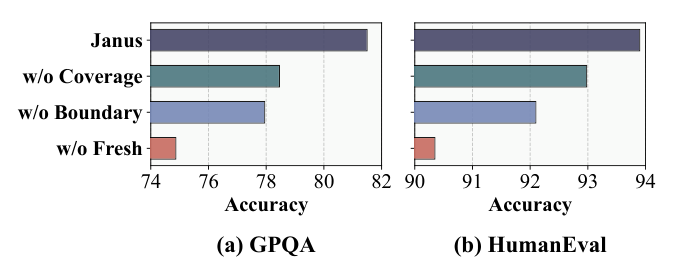
하나씩 빼 본 세 막대 중 w/o Fresh가 제일 짧다.
저장해 둔 support set으로만 평가하면 비교가 낡은 예시에 갇힌다고 한다.
-> 본 것만으로 평가하면 최근 예시에 맞춘 메모리가 유리해질 테니까, 새 태스크를 섞어야 일반화가 보이는 것 같다.
coverage는 본 분포를 넓게 대표하고, boundary는 메모리에 따라 답이 바뀌는 사례에 비교를 모은다.
3.5 Memory Deployment Ablation
갱신을 다 받았을 때 중간 메모리 성능이 어떻게 변하는지 본다.
스트림의 20%, 40%, 60%, 80%, 100% 시점마다 중간 메모리로 정확도를 쟀다. Qwen3-8B로 GPQA와 MMLU-Pro (Eng.)에서 쟀다.
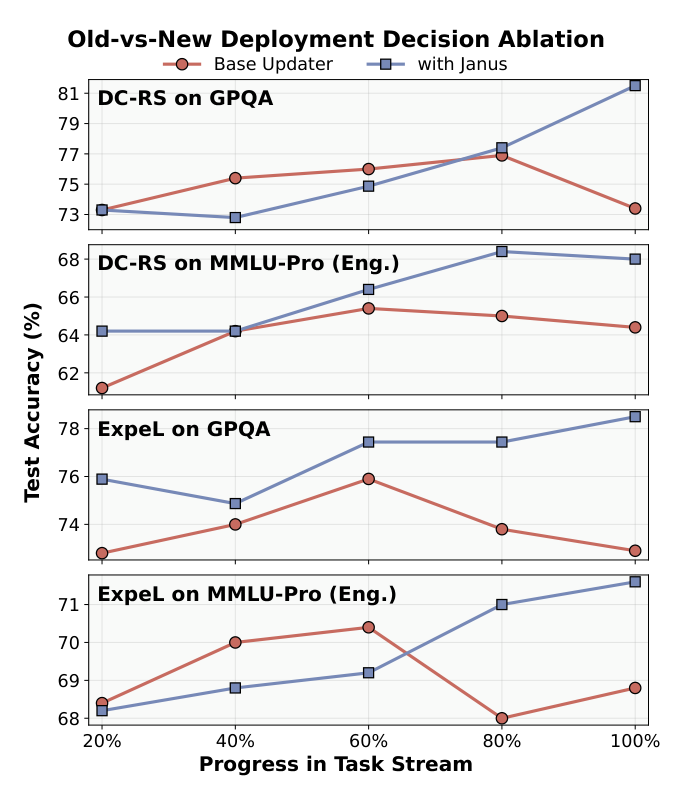
빨간 선이 갱신을 다 받는 기존 갱신기, 파란 선이 Janus를 붙인 경우다.
DC-RS와 ExpeL 둘 다 갱신을 전부 받으면 초중반에는 좋아지다가, 그 뒤로는 정체하거나 떨어진다.
앞에서 본 Experience-Following 리뷰의 Add all 결과랑 같은 모양이다. 거기서는 최종 성능만 봤는데, 여기서는 곡선이 꺾이는 지점까지 보여준다.
3.6 Hyperparameter Sensitivity
support set 크기 K와 MMT 임계값 τ를 바꿔본다. Qwen3-8B, DC-RS, GPQA 기준이고 논문 Table 3이다. 맨 위 Default 행(K=20, τ=0.0)이 기본 설정이고, Cost는 평가 비용 근사치(#Trig. × (K + fresh 5개))다.
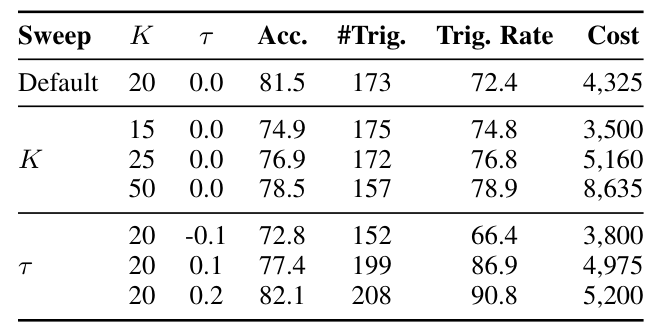
K는 20일 때 제일 좋았고 더 늘리면 비용만 늘었다. τ를 키우면 트리거가 더 자주 걸려서 정확도는 오를 수 있지만 평가 비용도 늘어난다고 한다. τ=0.2는 82.1로 기본보다 0.6점 높지만, 비교 비율이 90.8%로 오르고 비용도 5,200이다.
4. Related Work
ExpeL, Dynamic Cheatsheet 같은 순차 메모리 방법과 피드백으로 테스트 시점에 적응하는 연구를 정리한다.
기존 방법은 메모리를 어떻게 만들고 갱신할지에 집중하고 새 메모리를 바로 쓴다고 가정하는데, Janus는 그걸 쓸지 말지를 다룬다고 한다.
5. Conclusion
메모리 갱신을 배포 결정으로 다룬 논문이다.
국소적으로 만든 메모리를 무조건 받아들이던 걸, 어떤 메모리가 앞으로의 추론에 쓰일지 통제하는 쪽으로 바꿨다.
conclusion 부분을 보면 순차적으로 바뀌는 메모리는 경험을 더 많이 저장하거나 더 자주 갱신하는 것과는 다른 스케일링 문제라고 한다. 이력이 길어질수록 추가 추론을 어디에 쓸지가 중요해지고, 새 메모리를 다 믿어서도 안 되고 모든 갱신을 비싸게 검증할 필요도 없다. 그래서 메모리를 잘 쓰는 것뿐 아니라, 고치는 게 비용만큼 가치가 있는지 판단하는 장치도 필요하다고 본다.
한계도 적었다.
범위는 프롬프트 기반 순차 메모리만 다룬다. LLM은 고정이고 메모리는 검색·요약·반성·치트시트 같은 외부 텍스트로 갱신되는 설정이다. RL로 정책이나 스킬을 갱신하는 학습 기반 진화로 넓히는 건 후속 과제로 남겼다.
평가 범위는 여러 태스크와 백본 두 개다. 장기 상호작용 환경, 멀티에이전트, 분포가 바뀌는 태스크에서는 다른 문제가 있을 수 있다.
-> 두 번째는 Experience-Following 리뷰랑 겹친다. 거기서는 태스크 분포가 바뀌면 history-based 삭제가 오히려 불리했다. Janus의 coverage도 본 분포를 전제로 하니까 분포가 바뀌면 같은 문제가 생길 것 같다.
여태까지 메모리 갱신은 LLM이 제안하면 그대로 반영했다면, 이 방법은 옛 메모리와 비교해서 나을 때만 반영한다.
6. 지금 관점: 메모리 갱신에 적용해볼 만한 부분
앞에서 본 Mem0, Zep, A-MEM은 갱신할 때 LLM 판단을 그대로 믿었다. 추가·수정·삭제를 LLM이 고르거나, 모순을 LLM이 판단해서 옛 사실을 무효화하거나, 이웃 메모리를 LLM이 고쳐 쓴다. 고친 다음에 그게 나아졌는지 재보는 단계는 없었다.
Experience-Following은 넣기 전에 평가기로 거르고, Janus는 후보를 만든 뒤 배포 전에 옛 버전과 맞붙여서 나쁘면 옛 메모리를 유지한다.
-> 옛 메모리를 유지하려면 이전 메모리가 남아 있어야 한다. 그 자리에서 덮어쓰면 Janus 같은 비교를 붙일 수가 없다. 버전을 남기든지 적어도 직전 상태는 들고 있어야 할 것 같다. 되돌릴 수 있게 남기는 문제는 바로 다음 Rate-Distortion 리뷰에서 다시 나온다.
평가 집합 셋 중에서는 fresh가 제일 쉽다. 안 본 질의를 조금 떼어두면 되고, 기여도 제일 컸다. boundary는 비교를 돌리다 보면 저절로 쌓이니까 처음 몇 번은 비어 있을 텐데, 그때는 coverage랑 fresh만으로 버티는 건지??
그리고 이 실험은 정답이 있는 문제 풀이라서 옛 메모리와 새 메모리 중 어느 쪽이 나은지 바로 채점할 수 있다. 대화 메모리처럼 정답이 없는 곳에서는 무엇으로 점수를 매길지부터 정해야 할 것 같다.
다음은 What to Keep, What to Forget이다. KV 캐시 축출, 프롬프트 압축, 에이전트 메모리 요약을 하나의 rate-distortion 문제로 묶은 서베이다.
Leave a comment