
What to Keep What to Forget Paper review
What to Keep, What to Forget: A Rate–Distortion View of Memory Compaction in LLMs and Agents
https://arxiv.org/abs/2607.08032
What to Keep, What to Forget은 UC Irvine에서 쓴 메모리 압축 서베이 논문이다. 2026년 7월에 arXiv에 올라왔다.
무엇을 버릴지를 다루는 논문이다. 앞에서 본 서베이(Memory in the Age of AI Agents)에서는 Forgetting을 Dynamics의 한 항목으로 올려두기만 했는데, 여기서는 그걸 정보이론으로 정식화한다.
rate-distortion은 원래 정보이론 용어다. rate는 남기는 양(메모리 예산), distortion은 그만큼 줄여서 생기는 오류다. 예산을 줄일수록 오류가 늘어나는 관계를 곡선으로 그려서, 같은 예산에서 오류가 적은 방법을 고른다.
1. Introduction
introduction 부분을 보면 출발점이 구체적이다.
트랜스포머로 10만 토큰을 읽히면 이미 읽은 것의 KV 캐시가 모델 가중치보다 가속기 메모리를 더 많이 차지한다.
같은 문제가 여러 형태로 나타난다.
- 에이전트가 쌓는 도구 호출 기록이 컨텍스트 창을 금방 넘는다
- state-space나 linear-attention 모델은 과거 전체를 고정 크기 상태에 넣어야 한다
- 사용자를 기억해야 하는 어시스턴트는 세션을 넘어서 뭔가를 들고 가야 한다
부족한 게 계산보다 읽은 것의 메모리가 됐고, 들어갈 자리보다 많을 때 뭘 할지가 문제가 됐다.
여기에 네 개의 연구 커뮤니티가 서로 거의 교류 없이 각자 답을 만들어왔다. 논문은 이 넷을 layer라고 부르는데, 아래에서는 층이라고 쓴다.
- KV 캐시 압축 : 추론 중에 작동, 값이 낮은 토큰을 버리거나 몇 비트로 저장하거나 인수분해·병합
- 프롬프트·컨텍스트 압축 : 모델이 입력을 읽기 전에 작동, 토큰을 지우거나 고쳐 쓰거나 학습된 “gist” 벡터 몇 개로 바꿈
- 아키텍처 상태 압축 : 구조를 바꿔서 상태 크기를 묶음
- 에이전트 메모리 통합 : 궤적을 요약
논문은 이 넷이 사실 같은 문제라고 한다.
어떤 정보를 어느 충실도로, 어떤 예산 안에서, 다운스트림 태스크 성능을 지키면서 남기고 버릴 거냐. 이걸 하나의 rate–distortion 결정으로 본다.
Figure 1은 네 층과 층에 걸친 주제를 한 장에 모은 그림이다.
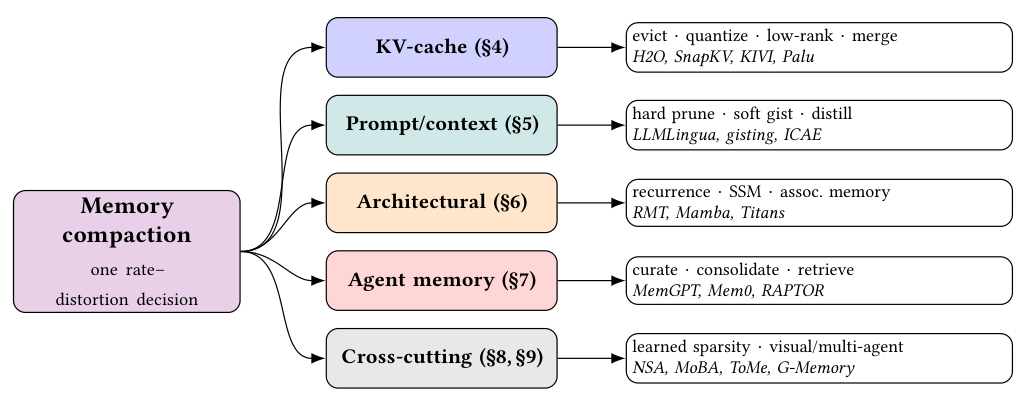
네 층이 다루는 대상과 시점은 달라도 같은 rate–distortion 선택을 한다.
trainable sparse attention이랑 멀티모달·멀티에이전트는 네 층에 걸치는 cross-cutting으로 따로 뒀다.
-> KV 캐시 축출이랑 에이전트 대화 요약을 같은 문제로 본다는 게 처음엔 좀 억지 같았는데, 뒤에 실험을 보니 이해가 됐다.
2. A Unified Formalism for Compaction
형식화에서 성질 세 개를 뽑는다.
- P-rev (되돌릴 수 있는가) : 버린 내용을 나중 질의가 필요로 할 때 다시 꺼낼 수 있는가
- P-q (질의를 보는가) : 뭘 남길지 정할 때 질의(또는 질의 분포)를 보는가
- P-fid (충실도) : 무손실, 준무손실, 균일 손실, 다중 충실도(작은 정확 계층 + 큰 손실 계층) 중 무엇인가
P-rev로 보면 검색·아카이브 방식은 되돌릴 수 있고, 축출과 요약은 못 한다. P-q로 보면 오프라인 gisting은 질의를 못 보고, LongLLMLingua와 Quest는 본다.
Figure 2는 가로축이 예산, 세로축이 태스크 성능이다. 파란 선이 질의를 보는 방식, 빨간 선이 질의를 안 보는 방식이다.
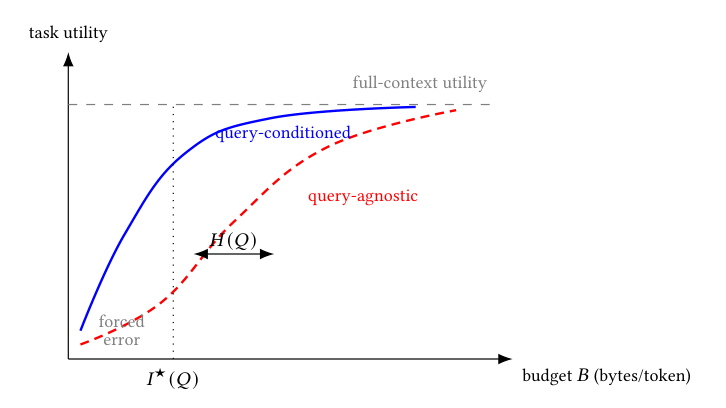
I★(Q)는 질의 Q에 답하는 데 꼭 필요한 정보량이다. 쌓인 맥락 중 정답을 맞히는 데 실제로 필요한 비트 수라고 보면 된다.
예산이 I★(Q)보다 작으면 어떤 방식도 오류를 피할 수 없다.
두 곡선 사이 가로 간격이 질의 엔트로피 H(Q)다. 질의를 미리 모르는 대가로 그만큼 예산을 더 써야 같은 성능이 나온다.
그리고 서베이 전체에서 보이는 패턴 두 개를 말한다.
첫째, 모든 층에서 뭘 남길지 정하는 신호가 어텐션 크기 아니면 최신성으로 똑같고, 실패도 똑같다. 질의를 알기 전에, 되돌릴 방법 없이, 나중에 필요한 정보를 버린다. P-rev와 P-q를 같이 어기면 모든 층에서 같은 실패가 나온다는 게 형식화에서 나오는 예측이다.
둘째, 에이전트가 실제로 하는 반복 압축은 거의 측정되지 않는다. 압축은 보통 단일 턴 긴 컨텍스트에서 재는데, 에이전트는 압축을 여러 번 되풀이한다. 하나의 예산 축으로 네 층을 같이 재는 벤치마크도 없다.
3. A Seven-Axis Taxonomy
약 70개 방법을 같은 좌표에 놓는다. 축끼리는 가능한 한 겹치지 않게 골랐고, 방법 하나가 축들의 곱 위의 한 점이 된다.
축은 일곱 개인데, 논문은 층을 가르는 건 이 중 세 축뿐이라고 한다.
- 압축 단위 : 무엇을 단위로 줄이나 (비트, 토큰·KV 항목, 자연어 스팬, 순환 상태, 사실·노트 같은 의미 항목 등)
- 생애주기 단계 : 언제 줄이나 (사전학습, prefill, decode, 태스크 안, 태스크 사이, 오프라인 색인 등)
- 질의·태스크 적응성 : 질의를 보고 줄이나 (질의 무관, 질의 조건부, 학습된 보상으로 태스크 인지)
나머지 넷(손실성과 충실도, 학습 가능성, 메커니즘, 저장 위치)은 층끼리 차이가 훨씬 작다. 가역·비가역 구분은 손실성 축 안에 들어 있다.
그래서 KV 축출이랑 에이전트 요약이 생각보다 가깝다.
층별 축 값은 논문 Table 2에 있다. 논문이 층을 가른다고 본 세 축이 Granularity, Lifecycle stage, Adaptivity 열이다.
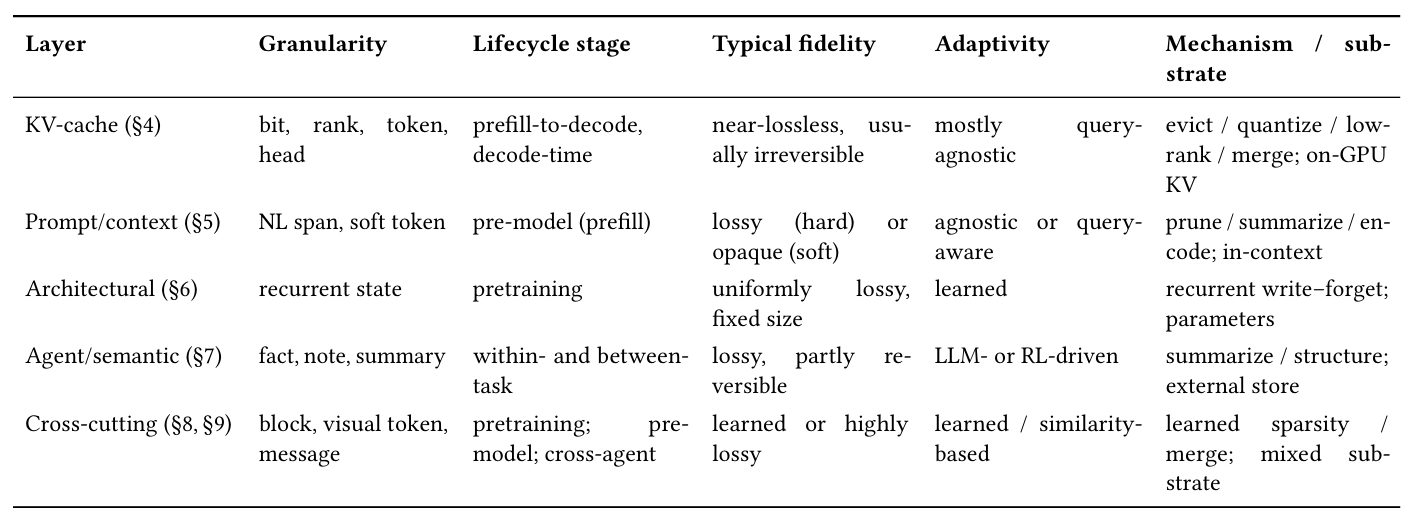
Figure 3은 생애주기 축을 그린 그림이다. 맨 왼쪽 Mamba, RMT(아키텍처 단계)부터 맨 오른쪽 Mem0, RAPTOR(태스크 사이 통합, 오프라인 색인)까지 한 줄에 놓여 있다.
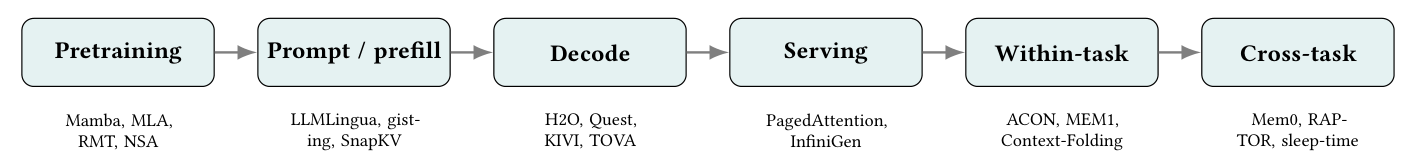
단계마다 대상과 시간 규모는 다르지만 남길지 버릴지는 똑같이 정한다.
4. KV-Cache-Level Compaction
첫 번째 층이다. 긴 맥락에서는 가중치보다 KV 캐시가 GPU 메모리를 더 차지해서, 압축 연구가 이 층에 제일 많다고 한다.
토큰 축출, 질의 시점에 일부만 읽기, 양자화, 차원 줄이기, 층 간 공유·병합으로 나눈다. 거의 다 어텐션 점수로 버렸을 때의 손해를 어림한다.
5. Context and Prompt Compaction
두 번째 층이다. 모델이 읽기 전에 입력 자체를 줄인다.
결과가 사람이 읽을 수 있는 텍스트로 남는 hard 방식과 학습된 벡터로 바뀌는 soft 방식으로 나눈다.
6. Architectural and Bounded-State Compaction
세 번째 층이다. 압축을 모델 구조에 넣고 가중치와 같이 학습한다.
고정 크기 상태는 질의를 보기 전에 크기가 정해져 있어서, 상태보다 많은 정보가 필요한 질의에는 답할 수 없다고 한다.
7. Agent and Semantic-Memory Compaction
네 번째 층이다. 에이전트의 도구 호출, 관찰, 대화 기록을 요약·사실·노트·그래프로 줄여 외부에 두고, 검색해서 다시 창에 넣는다.
뭘 남길지 LLM이 판단하니까 그 판단이 틀리면 메모리에 그대로 남는다. 그래서 이 층에서는 원본을 남겨 되돌릴 수 있느냐(P-rev)가 제일 중요하다고 한다.
8. Trainable Sparse Attention
4장의 KV 방법들은 학습이 끝난 모델에 나중에 붙이는 규칙이다. 여기서는 무엇을 남길지를 모델과 같이 학습한다.
9. Multimodal and Multi-Agent Compaction
이미지·영상 토큰은 이웃끼리 겹치는 정보가 많아서 텍스트보다 훨씬 세게 줄여도 버틴다고 한다. 멀티에이전트에서는 에이전트끼리 주고받는 메시지가 압축 대상이다.
10. The Inference ↔ Agent-Memory Bridge
층 간 이전을 다룬다.
같은 틀로 보면 한 층의 기법을 다른 층으로 옮길 수 있다고 한다. 예시가 세 개다.
- 망각 곡선을 KV prior로
- 축출 없는 검색을 에이전트 메모리 설계로
- 출력 오차 한계를 요약의 정지 규칙으로
Figure 4는 이 절이 다루는 세 계층을 위아래로 쌓은 그림이다.
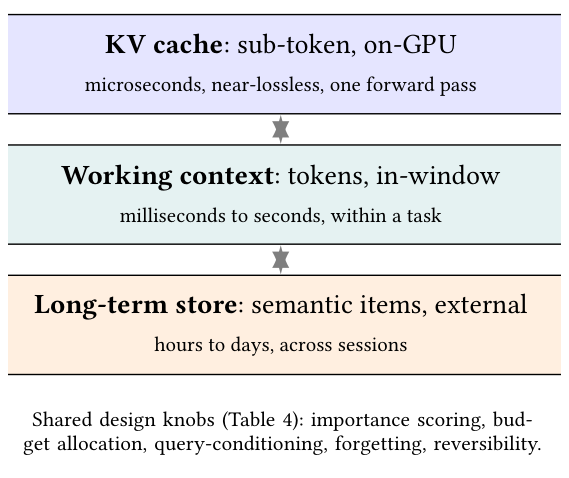
위에서부터 KV 캐시(마이크로초, 한 번의 forward), 작업 맥락(밀리초~초, 태스크 안), 장기 저장소(시간~일, 세션 사이)다.
시간 규모는 크게 달라도 중요도 점수, 예산 배분, 질의 조건화, 망각, 가역성이라는 다섯 손잡이를 같이 쓴다는 게 그림 아래 문장이다.
논문 Table 4는 같은 설계 손잡이(design knob)가 KV 캐시와 에이전트 장기 메모리에서 각각 무엇인지 나란히 놓은 표다. 세 예시는 Forgetting, Query-cond.·Reversibility, Stop rule 행에 해당하고, Stop rule 행의 에이전트 칸은 (open)으로 비어 있다.
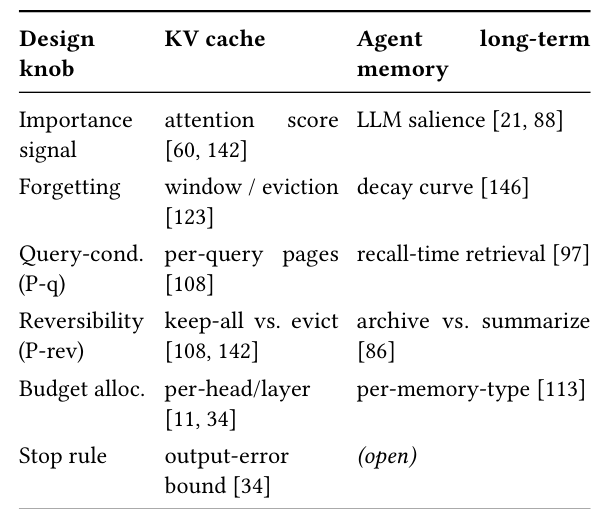
첫 번째를 보면, H2O 같은 KV 축출은 누적 어텐션만 보고 버리는데 이 신호는 앞쪽 토큰에 치우친다. MemoryBank(에이전트 메모리)의 Ebbinghaus식 망각 곡선은 최근에 다시 쓰인 기억일수록 오래 남기니까, 이걸 KV 축출 점수로 바꿔 끼울 수 있다는 게 논문 설명이다.
두 번째는 Quest가 KV를 버리지 않고 질의에 맞는 페이지만 꺼내 쓰듯, 에이전트도 요약해서 덮어쓰지 말고 아카이브에서 꺼내 쓰라는 얘기다. 세 번째는 Ada-KV의 출력 오차 상한처럼, 요약도 정해진 주기가 아니라 오차 추정치가 한계에 닿을 때까지만 하라는 것이다.
11. Systems and Serving Substrate
서빙 단계에서는 KV 캐시를 요청끼리 공유하고 GPU·CPU·디스크 사이로 옮기는 자원 관리 문제로 본다.
PagedAttention처럼 압축 없이 정확한 KV를 재사용하는 쪽은 되돌릴 수 있는 극단이고, FlexGen, InfiniGen처럼 메모리에 맞추려고 다시 손실을 들이는 쪽도 있다고 한다.
12. Theory of Compaction
2장의 하한(예산이 I★(Q)보다 작으면 오류를 피할 수 없다)을 뒷받침하는 이론 결과를 모은다. 정확한 어텐션은 맥락 길이에 비례하는 공간이 필요하고, 고정 크기 상태의 RNN/SSM은 어텐션이 푸는 일부 recall 문제를 못 푼다는 결과 등이다.
I★(Q) 자체를 예측하는 이론은 아직 없다고 한다.
13. Evaluation and the COMPACT-Bench Proposal
Needle-in-a-Haystack, RULER 같은 기존 벤치마크를 정리한다. 층마다 예산 단위가 달라서 서로 비교가 안 되고, 버린 걸 아는지·되찾을 수 있는지는 아무도 재지 않는다고 한다.
그래서 하나의 예산 축으로 네 층을 같이 재는 COMPACT-Bench를 제안한다.
14. A Reference Experiment
주장을 뒷받침하려고 작은 실험 두 개를 돌린다. 규모가 작다는 건 논문도 인정하고, 절대값보다 곡선 모양을 보라고 한다.
14.1 Experiment 1: the unified accuracy–budget frontier
needle-in-a-haystack 검색이다.
Wikitext에서 뽑은 채움 텍스트에 key-value needle을 10~90% 깊이에 심고, 2k~8k 토큰 맥락에서 값을 묻는다.
Qwen2.5-1.5B로 KV 압축 방법 여섯 개를 비교한다. SnapKV, StreamingLLM, TOVA, Knorm, expected-attention, 그리고 무작위 축출 대조군. 생성은 총 1,395회다.
공통 축으로 BPT(bytes-per-token-of-history)를 쓴다. 남긴 메모리 바이트를 원본 맥락 토큰 수로 나눈 값이다.
실제 그래프에서는 이걸 전체 KV 캐시 대비 비율(%)로 정규화해서 그린다. 그래서 서로 다른 방법을 다 같은 축에 놓을 수 있다.
- 토큰 비율
f를 남기는 축출 :f b비트 양자화 :b/16n토큰을m으로 줄이는 요약 :m/n
Figure 5는 가로축이 BPT 예산(전체 캐시 대비 %), 세로축이 needle 정확도다.
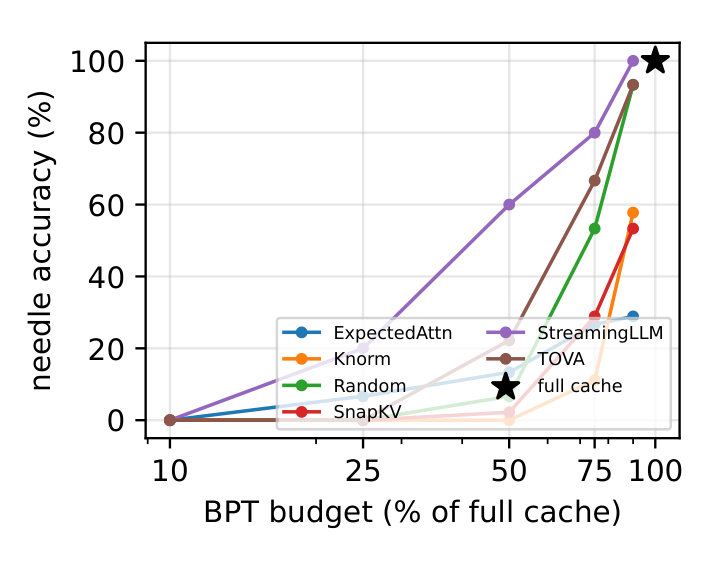
전체 캐시는 정확도 1.00으로 다 맞힌다. 예산이 줄면 방법들이 0으로 떨어지고, 전체 예산의 대략 1/4 아래에서는 모든 방법이 0 근처다.
needle 태스크는 필요한 정보가 토큰 몇 개에 몰려 있어서, 예산이 그 아래로 내려가면 어떤 방법도 답을 복구할 수 없다.
논문은 무작위 축출 대조군이 예산이 높을 땐 운으로 needle을 지켜서 괜찮다가, 예산이 좁아지면 제일 빨리 무너진다고 한다. 진짜 방법이랑 무작위 사이 간격이 그 방법의 점수 매기기가 벌어오는 몫이다.
-> 그런데 그림에서는 75%, 50% 예산에서 SnapKV(빨강)와 Knorm(주황)이 무작위(초록)보다 아래에 있다. 이 그림만으로는 무작위가 제일 먼저 무너진다고 읽히지 않는다.
다만 이 규모에서는 그 간격이 크지 않고, 방법들 순위도 요점에서 벗어난다. BPT 축으로 비교할 수 있게 된다는 게 요점이라고 한다.
14.2 Experiment 2: error accumulation under repeated compaction
이쪽은 단일 턴 벤치마크로는 못 돌리는 실험이다.
에이전트가 긴 문서를 덩어리로 읽으면서 곳곳에 흩어진 key-value 사실 열두 개를 모으고, 주기적으로 작업 메모리를 압축한다. 압축 횟수를 늘려가면서 두 가지를 비교한다.
- 비가역 : 작업 메모리를 LLM이 만든 요약으로 덮어씀
- 가역 : 덩어리를 전부 아카이브에 두고 질의할 때 관련 덩어리를 꺼냄 (Quest와 MemGPT 아카이브 방식)
마지막에 열두 사실을 전부 물어서 recall을 잰다.
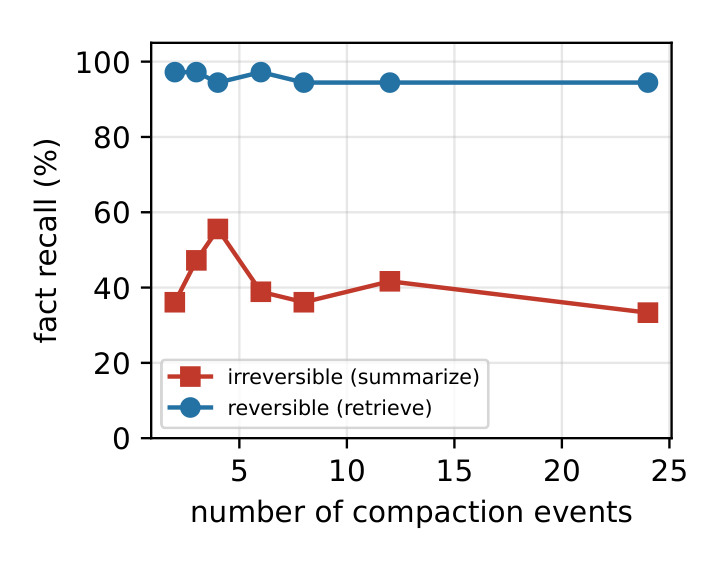
가역은 모든 압축 빈도에서 recall 0.95 근처를 유지한다. 검색으로 버려진 사실을 다시 꺼낼 수 있어서다.
비가역은 0.33~0.56 사이로 한참 아래고, 압축 빈도가 가장 높을 때 제일 낮다. 요약할 때마다 다음 요약이 못 보는 사실이 빠지고 그게 계속 쌓인다.
논문은 평균 예산이 같은 두 방식이 메모리를 재사용하는 구간에서 recall 0.5가량 차이 난다고 한다. 그런데 단일 턴 needle 테스트로는 이 둘을 구분할 수 없다.
-> 여기서 같은 예산은 모델이 매번 읽는 작업 메모리 크기를 말하는 것 같다. 아카이브를 쌓아 두는 저장 공간은 이 예산에 안 들어간다. 논문에 따로 적혀 있지는 않다.
-> 요약을 반복하면 정보가 빠진다는 건 감으로는 알았는데, 숫자로 보니까 차이가 꽤 크다.
15. Open Problems and Research Agenda
첫 번째 과제로 모든 층에서 질의를 보고(P-q), 되돌릴 수 있고(P-rev), 다중 충실도(P-fid)인 압축을 만드는 것을 꼽는다.
무엇을 버렸는지 추적하고 압축 때문에 틀릴 것을 미리 알려주는 방법도 과제로 든다.
16. Conclusion
conclusion 부분을 보면 네 층을 하나의 틀로 보면 세 가지를 얻는다고 한다. 같은 예산 축 위에서 KV 축출기와 에이전트 요약기를 비교할 수 있고, 질의를 모른 채 되돌릴 수 없게 버리는 실패가 모든 층에서 같다는 걸 보고, 한 층의 기법을 다른 층으로 옮길 수 있다.
실험으로는 같은 예산이면 가역이 비가역을 이긴다는 걸 보였다. 그리고 네 층을 하나의 예산 축으로 묶어서 반복 압축을 재는 벤치마크가 아직 없어서, COMPACT-Bench를 제안하면서 끝난다. 공통 축이 생기기 전까지 이 통합은 검증된 과학이 아니라 틀 짜기에 머문다고 스스로 말한다.
KV 압축, 프롬프트 압축, 에이전트 요약을 하나의 예산 축 위에 올려놓고 되돌릴 수 있느냐로 비교한 서베이다.
17. 지금 관점: 메모리를 줄일 때 해볼 만한 것
이 논문에서 가져갈 건 되돌릴 수 있게 만들라는 것 같다.
LongMemEval에서 세션을 사실 단위로 압축하면 전체 성능이 떨어졌던 것도, 이 논문 틀로 보면 질의를 알기 전에 되돌릴 수 없게 버린 경우다. 서베이에서는 Forgetting 기준을 time/frequency/importance 셋으로 나눴는데, 이 논문은 무엇을 기준으로 버리느냐보다 버린 걸 다시 꺼낼 수 있느냐를 먼저 본다.
-> 요약으로 덮어쓰지 말고 원본을 남겨두면 되는 건가? 저장 공간은 더 들지만 이 실험 기준으로는 recall 0.5 차이다.
대화 기록을 최근 몇 턴만 남기고 자르는 시스템이라면, 자른 부분을 버리지 말고 아카이브로 옮기는 정도는 해볼 만한 것 같다.
이런 턴 자르기도 BPT처럼 바이트로 재면 KV 압축이나 요약이랑 같은 그래프에 올려볼 수 있겠다. 최근 건 원문, 오래된 건 요약, 요약 뒤에는 원문 포인터를 남기는 식이면 P-fid에서 말하는 다중 충실도와도 맞는다.
그래도 걸리는 점이 있다.
실험 규모가 작다. Qwen2.5-1.5B에 1,395회 생성, 사실 열두 개다. 가역이 이긴다는 방향은 믿을 만한데, 0.5라는 크기는 다른 데이터에서 다시 재봐야 알 것 같다.
가역은 저장 비용이 든다. 아카이브를 유지해야 하고, 개인정보 삭제 요청이 오면 되돌릴 수 있다는 게 오히려 부담이 된다.
뒤에서 볼 ReFind는 원본 대화를 그대로 두고 검색만 하는 쪽이라, 가역 쪽 얘기가 다시 나온다.
다음은 ReFind다. 원본 대화 로그를 그대로 두고 BM25 검색만 에이전트가 잘 돌리게 했더니 구조화 메모리 시스템들보다 잘 나왔다는 논문이다.
Leave a comment