
MemFail Paper review
MemFail: Stress-Testing Failure Modes of LLM Memory Systems
https://arxiv.org/abs/2605.26667
MemFail은 UC Berkeley에서 만든 메모리 시스템 진단 벤치마크이다. 2026년 5월 arXiv에 올라왔다.
메모리 시스템을 요약·저장·검색 세 연산으로 나눠서, 틀린 답이 어느 단계에서 나왔는지 찾아낸다.
앞의 열여섯 편에서는 시스템들이 얼마나 잘하는지를 봤다. 이 논문은 어디서 실패하는지를 본다.
기존 벤치마크는 QA 정확도를 합쳐서만 보고하고 메모리 시스템을 블랙박스로 다룬다고 한다. 그래서 틀린 답이 시스템의 어떤 실패 때문인지 알 수가 없다.
앞에서 본 Anatomy 리뷰가 평가가 제대로 된 건지를 따졌다면, 이 논문은 진단 도구를 만든다.
1. Introduction
메모리 시스템의 압축·갱신·망각 장치가 오히려 새로운 실패를 만든다고 한다. 요약하다가 중요한 내용을 지우거나, 모순되는 새 사실이 들어와도 옛 사실을 안 지우는 식이다.
네 시스템을 돌려보면 모든 과제에서 이기는 시스템은 없고, 시스템마다 실패하는 모양이 다르다고 한다.
2. Related Work
MemGPT, MemoryBank, Mem0, A-MEM 같은 메모리 시스템과 LoCoMo, MemBench 같은 메모리 벤치마크를 정리한다.
이 시스템들이 결국 요약·저장·검색이라는 같은 연산을 쓰고, 기존 벤치마크는 실패를 연산별로 나누지 않는다고 한다.
3. Background
3.1 Three Operations of a Memory System
메모리 시스템을 요약(summarization), 저장(storage), 검색(retrieval) 세 연산을 이어 붙인 것으로 본다.
3.2 Failure Modes
연산마다 나오는 실패가 있다.
- Summary failure : 요약하다가 중요한 정보를 지우거나 망가뜨림
- Storage failure : 새 정보를 제대로 반영하지 못함
- Retrieval failure : 관련 메모리를 못 꺼내거나, 의미는 비슷하지만 맥락상 안 맞는 걸 꺼냄
- Reasoning failure : 맞는 메모리를 꺼냈는데도 판단을 틀림
1번 예시로 “I am deathly allergic to peanuts”가 “allergic to peanuts”로 압축되는 경우를 든다. 땅콩 알레르기가 있다는 사실은 남았는데 “죽을 수도 있다”는 심각도가 빠져서, 뒤에서 추론할 때 필요한 정보가 사라진다.
2번은 두 가지다.
- 오래된 사실을 안 덮어씀 : 사용자가 “Dan은 이제 피자를 싫어한다”고 했는데 “Dan likes pizza”를 그대로 둠
- 같이 있어도 되는 사실을 거절 : “Dan likes burgers”를 저장된 “Dan likes pizza”와 모순이라고 보고 안 넣음
앞에서 본 Mem0 리뷰의 DELETE 위험은 뒤의 Task 2에서 말하는 경우에 더 가깝다. 같이 있어도 되는 두 사실을 모순으로 보고 옛 사실을 덮어쓰는 것(“overwrite the older fact”)이다. 모순이라고 판단한 게 틀렸을 때 생긴다.
4번은 메모리 시스템 바깥의 실패라서 참고용으로 재기만 한다.
기존 연구는 긴 대화 이력을 넣고 사용자 성격이나 선호를 추론하게 하면서, 이 네 가지를 섞어서 평가하고 구분하지 않았다고 한다.
3.3 Compatibility with Existing Memory Systems
세 함수만 노출하면 평가할 수 있게 만들었다.
store_conversation(H)
retrieve_memories(Q, H, k)
get_all_memories()
get_all_memories는 채점할 때 쓴다. 필요한 메모리가 저장소에 아예 없으면 저장 실패로 가른다.
4. Benchmark Details
다섯 데이터셋을 네 과제로 묶었다. 과제마다 실패 모드 하나를 일부러 노린다.
Task 1: Conditional-Facts
요약 실패를 노린다.
“엔티티 E는 조건 C를 만족할 때만 행동 B를 한다”는 규칙을, 같은 엔티티에 대한 상관없는 무조건 사실 4~7개와 함께 5~8문장 에세이에 넣는다.
질문은 특정 상황 X에서 E가 B를 할지 묻는다. 요약하면서 C를 빼고 “E does B”로 저장한 시스템은 X와 상관없이 “예”라고 답한다.
변형이 두 개다.
- Easy : 규칙 전체가 한 문장에 있음. 문장을 그대로 복사하는 시스템은 맞힘
- Hard : 규칙을 떨어진 세 문장(행동, 조건, 연결)으로 쪼개서 8~12문장 에세이에 흩어놓음
Easy와 Hard가 같은 엔티티와 조건을 쓴다. 그래서 성능 차이는 규칙이 흩어진 방식 때문이라고 볼 수 있다.
예시(Easy) : “Sylas는 협상을 막 끝냈을 때만 정교한 지도를 그린다.”
질문 : “Sylas가 방금 조용히 명상을 했고 협상은 안 했다. 지금 정교한 지도를 그릴까?”
정답 : 아니오
Task 2: Coexisting-Facts
저장 + 검색 실패를 노린다.
요즘 메모리 시스템은 들어오는 정보를 기존 DB와 적극적으로 맞춘다. 그러다 보니 같이 있어도 되는 두 사실(“사용자는 피자를 좋아한다”, “사용자는 라멘을 좋아한다”)을 모순으로 보고 이전 사실을 덮어쓰는 실패가 생길 수 있다.
100개 선호 범주에서 범주마다 N ∈ {2,3,4,5}개 선호를 각각 따로 된 1인칭 문장으로 넣고, N개가 전부 필요한 질문을 던진다.
예시 : 모자 스타일. “페도라를 즐겨 쓴다”, “비니가 추운 날 기본”, “버킷햇은 화창한 주말용”.
질문 : “날씨가 뒤섞인 일주일 여행을 싸는데, 모든 경우를 커버하려면 어떤 모자를 가져가야 할까?”
정답 : 페도라, 비니, 버킷햇
Task 3: Persona-Retrieval
논문은 이 과제가 저장 실패를 노린다고 쓴다. 다른 사람에 대해 물었을 때 저장된 엉뚱한 프로필을 꺼내오는지 본다.
이름 있는 엔티티 E에 대한 10~15문장 에세이에 특이한 사실 4~5개를 넣고, 질문을 두 가지로 50/50 섞는다.
- 직접 질의 : E를 지목. 에세이 내용으로 답할 수 있음
- 오도 질의 : 상관없는 인물 D를 지목. 모른다고 하는 게 정답
예시 : 에세이에 Yuki Tanaka가 갑각류를 안 먹는다고 나온다.
오도 질의 : “Noah Brooks는 갑각류를 먹나?” → “정보가 없다”
앞에서 본 SYNAPSE 리뷰의 “dog 질의가 의미적으로 가까운 Rex와 매칭돼 환각”과 같은 종류의 실패다.
Task 4: Long-Hop
검색 실패를 노린다.
K ∈ {1,2,3} 홉짜리 이어지는 사슬을 만든다. 기분, 루틴, 의견, 개인 물건처럼 주관적인 것들이라 세계 지식만으로는 답할 수 없다.
평가할 때 각 사실을 메모리 시스템에 하나씩 따로 준다. 한 대화에서 읽어내는 게 아니라 흩어진 저장소에서 사슬을 찾아서 이어야 한다.
예시(K=3) : “아침 에스프레소를 마시면 엄마에게 전화한다” / “엄마에게 전화한 뒤엔 당일치기를 계획한다” / “당일치기를 계획하면 간식을 챙긴다” / “간식을 챙기면 풍경 사진을 찍는다”
질문 : “아침 에스프레소를 마시면 마지막엔 뭘 하게 되나?” (보기 5개 중 고르기)
정답 : 풍경 사진을 찍는다
5. Experimental Setup
Mem0, A-MEM, SimpleMem, StructMem 네 시스템을 평가한다.
앞 두 개는 앞에서 리뷰했다. SimpleMem은 엔트로피 기반 필터링으로 의미 손실 없이 압축하고 검색을 상황에 맞게 조절하는 방법이고, StructMem은 이벤트 단위 계층 구조를 만들고 주기적으로 의미 통합을 하는 그래프 기반 방법이다.
답하는 모델과 채점 모델은 gpt-5-mini로 고정한다. 메모리 시스템 내부 모델이 아니라 메모리를 받아서 답하는 LLM이다. 그래서 시스템 간 차이는 메모리 시스템 때문이라고 볼 수 있다.
채점도 검증했다. 사람이 채점한 100개 예시에서 gpt-5-mini가 98%를 맞혔고, 오류 유형은 98.4% 맞게 분류했다고 한다.
-> 오류 유형은 질문마다 필요한 메모리 N개를 하나씩 분류하는 방식이라, 98.4%는 100개 예시보다는 메모리 개수가 분모인 것 같다. 100개로는 98.4%가 안 나온다.
6. Experiments
Q1: How does performance scale with k, the number of retrieved memories?
검색 개수 k를 늘리면 어떻게 되는지 본다.
MEMFAIL은 최신 시스템에도 어렵고, k를 늘려도 성능이 잘 안 오른다. Coexisting-Facts만 예외인데, 많이 꺼내면 같이 있는 사실이 우연히라도 걸릴 확률이 커지기 때문이다.
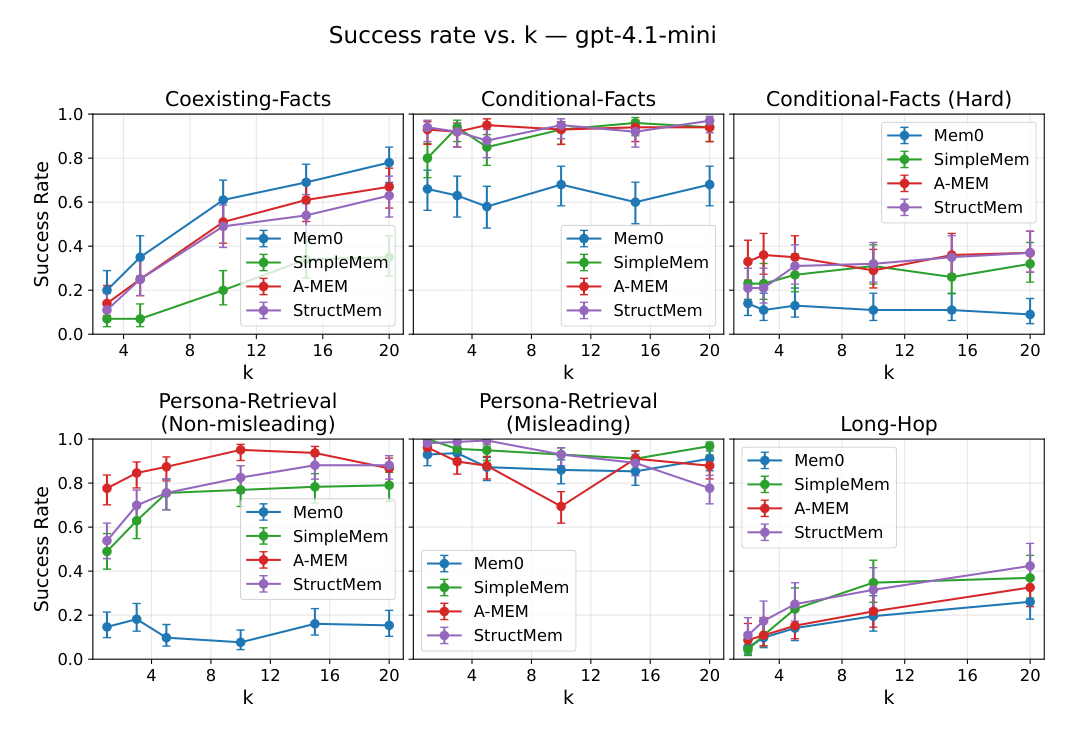
메모리 시스템 내부 모델을 GPT-4.1-mini로 두고 k를 바꿔가며 잰 그림이다.
칸이 과제별이고 선 색이 시스템이다. 오차 막대는 95% Wilson 구간이다.
논문은 StructMem이 대부분 과제에서 잘하는데 Coexisting-Facts에서 크게 무너지고, Mem0은 반대 패턴이라고 쓴다.
-> 그런데 이 그림에서 Coexisting-Facts 최하위는 SimpleMem(초록)이고 StructMem(보라)은 Mem0, A-MEM 다음이다. 본문 설명과 그림이 딱 맞지는 않는다.
과제별로 실패가 갈린다.
- Coexisting-Facts : 검색 실패. 대부분 시스템이 관련 사실을 전부 질문과 연결하지 못함
- Conditional-Facts (Hard) : 요약 실패. 모든 시스템이 너무 많이 압축해서 원래 메시지를 바꾸거나 세부를 뺌
- Persona-Retrieval : 요약 실패(긴 페르소나를 과하게 압축). Mem0만 예외로 처음부터 세부를 다 저장하지 못함
- Long-Hop : 검색 실패. 멀어 보이는 엔티티 사이의 인과 관계를 못 잡음
-> Persona-Retrieval은 4장 Task 3 설명에서 저장 실패를 노린다고 했는데, 결과는 요약 실패가 대부분이고 저장 실패는 Mem0에서만 나왔다. 논문도 이 차이를 따로 설명하지는 않는다. 엉뚱한 사람 프로필을 꺼내는 건 검색 쪽 실패 같기도 한데 왜 저장 실패를 노린다고 했는지??
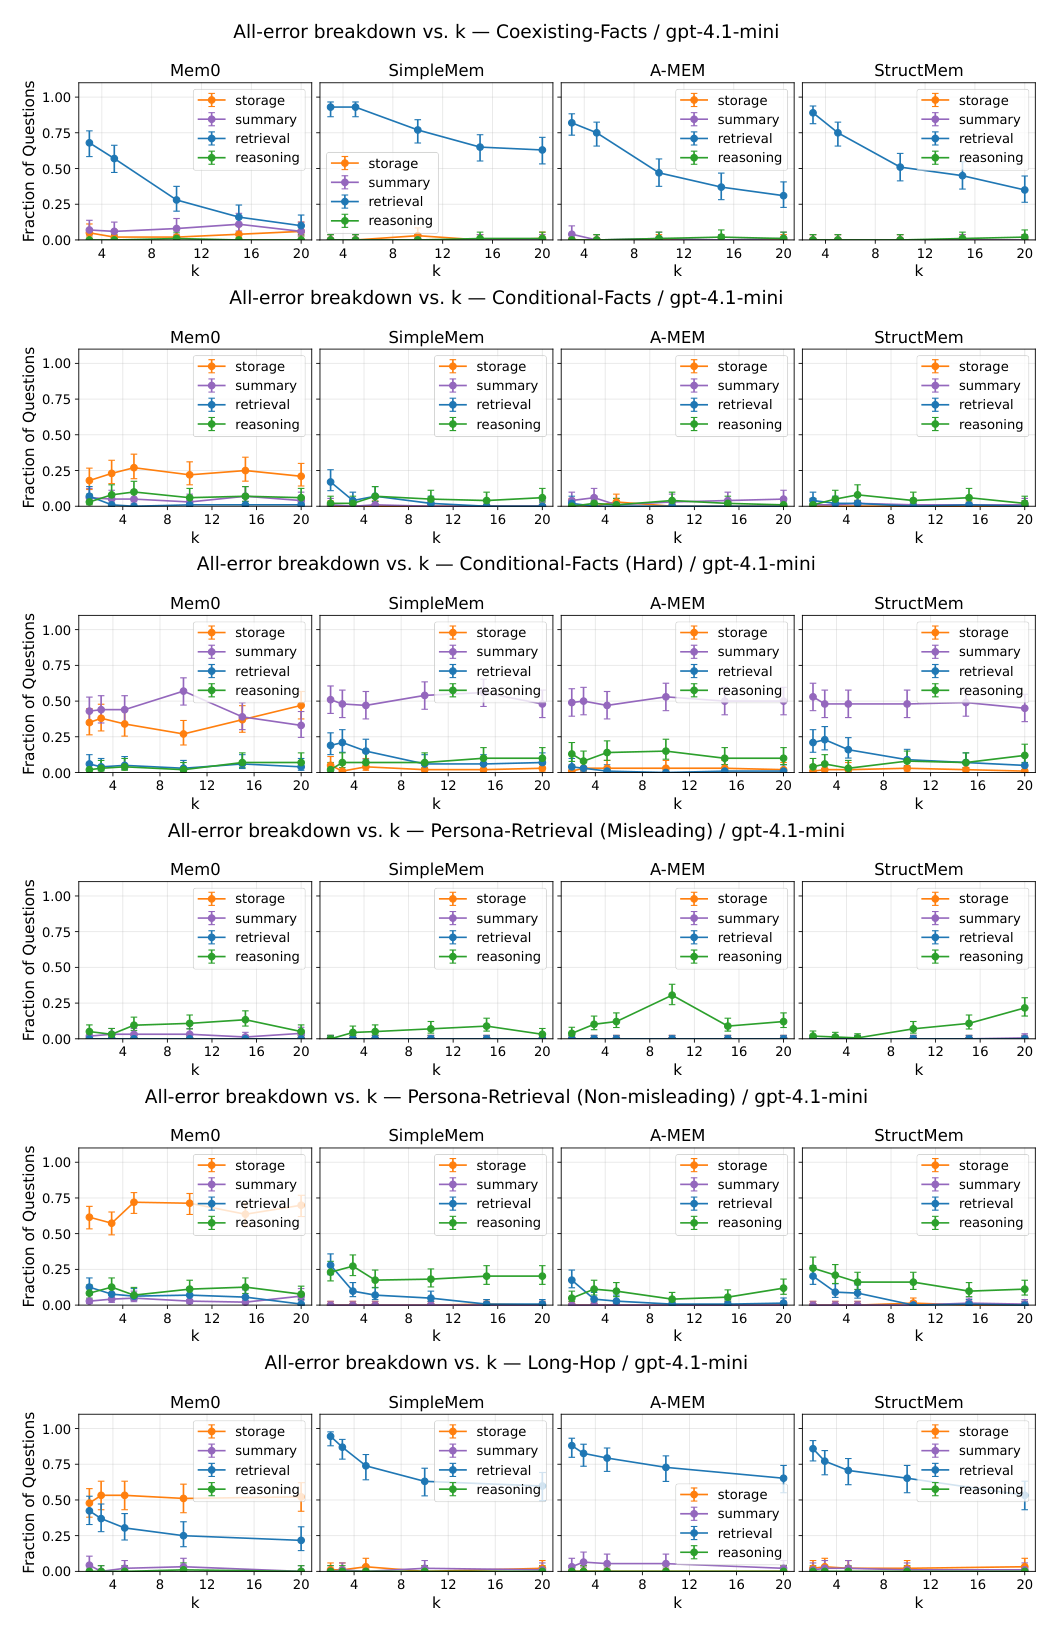
부록에 있는 오류 분류 그림이다. 줄이 과제, 칸이 시스템이고, 선 색이 storage·summary·retrieval·reasoning 오류 비율이다.
Coexisting-Facts와 Long-Hop은 Mem0을 빼면 파란 retrieval이 제일 위에 있고, Conditional-Facts (Hard)는 보라 summary가 제일 위에 있다.
논문은 Mem0 말고는 저장 실패가 거의 없고, 실패는 거의 다 요약이나 검색에서 나왔다고 정리한다. Mem0은 LLM 도구 호출로 메모리를 갱신하는데, 긴 에세이에서는 도구 호출을 충분히 안 해서 세부를 빠뜨린다.
검색 개수를 늘리면 검색 오류가 많은 과제에서는 오르고, 요약 오류가 병목이면 별로 안 오른다.
앞에서 본 MemMachine 리뷰에서는 k를 20→30으로 올리면 +4.2%p였는데, 그 이득도 어떤 실패가 병목이냐에 따라 달라질 수 있다.
Q2: How does accuracy scale with the strength of the model used by the memory system?
더 좋은 모델을 쓰면 어떻게 되는지 본다.
더 강한 내부 모델을 써도 정확도가 안 오르고, 대부분 과제에서 오히려 떨어지기도 한다고 한다. 더 똑똑한 추론 모델이 메모리를 너무 길게 만들어서 컨텍스트를 오염시킬 수 있다고 본다.
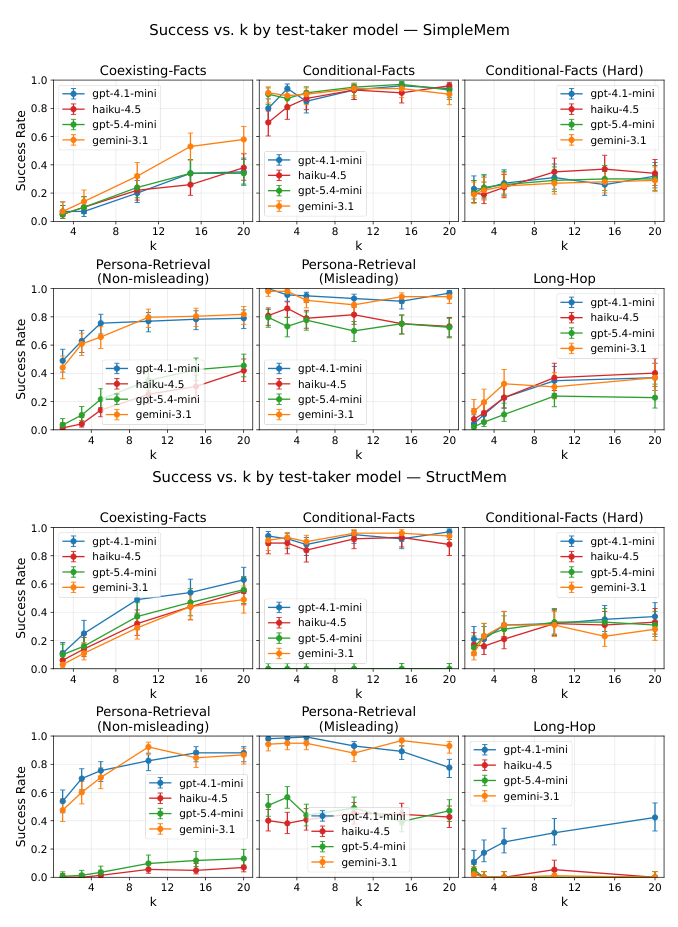
SimpleMem(위)과 StructMem(아래)의 내부 모델을 바꿔가며 잰 그림이다. 선 색이 내부 모델이다.
Mem0과 A-MEM도 같은 경향이라 부록으로 뺐다.
다른 LLM 에이전트 분야는 모델이 좋아지면 벤치마크 성능도 오르는데, 메모리 시스템은 모델보다 구조에 묶여 있다는 게 논문의 해석이다.
앞에서 본 Anatomy 리뷰의 백본 민감도, NEMORI 리뷰의 “휴리스틱이 문제”와 이어진다.
Q3: What does MEMFAIL reveal about the tradeoff between performance and token consumption?
토큰을 더 쓰면 어떻게 되는지 본다.
요약 실패가 병목인 과제(Persona-Retrieval, Conditional-Facts Hard)에서는 메모리에 토큰을 더 쓰면 대체로 성능이 오른다. 반대로 검색 과제는 토큰을 더 쓰면 떨어질 수도 있다.
Coexisting-Facts에서 특히 그런데, 메모리를 크게 저장하면 의미 임베딩이 “오염”돼서 검색이 나빠진다고 한다.
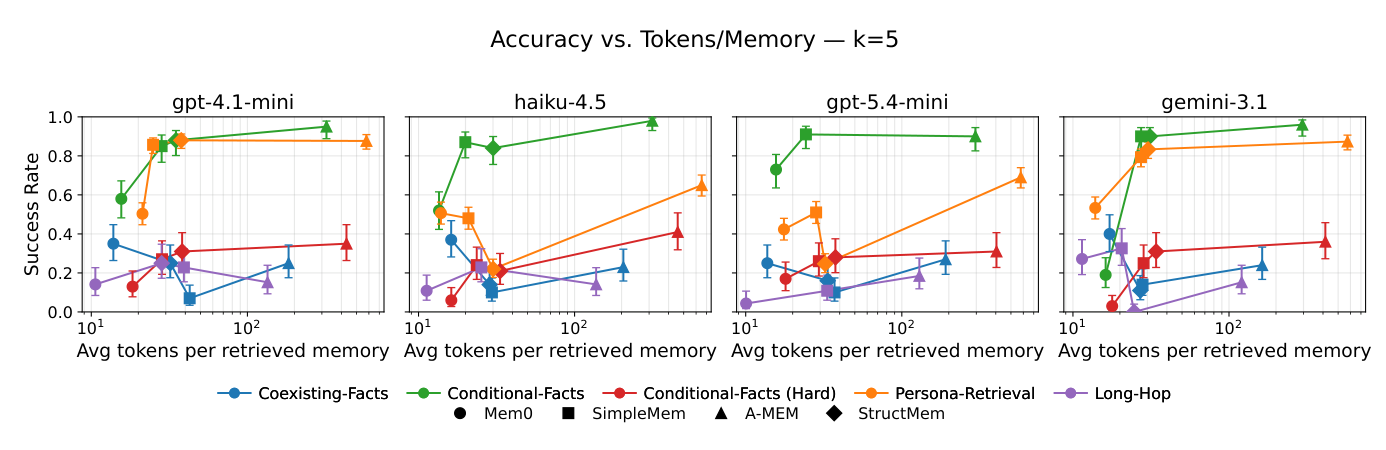
가로축이 검색된 메모리 하나당 평균 토큰 수, 세로축이 성공률이다(k=5). 색이 과제, 모양이 시스템이다.
주황(Persona-Retrieval)을 보면 haiku-4.5, gpt-5.4-mini에서 토큰을 제일 많이 쓰는 A-MEM(세모)이 제일 높다. 요약 과제에서는 토큰이 도움이 된다는 쪽과 맞는다.
그래서 “토큰을 더 쓰면 성능이 오른다”는 건 과제에 따라 다르다. 요약 과제에서는 맞고, Coexisting-Facts 같은 검색 과제에서는 안 맞는다.
그리고 A-MEM은 다른 시스템보다 토큰을 훨씬 많이 쓰는데 검색 위주 과제에서는 그만큼 성능이 안 나온다.
앞에서 본 A-MEM 리뷰에서는 토큰 효율이 좋다고 봤는데(1,200~2,500 vs MemGPT 16,900), 그건 질문할 때 넣는 컨텍스트 기준이었다. 여기서 말하는 건 메모리 하나의 크기라서 두 수치는 다른 걸 잰다.
7. Conclusion
conclusion 부분을 보면, 지금 시스템들은 구조적인 제약에 묶여 있어서 토큰을 더 쓰거나 더 똑똑한 모델을 쓴다고 해결되지 않는다고 한다.
저자들이 아는 한 실패 모드를 세밀하게 분석할 수 있는 첫 벤치마크라고 하고, 앞의 3.3에서 본 API만 구현하면 어떤 메모리 시스템이든 평가할 수 있다. 데이터셋과 평가 코드도 공개했다.
한계도 적어뒀다. MEMFAIL 데이터셋은 전부 LLM으로 만들고(gpt-4.1-mini, gpt-5-mini, gpt-5) 걸렀다. 모든 항목을 사람이 확인했지만, 대화·엔티티·표현이 실제 서비스 환경보다 좁을 수 있다. 그래서 MEMFAIL 점수는 특정 실패에 대한 진단 신호로 봐달라고 하고, 실제 성능을 예측하는 값으로 보지 말라고 한다. 지연은 재긴 했지만 분석하지 않았다.
정확도 하나로 비교하던 메모리 벤치마크를 요약·저장·검색 단계별 실패로 나눠 본 논문이다.
8. 지금 관점: 메모리 시스템을 붙이기 전에 해볼 테스트
네 과제는 메모리 시스템을 붙이기 전에 테스트 케이스로 그대로 써볼 수 있을 것 같다.
제일 위험해 보이는 건 조건부 사실이다. “X일 때만 Y”를 저장하고 X가 아닌 상황을 묻는 건데, “이 할인은 회원일 때만 적용된다”가 “이 할인이 적용된다”로 요약되면 답이 반대가 된다. “심하게 알레르기”가 “알레르기”가 되는 것과 같은 종류다.
공존 사실은 Mem0의 DELETE나 Zep의 무효화처럼 모순을 정리하는 장치가 있는 시스템에서 따로 봐야 할 것 같다. 같은 범주 선호를 여러 개 따로 말하고 전부 필요한 질문을 던지면 된다.
오도 질의(A에 대해 저장하고 B에 대해 묻기)는 앞에서 본 LongMemEval의 ABS와 같은 얘기다. 다중홉은 사슬의 각 고리를 따로따로 저장해야 의미가 있다.
k를 올릴지 메모리를 크게 만들지는 요약 실패냐 검색 실패냐에 따라 방향이 반대다. 그래서 뭘 바꾸기 전에 틀린 답이 어느 단계에서 나왔는지부터 나눠 봐야 한다.
-> 앞의 시스템 논문들이 낸 좋은 점수 뒤에도 어떤 실패가 섞여 있는지는 이렇게 나눠 봐야 알 것 같다.
다음은 Janus다. 새 메모리를 바로 쓰지 않고 옛 메모리와 비교해서 나은 쪽을 남기는 갱신 컨트롤러다.
Leave a comment