
LongMemEval Paper review
LongMemEval: Benchmarking Chat Assistants on Long-Term Interactive Memory
https://arxiv.org/abs/2410.10813
LongMemEval은 UCLA, Tencent AI Lab Seattle, UC San Diego에서 만든 챗봇 장기기억 벤치마크다. 2024년 10월에 나왔고 ICLR 2025에 붙었다.
이 시리즈 뒤쪽 논문들이 계속 이 벤치마크로 점수를 낸다. 나중에 볼 ReFind도 여기서 평가하고, 뒤에서 볼 서베이(Memory in the Age of AI Agents)에서도 lifelong learning 쪽 대표로 들어가 있다.
벤치마크만 있는 게 아니라, 메모리 시스템을 세 단계와 네 가지 제어점(CP)으로 나눠서 보는 틀도 같이 내놓았다.
1. Introduction
introduction 부분을 보면 기존 장기 대화 벤치마크가 못 보던 게 세 가지라고 한다.
- 여러 세션에 흩어진 정보를 합치는 것
- 어시스턴트가 한 말을 기억하는 것. “네가 지난번에 추천한 식당이 어디였지” 같은 질문
- 바뀐 사용자 정보나 복잡한 시간 표현을 추론하는 것
그리고 기존 벤치마크는 대화 이력이 너무 짧고, 실제 과제를 하는 대화랑은 성격이 다르다고 한다.
2. Related Work
장기 대화 벤치마크(MemoryBank, LoCoMo, PerLTQA, DialSim 등)와 장기 메모리 방법을 정리한다. 기존 벤치마크와의 비교는 아래 표다(논문 Table 1). Context Depth 열이 대화 이력의 토큰 수이고, 오른쪽 다섯 열이 벤치마크가 보는 메모리 능력이다.
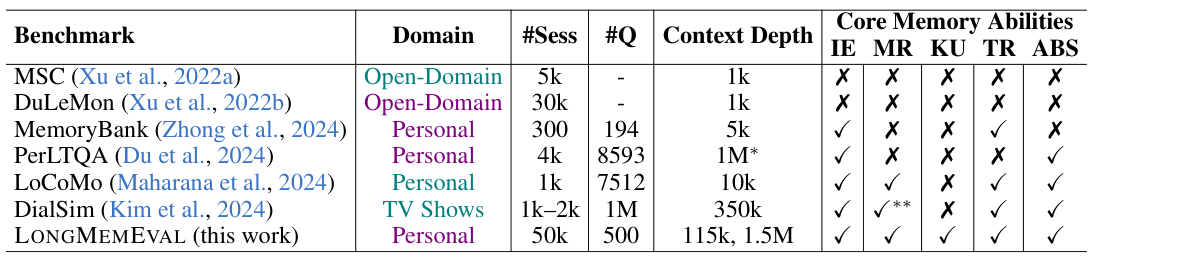
KU(knowledge update)까지 다섯 능력을 전부 보는 건 LongMemEval뿐이다.
3. LongMemEval
벤치마크 설계부터 보자.
3.1 Problem Formulation
평가 단위는 (S, q, t_q, a) 네 개다. 타임스탬프가 붙은 이력 세션 S를 시스템에 하나씩 넣고, 마지막 세션 뒤 날짜 t_q에 질문 q를 던져서 답 a와 비교한다.
3.2 LongMemEval: Benchmark Curation
장기기억을 다섯 가지 능력으로 나눈다.
- IE (Information Extraction) : 긴 이력에서 특정 정보 찾기, 사용자·어시스턴트 발화 모두 포함
- MR (Multi-Session Reasoning) : 여러 세션 정보를 합쳐서 답하기, 집계·비교 질문
- KU (Knowledge Updates) : 사용자 정보가 바뀐 걸 알고 갱신하기
- TR (Temporal Reasoning) : 대화 속 시간 표현이랑 타임스탬프 메타데이터 둘 다 이해하기
- ABS (Abstention) : 이력에 없는 걸 물으면 “모른다”고 답하기
ABS가 따로 있는 게 좋았다. Table 1을 보면 기존 벤치마크 중 ABS를 재는 건 PerLTQA, LoCoMo, DialSim 셋뿐이다.
-> 실제로 챗봇을 만들어보면 없는 기억을 지어내는 게 더 문제다.
다섯 능력을 재려고 질문 유형을 일곱 개 만들었다.
- single-session-user : 한 세션 안에서 사용자가 말한 정보
- single-session-assistant : 한 세션 안에서 어시스턴트가 말한 정보
- single-session-preference : 사용자 정보를 써서 개인화 응답 만들기
- multi-session : 둘 이상 세션에 걸친 정보 집계
- knowledge-update : 사용자 상황이 바뀐 걸 알고 기억 갱신하기
- temporal-reasoning : 타임스탬프랑 시간 표현으로 추론하기
- abstention : 앞 유형에서 30문항을 뽑아서 틀린 전제가 들어간 질문으로 바꾼 것
abstention은 따로 모으지 않고 기존 질문을 틀린 전제로 바꿔서 만들었다. 그래서 같은 이력에서 답이 있는 질문이랑 없는 질문을 짝으로 만들 수 있다.
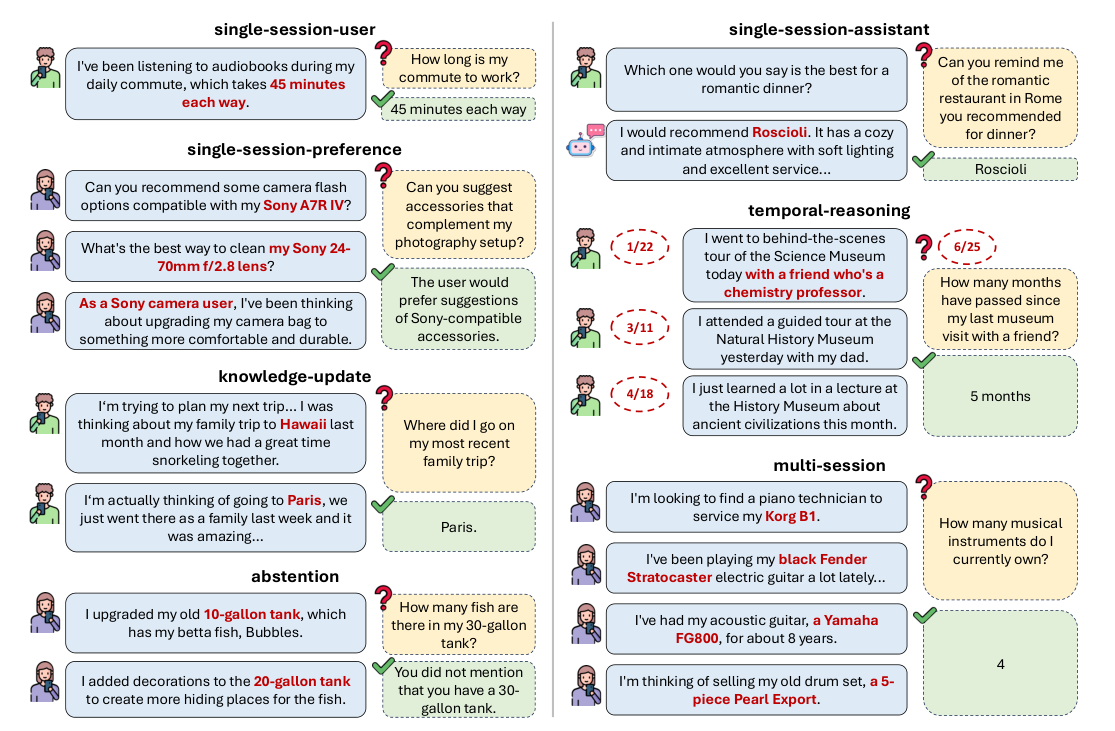
왼쪽이 증거 문장이고 오른쪽이 질문과 정답이다. abstention 예시는 10-gallon, 20-gallon 탱크만 말했는데 30-gallon 탱크를 묻는다.
데이터는 이렇게 만든다.
사용자 속성 164개를 다섯 범주(생활양식, 소유물, 생애 사건, 상황 맥락, 인구통계)로 나눠 정리했다.
속성마다 LLM(Llama 3 70B Instruct)으로 사용자 배경 문단을 만들고, 그걸 증거 문장과 대화 세션으로 늘린다. 문항 500개는 직접 골라 다듬었다.
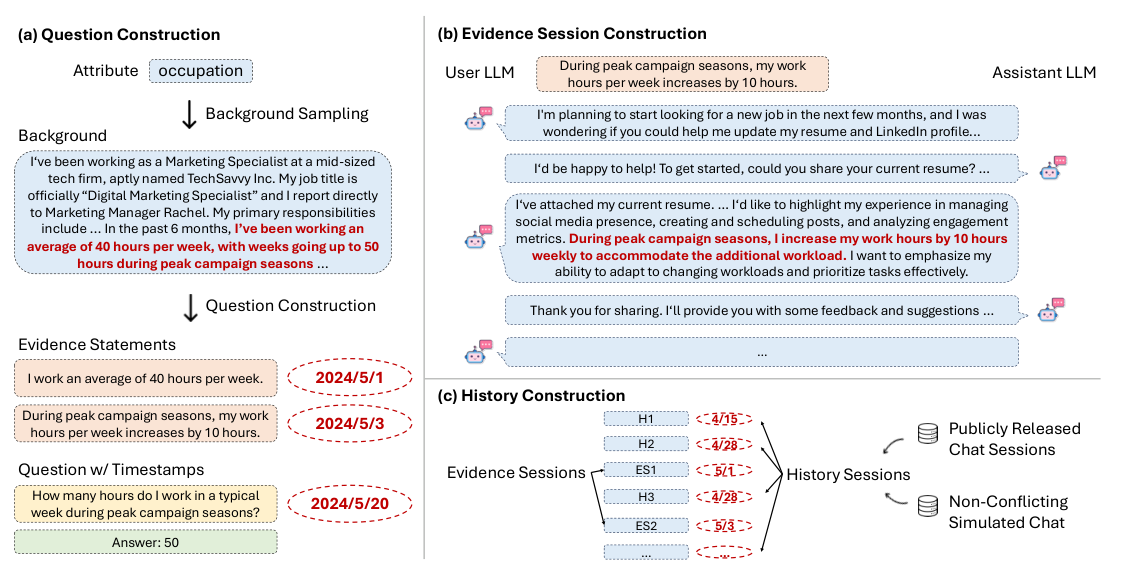
(a) 질문과 증거 문장은 사람이 만들고, (b) 증거 세션은 LLM으로 시뮬레이션한 뒤 사람이 고친다. (c) 전체 대화 이력은 테스트할 때 조립해서 길이를 자유롭게 정할 수 있다.
크기는 두 가지다.
- LongMemEval-S : 문항당 약 115k 토큰
- LongMemEval-M : 500세션, 약 150만 토큰
세션을 더 넣으면 이력을 얼마든지 늘릴 수 있다.
3.3 Evaluation Metric
답 형태가 자유로워서 exact match 대신 gpt-4o로 채점한다. 사람 전문가와 97% 넘게 일치했다고 한다.
답이 있는 위치를 사람이 표시해뒀기 때문에, 시스템이 검색 결과를 보여주면 Recall@k와 NDCG@k도 잴 수 있다.
3.4 LongMemEval represents a significant challenge
사전 평가로 난이도를 먼저 보여준다.
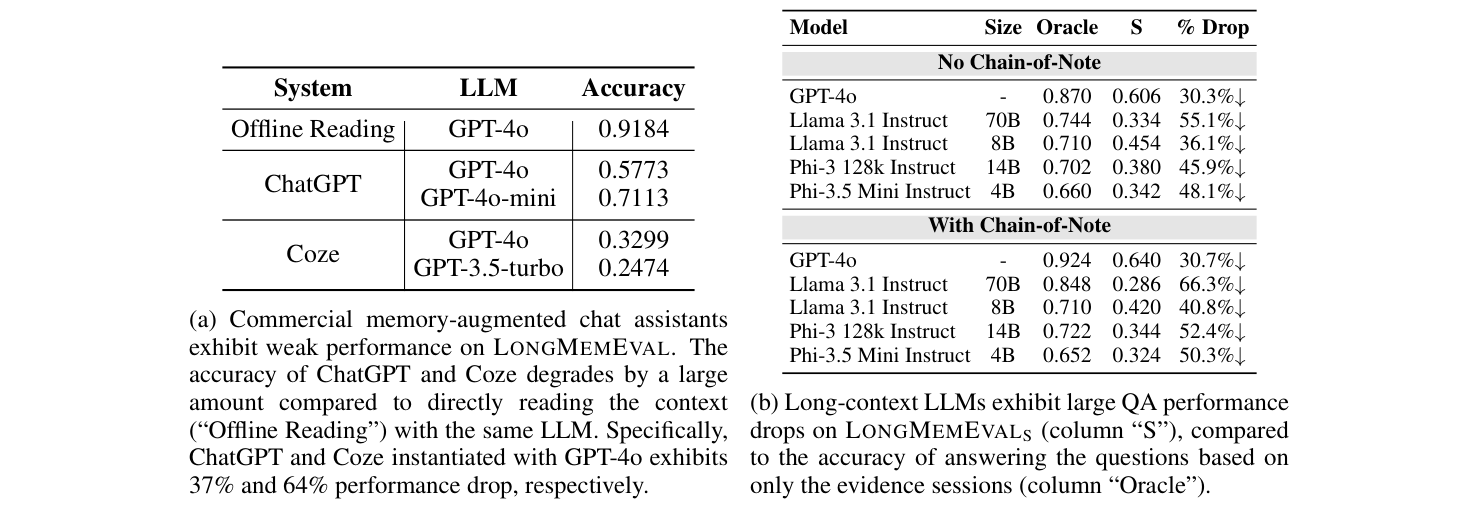
- long-context LLM은 LongMemEval-S에서 성능이 30~60% 떨어진다
- 상용 시스템은 LongMemEval-S보다 훨씬 쉬운 설정에서도 정확도가 30~70%에 그친다
abstract에서는 이걸 한 줄로 요약한다. 대화가 이어지면서 정보를 기억해야 하는 상황에서 정확도가 약 30% 떨어진다고 한다.
4. A Unified View of Long-Term Memory Assistants
4.1 Long-Term Memory System: Formulation
장기 메모리를 큰 key-value 저장소로 본다.
키는 종류가 달라도 된다. 문장, 문단, 사실, 엔티티 같은 텍스트일 수도 있고 모델 내부 표현일 수도 있다. 값은 중복돼도 된다.
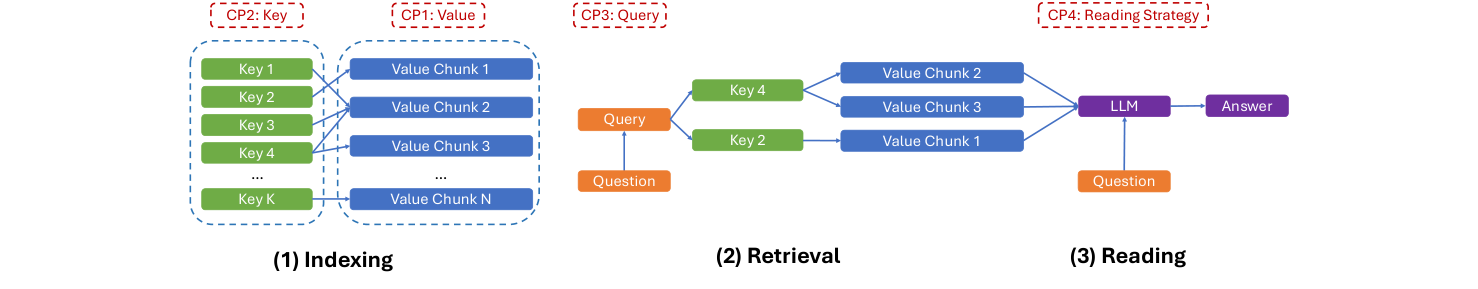
그 위에 세 단계를 둔다.
- Indexing : 이력 세션을 key-value 항목으로 바꾼다
- Retrieval : 검색 질의를 만들고 상위 k개를 가져온다
- Reading : LLM이 가져온 걸 읽고 답을 만든다
기존 메모리 시스템 아홉 개가 전부 이 틀로 표현된다는 걸 표로 보여준다. 맨 아래 Our Design 줄은 기존 시스템이 아니라, 뒤 실험에서 나온 선택을 모은 이 논문의 설계라 아홉 개에 들어가지 않는다.
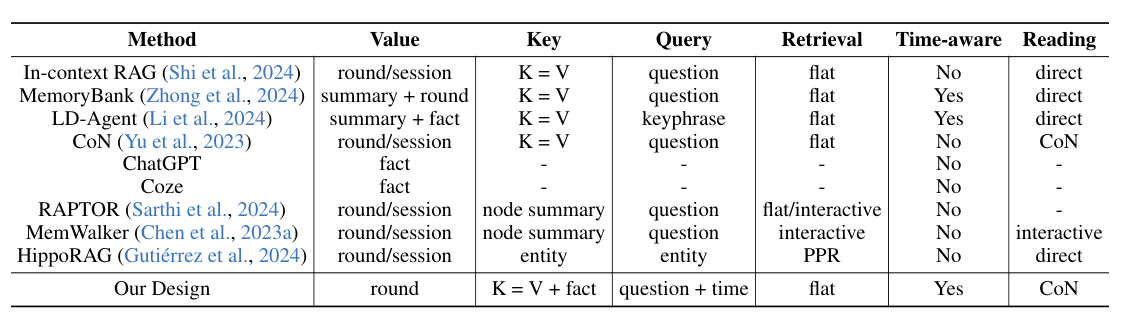
ChatGPT와 Coze는 알 수 없는 설계 항목을 비워뒀다.
4.2 Long-Term Memory System: Design Choices
여기서 설계할 때 정해야 하는 제어점(CP, control point) 네 개를 뽑는다.
CP 1: Value
뭘 한 덩어리로 저장하나. 세션을 통째로 저장하면 길고 주제가 섞여서 검색도 읽기도 어려워진다. 반대로 요약이나 사용자 사실로 줄이면 정보가 빠진다.
CP 2: Key
뭘로 색인하나. 세션을 쪼개고 줄여도 한 항목 안에 정보가 많고, 질문이랑 관련된 건 일부다. 그래서 값을 그대로 키로 쓰는 방식(MemoryBank, LoCoMo)은 최선이 아닐 수 있다.
CP 3: Query
질의를 어떻게 만드나. 단순한 질문은 key-value만 잘 만들면 된다. 그런데 “지난 주말에 네가 추천한 식당”처럼 시간이 들어가면 그냥 유사도 검색으로는 안 된다.
CP 4: Reading Strategy
가져온 걸 어떻게 읽나. 검색을 잘해도 LLM이 긴 컨텍스트를 제대로 읽고 추론한다는 보장이 없다.
5. Experiment Results
제어점마다 실험을 돌려서 설계 지침을 냈다.
5.1 Experimental Setup
GPT-4o, Llama 3.1 70B Instruct, Llama 3.1 8B Instruct 세 모델로 돌린다. 검색기는 Stella V5(1.5B) dense retrieval이고, 색인 단계의 요약·키프레이즈·사실 추출은 Llama 3.1 8B Instruct로 한다.
5.2 Value: Decomposition improves RAG performance
저장 단위는 세션보다 라운드가 낫다고 한다(CP 1). 라운드는 사용자 메시지 하나와 그에 대한 어시스턴트 응답 하나를 묶은 단위다.
라운드에서 사용자 사실까지 더 쪼개면 정보가 빠져서 전체 성능은 떨어지는데, multi-session 추론 정확도는 올라간다.
잘게 쪼갤수록 여러 세션을 엮는 추론은 좋아지고 전체 성능은 나빠지는 trade-off다.
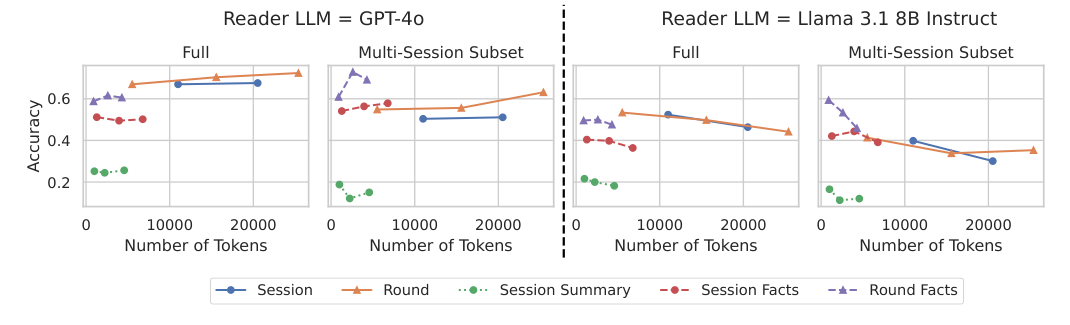
Full과 Multi-Session Subset을 나눠서 토큰 수 대비 정확도를 그렸다. Multi-Session Subset에서는 Round Facts(보라색) 점이 위로 올라간다.
5.3 Key: Multi-key indexing improves retrieval and RAG
키를 사실로 늘리면 검색이랑 QA가 같이 오른다(CP 2).
값을 그대로 키로 쓰는 flat 인덱스도 이미 꽤 강한 베이스라인이다.
여기에 뽑아낸 사용자 사실을 키로 더 붙이면 recall@k가 9.4%, 정확도가 5.4% 오른다. 요약, 키프레이즈, 사용자 사실, 타임스탬프 이벤트를 값에서 뽑아서 검색 경로를 여러 개 만드는 방식이다.
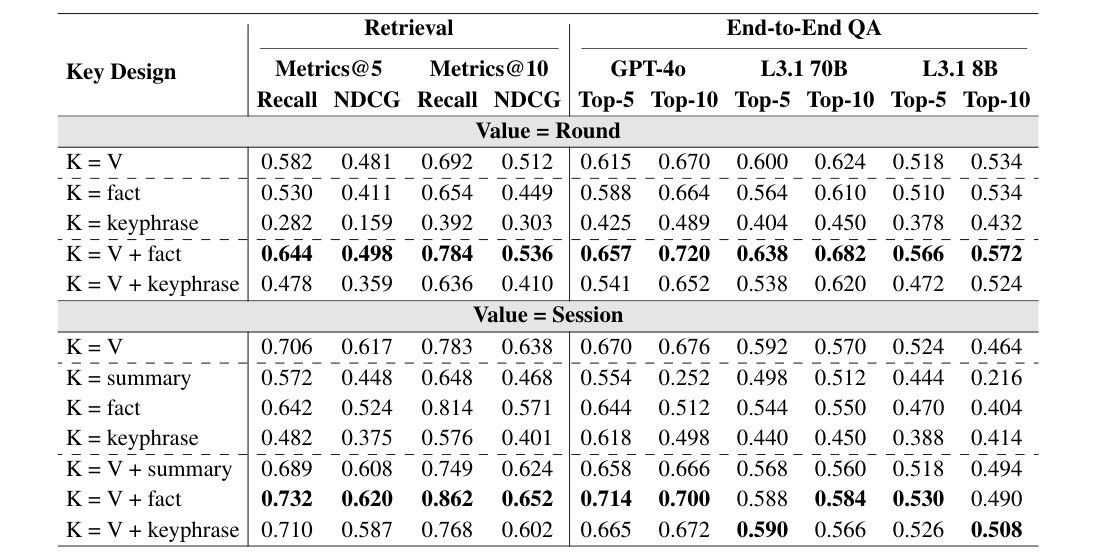
굵게 표시된 K = V + fact 행이 검색과 QA를 같이 올린다. Value = Round에서는 K = fact나 K = keyphrase만 쓰면 검색 지표가 K = V보다 낮다. 값을 키로 그대로 두고 사실을 더해야 오른다.
5.4 Query: Time-aware query expansion improves temporal reasoning
시간을 고려해야 시간 질문을 푼다(CP 3).
값을 타임스탬프 이벤트로 색인하고 검색을 그 시간 범위로 제한하면, temporal reasoning의 recall이 6.8~11.3% 오른다. 단 질의를 늘릴 때 강한 LLM을 써야 그렇다고 한다.
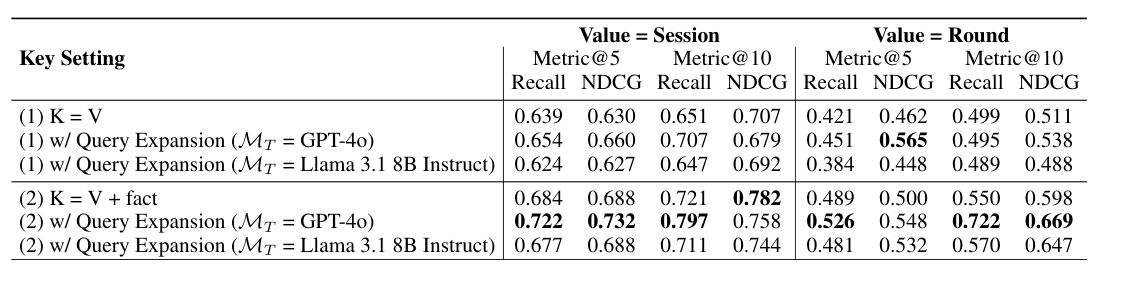
질의 확장 모델을 Llama 3.1 8B Instruct로 바꾸면 K = V보다 낮아지는 칸도 있다.
5.5 Improving reading with chain-of-note and structured format
잘 꺼내도 잘 읽는 건 따로다(CP 4).
검색이 완벽해도 가져온 걸 제대로 쓰는 건 쉽지 않다고 한다.
Chain-of-Note(답하기 전에 필요한 내용을 먼저 뽑음)랑 구조화된 포맷으로 프롬프팅하면 LLM 세 개에서 최대 10점 오른다.
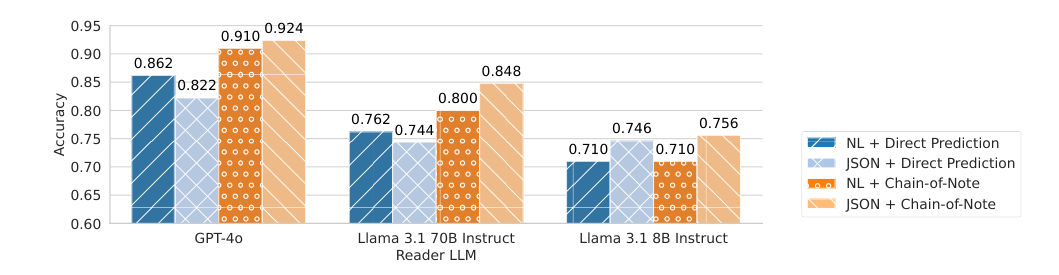
근거 세션만 넣어주는 oracle 설정에서 잰 결과다. 세 모델 모두 JSON 형식에 CoN을 붙인 조합(맨 오른쪽 막대)이 가장 높다. Llama 3.1 8B에서는 JSON + Direct Prediction과 차이가 작다.
-> oracle 설정이라 검색이 완벽할 때 얘기다. 검색까지 붙인 실제 설정에서도 10점이 그대로 나오는지는 이 그림만으로는 모르겠다.
6. Conclusion
장기기억을 다섯 능력(정보 추출, 다중 세션 추론, 시간 추론, 지식 갱신, 회피)으로 나눈 벤치마크와, 메모리 설계를 indexing·retrieval·reading 세 단계 네 제어점으로 나눈 틀을 같이 내놓았다.
상용 시스템이랑 long-context LLM 모두 크게 떨어진다는 걸 보여줬고, 세션 분해, 사실 기반 키 확장, 시간을 고려한 질의 확장이 검색과 QA를 같이 올린다고 한다.
뒤에서 볼 서베이는 메모리를 형태·기능·동역학으로 분류하는데, 이 논문은 구현할 때 정해야 하는 지점으로 나눴다.
7. 지금 관점: 메모리 시스템을 볼 때 확인할 것
벤치마크 자체보다 네 제어점 틀을 더 오래 쓸 것 같다.
새 메모리 시스템이 나오면 “Value를 뭘로 잡았고, Key를 어떻게 늘렸고, 시간은 어디서 처리하고, 읽을 때 뭘 붙였나”로 물어보면 대부분 한 표에 들어간다. 뒤에 나오는 시스템들도 이 네 칸으로 정리해 보려고 한다.
키 확장은 검색을 한 번만 하는 설정에서 잰 결과다. 검색을 여러 번 하는 에이전트라면 키 확장이 하던 일을 반복 검색이 대신할 수도 있을 것 같다. 이건 나중에 볼 ReFind에서 다시 나온다.
바로 가져다 쓸 수 있는 건 CP 4다. 검색을 어떻게 짜든 읽는 단계에 Chain-of-Note랑 구조화 포맷은 붙일 수 있다.
-> 평가할 때는 다섯 능력 중 KU랑 ABS를 먼저 보면 될 것 같다. 바뀐 사용자 정보를 못 따라가거나 없는 걸 지어내는 게 챗봇에서는 더 큰 문제다.
다음은 Zep이다. 사실을 지우지 않고 무효화하는 방식이고, 네 개의 타임스탬프로 무엇이 언제 참이었는지와 언제 그렇게 알았는지를 함께 남기는 지식그래프다.
Leave a comment