
Zep Paper review
Zep: A Temporal Knowledge Graph Architecture for Agent Memory
https://arxiv.org/abs/2501.13956
Zep은 Zep AI에서 만든 에이전트 메모리 시스템이다. 2025년 1월 arXiv에 올라온 논문이다.
사실을 지우지 않고 무효화 표시만 하는 시간 인식 지식그래프로 메모리를 만든다.
모순된 기억을 지워버리면 그 판단이 틀렸을 때 복구할 방법이 없는데, 여기서는 지우지 않고 푼다. 지우는 쪽은 뒤에서 볼 Mem0에서 나온다.
1. Introduction
RAG의 한계에서 시작한다.
기존 RAG는 정적인 문서 검색에 묶여 있는데, 기업 서비스는 진행 중인 대화나 비즈니스 데이터처럼 계속 바뀌는 정보를 합쳐서 써야 한다고 한다.
그래서 만든 게 Graphiti다. 비정형 대화 데이터랑 정형 비즈니스 데이터를 같이 넣으면서 과거 관계도 남겨두는 시간 인식 지식그래프 엔진이다.
2. Knowledge Graph Construction
메모리를 시간 인식 지식그래프 G = (N, E, φ)로 두고, 서브그래프 세 층으로 쌓는다.
첫 번째 층은 Episode Subgraph G_e다.
에피소드 노드에 메시지, 텍스트, JSON 같은 원본 입력을 그대로 담는다.
“Episodes serve as a non-lossy data store from which semantic entities and relations are extracted.”
원본을 손실 없이 보관하고, 거기서 엔티티랑 관계를 뽑는다. 추출이 틀려도 에피소드로 돌아가면 된다. 원본을 남기느냐는 나중에 볼 Rate-Distortion 논문에서 다시 나온다.
두 번째 층은 Semantic Entity Subgraph G_s다.
에피소드에서 뽑은 엔티티를 기존 그래프 엔티티랑 맞춰(resolve) 노드로 두고, 엔티티끼리 관계를 엣지로 잇는다.
세 번째 층은 Community Subgraph G_c다.
제일 위층이다. 서로 많이 연결된 엔티티들을 커뮤니티 노드로 묶는다.
에피소드 → 엔티티 → 커뮤니티로 올라가면서 점점 요약된 층이 쌓인다. 뒤에서 볼 서베이(Memory in the Age of AI Agents)에서도 이런 계층형 구조의 예로 Zep을 든다.
2.1 Episodes
에피소드는 message, text, JSON 세 종류인데, 이 논문은 대화 실험이라 message만 다룬다. 메시지마다 보낸 시각 t_ref가 붙어 있어서 “next Thursday” 같은 상대 날짜를 풀 수 있다고 한다.
2.2 Semantic Entities and Facts
엔티티와 사실을 뽑은 다음 시간 정보를 붙인다.
2.2.1 Entities
현재 메시지와 직전 메시지 4개를 같이 보고 엔티티를 뽑는다. 이름 임베딩과 전문 검색으로 기존 엔티티 후보를 찾고, LLM이 같은 엔티티인지 판단한다.
2.2.2 Facts
엔티티 사이의 사실을 엣지로 뽑는다. 중복 제거는 같은 엔티티 쌍 사이의 엣지 안에서만 찾아서 계산량을 줄인다.
2.2.3 Temporal Extraction and Edge Invalidation
논문은 이 부분이 Graphiti가 다른 지식그래프 엔진이랑 다른 점이라고 한다.
에피소드에서 사실의 시간 정보를 뽑는다. 절대 시각(“Alan Turing was born on June 23, 1912”)이랑 상대 시각(“I started my new job two weeks ago”) 둘 다 다룬다.
양시간(bi-temporal)으로 타임스탬프 네 개를 둔다.
t'_created: 시스템에 사실이 생긴 시각t'_expired: 시스템에서 사실이 무효화된 시각t_valid: 사실이 참이 되기 시작한 시각t_invalid: 사실이 더 이상 참이 아니게 된 시각
앞의 둘은 트랜잭션 타임라인(시스템이 언제 그렇게 알았나), 뒤의 둘은 유효 타임라인(실제로 언제 참이었나)이다. 이 넷이 엣지에 사실이랑 같이 저장된다.
새 엣지가 들어오면 기존 엣지를 무효화할 수 있다. 순서는 이렇다.
- LLM이 새 엣지를 의미가 비슷한 기존 엣지들이랑 비교해서 모순 후보를 찾는다
- 시간이 겹치는 모순이 있으면, 기존 엣지의
t_invalid를 새 엣지의t_valid로 설정한다 - 트랜잭션 타임라인 기준으로 새 정보를 우선한다
엣지를 지우지 않고 t_invalid만 찍는다. 그래서 지금 관계가 뭔지랑, 관계가 시간에 따라 어떻게 바뀌어 왔는지를 같이 남길 수 있다. 판단이 틀렸으면 유효 구간을 다시 잡으면 된다.
-> “작년에는 뭐라고 했지” 같은 질문은 지우는 방식으로는 못 푼다. 지금 참인 것이랑 그때 참이었던 건 다른 질문이다.
2.3 Communities
GraphRAG처럼 커뮤니티를 만들지만 Leiden 대신 label propagation을 쓴다. 새 엔티티가 들어오면 이웃 다수가 속한 커뮤니티에 넣고, 전체 재계산은 가끔만 한다.
3. Memory Retrieval
검색을 세 단계 합성 f(α) = χ(ρ(φ(α)))으로 둔다.
- Search
φ: 후보를 찾는다 - Reranker
ρ: 결과를 다시 정렬한다 - Constructor
χ: 노드랑 엣지를 텍스트 맥락으로 바꾼다
Constructor가 만드는 출력 형식은 이렇다.
format: FACT (Date range: from - to)
<FACTS> {facts} </FACTS>
ENTITY_NAME: entity summary
<ENTITIES> {entities} </ENTITIES>
의미 엣지마다 사실이랑 t_valid·t_invalid를 같이 준다. LLM이 “이 사실은 이 기간에 참이었다”를 보고 답하게 된다.
3.1 Search
Search에서는 함수 세 개를 쓴다.
- 코사인 유사도 (
φ_cos) - Okapi BM25 전문 검색 (
φ_bm25) - 너비 우선 탐색 (
φ_bfs)
앞의 둘은 Neo4j의 Lucene 구현을 쓴다. 검색하는 필드가 객체마다 다르다. 의미 엣지는 사실 필드, 엔티티 노드는 이름, 커뮤니티 노드는 이름(관련 키워드랑 구문)이다.
논문은 BFS가 RAG 쪽에서는 거의 안 쓰였다고 한다. AriGraph나 Distill-SynthKG 정도가 예외다.
세 개를 같이 쓰는 건 리랭킹 전에 후보를 넓게 모으려는 것이다. 나중에 볼 ReFind는 반대로 BM25 하나만 쓴다.
3.2 Reranker
Search가 recall을 넓히는 단계라면, Reranker는 정밀도를 올리는 단계다.
RRF(Reciprocal Rank Fusion, 여러 검색 결과의 순위를 합치는 방법)나 MMR(Maximal Marginal Relevance, 관련성과 다양성을 같이 보는 방법) 같은 기존 방법을 지원한다. 여기에 그래프 전용 리랭커가 둘 더 있다. 대화에서 자주 언급된 엔티티·사실을 앞으로 올리는 episode-mentions 리랭커, 기준 노드에서 그래프 거리가 가까운 순으로 정렬하는 node distance 리랭커다.
제일 정교한 건 LLM cross-encoder로 질의와 노드·엣지를 같이 넣어 관련도를 매기는 방식인데, 계산 비용이 제일 크다.
4. Experiments
4.1 Choice of models
임베딩과 리랭킹은 BGE-m3, 그래프 구성은 gpt-4o-mini를 쓴다. 답 생성은 gpt-4o-mini와 gpt-4o이고, MemGPT의 DMR 결과와 맞추려고 DMR은 gpt-4-turbo로도 돌렸다.
4.2 Deep Memory Retrieval (DMR)
Deep Memory Retrieval은 앞에서 본 MemGPT 팀이 자기들 주 평가 지표로 쓴 벤치마크다. 500개 다중 세션 대화, 대화당 5세션, 세션당 최대 12메시지다.
아래는 DMR 정확도다(논문 Table 1). † 표시가 붙은 Recursive Summarization과 MemGPT 줄은 MemGPT 논문에서 가져온 값이다. Recursive Summarization은 MemGPT 논문의 베이스라인으로, 지난 다섯 세션의 요약만 본다. Conversation Summaries(세션 요약)와 Full-conversation(대화 전체를 넣음)은 Zep 팀이 새로 돌린 베이스라인이다.
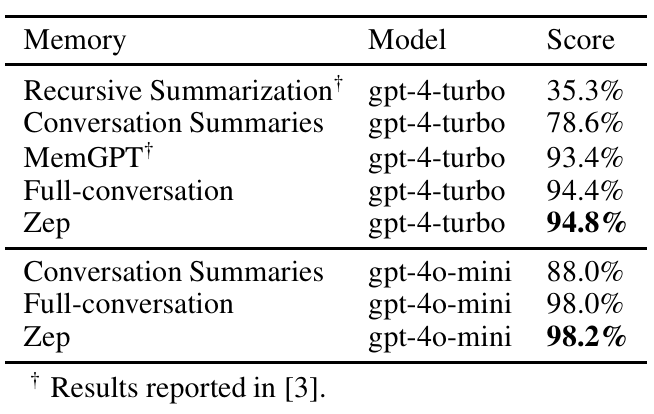
Zep이 MemGPT보다 높긴 한데, 대화를 통째로 넣은 full-conversation도 94.4%로 이미 MemGPT(93.4%)보다 높다. MemGPT 논문의 35.3%는 요약만 본 베이스라인이라 대화 전체와 비교한 숫자가 아니었다.
-> 대화를 다 넣어도 풀리는 벤치마크라서 메모리 시스템끼리 비교하기엔 좀 쉬운 것 같다. 대화 하나가 60메시지라 요즘 컨텍스트 창에 다 들어간다.
논문도 바로 더 어려운 평가로 넘어간다. gpt-4o-mini에서는 MemGPT 결과를 재현하지 못했는데, 공개된 방법 설명이 부족해서라고 한다.
4.3 LongMemEval (LME)
앞에서 본 LongMemEval에서 문항당 약 115k 토큰인 LongMemEval-S로 잰 결과다(논문 Table 2). 지연은 응답까지 걸린 전체 시간이고, IQR은 지연 분포의 가운데 50% 폭이다.
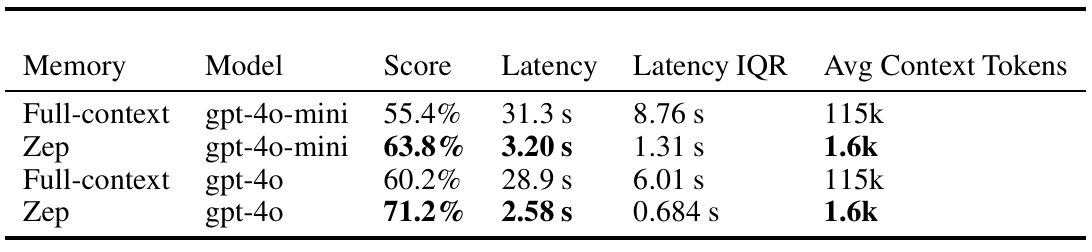
여기서는 정확도도 오르고 지연도 줄었다. gpt-4o 기준으로 18.5% 상대 개선에 지연은 약 90% 줄었고, 컨텍스트 토큰은 115k → 1.6k다.
Zep 쪽 지연에는 네트워크 시간도 들어 있다. 보스턴의 노트북에서 AWS us-west-2에 있는 Zep 서비스로 붙어서 쟀고, 베이스라인에는 이 지연이 없었다.
-> LongMemEval이 긴 이력에서 관련된 부분만 찾는 과제라서 full-context가 오히려 불리한 것 같다.
MemGPT도 LongMemEval로 돌려 보려 했는데, 기존 대화 이력을 바로 넣는 기능이 없어서 archival에 넣는 식으로 우회했고 답을 제대로 받지 못했다고 한다.
질문 유형별로 보면 이렇다(논문 Table 3). 위 여섯 줄이 gpt-4o-mini, 아래 여섯 줄이 gpt-4o이고, 여기서는 gpt-4o 줄을 본다. Delta는 full-context 대비 상대 변화율이다.
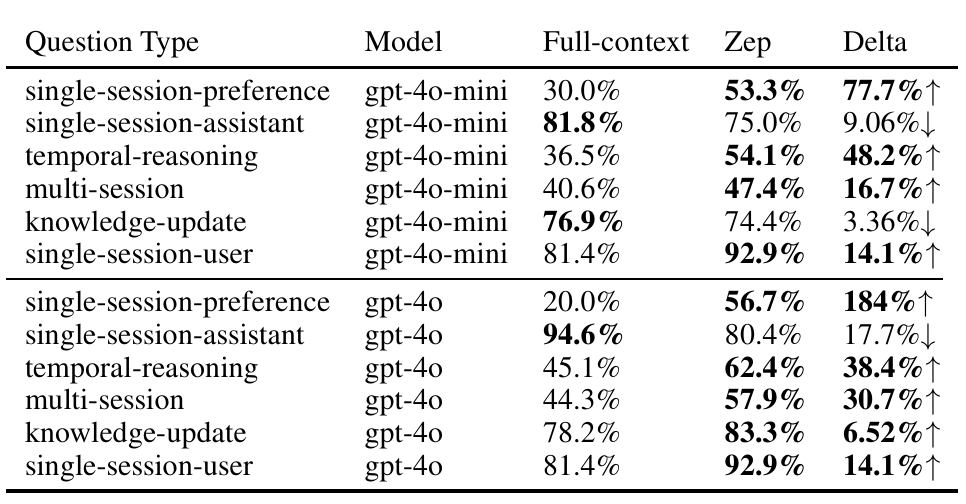
gpt-4o에서는 single-session-assistant만 떨어진다(−17.7%). gpt-4o-mini에서는 single-session-assistant(−9.06%)와 knowledge-update(−3.36%)가 떨어진다. 논문도 single-session-assistant는 예외라고 적고 추가 연구가 필요하다고 한다.
원인은 논문에 안 나와 있다.
-> 이 유형은 어시스턴트가 한 세션 안에서 한 말을 묻는 건데, 어시스턴트 발화는 설명이나 추천이 많아서 엔티티로 뽑기 애매하다. 추출하면서 흐려지는 게 아닐까??
LongMemEval에서 어시스턴트 쪽 정보 기억을 따로 능력으로 둔 게 이런 경우를 보려는 거였던 것 같다.
5. Conclusion
의미 기억이랑 일화 기억을 엔티티·커뮤니티 요약과 같이 담는 그래프 기반 메모리를 만들었다. 기존 메모리 벤치마크에서 제일 높은 성능을 내면서 토큰도 줄이고 지연도 훨씬 낮다고 한다.
conclusion 부분을 보면 논문도 이건 그래프 기반 메모리의 초기 단계라고 한다. 다음으로 다른 GraphRAG 방법을 합치는 것, 엔티티·엣지 추출용 모델을 파인튜닝하는 것을 꼽는다.
틀린 기억을 지우지 않고, 언제까지 참이었는지를 표시해두는 방식이다.
6. 지금 관점: 적용해볼 만한 부분
이 논문에서 제일 가져다 쓰고 싶은 건 무효화다. 모순이 생기면 지우지 않고 t_invalid만 찍는다.
그래프를 안 쓰더라도 사실마다 t_valid/t_invalid 두 필드만 붙이면 비슷하게 흉내 낼 수 있을 것 같다. 지우는 방식이 어떻게 되는지는 뒤에서 볼 Mem0에서 나온다.
검색 결과에 FACT (Date range: from - to)처럼 유효 구간을 같이 주는 것도 쉽게 따라 할 수 있다. LongMemEval의 CP 3은 시간을 인덱스와 질의 쪽에서 풀었는데, Zep은 LLM에 넘기는 출력 형식에서도 푼다.
원본을 에피소드로 남겨두는 것도 그대로 가져다 쓸 만하다.
성능 근거로는 DMR보다 LongMemEval 쪽을 믿는 게 맞을 것 같다.
걸리는 것도 있다.
어시스턴트가 한 말을 기억하는 게 약하다. 안내나 추천을 많이 하는 챗봇이면 “아까 뭐라고 알려줬지”를 자주 묻는데, 그래프 추출만으로는 부족할 수 있다.
저장할 때 LLM을 여러 번 부른다. 엔티티 추출, 관계 생성, 모순 판단이 다 LLM이다.
-> 논문의 지연은 질의 응답 기준이다. 저장에 드는 시간은 안 나와 있다.
다음은 A-MEM이다. Zettelkasten을 LLM 에이전트에 옮겨서, 새 기억이 들어오면 스스로 링크를 걸고 기존 기억의 맥락·키워드·태그까지 고쳐 쓴다.
Leave a comment