
ReFind Paper review
When Your Agent Opens the Chat App: Agent-Controlled Search over Raw Chat Logs Rivals Structured Memory
https://arxiv.org/abs/2608.12888
ReFind는 중국과기대(USTC)와 MetaStone Technology에서 만든 채팅 기록 검색 방법이다. 2026년 8월 arXiv에 올라온 논문이다.
대화 기록을 요약하거나 그래프로 바꾸지 않고, 원본 로그를 그대로 두고 BM25(단어가 얼마나 겹치는지로 점수를 매기는 고전 키워드 검색) 검색만 에이전트가 잘 돌리게 했더니 구조화 메모리 시스템들보다 잘 나왔다는 논문이다.
앞에서 본 서베이(Memory in the Age of AI Agents)에서는 메모리 형태를 Token-level · Parametric · Latent로 나누고 Flat(1D) → Planar(2D) → Hierarchical(3D)로 올라가는 구조를 정리했는데, 여기서는 그렇게 올라갈 필요가 있냐고 묻는다.
1. Introduction
에이전트 메모리 시스템들은 원본 대화를 요약, 임베딩, 트리, 지식그래프로 바꿔두고 검색한다.
문제는 이 변환이 질문이 오기 전에 일어난다는 점이다.
논문은 이걸 “질문을 알기 전에 거는 내기”라고 부른다. 뭘 남기고 뭘 버릴지 미리 정하는 거라서, 전처리에서 빠진 내용은 나중에 되살리기 어렵다.
앞에서 본 Rate-Distortion 리뷰의 말로 하면 질의를 보기 전에, 되돌릴 수 없게 버리는 경우다.
비용도 든다. 인덱스를 오프라인으로 만들어야 하고, 새 메시지가 올 때마다 다시 만들거나 조금씩 갱신해야 한다.
그래서 이런 질문을 한다. 구조화 메모리의 이득이 구조에서 오는 건지, 아니면 그냥 히스토리를 제대로 검색해서 오는 건지.
이걸 확인하려고 의미 구조를 하나도 만들지 않고 어디까지 갈 수 있는지 본다.
아이디어는 개인 정보 재탐색(refinding) 연구에서 가져왔다.
사람은 아는 걸 다시 찾을 때 키워드 하나로 한 번에 찾지 않는다. 한 연구에서는 참가자가 키워드 검색을 쓴 비율이 39%뿐이었고, 나머지는 조금씩 좁혀가는 orienteering 방식이었다. 메신저 연구에서도 키워드, 스크롤, 시간·맥락 단서를 섞어 쓴다.
그래서 원본은 그대로 두고, 미리 인덱스를 똑똑하게 만드는 대신 검색을 그때그때 잘 하도록 만든다.
2. Related Work
related work 부분을 보면 기존 시스템을 다섯 가지 기준으로 비교한 표(논문 Table 1)가 있다. 체크는 그 기능을 갖췄다는 뜻이고, 맨 아래 ReFind 행만 다섯 칸이 다 차 있다.
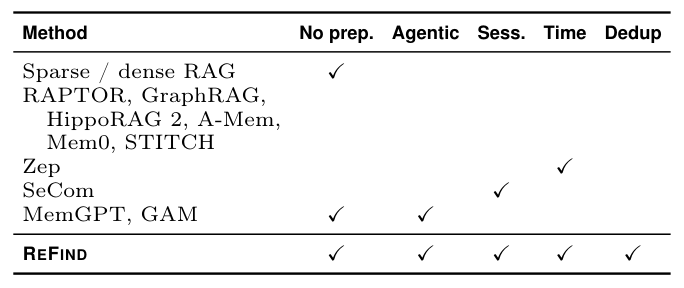
- No prep. : 질문이 오기 전에 LLM으로 인덱스를 만들지 않음
- Agentic : 모델이 스스로 여러 번 검색함
- Sess. : 세션 구조를 랭킹에 반영함
- Time : 시간으로 걸러서 검색할 수 있음
- Dedup : 라운드끼리 중복 결과를 뺌
STITCH, SeCom, GAM은 이 시리즈에서 처음 나오는 비교 대상 메모리 시스템이다. 뒤 표의 MIRIX는 앞의 서베이 리뷰에서 잠깐 나왔다. STITCH는 메모리를 대화의 맥락상 의도(contextual intent)에 묶어 두고, SeCom은 대화를 주제 단위로 잘라 압축하고, GAM은 원본 메시지를 페이지 단위로 보관해 두고 찾아 쓴다. MIRIX는 역할이 나뉜 메모리 에이전트 여러 개를 조율한다.
논문도 각각은 새로운 게 아니라고 한다. 기존 시스템들은 일부만(없거나 한두 개) 갖고 있고, ReFind는 다 합쳤다.
3. Method
검색(증거 모으기)이랑 추론(답 만들기)을 두 단계로 나눈다.
What “no structure” means
구조가 없다고 해서 아무것도 안 쓰는 건 아니다.
채팅 기록에 원래 있는 것들, 턴 경계, 세션 ID, 타임스탬프, 원문 텍스트는 쓴다. 안 만드는 건 학습하거나 LLM으로 생성한 메모리 표현이다.
BM25 인덱스도 원문을 찾아가는 경로일 뿐 메모리를 대신하지 않는다. 메시지가 추가되면 토큰이랑 메타데이터가 붙을 뿐이고, 요약하거나 엔티티를 뽑거나 그래프를 잇지 않는다.
정리하면 구조화 시스템은 질문을 보기 전에 표현을 정하고, ReFind는 그걸 질문이 올 때까지 미룬다.
System Architecture
Stage 1은 ReAct 루프다. LLM이 키워드랑 파라미터를 정해서 여러 번 검색하고, 쓸 만한 내용을 노트에 저장한다.
이전 검색 결과를 보고 다음 검색을 바꿀 수 있다. 안 걸린 단어를 특징적인 엔티티로 바꾸거나, 시간 단서를 찾으면 날짜 범위를 좁히거나, 멀티홉 질문이면 두 번째 사실을 찾으러 가는 식이다.
Stage 2는 모은 노트를 세션별로 묶고 시간순으로 정렬해서 질문이랑 같이 준다.
이렇게 나눈 이유는 답 만드는 쪽이 검색이랑 컨텍스트 공간을 두고 다투지 않게 하려는 거라고 한다. 답변 모델은 원문 그대로의 증거만 받는다.
Search Engine Design
검색 엔진에 채팅 기록에 맞춘 기능 네 개를 넣었다. RRF 2단 재랭킹, 컨텍스트 창 확장, 시간 필터, 본 세션 제외다.
Figure 1은 칸이 세 개인데, (c)에 시간 필터와 본 세션 제외가 같이 들어 있어서 기능으로 세면 넷이다.
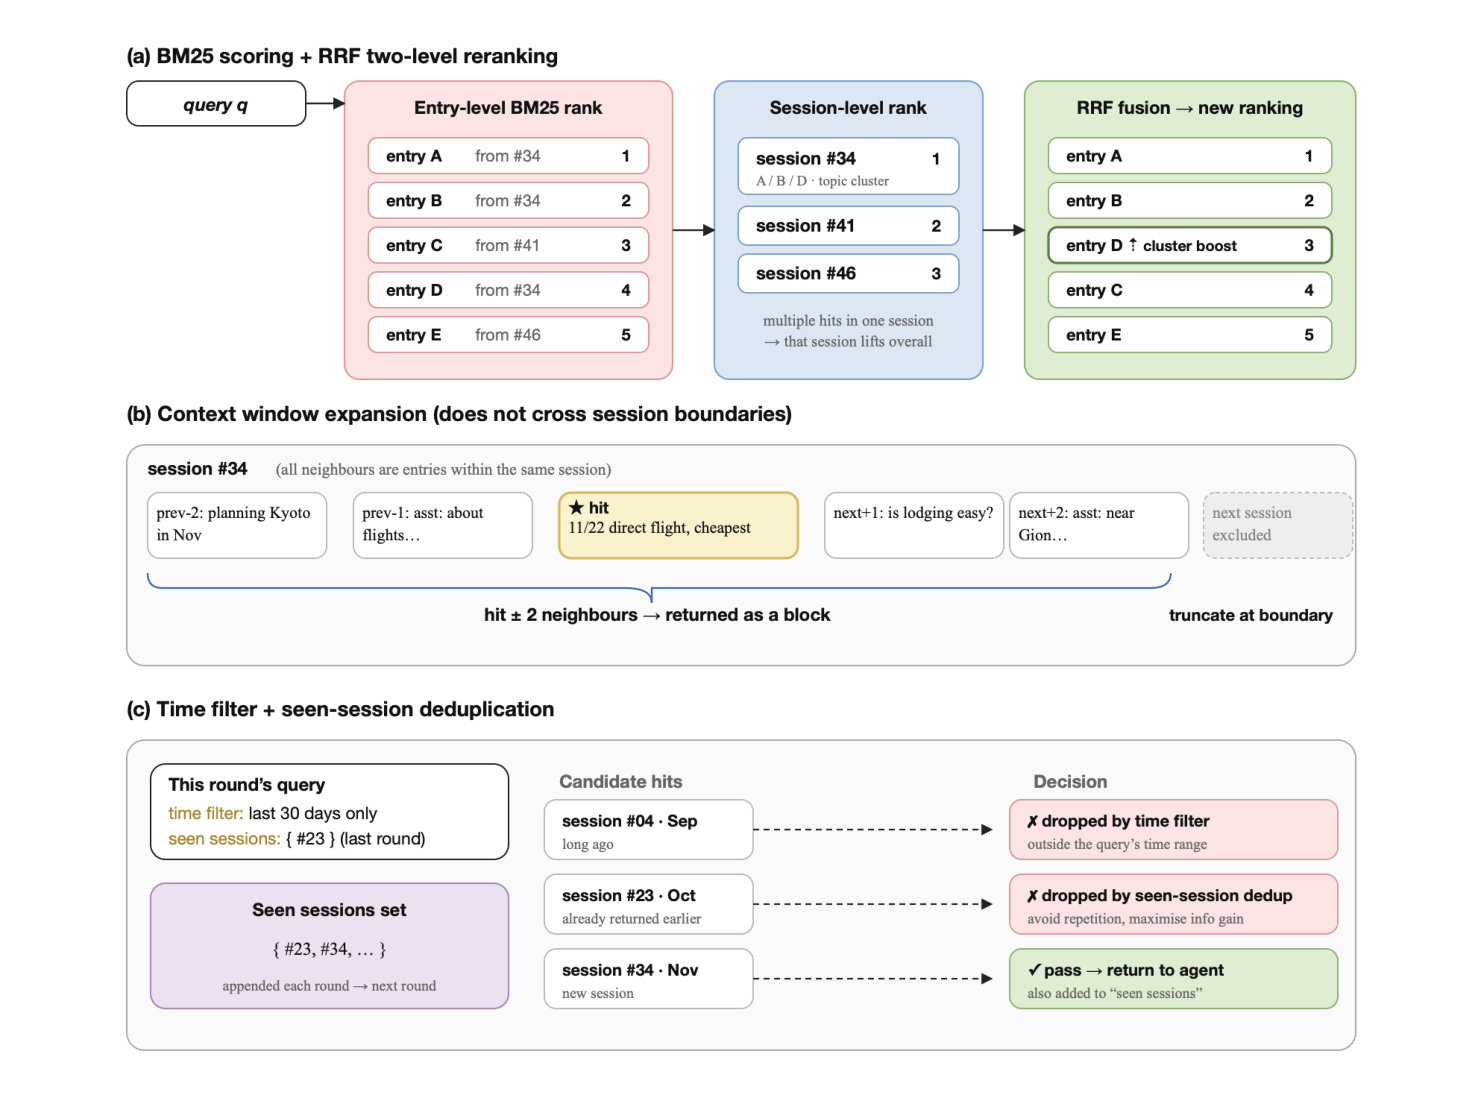
먼저 데이터 표현. 대화는 두 층이다. 제일 작은 단위가 턴(사용자 발화 + 어시스턴트 응답)이고, 턴이 모여서 세션(ID와 타임스탬프가 있는 대화 하나)이 된다.
BM25 역인덱스는 턴 단위로 만든다. 소문자화, 공백·구두점 분할, Porter 스테밍, 불용어 제거를 하고 k1=1.2, b=0.75를 쓴다.
sparse를 쓴 이유는 두 가지다.
- 모델 호출이나 요약이 없어서 기록되자마자 바로 검색할 수 있다. 새 턴은 인덱스에 그냥 붙는다.
- 키워드 매칭은 결과를 이해하기 쉽다. 에이전트가 어떤 단어가 먹혔고 어떤 단어가 안 먹혔는지 보고 다시 검색할 수 있다. 유사도 점수보다 이게 더 좋은 피드백이라고 한다.
-> 2번은 그럴듯하다. 임베딩 검색은 왜 안 걸렸는지 알기 어렵긴 하다.
첫 번째 기능은 RRF 2단 재랭킹이다.
BM25는 턴 단위로 매칭해서 세션 전체가 관련 있는지는 못 본다. 한 세션에서 턴이 여러 개 걸리면 그 세션 자체가 질문이랑 관련 있을 가능성이 크다.
그래서 랭킹을 두 개 만든다.
- 턴 BM25 순위 (
r1) - 세션 총점으로 매긴 세션 순위를 그 세션의 턴이 물려받은 것 (
r2)
둘을 Reciprocal Rank Fusion(RRF)으로 합친다. RRF는 각 랭킹에서의 순위 r마다 1/(k+r)을 더해 새 점수를 만드는 방법이고, 여기서는 k=60이다. 합친 점수로 상위 K개 턴을 돌려주는데 기본값이 K=5다.
그림 (a)에서 entry D가 세션 #34에 속해 있어서 3위로 올라간다.
두 번째는 컨텍스트 창 확장이다.
걸린 턴 하나만 주면 앞뒤 맥락이 잘린다. 그래서 앞뒤 ±2 턴을 묶어서 주는데, 세션 경계를 넘어가진 않는다(그림 b).
세 번째, 네 번째는 시간 필터와 본 세션 제외다.
에이전트가 시간 범위를 정할 수 있고, 이전 라운드에서 이미 나온 세션은 뺀다(그림 c). 라운드마다 새 정보를 더 많이 얻으려는 장치다.
4. Experiments
Evaluation Setup
MemoryAgentBench(Hu et al., 2025)의 벤치마크 여섯 개를 GPT-4o-mini로 잰다. 약 2,800문항이다.
- SH-QA / MH-QA : 긴 기록에서 사실 하나(single-hop) 또는 둘 이상을 이어서(multi-hop) 찾는 QA
- LME : LongMemEval
- EventQA : 긴 이야기에서 다음에 일어날 사건을 고르는 사건 순서 문제
- FC-SH / FC-MH : FactConsolidation, 사실이 나중에 덮어쓰였을 때 최신 값을 답해야 하는 문제 (single-hop / multi-hop)
앞의 넷은 정확한 사실 찾기, 뒤의 둘은 갱신된 사실 추적이다.
모든 시스템을 GPT-4o-mini로 맞췄다. 베이스라인 수치는 MemoryAgentBench 논문에서 그대로 가져왔다.
Main Results: Precise Retrieval and Fact Tracking
여섯 벤치마크 정확도(%)다. 논문 Table 2다. Avg 열과 Structured Memory 블록, 맨 아래 ReFind 행을 보면 된다. 굵은 글씨가 1등, 밑줄이 2등이다.
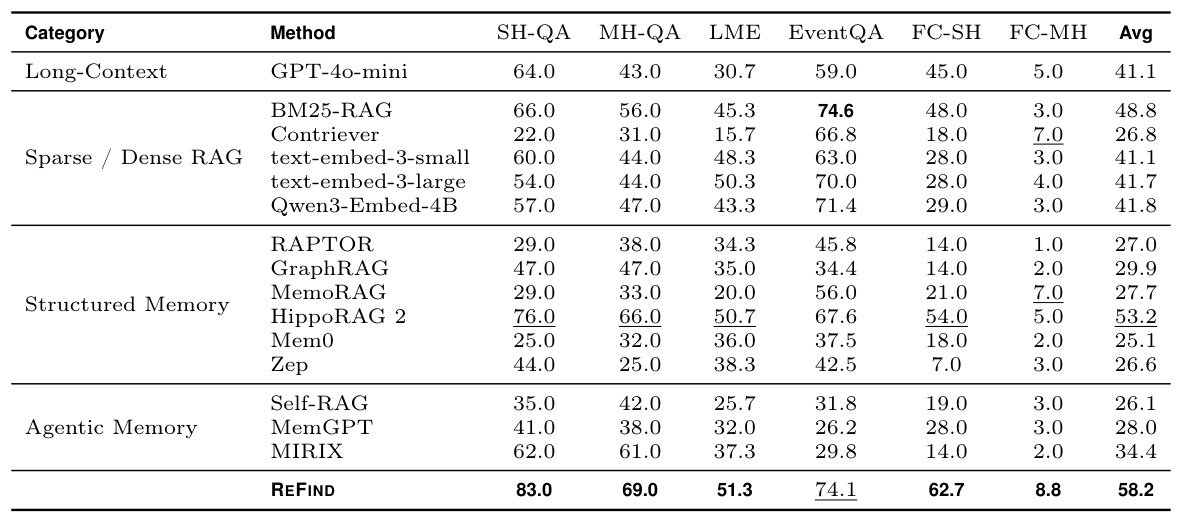
표를 보면,
- 구조화 메모리가 그냥 BM25-RAG보다 낮다. RAPTOR 27.0, GraphRAG 29.9, Mem0 25.1, Zep 26.6인데 BM25-RAG가 48.8이다.
- 구조화 메모리 중에는 HippoRAG 2만 53.2로 BM25-RAG보다 높다.
- ReFind가 58.2로 제일 높다. 구조 없이 HippoRAG 2보다 평균 5.0점 높다.
HippoRAG 2는 시리즈 앞쪽에서 본 HippoRAG의 후속판이다.
FC-MH는 모든 시스템이 10점 아래다. 덮어쓰인 사실 중 최신 값을 골라서 다시 다른 사실과 이어야 하는 문제라서 그런 것 같은데, 논문은 왜 다 낮은지 따로 설명하지 않는다.
-> Mem0랑 Zep이 키워드 검색보다 한참 낮은 건 좀 의외다. 베이스라인 수치를 다른 논문에서 가져온 거라 세팅이 잘 맞았는지는 모르겠다.
5. Analysis and Discussion
Backbone Scaling
백본을 키우면 격차가 벌어진다.
LongMemEval-S(50문항, 문항당 ~115k 토큰)와 M(15문항, ~500k 토큰, 원 벤치마크 M과 다른 부분집합)에서 GPT-5-mini로 다시 쟀다. ReFind는 5회 반복 평균이다. 베이스라인은 STITCH 논문 수치를 가져왔고(GAM만 직접 돌림), 결과는 논문 Table 3이다. HippoRAG 2 행과 맨 아래 ReFind 행을 비교하면 된다.
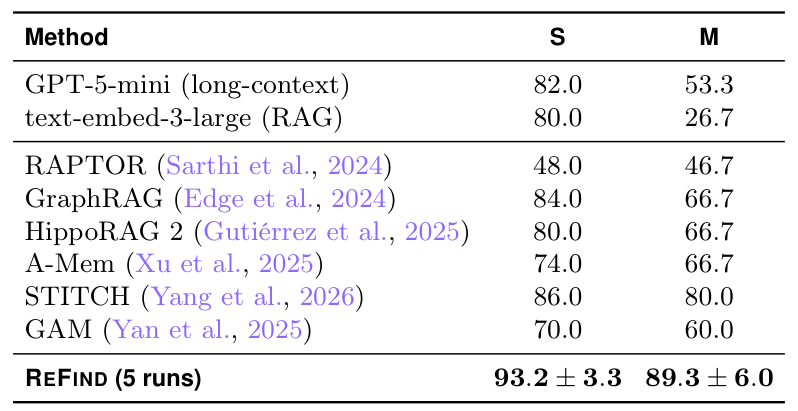
HippoRAG 2랑 차이가 GPT-4o-mini 때는 LME 열 기준 0.6점(51.3 대 50.7)이었는데 여기서는 13.2(S), 22.6(M)으로 벌어진다.
-> 모델이 좋아질수록 검색을 직접 하는 쪽이 유리해지는 것 같다. 구조화 시스템은 인덱스를 미리 만들어뒀으니 모델이 좋아져도 얻는 게 적을 것 같다. 논문이 이렇게 말하지는 않았고, 두 설정은 벤치마크 부분집합과 베이스라인 출처가 달라서 격차를 그대로 비교하기는 어렵다.
Ablation Study
무엇이 효과를 냈는지 본다. 같은 LongMemEval-S/M, GPT-5-mini 설정에서 기능을 하나씩 뺀 정확도로, 논문 Table 4의 위쪽 블록이다. ∆S, ∆M 열이 전체 방법 대비 떨어진 폭이다. 아래쪽 Backend 블록은 검색 백엔드를 바꾼 결과다.
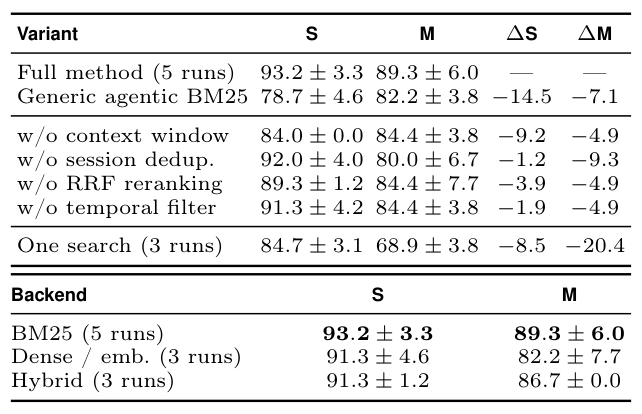
검색을 한 번만 하면 M에서 −20.4로 제일 많이 떨어진다. 기록이 길수록 한 번에 못 찾는다.
채팅용 기능을 다 빼고 그냥 agentic BM25로 돌리면 S에서 −14.5다. 에이전트가 여러 번 검색하는 것만으로는 안 되고, 세션·시간·맥락·중복을 다루는 기능도 꽤 역할을 한다.
검색 백엔드도 바꿔봤는데 S 기준으로 BM25 93.2, dense 91.3, hybrid 91.3으로 sparse가 조금 낫거나 비슷했다.
Discussion
비용은 부록 Table 11에 따로 정리돼 있다. 문항당 평균 검색 횟수(Searches), LLM 호출 수(Calls), 토큰, 시간이다. Full의 S 행과 One search의 S 행을 비교하면 된다.
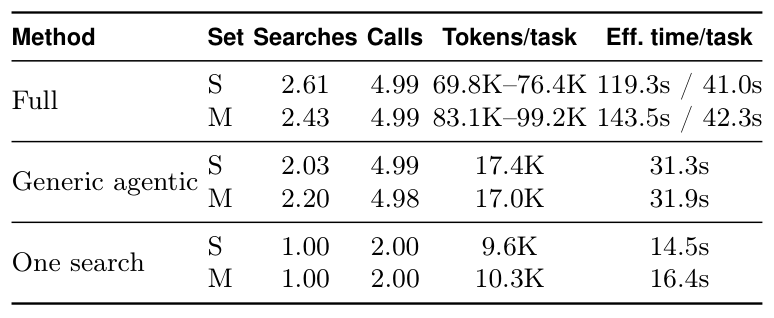
시간은 LLM API 호출 시간과 검색 시간을 더한 값이다. 전체 방법은 두 개가 적혀 있는데, 앞은 처음 잰 실행, 뒤는 나중에 세 번 다시 잰 평균이다. 논문은 이 차이가 방법이 아니라 API 서버 상태 때문이라고 한다.
정확도를 토큰으로 산다. 검색 1회보다 토큰이 7배쯤(69.8K 대 9.6K), 시간은 나중에 잰 41.0s 기준으로 3배쯤 든다.
대신 오프라인으로 인덱스 만드는 비용은 0이다. 어느 쪽이 싼지는 기록 크기랑 질문이 얼마나 자주 오는지에 달렸다.
6. Conclusion
구조를 하나도 안 만들고 끝까지 밀어붙여서, 구조화 메모리의 이득 상당 부분이 구조가 아니라 질문할 때 검색을 잘 하는 데서 온다는 걸 보여준다.
여섯 벤치마크 평균 58.2(구조화 중 제일 높은 게 53.2), LongMemEval-S/M에서 93.2/89.3이다.
부수적인 장점도 있다. 검색 과정이 노트에 남아서 나중에 확인할 수 있고, 답을 원문 턴이랑 대조할 수 있고, 새 메시지가 오면 바로 반영된다. 앞의 두 가지는 앞에서 본 서베이 7.7(trustworthy memory)에서 말한 감사할 수 있는 메모리와 이어진다.
원본을 그대로 두고, 질문이 올 때 에이전트가 검색을 여러 번 돌려서 찾는 방법이다. 미리 구조를 만드는 비용을 질문 시점의 토큰으로 옮겼다.
7. 지금 관점: 구조화 메모리를 들이기 전에 확인할 것
메모리 구조를 짜기 전에 그게 정말 필요한지부터 따져봐야 할 것 같다.
표에서 Mem0(25.1)랑 Zep(26.6)이 BM25-RAG(48.8)의 절반 정도다. 구조화 메모리를 얹는다고 알아서 좋아지지는 않는다.
앞에서 본 Rate-Distortion 서베이 틀로 보면, 구조화 메모리가 진 건 구조가 나빠서라기보다 질의를 알기 전에 되돌릴 수 없게 버렸기 때문일 수도 있다. ReFind는 원본을 안 건드리니까 버린 게 없다. 다만 이건 내 해석이고, 논문이 이 둘을 따로 떼어 실험하지는 않았다.
그래도 그대로 받아들이기 어려운 부분이 있다. 여섯 벤치마크가 전부 사실을 찾거나(앞의 넷) 갱신된 사실을 따라가는(뒤의 둘) 문제다. abstract를 보면 논문도 범위를 “for precise, evidence-grounded questions over chat archives”라고 적었다. 서베이 분류로 치면 factual memory만 본 거고, experiential memory(실패에서 배우기, 스킬 쌓기)는 평가하지 않았다.
또 원본 대화를 다 보관하고 있다는 전제다. 보관 기간 제한이 있거나 개인정보를 지워달라는 요청이 오면 이 방식은 쓰기 어렵다. 질문 하나에 70~100K 토큰, LLM 5회 호출이라 매 턴 메모리를 보는 챗봇에 그대로 넣기도 부담스럽다.
-> 그래도 구조화 메모리를 쓸 거면 BM25 반복 검색보다 나은지는 먼저 확인해봐야 할 것 같다. 네 기능 중 RRF 2단 재랭킹이랑 컨텍스트 창 확장은 구조를 전제하지 않아서, 벡터 DB를 쓰고 있어도 세션 단위 점수를 더해서 재랭킹하는 건 인덱스를 다시 안 만들고 붙일 수 있을 것 같다.
다음은 Does Your Agent’s Memory Survive a Model Upgrade?다. 같은 메모리 저장소를 그대로 두고 모델만 바꿨을 때 에이전트가 잊는지를 잰 논문이다.
Leave a comment