
HippoRAG Paper review
HippoRAG: Neurobiologically Inspired Long-Term Memory for Large Language Models
https://arxiv.org/abs/2405.14831
HippoRAG는 Ohio State University와 Stanford에서 만든 RAG 방법이다. 2024년 5월에 나왔고, NeurIPS 2024에 실렸다.
사람 뇌의 해마 색인 이론을 가져와서, LLM으로 지식그래프를 만들고 Personalized PageRank(PPR, 시작 노드를 정해두고 그래프 위에서 확률을 퍼뜨리는 PageRank)로 한 번의 검색에 다중홉을 푼다.
뒤에서 볼 서베이(Memory in the Age of AI Agents)에서는 RAG 쪽이랑 메모리 쪽 양쪽에서 다 인용되는 논문으로 꼽는다. 나중에 볼 ReFind의 비교표에는 후속작인 HippoRAG 2가 들어가 있고, 거기서도 성적이 좋다.
1. Introduction
다중홉 질문을 두 가지로 나눈다.
- Path-following : “Alhandra는 어느 구역에서 태어났나?”처럼 정해진 경로를 따라가면 되는 질문
- Path-finding : “알츠하이머 신경과학을 연구하는 스탠퍼드 교수는?”처럼 갈 수 있는 경로가 많은데 그중 맞는 걸 찾아야 하는 질문
첫 번째는 반복 검색으로 풀린다. Alhandra → Vila de Xira → Portugal 순으로 따라가면 된다.
두 번째는 다르다. “스탠퍼드”에서 뻗는 경로도 많고 “알츠하이머”에서 뻗는 경로도 많다. 둘이 만나는 지점을 찾아야 하는데, 질의 임베딩 하나로는 그 지점이 안 보인다.
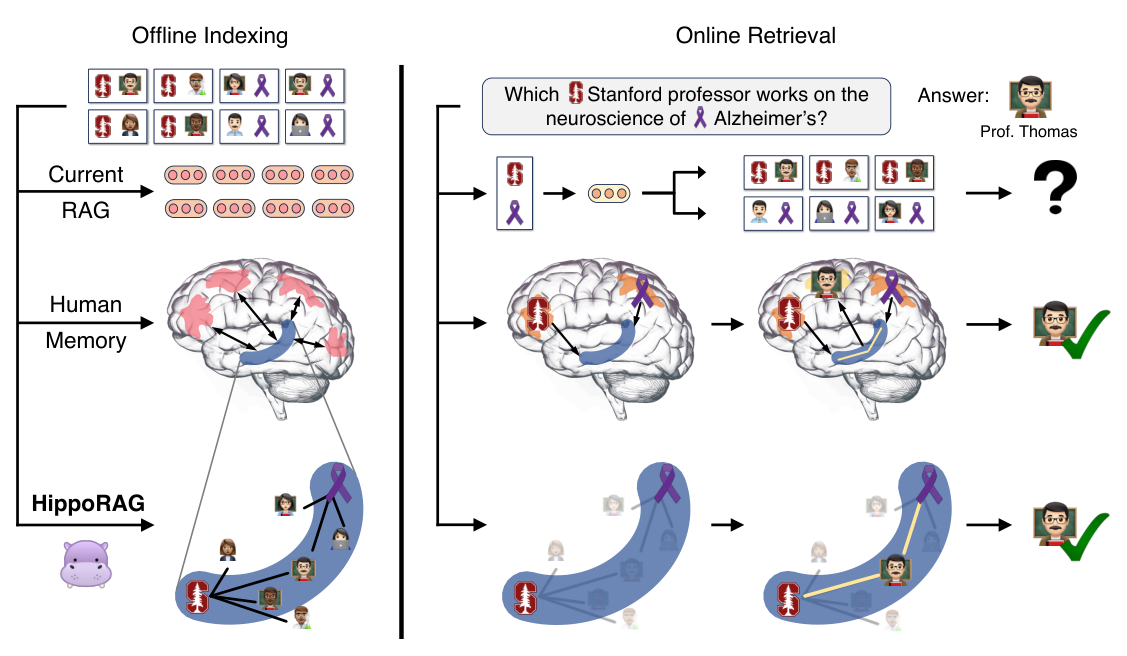
기존 RAG는 구절을 따로따로 인코딩해서, 두 특징이 한 구절에 같이 나오지 않으면 Prof. Thomas를 찾기 어렵다. 그림 아래쪽 HippoRAG 줄은 그래프 위에서 두 노드 사이 경로로 답에 닿는다.
그래서 여러 단계 RAG를 완벽하게 돌려도 이런 지식 통합 문제에는 부족할 때가 많다고 한다.
2. HippoRAG
2.1 The Hippocampal Memory Indexing Theory
Teyler와 Discenna(1986)의 해마 색인 이론에서 설계를 가져왔다.
사람의 장기기억은 두 가지를 해낸다고 본다.
- Pattern separation : 서로 다른 경험이 서로 다른 표현으로 저장되게 함
- Pattern completion : 일부 단서만으로 전체 기억을 되살림
저장할 때는 분리가 일어난다. 신피질이 감각 자극을 고수준 특징으로 바꾸고, 해마주위 영역(PHR)을 거쳐서 해마가 색인을 만든다. 해마에서는 두드러진 신호가 색인에 들어가고 서로 연결된다.
꺼낼 때는 완성이 일어난다. 해마가 PHR에서 일부 신호를 받으면 맥락에 따라 전체 기억을 되살린다.
2.2 Overview
이 구조를 그대로 옮겼다.
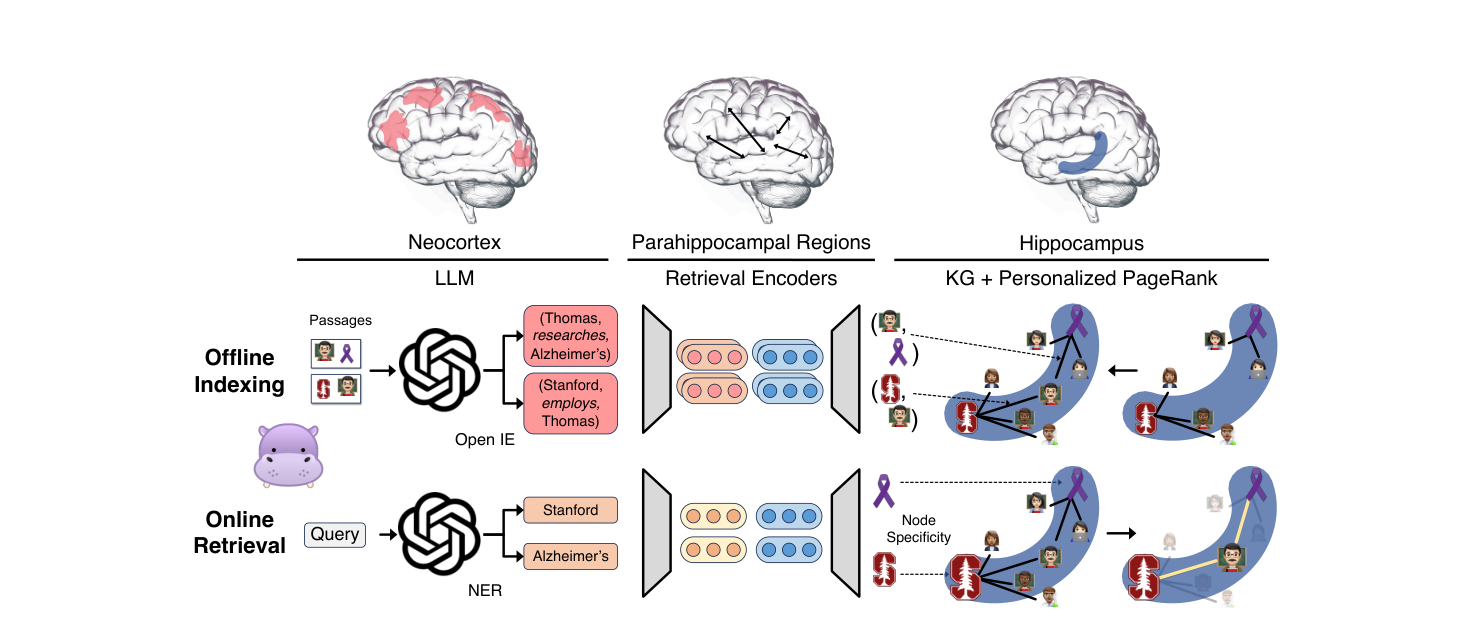
- 신피질 → LLM (입력 처리)
- 해마 색인 → 스키마 없는 지식그래프
- 해마주위 영역 → 검색 인코더
- pattern completion → Personalized PageRank
2.3 Detailed Methodology
먼저 오프라인 색인이다.
명령어 튜닝 LLM L과 검색 인코더 M으로 구절들을 처리한다.
- 구절에서 개체명을 먼저 뽑고, 그 개체명을 OpenIE(정해진 스키마 없이 문장에서 주어-관계-목적어 트리플을 뽑는 작업) 프롬프트에 넣어서 트리플을 뽑는다. 1-shot 프롬프팅이고, 트리플에는 개체명 말고 개념(명사구)도 들어간다
- 인코더로 동의어 엣지를 추가한다. 두 엔티티의 코사인 유사도가 임계값
τ를 넘으면 잇는다
두 단계로 나눈 건 일반성과 개체명 편향 사이에서 균형을 맞추려고 그랬다고 한다.
동의어 엣지는 색인에 엣지를 더 넣어서 pattern completion이 더 잘 되게 한다고 본다.
다음은 온라인 검색이다.
- 질의에서 개체명
C_q를 1-shot 프롬프트로 뽑는다 (Figure 2 예시에서는 “Stanford”와 “Alzheimer’s”) - 같은 인코더로 인코딩해서 그래프에서 코사인 유사도가 제일 높은 노드를 질의 노드
R_q로 고른다 - 질의 노드를 시작점으로 PPR을 돌린다
- PPR 노드 확률을 구절 단위로 합쳐서 순위를 매긴다
3번에서 PPR을 돌리기 전에 질의 노드마다 node specificity를 곱한다. 노드가 나온 구절 수의 역수(s_i = 1/|P_i|)라서, 여러 구절에 흔하게 나오는 노드일수록 가중치가 작아진다. IDF 비슷한 신호를 노드 안의 정보만으로 만들었다. Figure 2에서 Stanford 로고가 Alzheimer’s보다 크게 그려진 게 이 가중치다.
PPR이 그래프 경로를 탐색하고 관련 부분그래프를 찾아주니까, 한 번의 검색 안에서 다중홉 추론을 할 수 있다.
뒤에서 볼 SYNAPSE도 그래프 위에서 활성을 퍼뜨리는 비슷한 계열이다.
3. Experimental Setup
다중홉 QA 벤치마크 MuSiQue, 2WikiMultiHopQA, HotpotQA에서 검색과 QA를 잰다. 각 검증셋에서 질문 1,000개를 뽑고, IRCoT를 따라 후보 구절을 모아 검색 코퍼스를 만든다.
베이스라인은 BM25, Contriever, GTR, ColBERTv2와 Propositionizer, RAPTOR, 다단계 검색인 IRCoT다. 지표는 검색 R@2·R@5, QA EM·F1이다.
4. Results
단일 단계 검색부터 보자. 세 데이터셋 dev 1,000문항에서 잰 recall@5(상위 5개 안에 근거 구절이 든 비율)다. 논문 Table 2에서 R@5 열을 보면 된다. 위쪽 여덟 줄이 베이스라인, 아래 두 줄이 HippoRAG다.
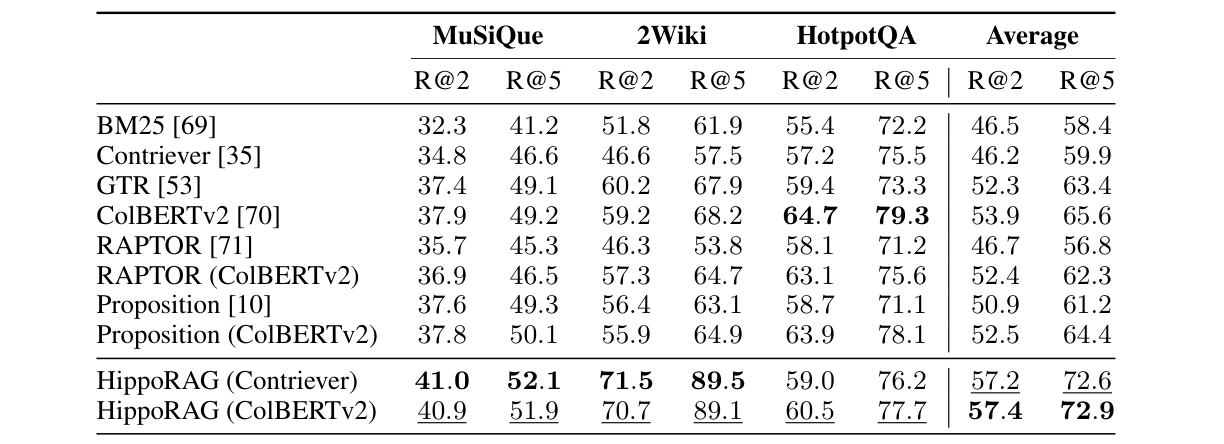
2Wiki에서 68.2 → 89.1로 20.9점 올랐다. abstract의 “최대 20%”가 여기서 나온 거다.
HotpotQA에서는 진다(77.7 vs 79.3). 논문은 HotpotQA가 지식 통합이 별로 필요 없는 데이터셋이고, 개념과 맥락 사이의 절충 문제도 있다고 한다.
반복 검색과 결합하면 더 오른다. 아래는 IRCoT(추론 한 단계마다 검색을 다시 하는 반복 검색 방법)의 검색기를 바꿔 가며 잰 결과다(논문 Table 3). 맨 오른쪽 Average R@5 열을 보면 IRCoT + BM25가 66.4, IRCoT + ColBERTv2가 70.0, IRCoT + HippoRAG (ColBERTv2)가 78.2다.
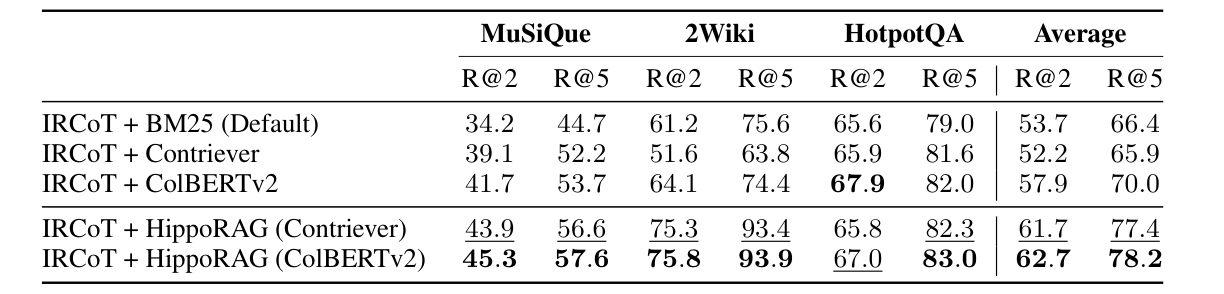
반복 검색과 같이 쓸 수 있다. 논문 본문에 따르면 IRCoT 안에서 검색기로 HippoRAG를 쓰면 R@5가 MuSiQue에서 4%, 2Wiki에서 18% 정도 더 오른다.
QA 성능은 이렇다. 검색 결과를 읽기 모델에 넣고 답한 EM과 F1이다(논문 Table 4). 맨 오른쪽 Average 열이 세 데이터셋 평균이다.
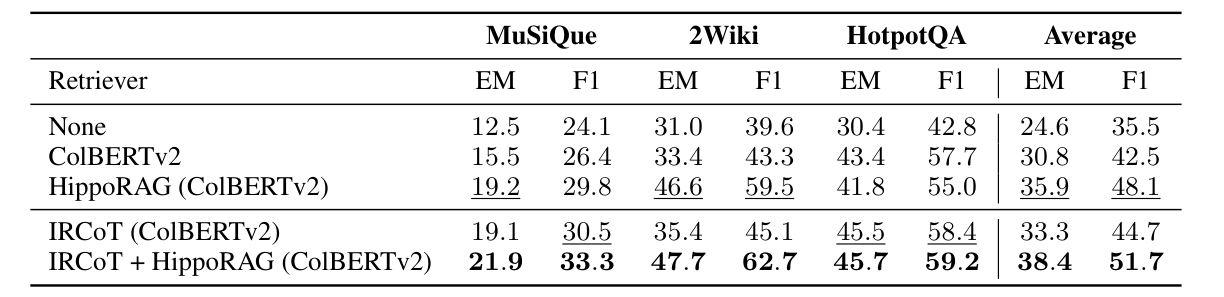
단일 단계 HippoRAG가 IRCoT보다 높다(48.1 vs 44.7).
그러면서 온라인 검색이 IRCoT보다 10~30배 싸고 6~13배 빠르다고 한다(초록에는 10~20배로 적혀 있다). 반복 검색만큼의 정확도를 한 번의 검색으로 낸다.
5. Discussions
5.1 What Makes HippoRAG Work?
5.1절의 실험은 전부 논문 Table 5 하나에 들어 있다. 맨 위 HippoRAG 줄이 기본 설정(OpenIE는 GPT-3.5, PPR 사용)이고, 아래로 OpenIE 대체, PPR 대체, 구성요소 제거 순이다.
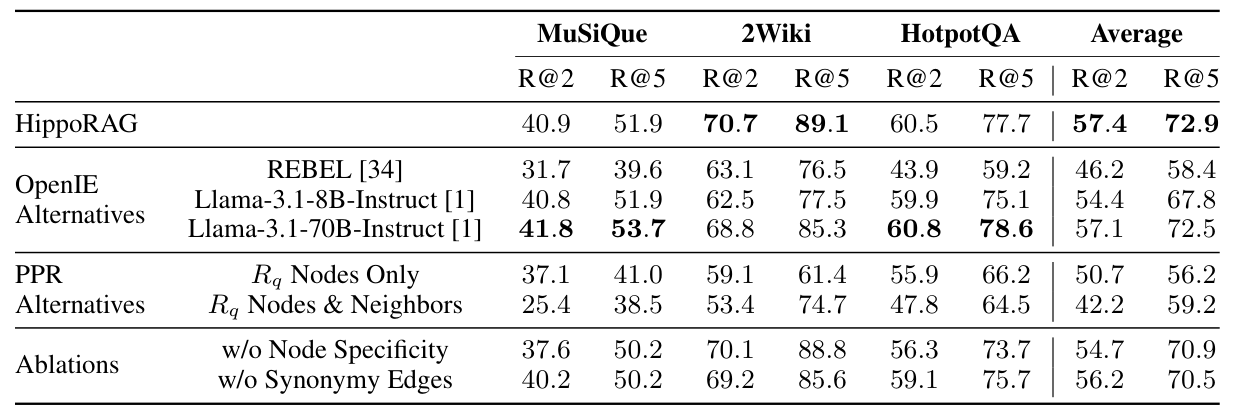
먼저 OpenIE 모델을 바꿔 봤다. OpenIE Alternatives 세 줄의 맨 오른쪽 평균 R@5를 기본 설정(72.9)과 비교하면 된다.
전용 OpenIE 모델(REBEL)을 쓰면 크게 떨어진다.
GPT-3.5는 REBEL보다 트리플을 두 배 많이 만든다. REBEL은 일반 개념이 들어간 트리플을 잘 안 만들어서 쓸모 있는 연결을 많이 놓친다.
Llama-3.1-70B는 GPT-3.5랑 거의 비슷하고, 8B도 2Wiki만 빼면 괜찮다. 큰 코퍼스를 색인할 때 더 싼 대안이 될 수 있다고 한다.
PPR이 실제로 기여하는지도 봤다. 위 Table 5의 PPR Alternatives 두 줄이 PPR 자리를 단순한 방식으로 바꾼 결과다. 맨 오른쪽 Average의 R@2·R@5를 맨 위 HippoRAG 줄(57.4, 72.9)과 비교하면 된다.
PPR을 빼면 R@5가 16점 넘게 떨어진다.
논문은 PPR 없이 R_q 노드에 이웃을 더하면 질의 노드만 쓸 때보다 나빠진다고 한다. 그런데 표를 보면 R@2 평균은 50.7 → 42.2로 떨어지지만 R@5 평균은 56.2 → 59.2로 오른다. R@5가 오른 건 2Wiki(61.4 → 74.7) 때문이고, MuSiQue와 HotpotQA의 R@5는 떨어진다.
-> 이웃을 막 넓히면 상위 2개 같은 좁은 순위에서는 잡음이 먼저 올라오고, 후보를 5개까지 보면 2Wiki처럼 엔티티 중심 데이터에서는 이웃이 도움이 되는 것 같다. 어느 쪽이든 얼마나 퍼질지 조절하는 PPR이 둘보다 훨씬 높다.
나머지 구성요소도 하나씩 뺐다. 위 Table 5의 Ablations 두 줄이고, 평균 R@5는 Node Specificity를 빼면 70.9, Synonymy Edges를 빼면 70.5다(전체 72.9).
둘 다 2점 정도다. PPR에 비하면 작다.
5.2 HippoRAG’s Advantage: Single-Step Multi-Hop Retrieval
All-Recall로 본다. 근거 구절을 전부 찾은 질문의 비율이다(논문 Table 6). AR@5 열을 보면 된다.
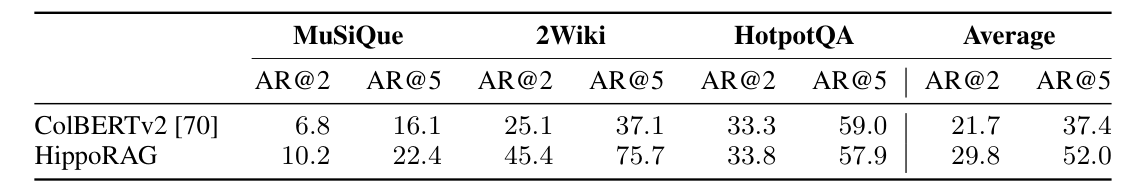
2Wiki에서 37.1 → 75.7로 두 배다. HotpotQA는 여기서도 조금 진다.
논문은 이 개선이 부분 검색을 한 질문이 늘어서가 아니라, 근거 문서를 전부 찾은 질문이 늘어서 생긴 거라고 한다.
-> 다중홉은 근거 하나만 빠져도 못 푸니까, R@5보다 AR@5가 실제 능력에 더 가까워 보인다.
5.3 HippoRAG’s Potential: Path-Finding Multi-Hop Retrieval
앞에서 본 두 질문에 대한 방법별 상위 3개 결과다(논문 Table 7). 아래쪽 Path-Finding 줄이 “알츠하이머 연구하는 스탠퍼드 교수?” 질문이다.
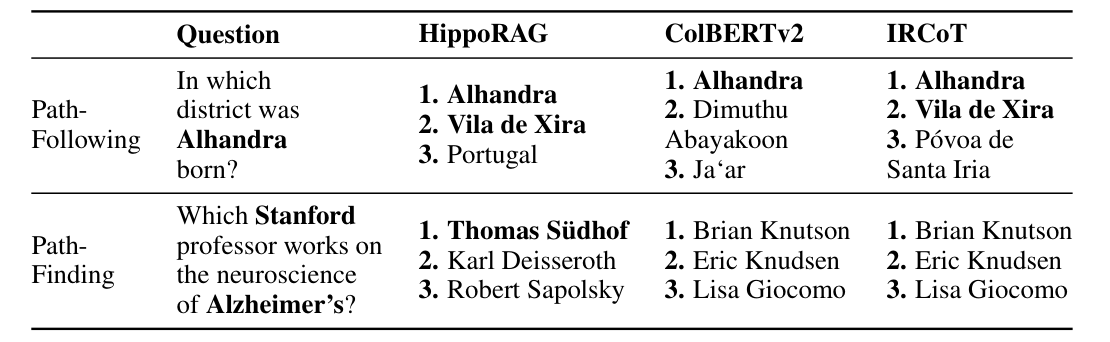
Path-Finding 줄만 옮기면 이렇다.
- HippoRAG : Thomas Südhof, Karl Deisseroth, Robert Sapolsky
- ColBERTv2 : Brian Knutson, Eric Knudsen, Lisa Giocomo
- IRCoT : ColBERTv2와 동일
ColBERTv2랑 IRCoT가 같은 답을 낸다. 반복 검색을 해도 못 찾았다.
6. Related Work
LLM 장기기억(파라미터 메모리, RAG, 긴 컨텍스트), 그래프를 쓰는 다중홉 QA, LLM과 지식그래프를 합치는 연구를 정리한다.
RAPTOR, GraphRAG처럼 오프라인에서 정보를 합치는 방법은 요약을 쓰니까 새 데이터가 들어오면 요약을 다시 해야 한다. HippoRAG는 KG에 엣지만 더하면 된다고 한다.
7. Conclusions & Limitations
논문은 신경생물학 원리를 가져온 단순한 방법으로 기존 RAG의 한계를 넘으면서도 파라미터 메모리보다 나은 점은 유지할 수 있다는 걸 보였다고 한다.
path-following 다중홉 QA에서 좋은 결과, path-finding에서의 가능성, 큰 효율 개선, 그리고 계속 갱신할 수 있다는 점 때문에 HippoRAG를 기존 RAG와 파라미터 메모리 사이의 중간쯤에 있는 방법으로 본다.
한계도 적었다.
- 모든 구성요소를 학습 없이 기성품으로 썼다. 오류 대부분이 NER과 OpenIE에서 나와서 파인튜닝 여지가 크다
- 나머지 오류는 그래프 탐색에서 나온다. 단순 PPR보다 나은 방법이 있을 수 있다
첫 번째는 쓰기 단계에서 LLM 추출 품질이 전체를 좌우한다는 얘기다. 뒤에서 볼 Anatomy에서 이 문제를 직접 잰다.
다중홉을 검색 여러 번으로 풀던 것을, 그래프 위에 PPR을 돌려서 검색 한 번으로 푼다.
8. 지금 관점: 메모리 설계에 쓸 수 있는 점
이 논문을 읽고 지금도 써먹을 만해 보인 게 몇 가지 있다.
먼저 원본 구절을 안 버린다. 그래프를 만들긴 하지만 검색 결과는 원래 구절이다. PPR 노드 확률을 구절로 모아서 순위를 매긴다.
그래프는 색인이고 저장소가 아니다. 해마도 기억을 직접 저장하지 않고 신피질의 기억을 가리키는 색인만 갖고 있다고 하니까, 이론을 그대로 옮겼다. 원본을 남기느냐는 나중에 볼 Rate-Distortion에서 다시 나온다.
스키마도 없다. 논문이 schemaless knowledge graph라고 적었다. 스키마를 안 정하니까 뭘 버릴지 미리 정하지 않는다.
대신 그래프가 OpenIE를 돌린 모델에 묶인다. REBEL이랑 GPT-3.5의 트리플 수가 두 배 차이 난다.
-> 색인 모델을 바꾸면 그래프를 다시 만들어야 하는 거 아닌가??
모델을 바꿀 때 메모리가 어떻게 되는지는 나중에 볼 Memory Portability에서 다룬다.
검색 비용도 낮다. 색인은 오프라인이고 질의할 때는 PPR만 돈다. IRCoT보다 6~13배 빠르다. 검색이 느린 메모리 시스템이 뒤에서 볼 Anatomy에서 나오는데, 그거랑은 차이가 크다.
다중홉 질문을 볼 때는 R@k만 보지 말고 AR(all-recall)도 같이 보는 게 좋을 것 같다.
PPR은 그래프 구조가 필요해서 벡터 DB만 있는 환경에 바로 얹기는 어렵다. 질의에서 엔티티를 뽑고 그 엔티티로 다시 검색하는 2단 구조는 그래프 없이도 되니까, path-finding 일부는 그걸로도 나아지지 않을까?
다음은 LongMemEval이다. 장기기억을 다섯 능력으로 쪼개고, 메모리 설계를 indexing·retrieval·reading 세 단계 네 제어점으로 나눈 벤치마크다.
Leave a comment