
REFLEX Paper review
REFLEX with Jev for Efficient Selective Control in LLM Agents
https://arxiv.org/abs/2609.26532
REFLEX는 Nanyang Technological University 에서 만든 에이전트 구조다.
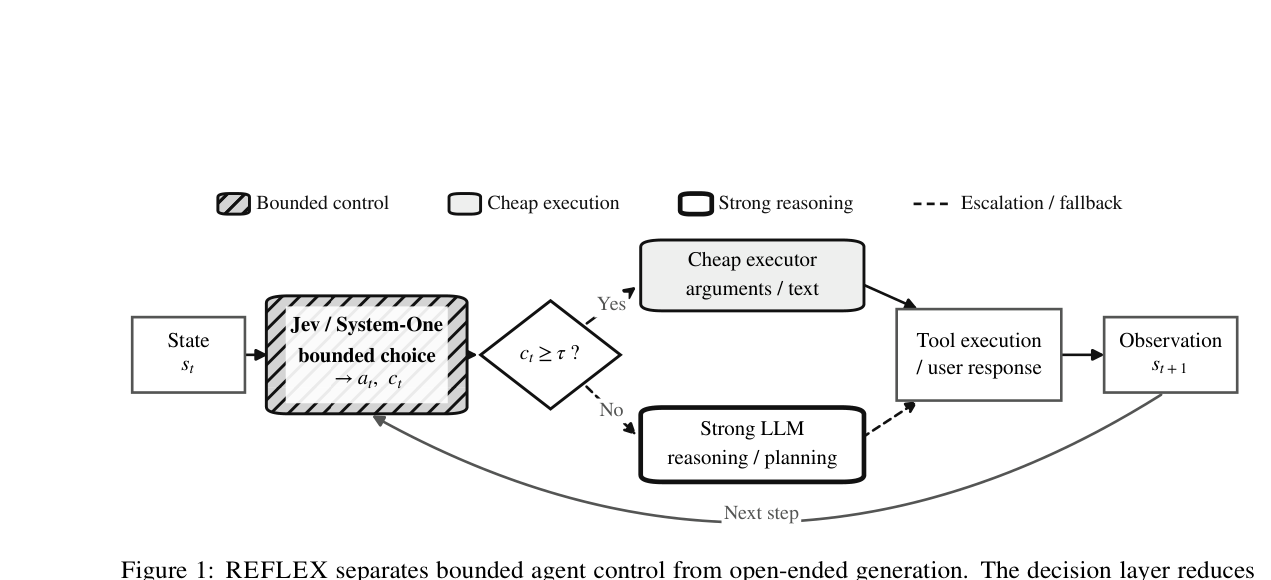
매 스텝마다 강한 LLM 을 부르는 대신, 도구 고르기·계속할지 말지 같은 유한한 선택은 Jev 라는 결정 모델이 먼저 맡고, 확신이 낮거나 글을 써야 할 때만 강한 LLM 을 부른다.
저자는 2명이고, 2026년 9월 arXiv 에 올라온 논문이다.
앞에서 본 ARIA에서는 싼 모델이 언제 비싼 모델에게 물어볼지를 Q-table 로 배웠는데, 이 논문은 그 자리에 텍스트를 아예 생성하지 않는 모델을 놓고 어디까지 되는지를 잰다.
1. Introduction
도구를 쓰는 에이전트는 보통 생성형 LLM 하나가 거의 모든 스텝을 맡는다.
상태를 읽고, 도구를 고르고, 인자를 채우고, 계속할지 정하고, 답을 쓴다.
저자들은 이 중 많은 스텝이 “정해진 집합에서 하나 고르기”에 불과하다고 본다.
그러면 비싼 생성형 추론은 정말 필요한 상태에만 쓸 수 있지 않을까가 출발점이다.
Jev 는 TypeSafe AI 가 2026년에 공개한 “System One” 모델이다.
문자열을 생성하지 않고 타입이 정해진 확률적 결정을 돌려준다.
REFLEX 에서 Jev 는 선택지 하나와 확신도를 내고, 확신도가 높으면 바로 실행하고 낮으면 강한 LLM 에 넘긴다.
introduction 에 적힌 결과는 두 갈래다.
자체 벤치마크 REFLEX-Sim 100개 과제에서는 성공률 95%에 강한 모델 호출이 72.7% 줄었고, 강한 모델을 세 종류로 바꿔도 66~72% 감소가 유지됐다.
외부 벤치마크 BFCL 과 τ-style 과제에서는 싼 LLM 이 스스로 올리는 캐스케이드와 비교해 우위가 없었다.
-> 논문이 abstract 부터 부정적 결과를 같이 내놓는 구조다. 어디서 안 되는지를 같이 보고하는 논문은 읽을 때 믿을 범위를 정하기 쉽다.
2. Related Work
비용 인식 라우팅(FrugalGPT, RouteLLM, RouterBench, LLMRouterBench)은 질의마다 모델을 고르는 문제고, REFLEX 는 한 궤적 안에서 두 추론 방식이 번갈아 나오게 한다.
도구 사용 평가는 BFCL, DialogTool, τ-bench, τ²-bench 를 쓰는데, BFCL 로는 도구 선택 자체가 병목인지를, τ 계열로는 궤적 전체가 좋아지는지를 본다.
확신도 기반 선택적 예측 연구를 이어받아, 정확도 외에 risk-coverage 관계도 같이 보고한다.
3. REFLEX
3.1 Agent control as a selective decision problem
스텝 $t$ 에서 관측 가능한 상태를 $s_t$, 허용된 유한 결정 집합(도구나 제어 동작)을 $A_t$ 라 하면 결정 모델 $J$ 는 선택지와 확신도를 돌려준다.
\[(\hat a_t, c_t) = J(s_t, A_t)\]정책은 확신도가 임계값 $\tau$ 이상이고 실행 가능하면 $\hat a_t$ 를 그대로 실행하고, 아니면 강한 LLM $L_{strong}(s_t)$ 에 넘긴다.
강한 모델은 열린 추론, 상태에서 결정적으로 못 얻는 인자, 사용자에게 보여줄 글을 맡는다.
타입 결정 모델은 글도 임의 인자도 못 만들기 때문에, 현실적인 다중 턴 평가에서는 Jev 와 강한 모델 사이에 싼 생성 실행기를 하나 더 둔다.
게이트의 두 결과는 역할이 다르다.
확신 높은 결정은 강한 모델 호출 하나를 없애고, 확신 낮은 결정은 억지로 행동하지 않고 제어권만 넘긴다.
그래서 REFLEX 는 fallback 모델의 능력을 유지한 채 “어느 상태에서 그 모델이 필요한지”만 바꾼다.
저자들이 검증하려는 것은 새 실패를 만들지 않고 혼자 처리할 수 있는 안정적인 상태 부분집합을 찾아내는지다.
모든 과제를 푸는지는 묻지 않는다.
3.2 Decision heads and execution semantics
한 에이전트 안에 섞여 있는 역할 세 가지를 나눈다.
Control 은 유한한 대안 중 고르기(어느 도구, 지금 행동해도 되는지).
Argument synthesis 는 고른 행동의 구조화된 값 채우기.
Generation/reasoning 은 자유 텍스트와 열린 정책 질문.
REFLEX 가 겨냥하는 것은 control 이다.
REFLEX-Sim 에서는 인자 대부분이 상태의 결정적 함수라 Jev 만으로 되고, 외부 다중 턴 환경에서는 싼 생성 실행기가 인자와 글을 채운다.
평가도 이 구분을 따른다.
도구 선택 오류, 인자 오류, 조기 종료, 정책 오류를 따로 기록하고, 복구 가능한 무효 결정과 되돌릴 수 없는 행동을 구분한다.
불필요한 검색 한 번과 돌이킬 수 없는 쓰기를 같은 오류로 세지 않겠다는 뜻이다.
계산량 지표는 강한 모델 호출 감소율 GMR 이다.
\[GMR = 1 - \frac{N^{REFLEX}_{strong}}{N^{strong\text{-}only}_{strong}}\]에피소드당 비용, 성공 에피소드당 비용, 성공 과제당 강한 호출 수도 같이 보고한다.
일찍 실패해서 싸 보이는 방법에 점수를 주지 않기 위해서다.
선택적 신뢰성은 임계값 $\tau$ 에서의 Risk(자율 실행된 결정 중 무효 비율)와 Coverage(자율 실행 비율)로 재고, risk-coverage 곡선 아래 면적 AURC 를 같은 coverage 의 무작위 escalation 과 비교한다.
싼 생성 모델도 스스로 “이건 강한 모델에 넘기자”고 할 수 있다.
이걸 baseline B3 로 두고, 논문은 처음부터 B3 를 중심 비교 대상으로 삼는다.
특화 결정 계층이 B3 보다 나을 거라고 가정하지 않는다고 못 박는다.
4. Experimental Setup
모델은 결정 계층에 버전 고정된 jev-1.13.0 API, 작은 생성 모델에 Qwen3.8-Flash, 강한 모델에 Qwen3.8-Max 를 쓴다.
cross-family 검증에서는 강한 모델만 Kimi K3 나 DeepSeek-V4-Pro 로 바꾸고 Jev·임계값·도구·평가기는 고정한다.
REFLEX-Sim 은 직접 만든 결정적 도구 환경이다.
직접 행동, 의미 기반 도구 선택, 짧은 워크플로, 정책이 걸린 행동, 추론이 많이 필요한 모호한 과제(C0~C4)를 덮는다.
채점은 종료 상태 assertion 과 정책 제약으로 하고, 참조 궤적과의 일치는 보지 않는다.
두 번의 평가기 감사를 거쳐 v1.2.0 으로 동결했고, 테스트셋은 held-out 100개 과제다.
비교 조건은 B0(Max 만), B1(Flash 만), B3(Flash 가 스스로 Max 로 올리는 캐스케이드), R1(REFLEX, $\tau \in {0.5, 0.7, 0.8, 0.9, 0.95}$)이다.
주 운영점은 $\tau = 0.5$ 이고, 이후 실험은 이 값을 고정한다.
통계는 과제 또는 시나리오 family 단위 paired cluster bootstrap(본 분석 10,000회)과 McNemar 검정을 쓴다.
RF-5C factorial 은 cardinality, ambiguity, 상호작용 대비를 사전 등록해서 결과를 보고 효과를 고르는 일을 막았다.
결정 복잡도 개입 실험은 행동 집합 크기 $K$ 와 구조적 모호성을 조작한다.
모호성은 “행동 $a$ 가 맞는 행동이 되려면 바꿔야 하는 상태·정책 사실의 개수” $d(a \mid s)$ 로 정의한다.
선언된 조건으로 정하니 모델 예측과 임베딩 유사도 양쪽에서 독립이다.
RF-5C 는 $K \in {10, 25, 50}$ 과 모호성 4단계를 60개 family 에 교차해 1,440개 결정을 만든다.
별도의 matched intervention 240개는 “정보를 더 모으는 경쟁 후보”를 “되돌릴 수 없는 쓰기 경쟁 후보”로 바꾸면서 정답, 거리, 후보 수, $K$, 의미 유사도는 고정한다.
외부 평가는 BFCL(Berkeley Function Calling Leaderboard, 함수 선택과 “함수를 불러야 하는지” 판단을 재는 벤치마크)과 τ-style 다중 턴 검증이다.
후자는 사용자 시뮬레이터를 붙여 60개 paired 과제 × 5조건 = 300 에피소드를 돌리고, 리더보드 제출이 아닌 외부 검증으로 다룬다.
5. Results
5.1 REFLEX improves the tradeoff between success and computation
동결된 REFLEX-Sim 100개 과제에서 조건별 성공률과 과제당 강한 모델 호출 수를 잰 표다.
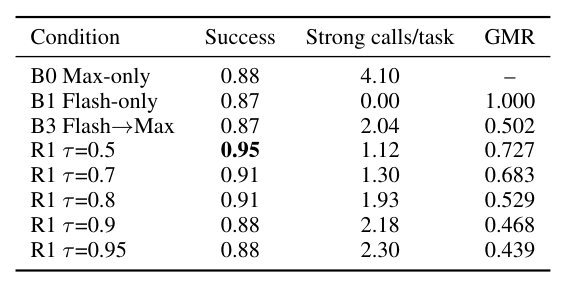
B0 는 성공률 88%, 과제당 강한 호출 4.10회다.
R1($\tau=0.5$)은 95%, 1.12회로 72.7% 감소다.
$\tau=0.9$ 와 0.95 에서는 B0 와 같은 88%를 2.18회, 2.30회로 맞춘다.
B3 캐스케이드는 87%에 2.04회라, 같은 벤치마크 안에서는 REFLEX 가 모든 임계값에서 B0 보다 Pareto 우위다.
확신도는 쓸 만하지만 완벽하진 않다.
$\tau=0.5$ 에서 escalation 없이 끝난 65개 에피소드는 전부 성공했고, 자율 결정 251개 중 250개가 유효했다(나머지 하나는 복구 가능).
AURC 는 0.019 로 같은 coverage 의 무작위 escalation(0.145)보다 약 7.6배 낮다.
반면 Brier 0.103, ECE 0.129 로 calibration 은 중간 수준이다.
저자들은 이득의 본질이 calibration 이 아니라 “혼자 해도 되는 결정을 가려내는 능력”에 있다고 본다.
paired 결과를 보면 R1 과 B0 둘 다 87개를 풀고, R1 만 푼 게 8개, B0 만 푼 게 1개, 둘 다 실패 4개다(McNemar p=0.0391).
어떤 결정이 대체되는지 보면 도구 선택 99%, 완료 판단 77%, 검색 여부 56%, 명확화 질문 28% 순이다.
정형화된 제어는 넘기기 쉽고, 권한에 걸린 판단과 명확화는 어렵다.
-> 성공률이 B0 보다 오른 건 좀 이상하다. Jev 가 8개를 더 푼 건지, Max 가 혼자 돌 때 쓸데없는 스텝을 밟다 망가지는 건지 본문만으로는 모른다. 부록 Table S8 도 개수만 준다. ??
5.2 Reliability depends on decision structure
행동 집합 크기 $K$ 와 구조적 모호성 A0~A3 에 따른 정확도를 60개 family 에서 잰 heatmap 이다.
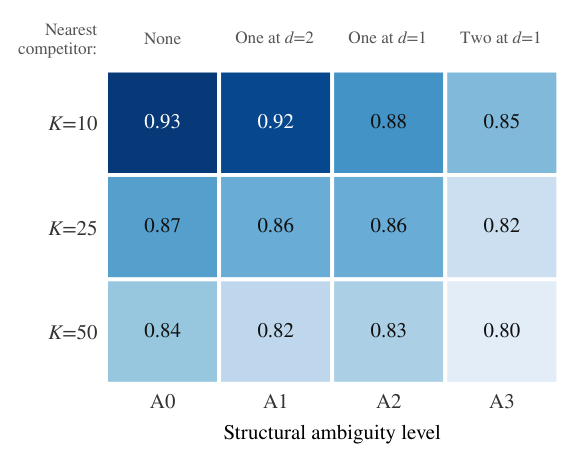
$K$ 를 10에서 50으로 늘리면 정확도가 6.7포인트 떨어진다(95% CI [−11.3, −2.5], p=0.0008).
A0 에서 A3 로 가면 5.6포인트 떨어지고(CI [−11.9, −0.3], p=0.038), 둘의 상호작용은 유의하지 않다.
후보 수를 늘리는 효과(−3.3)가 거리를 줄이는 효과(−1.1)보다 커 보이지만 둘 다 구간이 0을 포함해서 어느 쪽이 더 센지는 말할 수 없다.
이 효과는 모든 결정 유형에 걸치지 않는다.
오류 208개 중 192개가 control 결정(risk 117, clarification 75)에서 나왔고, 검색·보통 도구 선택·워크플로 결정 720개에서는 오류가 0개다.
60개 family 중 39개는 천장에 붙어 있고 21개만 정보가 있다.
risk family 를 빼고 다시 추정하면 $K$ 효과가 −2.7포인트로 줄고 구간이 0을 포함한다.
그래서 저자들은 결론을 좁힌다.
행동 집합 크기와 가까운 대안은 “지금 행동할 권한·정보가 충분한가”가 문제일 때만 중요하다.
임베딩 유사도가 이런 모호성을 못 잡는다는 감사도 있다.
후보 5,931개에서 정답과의 중앙 유사도가 one-change 경쟁자 0.310, two-change 0.333, 먼 distractor 0.237 이다.
절차상 더 먼 two-change 쪽이 더 비슷하고, 먼 distractor 의 22.2%가 가까운 경쟁자 중앙값(0.322)을 넘는다.
-> 벤치마크를 만들 때 “헷갈리는 오답”을 임베딩 유사도로 뽑는 관행에 대한 반례다. 유사도가 높은 오답과 조건 하나만 다른 오답은 다른 종류의 어려움이다.
5.3 Competitor type changes the consequences of errors
경쟁 후보가 “읽기”일 때와 “쓰기”일 때, 결정당 오류 유형의 비율을 잰 그림이다.
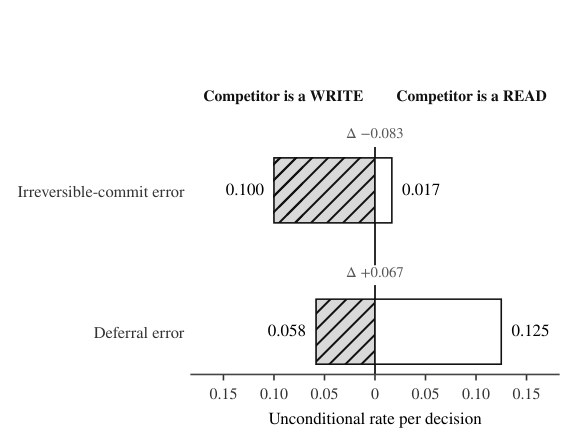
정확도는 쓰기 경쟁자 0.833, 읽기 경쟁자 0.842 로 차이가 없다(+0.008, p=0.872).
그런데 되돌릴 수 없는 커밋 오류는 쓰기 쪽 10.0%, 읽기 쪽 1.7%(Δ −0.083, p=0.0014)이고, deferral 오류는 5.8% 대 12.5%(Δ +0.067, p=0.0016)다.
읽기 선택지가 옆에 있으면 모델은 그쪽으로 미루고, 쓰기 선택지가 옆에 있으면 그쪽으로 저지른다.
이 실험은 저자들의 앞선 탐색 연구(RF-5)의 관찰도 뒤집는다.
RF-5 에서는 오류 366개 중 219개(59.8%)가 deferral 이었고 $K$ 가 커질수록 그 비율이 늘었다.
RF-5C 에서는 208개 중 24개(11.5%)만 deferral 이다.
그래서 “이 라우터는 미루는 경향이 있다”는 일반 주장은 철회했다.
-> 이 절의 메시지가 이 논문에서 가장 쓸모 있다. 도구 선택 정확도가 같은 두 에이전트가 운영에서는 전혀 다르게 사고를 친다는 것. 벤치마크 점수가 같다고 끝이 아니다.
5.4 External benchmarks show where the benefits are limited
왼쪽은 BFCL 에서 함수 선택과 관련성 판단의 정확도, 오른쪽은 τ²-bench 에서 에피소드당 비용 대 성공률이다.
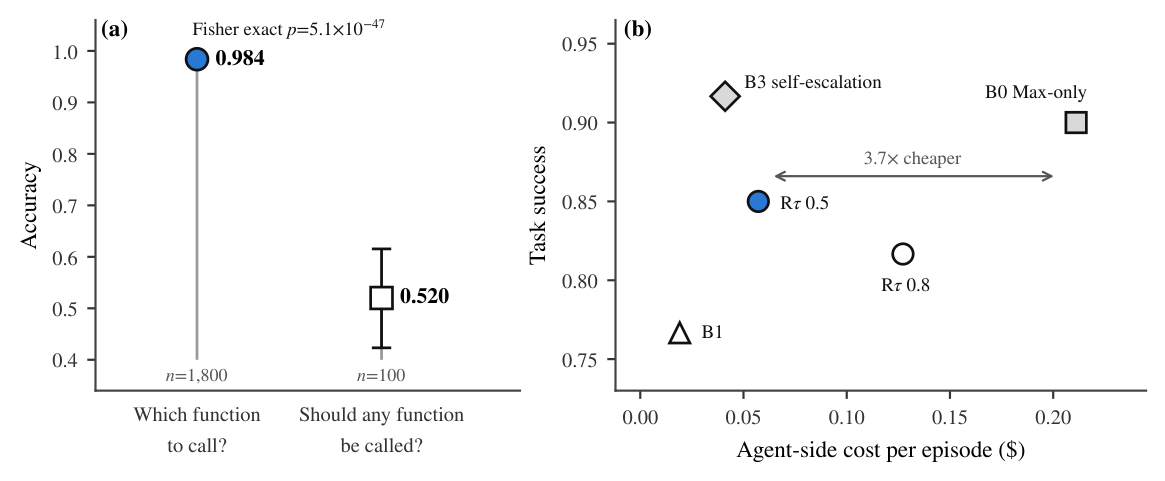
BFCL 에서 “어느 함수를 부를까”는 1,800개 결정에서 98.4%다.
“함수를 불러야 하나”는 100개 사례에서 52.0%다(Fisher p=5.1×10⁻⁴⁷).
후보를 2개에서 64개로 늘려도 99.0%에서 98.7%로 거의 안 변하고, 29개 오류 중 추가한 먼 distractor 를 고른 건 0개다.
다만 틀린 호출의 평균 확신도가 0.778 이라 $\tau=0.7$ 게이트로는 못 거른다.
τ²-bench v1.0.1 세 도메인, 60개 paired 과제 × 5조건에서의 시스템 비교는 이렇다.
REFLEX($\tau=0.5$)는 에피소드당 $0.0572 로 B0 의 $0.2111 보다 3.7배 싸고, 성공률은 0.850 대 0.900 이다(paired 차 −0.050, CI [−0.150, +0.050]).
B3 는 $0.0411 로 REFLEX 보다 더 싸고 성공률도 0.917 로 수치상 높다(차 +0.067, CI [−0.033, +0.167]).
어느 비교도 유의하지 않다.
실패 감사가 이유를 보여준다.
300 에피소드 중 45개 실패는 41개가 종료 DB 상태 불일치, 4개가 소통 실패다.
제어 선택 오류와 인자 생성 오류는 모든 조건에서 0개다.
고칠 라우팅 오류가 애초에 없으니 라우터가 끼어들 자리가 없다.
-> 비용 3.7배 절감을 홍보하기 쉬운데, B3 가 더 싸고 더 높다. 이 벤치마크에서 REFLEX 가 보여주는 건 “강한 모델만 쓰는 것보다 싸다” 하나뿐이다.
5.5 Strong-call reductions persist across fallback families
Jev 와 $\tau=0.5$ 를 고정하고 강한 모델만 바꾼 E6 실험이다.
호출 감소는 Qwen 71.9%, Kimi 71.4%, DeepSeek 66.1%.
성공률 차이는 +0.040, −0.020, 0.000 이고 구간은 [−0.010, +0.090], [−0.050, 0.000], [0.000, 0.000]이라 유의한 감소는 없다.
다만 사전 등록한 기준은 점추정이 −0.02 이상인지만 봤고, 정식 비열등 검정(하한이 −0.02 를 넘어야 함)으로는 Qwen 과 DeepSeek 만 통과하고 Kimi 는 통과하지 못한다.
Kimi 는 strong-only 가 100%라 REFLEX 98%는 두 과제 손실이다.
토큰 감소도 50.6~64.1%로 따라오고, 검증된 비용 감소는 Qwen 에서만 52.2%다.
같은 조건을 두 번 돌린 결과도 같이 보고한다.
temperature 0 에 같은 프롬프트인데도 Qwen strong-only 가 주 실험에서 0.88, E6 에서 0.91 이고, 6개를 잃고 9개를 얻은 결과다.
저자들은 이 3포인트 변동이 E6 의 성공률 차이와 같은 규모라, 한 번 돌린 결과의 작은 차이는 해석하지 말라고 적는다.
5.6 What does the gate identify?
강한 모델을 바꿔도 Jev 가 혼자 처리하는 과제 집합이 같은지를 본 표다.
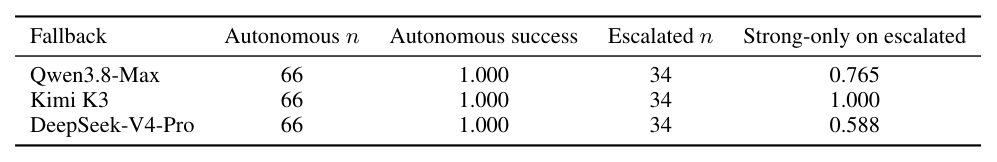
세 fallback 모두에서 같은 66개 과제가 Jev 만으로 끝나고, 66개 전부 성공한다.
E6 의 REFLEX 실패는 전부 escalation 이 필요한 34개 안에서 난다.
DeepSeek 는 strong-only 와 REFLEX 가 정확히 같은 86개를 푼다.
게이트는 뒤에 어떤 모델이 있는지 모르고, 과제 자체로 계산을 거른다.
모델 능력 차이는 나머지 34개에서만 드러난다(strong-only 기준 Kimi 100%, Qwen 76.5%, DeepSeek 58.8%).
절감이 66개 과제에서만 오는 것도 아니다.
escalation 이 한 번이라도 있었던 에피소드 안에서도 Jev 가 Qwen 26.2%, Kimi 26.8%, DeepSeek 21.3%의 스텝을 강한 호출 없이 처리한다.
세 REFLEX 조건의 실패 21개(Qwen 5, Kimi 2, DeepSeek 14) 중 잘못된 자율 결정을 포함한 건 없다.
감사는 실패 원인을 escalation 뒤의 fallback 처리로 돌린다.
-> 이 결과가 이 설계의 실제 가치다. 게이트가 특정 강한 모델을 흉내 내는 게 아니라 과제의 성질을 보고 자르니, 뒤 모델을 갈아 끼워도 앞단을 다시 튜닝할 필요가 없다. 모델 교체가 잦은 운영에서는 이 성질이 비용 절감보다 중요할 수 있다.
6. Discussion
저자들은 세 가지로 정리한다.
첫째, 유한한 제어는 별도의 계산 형태로 분리할 수 있다.
REFLEX-Sim 에서 66% 부분집합이 세 fallback 에서 실패 0으로 자율 처리됐다.
둘째, 이득은 어려움의 출처에 달렸다.
BFCL 은 함수 선택이 이미 거의 완벽하고, τ²-bench 는 도구 선택·인자 오류가 0개라 라우터가 고칠 게 없었다.
그럴 때는 싼 캐스케이드가 경쟁력이 있고, 이는 복잡한 라우터가 단순 baseline 을 꾸준히 이기지 못한다는 LLM 라우팅 쪽 증거와 맞는다.
셋째, 정확도만 보면 제어 오류의 차이를 놓친다.
권한 경계 근처에서는 큰 후보 집합과 구조적 모호성이 신뢰성을 떨어뜨리고, 경쟁 후보의 종류는 오류를 커밋과 deferral 사이에서 옮긴다.
특화 결정 계층을 쓸 조건도 셋으로 적는다.
궤적의 상당 부분이 반복되는 유한 결정이어야 하고, 확신도가 자율 실행 가능한 상태를 가려내야 하며, 벤치마크가 제어 결정의 불확실성을 반영해야 한다.
벤치마크에 대한 제안도 있다.
정답 행동뿐 아니라 그 행동이 왜 지금 유효한지(필요한 증거, 권한 상태, 되돌릴 수 있는지, 더 물어봐도 되는지)를 주석으로 달자고 한다.
7. Conclusion
REFLEX 는 유한 제어와 열린 추론을 분리한다.
cross-family 비교에서 강한 호출을 약 3분의 2 줄였고, 성공률 차이는 −2포인트에서 +4포인트 사이였다.
유의한 감소는 없지만 비열등 기준은 Qwen 과 DeepSeek 만 통과했다.
신뢰성을 제한하는 건 권한에 달린 커밋 결정이고, 보통의 도구 선택은 문제가 안 된다.
BFCL 과 τ²-bench 는 라우팅이 이미 거의 완벽하면 싼 캐스케이드로 충분하다는 보완적 부정 결과를 준다.
Limitations
결정 모델은 독점 모델 Jev 하나다.
E6 도 강한 모델만 바꿨으니, 다른 비생성 결정 모델이 같은 선택적 제어 행동을 보이는지는 알 수 없다.
2026년 프런티어 모델에서는 천장 효과가 여럿 있다.
Kimi 는 REFLEX-Sim 에서 100%고, BFCL 함수 선택은 거의 완벽하다.
RF-5C 의 효과는 권한·위험 family 에 몰려 있어 모든 에이전트 결정으로 일반화하면 안 된다.
τ 평가는 300 에피소드 held-out 검증이고 다중 시도 리더보드 평가가 아니며, 네이티브 보상이 절차 차이를 놓칠 수 있다.
API 비용은 날짜가 박힌 스냅샷이라 가격·캐싱·리전에 따라 달라진다.
8. 지금 관점: 싼 모델 캐스케이드로 충분한가
ARIA는 싼 생성 모델이 워크플로 신호를 보고 언제 비싼 모델을 부를지를 배웠다.
이 논문의 B3 가 거의 그 자리다.
REFLEX 는 거기서 한 발 더 가서 “고르는 일은 생성 모델도 과하다”고 묻는다.
ReAct 루프의 Thought → Action 에서 Action 고르기만 떼어내 다른 모델에 준 셈이다.
답은 자체 환경에서는 좋았고, 외부 두 벤치마크에서는 B3 와 구분이 안 됐다.
지금 가져다 쓸 수 있는 부분은 Jev 보다 평가 쪽이다.
도구 선택 정확도와 “지금 행동해도 되는가” 정확도를 따로 재는 것, 오류를 되돌릴 수 있는 것과 없는 것으로 나누는 것, 경쟁 후보가 읽기인지 쓰기인지에 따라 실수의 방향이 바뀐다는 것.
현재 에이전트 평가 대부분이 “맞는 도구를 골랐나”를 세는데, 이 논문의 BFCL 결과는 그 숫자가 이미 98%라 변별력이 없다고 말한다.
권한 경계에서 쓰기 도구가 옆에 있을 때 얼마나 저지르는지를 재는 쪽이 운영 사고와 더 가깝다.
그대로 받아들이기 어려운 부분도 분명하다.
Jev 는 독점 API 하나라 재현이 안 되고, 비용 절감이 검증된 건 Qwen 한 family 뿐이다.
REFLEX-Sim 은 저자들이 만든 환경이고, 인자 대부분이 상태의 결정적 함수라는 전제가 깔려 있다.
실제 에이전트에서 인자는 대개 글이라 싼 생성 실행기가 어차피 들어가야 하고, 그러면 B3 와의 차이는 더 줄어든다.
τ²-bench 에서 B3 가 더 싸고 더 높았다는 결과는, 지금 당장 프로덕션에서 고를 선택지는 결정 모델이 아니라 “싼 LLM 에게 스스로 올리게 하기”라는 뜻으로 읽힌다.
다만 5.6절의 “뒤 모델을 바꿔도 같은 66개를 혼자 처리한다”는 성질은 B3 에는 없다.
모델 교체가 잦고, 결정 유형이 정형화된 도구 라우팅 위주인 시스템이라면 결정 계층을 따로 두는 게 맞을 수 있다.
그 판단은 자기 궤적에서 escalation 없이 끝나는 비율과 권한 결정의 비율을 먼저 재 보고 해야 한다.
Leave a comment