
Component Routing Paper review
Not All Experience Belongs in the Weights: Component Routing for Self-Improving GUI Agents
https://arxiv.org/abs/2610.01787
Component Routing 은 South Dakota State University 에서 만든 경험 배치 방법이다.
GUI 에이전트가 과제를 돌면서 남긴 궤적을 통째로 파인튜닝하거나 통째로 검색해 넣는 대신, 네 종류의 조각으로 쪼개서 조각마다 가중치와 컨텍스트 중 어디에 넣을지를 정한다.
저자는 3명이고 2026년 10월 1일에 arXiv 에 올라온 논문이다.
앞에서 본 Experience-Following에서는 메모리에 무엇을 넣느냐가 행동을 바꾼다는 걸 봤는데, 이 논문은 같은 경험이라도 어디에 넣느냐에 따라 득이 갈린다는 쪽을 잰다.
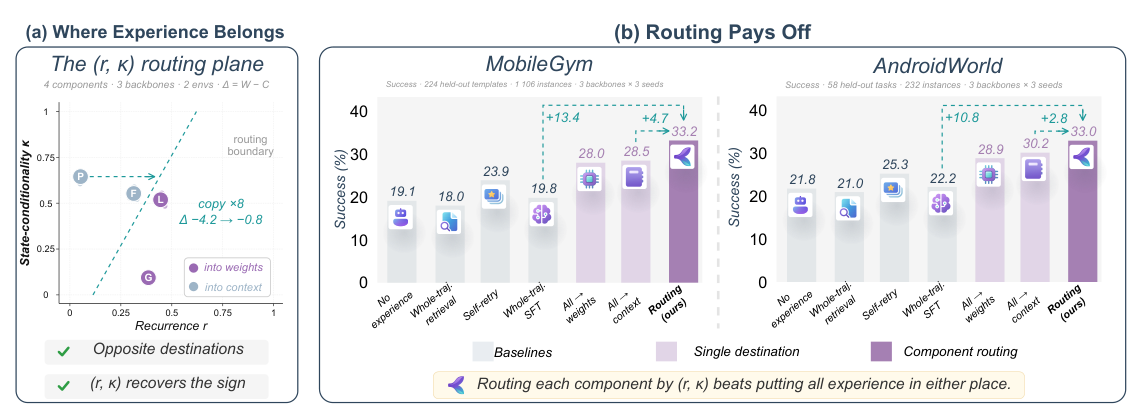
네 조각이 두 속성 평면 위에서 어디에 놓이는지와, 규칙대로 나눠 넣었을 때 점수가 얼마나 오르는지를 한 장에 담은 그림이다.
1. Introduction
폰과 데스크톱을 조작하는 GUI 에이전트는 자기 궤적으로 개선하는 쪽으로 가고 있다.
과제를 한 묶음 돌리고, 궤적을 남기고, 그 경험을 에이전트에게 돌려준다.
돌려주는 길은 둘로, 성공한 궤적으로 파인튜닝해서 가중치에 쓰거나, 궤적이나 거기서 뽑은 노트를 라이브러리에 두고 프롬프트로 검색해 넣는다.
둘을 비교한 연구들은 결론이 엇갈린다.
도구 과제에서는 내재화한 힌트가 프롬프트를 이기고, 웹 과제에서는 프롬프트 쪽 갱신이 그래디언트 갱신을 이기고, 같은 스킬 표현이 한 과제에서는 돕고 다른 과제에서는 해친다.
저자들은 이 불일치를 경험의 단위 탓으로 본다.
궤적 하나에는 성질이 다른 항목들이 섞여 있어서, 묶음 전체에 대한 결론은 그 섞임 비율에 따라 달라진다.
MobileGym 에서 8B 에이전트의 풀 전체를 가중치에 넣으면 held-out 성공률이 7.1점, 컨텍스트에 넣으면 8.0점 오른다.
그런데 가중치에서 가장 많이 얻는 조각이 컨텍스트에서는 가장 적게 얻는다.
가장 작은 예시가 Figure 2 다.
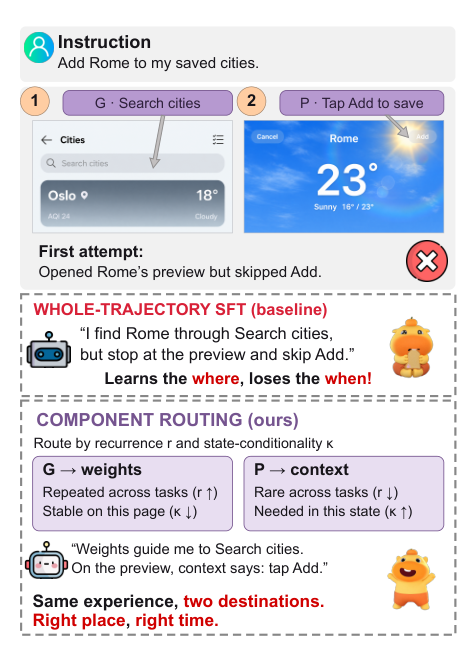
날씨 앱에서 도시를 저장하는 궤적 하나에는 검색창 위치와, 미리보기 화면에서 Add 를 눌러야 저장된다는 사실이 같이 들어 있다.
그림의 말로는 “Learns the where, loses the when!” 이다.
어디에 넣을지 정하려면 학습 전에 잴 수 있는 조각의 속성과, 두 목적지가 같은 항목을 소비하고 같은 held-out 과제에서 읽히는 비교가 필요하다.
기존 비교는 파이프라인 전체끼리 붙여서 목적지보다 항목이 먼저 달라지고, 조각 단위로 묻는 연구는 없다.
그래서 경험을 locator(요소 위치), procedure(절차), state fact(상태 조건), lesson(실패 교훈) 네 조각으로 나눈다.
각 조각은 학습 전에 풀에서 잰 두 속성으로 특징짓는다.
recurrence(반복 빈도)는 그 키가 무관한 과제에서 얼마나 자주 다시 나오는가, state-conditionality(상태 의존도)는 그 유용함이 현재 상태가 원래 상태와 맞는지에 얼마나 달려 있는가다.
각 조각을 같은 항목, 같은 held-out 인스턴스에서 컨텍스트로, 가중치로, 또는 양쪽으로 보내고, 세 백본 패밀리와 두 환경에서 비교한다.
결과 세 가지를 미리 적으면 이렇다.
route gain(가중치 성공률 빼기 컨텍스트 성공률)은 locator +4.9, lesson +1.5, procedure −4.2, state fact −4.1 이다.
두 속성으로 맞춘 규칙은 시험 백본을 빼고 맞춰도 24칸 중 24칸에서 부호를 맞히고, 학습량을 8배로 늘리면 procedure 가 가중치 쪽으로 3.5점 움직이며, state fact 에서 상태 조건을 빼면 3.4점 잃는다.
규칙대로 나눠 넣으면 백본마다 더 나은 단일 목적지보다 평균 3.5점, 반대로 배정한 것보다 7.8점 높다.
2. Related Work
관련 연구는 세 묶음으로 정리한다.
경험을 돌려주는 두 길(파인튜닝과 검색)을 비교한 연구들은 결론이 엇갈리고, 변동성으로 라우팅하거나 두 길을 한 예산 안에서 같이 돌리는 시스템도 있는데 전부 궤적 하나를 단위로 삼는다.
GUI 에이전트의 경험 형태 연구들은 스킬·스킬 카드·hindsight 재라벨 경험·인터페이스 변화를 견디는 메모리처럼 한 형태와 한 목적지를 고정한다.
생산자·소비자 연구들은 누가 경험을 만들고 누가 쓰느냐에 따라 득이 달라진다고 보고하지만 순효과만 보고한다.
이 논문은 그걸 정보 격차와 정책 격차로 나눠 잰다.
3. Experimental Setup
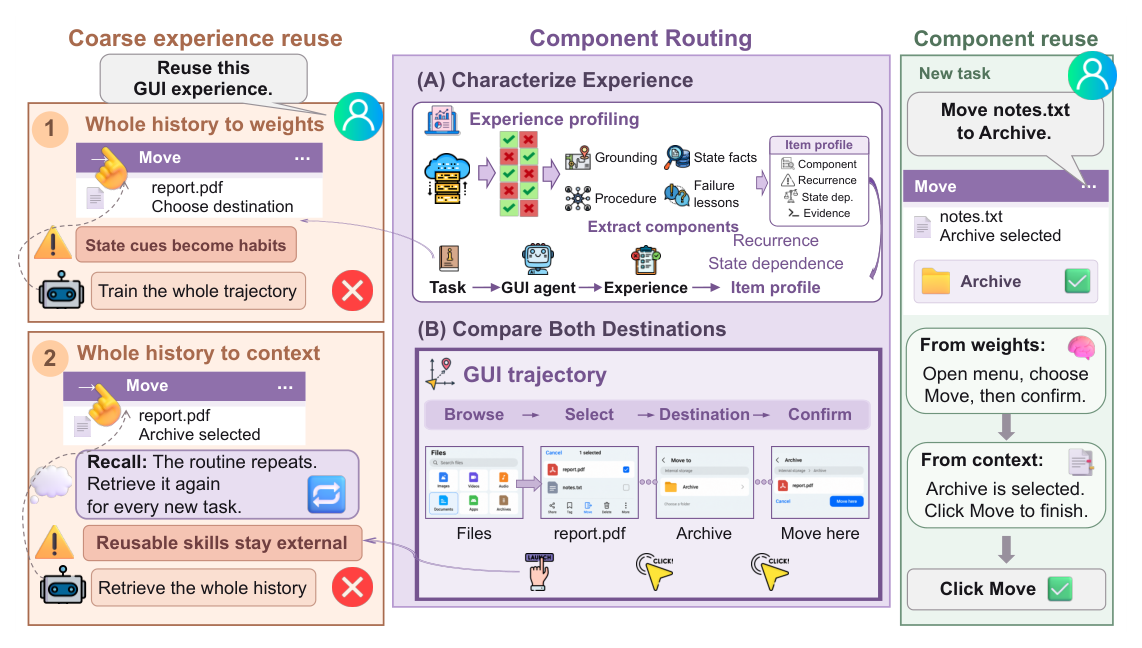
전체 흐름은 Figure 3 에 있다.
문제 정의
에이전트가 고정된 앱 집합에서 과제를 한 묶음 돌리고, 성공·실패 가리지 않고 모든 궤적을 남긴다.
스텝마다 스크린샷, 구조화된 앱 상태, 화면 요소, 액션과 대상 요소를 기록하고, 이 묶음이 experience pool 이다.
추출기가 풀을 네 항목 집합으로 나누고, 항목마다 에피소드를 가로질러 같은 항목임을 식별하는 키를 붙인다.
context route 는 매 스텝 항목을 프롬프트로 검색해 넣고, weights route 는 그 항목으로 파인튜닝하고, 공존 arm 은 둘 다 한다.
재는 양은 route gain 이다.
같은 held-out 인스턴스에서 짝지은 차이이고, 양수면 그 조각은 가중치가 낫다는 뜻이다.
네 조각
항목마다 키, 컨텍스트가 제공하는 노트, 가중치가 학습하는 샘플이 있다.
locator 는 어떤 이름의 요소가 화면 어디에 있는지다. 키는 (앱, 역할, 요소 이름), 샘플은 스크린샷과 그 요소 클릭의 쌍이다.
procedure 는 과제 패밀리 안에서 반복되는 짧은 액션 대상 연쇄다. 키는 연속 대상 셋, 노트는 서브골 순서, 샘플은 서브골을 thought 로 두고 다음 액션을 예측하는 것이다.
state fact 는 액션이 성공하려면 먼저 성립해야 하는 전제조건이다. 같은 대상에 대한 실패 시도와 성공 시도에서 뽑고, 키는 (앱, 대상, 술어)다.
lesson 은 어떤 상태에서 실패한 액션과 나중에 거기서 성공한 액션의 쌍이다. 샘플은 preference pair 다.
추출기는 규칙 기반이다.
상태 서명과 두 속성
상태는 앱 라우트와 환경 상태의 경로-값 쌍 집합(타임스탬프 같은 휘발 필드 제외)으로 요약한다.
AndroidWorld 는 앱 상태가 노출되지 않아 보이는 접근성 노드 집합을 쓴다.
같은 앱의 스텝끼리 Jaccard 유사도(두 집합의 교집합 크기를 합집합 크기로 나눈 값)로 비교해서 0.9 이상이면 exact, 0.5 이상 0.9 미만이면 relaxed 매치다.
recurrence 는 항목이 나온 에피소드와 같은 앱이면서 다른 템플릿인 에피소드 중 그 키가 다시 나오는 비율이다.
state-conditionality 의 사전 추정치는, 키가 같은 두 발생의 payload(locator 의 위치, procedure 의 다음 대상)가 exact 매치에서 일치하는 비율 대비 relaxed 매치에서 일치하는 비율이 얼마나 떨어지는가다.
컨텍스트 route 를 exact 만으로, relaxed 만으로 돌린 뒤 컨텍스트 이득 중 exact 매치가 필요한 몫을 온라인 값 κ 로도 잰다.
두 값 모두 풀만 있으면 학습 전에 나온다.
두 목적지
컨텍스트 route 는 항목을 앱과 키로 색인한 라이브러리에 둔다.
매 스텝 같은 앱의 항목을 현재 상태와의 Jaccard 로 순위 매겨 상위 다섯 개를 노트로 프롬프트 끝에 붙이고, 나머지 프롬프트는 base 에이전트와 글자 단위로 같다.
가중치 route 는 같은 항목의 샘플로 LoRA(가중치 전체 대신 저랭크 행렬만 학습하는 방법)를 모든 백본에 한 설정으로 학습한다.
lesson 은 DPO(선호 쌍으로 직접 학습하는 방법), 나머지는 SFT 다.
기준 arm
경험 없음, 성공 궤적 전체 SFT, 유사 궤적 1개 검색, 과제 유사도로 스텝 기록 10개 검색, context-then-distill, 세 번 시도 중 에이전트가 완료를 선언한 첫 시도를 쓰는 self-retry 가 있다.
다른 앱의 무작위 노트, 키와 내용을 섞은 노트, 라벨을 섞은 학습 샘플이 통제 arm 이고, 전부 컨텍스트·전부 가중치·규칙대로 라우팅이 종합 arm 이다.
평가
MobileGym 은 시뮬레이션 폰으로 앱 20개, 과제 템플릿 416개(학습 160, 테스트 256)이고 체커가 앱 상태를 목표와 비교한다.
앱 5개를 unseen 으로 빼고, 나머지 학습 템플릿 122개가 풀이 된다.
held-out 은 연습한 앱의 새 템플릿 165개와 unseen 앱 템플릿 59개, 시드당 1,106개의 짝지은 인스턴스다.
AndroidWorld 는 실제 앱 20개에 과제 116개이고, 12개 앱이 경험을 주고 8개는 held-out, held-out 과제 58개를 네 번씩 돌려 시드당 232개 인스턴스다.
성공 여부는 환경의 결정적 체커가 정하고 모델 judge 는 없다.
차이는 인스턴스 단위 paired bootstrap(1만 회, 95% 구간)으로 읽는다.
생산자와 소비자는 같은 모델이고, GUI-Owl-1.5-8B, ScaleCUA-7B, Qwen3-VL-8B 세 패밀리이며, 생산자-소비자 측정에는 Qwen3-VL 4B·8B·32B 사다리를 쓴다.
시드는 세 개이고 분석은 실행 전에 고정했다.
4. Observations
규칙을 맞추기 전에 풀과 두 목적지가 보여주는 것을 먼저 적는 장이고, 모든 이득은 같은 held-out 인스턴스에서 짝지은 차이다.
4.1 Components Split by Destination
조각별·백본별·환경별 route gain 과, 풀이 두 속성 평면 위에 어떻게 놓이는지를 그린 그림이다.
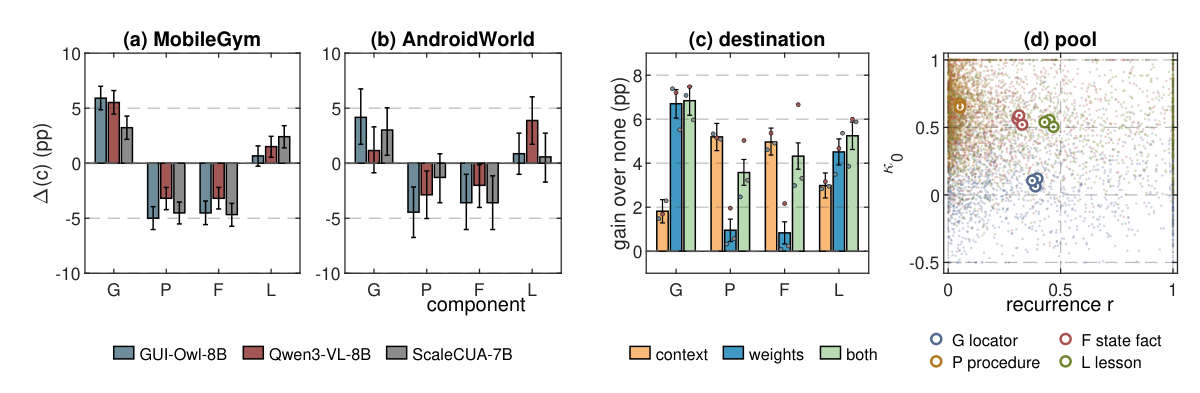
locator 는 모든 백본, 두 환경 모두에서 가중치가 낫다(MobileGym 백본 합산 +4.9).
procedure 와 state fact 는 컨텍스트가 낫다(−4.2, −4.1).
lesson 은 가중치 쪽으로 기울지만 절반의 칸에서 구간이 0 을 포함한다(+1.5).
MobileGym 12칸은 세 패밀리가 다 일치하고, 화면에서 상태를 읽는 AndroidWorld 는 더 넓은 구간으로 같은 패턴을 반복한다.
두 목적지 모두 모든 조각을 돕는다.
base 대비 컨텍스트는 +1.8~+5.2, 가중치는 +0.8~+6.7 인데, 어느 쪽이 더 돕느냐가 다르다.
locator 는 가중치 +6.7 대 컨텍스트 +1.8, procedure 는 컨텍스트 +5.2 대 가중치 +1.0 이다.
학습된 모델 위에 노트를 얹으면 locator 는 +0.1, state fact 는 +3.5 라, 공존은 가중치가 이미 이기는 곳에서는 거의 더하지 않는다.
학습 전부터 조각은 다르다.
procedure 는 과제 패밀리 밖에서 거의 반복되지 않고(평균 recurrence 0.05) 상태 의존적이다(0.66).
locator 는 반복되고(0.39) 상태에 거의 안 매인다(0.10).
state fact 와 lesson 은 반복되고(0.32, 0.45) 상태 의존적이다(0.56, 0.53).
세 백본 모두 각 조각을 평면의 같은 영역에 놓는다.
-> lesson 의 +1.5 는 구간이 0 을 걸치는 칸이 절반이다. 네 조각 중 lesson 의 목적지가 가장 약하게 정해져 있고, 뒤의 규칙 절에서 경계가 바로 lesson 과 state fact 사이를 지나는 것과 맞물린다.
4.2 Producer and Consumer
Qwen3-VL 패밀리를 크기별로 따라가며, 모든 procedure 어댑터가 같은 샘플 수로 학습하는 별도 배치에서 잰다.
컨텍스트로 읽는 procedure 는 누가 만들었든 모든 소비자를 돕고, 큰 생산자가 더 돕는다.
8B 소비자는 자기 procedure 에서 +3.6, 32B 의 것에서 +4.8, 4B 의 것에서 +2.2 를 얻고, 32B 소비자도 8B 의 procedure 에서 +3.2 를 얻는다.
같은 항목을 가중치에 쓰면 규칙이 다르다.
8B 소비자를 4B 의 procedure 로 파인튜닝하면 −2.3, 32B 의 것으로 −1.4, 다른 패밀리의 것으로 −7.5 인데, 자기 것은 +0.9 다.
손상은 정보가 아니라 정책 불일치에서 온다.
같은 다른 패밀리 풀을 컨텍스트로 읽으면 +3.6 이고, 그 생산자를 소비자의 성공 사례로 재학습시키면 가중치 route 가 −2.0 까지 돌아온다.
전이 항목 없이 소비자 자신의 procedure 로만 파인튜닝하면 +0.6 이고 전체 샘플로는 +0.9 라, 가중치 이득의 대부분은 연습이다.
Observation 2 는 노트는 누가 만들었든 돕고 강한 생산자일수록 더 돕는 반면, 파인튜닝은 생산자와 소비자가 같은 모델일 때만 돕고 그 이득의 대부분이 자기 궤적 연습이라는 것이다.
4.3 Readout after Training
결정 스텝을 노트 있이, 없이 다시 돌려 액션이 바뀌는지 보는 readout probe 의 결과다.
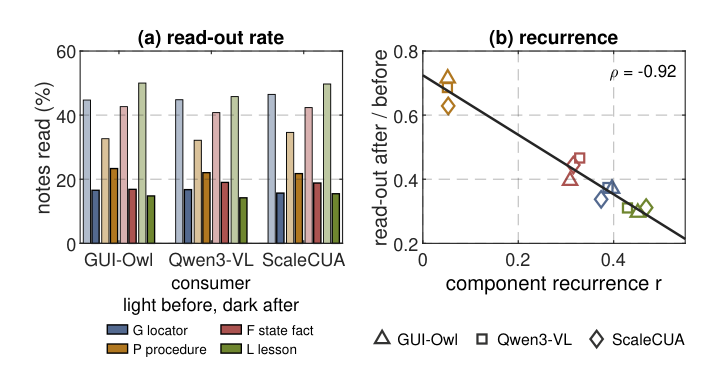
학습 전에는 노트가 probe 스텝의 42% 에서 액션을 바꾼다(procedure 33% 에서 lesson 48% 까지).
같은 항목이 가중치에 들어간 뒤에는 locator 16%, lesson 15% 로 떨어지지만 procedure 는 22% 까지만 떨어진다.
후/전 비율은 조각의 recurrence 와 함께 떨어진다(Spearman −0.92).
한 조각 안에서도 그렇다. recurrence 로 삼등분하면 비율이 locator 는 0.73 에서 0.11 로, lesson 은 0.63 에서 0.11 로 떨어진다.
저자들의 해석은 중복이다.
노트는 가중치가 아직 갖지 않은 것을 담고 있을 때 읽히고, 반복되는 조각은 가중치가 흡수한다.
5. The Routing Rule
두 풀 측정값으로 규칙을 맞추고, held-out 백본 패밀리에서 시험하고, 개입·학습·버전 변화를 본다.
5.1 A Rule in Two Properties
점수는 $s_\theta(c) = \alpha\, r(c) - \beta\, \kappa_0(c) - \gamma$ 이고, 양 환경의 24칸 중 한 패밀리의 8칸을 빼고 나머지 16칸에서 route gain 의 부호에 맞춘다.
구간이 0 을 걸치는 칸은 맞춤과 채점에서 절반만 센다.
세 fold 가 주는 α 는 9.01~9.32, β 는 4.86~5.28, γ 는 0.70~0.94 이고, 전체 맞춤은 (11.29, 5.73, 1.28)이다.
held-out 규칙은 24칸 중 24칸에서 부호를 맞히고, 그중 19칸은 구간이 0 에서 떨어져 있다.
경계는 state fact 와 lesson 사이를 지난다.
locator 와 procedure 는 경계에서 멀고(전체 맞춤 점수 2.52, −4.45) state fact 와 lesson 은 가깝다(−0.89, 0.74).
lesson 과 state fact 를 항목 recurrence 로 경계에서 반으로 나누면 위 절반은 가중치, 아래 절반은 컨텍스트로 가고, route gain 은 lesson 이 +2.5 와 −1.8, state fact 가 +2.9 와 −2.1 이다.
세 패밀리의 열두 절반 모두 규칙이 실행 전에 준 쪽에 떨어진다.
검색에서 읽은 온라인 κ 는 MobileGym 12칸에서 사전 추정치와 순위가 맞고(Spearman 0.56), 모든 백본에서 procedure 와 state fact 를 lesson 과 locator 위에 놓는다.
5.2 Interventions
속성 하나를 바꾸면 조각이 규칙이 말하는 방향으로 움직인다.
키가 더 많은 과제에서 반복되면 가중치 route 에 샘플을 더 많이 내므로, recurrence 는 가중치에 ‘한 키가 받는 업데이트 횟수’로 닿는다.
procedure 항목을 파인튜닝 전에 8배 복사하면 항목은 하나도 바뀌지 않으면서 그 dose 를 재현하고, procedure 의 route gain 이 −4.2 에서 −0.8 로 움직이고 Qwen3-VL-8B 에서는 0 을 넘는다(+1.0).
8배를 recurrence 로 읽으면 약 0.42 로, 그 상태 의존도에서의 경계(약 0.44)에 못 미쳐 평균 route gain 은 음수에 머문다.
state fact 는 +3.6 움직여 Qwen3-VL-8B 에서 컨텍스트 route 에 닿는데, 학습률을 10배로 올리는 것만으로는 두 조각의 route gain 이 −3.3, −3.2 에 머문다.
상태 조건을 빼면 컨텍스트 이득이 대부분 사라진다.
같은 노트를 과제 텍스트로만 검색하면 state fact 가 3.4점, procedure 가 3.9점을 잃는다.
컨텍스트 route 가 이 두 조각에 사 주는 것은 payload 가 아니라 조건이다.
환경 상태 대신 보이는 화면 요소로 조건을 읽어도 대부분 유지된다(각 0.7점 손실, route gain −3.5, −3.5).
노트 키나 학습 샘플 라벨을 섞으면 base 에이전트의 1.1점 안이고, 다른 앱의 무작위 노트는 −1.6 이라 프롬프트 형식이나 파인튜닝 자체가 이득을 내는 것은 아니다.
5.3 Readout and Conflict
OpenApps 앱의 버전 1 로 가중치를 학습하고 버전 2 의 노트를 제공한 뒤, 두 버전이 다른 액션을 요구하는 첫 스텝에서 에이전트가 노트·가중치·둘 다 아님 중 무엇을 따르는지 기록한다.
새 버전에서 낡은 가중치만 있으면 base 대비 −8.4, 새 노트만 있으면 +3.3 이고, 둘 다 넣으면 노트만일 때보다 2.7~12.7점 낮다.
recurrence 가 결과를 바꾼다.
분기 스텝에서 에이전트는 recurrence 낮은 항목의 52%, 높은 항목의 43% 에서 노트를 따르고, 가중치는 34% 와 21%, 둘 다 아님은 14% 와 36% 다.
가중치가 가장 잘 쥐고 있는 항목일수록 반대되는 노트가 가장 못 고치고, 그 항목의 낡은 버전을 가중치가 쥐고 있으면 에이전트는 더 자주 어느 쪽도 하지 않는다.
5.4 Routing against the Alternatives
held-out 규칙으로 라우팅한 결과를 모든 궤적 단위 baseline 과 단일 목적지와 같은 held-out 인스턴스에서 비교한 것이 Table 2 다.
MobileGym 에서 routed 는 GUI-Owl 34.8, Qwen3-VL 30.5, ScaleCUA 34.3 이고, AndroidWorld 에서 33.3, 33.2, 32.6 이다.
전부 컨텍스트는 MobileGym 에서 29.6, 27.3, 28.7 이고 전부 가중치는 28.6, 28.0, 27.3 이다.
라우팅은 MobileGym 모든 백본에서 더 나은 단일 목적지를 평균 +4.4 넘고, AndroidWorld 에서는 Qwen3-VL-8B +5.0, ScaleCUA-7B +3.2 이고 GUI-Owl-8B 는 동률이다.
단일 목적지는 서로 다른 조각에서 실패한다.
전부 컨텍스트는 locator 의 가중치 이득을, 전부 가중치는 procedure 와 state fact 의 컨텍스트 이득을 포기한다.
궤적 단위 baseline 중 가장 좋은 self-retry 가 라우팅보다 9.3점 아래이고, 궤적 전체 SFT·궤적 1개 검색·스텝 기록 10개 검색·context-then-distill 은 모두 단일 목적지에도 못 미친다.
반대 배정은 MobileGym 에서 라우팅보다 8.9점, AndroidWorld 에서 6.7점 잃는다.
비용은 appendix H 에 있는데, MobileGym GUI-Owl-8B 기준 routed 는 어댑터 학습에 H100 6.1 GPU-시간, 에피소드당 프롬프트 토큰은 base 의 1.07배다.
전부 가중치는 15.4 GPU-시간에 토큰 1.00배, 전부 컨텍스트는 학습 없이 1.07배다.
6. Producer and Consumer Shifts
4.2 에서 노트는 생산자에서 소비자로 옮겨가고 파인튜닝 샘플은 안 옮겨간다는 걸 봤는데, 이 장은 두 모델 사이의 격차 세 개를 전이 전에 재고 각 route 가 어느 격차에 값을 치르는지 본다.
6.1 Three Gaps
세 격차에 대해 procedure route 의 패밀리 단위 이득을 그린 그림이다.
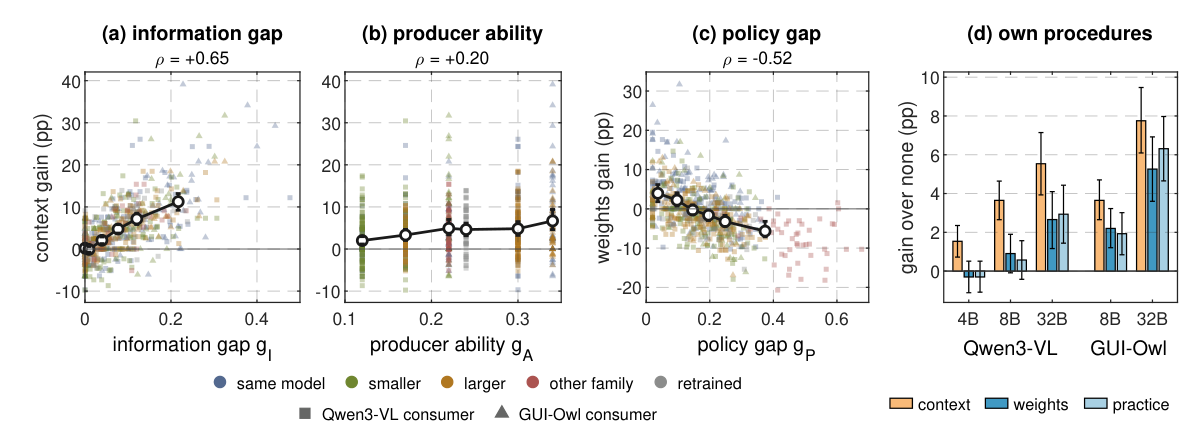
정보 격차는 생산자는 풀고 소비자는 못 푸는 패밀리 비율, 정책 격차는 같은 상태에서 소비자가 생산자와 다르게 행동할 비율, 생산자 능력은 생산자 자신의 성공률이다.
15개 생산자-소비자 쌍, 16개 과제 패밀리의 720칸에서 정보 격차와 정책 격차는 거의 독립이다(Spearman −0.13).
컨텍스트 이득은 정보 격차와 함께 가장 낮은 육분위 +0.2 에서 가장 높은 육분위 +11.3 까지 오르고(0.65), 생산자 능력은 단독으로 0.20, 정보 격차를 고정하면 0.05 다.
“A note pays when it says something the consumer does not know, whoever wrote it.”
가중치 이득은 정책 격차와 함께 가장 낮은 육분위 +4.0 에서 가장 높은 육분위 −5.7 까지 떨어진다(−0.52).
파인튜닝은 노트와 같은 정보를 사지만, 생산자의 액션이 소비자라면 안 할 액션인 모든 상태에서 값을 치른다.
6.2 Producer Shifts
큰 생산자는 정보 격차를 넓히고, 다른 패밀리 생산자는 정책 격차를 연다.
Qwen3-VL-8B 소비자에게 4B·8B·32B 생산자의 정보 격차는 0.04, 0.06, 0.08 이고 정책 격차는 같아서(0.16), 노트는 그 순서로 더 얻고 가중치에서는 자기 샘플만 얻는다.
GUI-Owl-8B 풀은 같은 패밀리 수준의 정보 격차(0.07)에 정책 격차 0.46 이라 노트는 자기 것만큼 돕고 샘플은 해치는데, 그 생산자를 소비자의 성공 사례로 재학습시키면 정책 격차가 0.17 로 닫히고 샘플이 같은 패밀리 생산자 수준으로 돌아온다.
6.3 Consumer Shifts
소비자를 업그레이드하면 노트는 가치를 유지하고 가중치는 처음부터 다시 시작한다.
같은 패밀리의 8B 에서 32B 로 옮기면 8B 생산자의 노트는 32B 소비자에게 +3.2 를 주고, 같은 샘플을 가중치에 넣으면 −1.4 다.
다섯 소비자 모두에서 이미 푸는 패밀리의 자기 성공 사례만으로 파인튜닝하면 전체 procedure 와 1.1점 안에서 맞으므로, 연습에는 생산자가 필요 없다.
노트 라이브러리는 소비자 교체를 넘어 이월되고, 가중치 route 는 새 소비자의 자기 궤적으로 다시 만든다.
7. Conclusion
경험의 네 조각을 학습 전에 잰 두 속성으로 컨텍스트나 가중치에 보내는 component routing 을 제시했다.
세 백본 패밀리와 두 환경에서 같은 항목·같은 held-out 과제로 비교하면, locator 와 lesson 은 가중치에서, procedure 와 state fact 는 컨텍스트에서 이긴다.
두 속성의 규칙은 못 본 패밀리에서 모든 조각의 목적지와 경계에서 반으로 나눈 조각의 양쪽 절반을 복원하고, 그 규칙으로 라우팅하면 궤적 단위 baseline 전부와 평균적으로 더 나은 단일 목적지를 넘는다.
같은 조각이 가중치에 들어가면 노트 readout 이 떨어지고, 컨텍스트 이득은 정보 격차와 함께 커지고 가중치 이득은 정책 격차와 함께 줄어든다.
본문에 Limitations 절은 따로 없다. 읽으면서 모아 둔 범위는 이렇다.
- 백본이 7~8B 세 패밀리뿐이라 더 큰 모델에서 부호가 유지되는지는 원문에서 확인 못 함.
- MobileGym 은 매 스텝 앱 상태가 노출되는 시뮬레이터다. 실기기에서는 AndroidWorld 처럼 접근성 트리로 대신해야 하고, 그쪽 구간이 더 넓다.
- 조각 추출기가 규칙 기반이라 키 정의(앱·역할·요소 이름 등)가 환경마다 손으로 정해진다.
- lesson 의 가중치 우위는 절반의 칸에서 구간이 0 을 포함하고, AndroidWorld GUI-Owl-8B 에서 라우팅은 단일 목적지와 동률이다.
- 코드와 데이터는 공개 예정이고 글 쓰는 시점에 링크는 없다.
8. 지금 관점: 파인튜닝과 노트 중 어느 쪽에 넣을까
Harness Benefit은 갱신을 만드는 능력과 갱신으로 득을 보는 능력이 다르다고 했는데, 이 논문의 6장은 그 득을 정보 격차와 정책 격차로 쪼개서 노트는 전자에, 파인튜닝은 후자에 값을 치른다고 정리한다.
Memory Portability에서 모델을 바꾸면 같은 저장소로도 잊을 수 있다고 했는데, 여기 6.3 은 노트 라이브러리는 소비자 교체를 넘어가고 LoRA 는 새로 만들어야 한다는 쪽 결과다.
Reflexion의 반성문은 이 논문의 lesson 에 가까운데, 여기서는 lesson 이 오히려 가중치 쪽으로 약하게 기운다.
지금 가져다 쓸 수 있는 부분은 두 속성 자체다.
파인튜닝을 할 계획이 없더라도, 메모리에 넣는 항목마다 “다른 과제에서도 이 키가 다시 나오는가”와 “현재 상태가 맞을 때만 쓸모가 있는가”를 붙여 두면 노트를 어떻게 검색해야 하는지가 정해진다.
5.2 에서 상태 조건을 빼고 과제 텍스트로만 검색했더니 procedure 와 state fact 의 이득이 대부분 사라졌다.
스텝 기록을 과제 유사도로 찾아 넣는 흔한 설계가 왜 기대만큼 안 오르는지에 대한 한 설명이다.
반대로 어디에 있는지만 알면 되는 locator 류 정보는 노트로 매번 꺼내 봐야 액션이 거의 안 바뀌니, 프롬프트에 두면 토큰만 쓰는 쪽에 가깝다.
그대로 받아들이기 어려운 부분도 있다.
환경 둘 다 결정적 체커가 있고 MobileGym 은 앱 상태를 그대로 읽을 수 있는 시뮬레이터다.
상태 서명을 어떻게 만들지가 이 방법의 절반인데, 웹이나 데스크톱에서 그만한 상태 서명을 만들 수 있을지는 환경마다 다르다.
점수 차이도 3~5점이고 시드 표준편차가 2점대인 칸이 많아서, 백본 하나로 한 번 돌려 보고 판단할 크기는 아니다.
7~8B 모델에서 본 결과라, 노트를 훨씬 잘 읽는 큰 모델에서는 가중치 쪽 우위가 더 줄어들 가능성도 있는데 이건 원문에 없다.
-> 5.3 의 충돌 결과가 실무에서는 가장 신경 쓰이는 부분이다. 앱이 바뀌었을 때 낡은 가중치와 새 노트를 같이 주면 노트만 줄 때보다 나빠지고, 반복이 많았던 항목일수록 에이전트가 둘 다 안 하는 쪽으로 간다. 파인튜닝을 한 번이라도 하면 그 뒤의 노트 갱신만으로는 못 고치는 영역이 생기므로, 가중치에 넣을 조각은 앞으로도 바뀌지 않을 것에 한정하는 편이 안전해 보인다.
Leave a comment