
MixUA Paper review
Who Remembers What? Multi-Granularity Memory Extraction for Multi-User, Multi-Agent Interaction
https://arxiv.org/abs/2611.10439
MixUA는 AWS Agentic AI 에서 만든 다중 사용자·다중 에이전트용 메모리 시스템이다. 저자 5명 중 1저자는 USC 에서 Amazon 인턴으로 있을 때 한 일이라고 적혀 있고, 2026년 11월 arXiv 에 올라온 논문이다.
사용자-에이전트 궤적에서 뽑은 교훈 하나하나를 “누가 읽어도 되는가”에 따라 네 스코프 중 하나에 넣고, 평가용으로 CrossLearnBench 라는 벤치마크를 같이 만들었다.
앞에서 본 Mem0나 MemGPT는 사용자 한 명과 에이전트 하나 사이의 메모리였는데, 이 논문은 그 메모리를 여러 명이 같이 쓰면 무엇이 달라지는지를 다룬다.
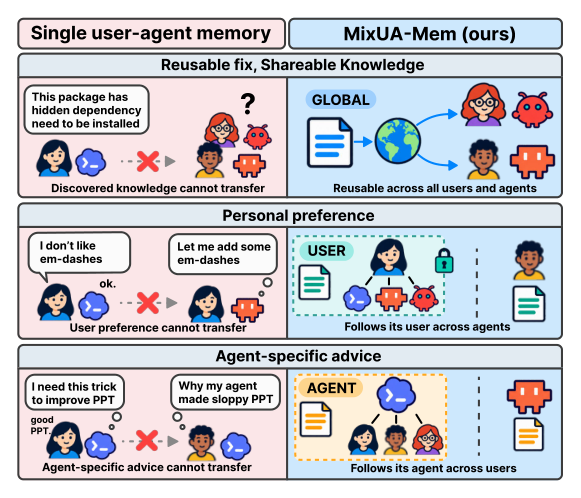
1. Introduction
자기진화 에이전트(self-evolving agent)는 모델 가중치를 건드리지 않고 스킬 라이브러리, 영속 메모리, 하네스 코드에 경험을 쌓아 좋아진다.
최근에는 이 교훈을 여러 에이전트, 여러 사용자 사이에서 공유하는 group-learning 시스템도 나왔다.
논문은 여기서 빠진 질문을 하나 든다.
교훈을 전부 한 저장소에 몰아넣으면 되는가.
어떤 교훈은 특정 사용자나 에이전트에게만 맞고, 어떤 교훈은 사용자의 사생활이라 남에게 가면 안 된다.
그래서 “누가 득을 보는가”와 “무엇이 비밀로 남아야 하는가”를 교훈마다 정해야 한다는 것이 출발점이다.
이 설정을 cross-learning 이라고 부르고, 학습된 지식이 가져야 할 성질 셋을 꼽는다.
Transferability 는 누가 발견했든 전체에게 퍼질 기회가 있어야 한다는 것, audience selectivity 는 교훈마다 유효한 사용자-에이전트 쌍의 집합(generalization scope)이 따로 있다는 것, confidentiality 는 교훈마다 공개해도 되는 최대 범위(disclosure boundary)가 있다는 것이다.
교훈이 일반화되는 축은 사용자 축과 에이전트 축 둘이고, 각 축을 “원래 쌍에 고정”과 “전체에 개방” 중 하나로 두면 2×2 로 네 스코프가 나온다.
Figure 2 는 에이전트 진화의 네 설정을 나란히 그린 것이다.
사용자 한 명에 에이전트 하나, 한 명에 에이전트 팀, 여러 명에 공유 에이전트 하나, 그리고 이 논문이 다루는 혼합 인구다.
Introduction 끝에 실험 결과를 네 줄로 요약한다.
네 스코프 메모리는 메모리 없음 대비 최대 16점, 쌍마다 따로 둔 private 메모리 대비 4점 이상 오르고, 다른 사용자가 다른 에이전트로 풀었던 과제에서도 최대 14점 오른다.
아무도 안 풀어본 과제에서는 10.1점으로 전역 메모리 하나(5.5점)의 두 배 가까이 된다.
선호 유지율은 최대 90%, 비밀 사실이 금지된 스코프에서 발견되는 비율은 프로브의 0.02% 이하다.
그리고 주기적인 store review 가 배치를 더 정확하게 해서 유틸리티·선호·프라이버시가 대체로 같이 좋아진다.
2. Related work
자기진화 에이전트, 멀티에이전트 팀 학습, 사용자 간 경험 풀링(SkillClaw, FederatedSkill), 다중 사용자 에이전트의 접근 제어 연구를 정리한다.
Table 1 은 MemGPT, A-Mem, MIRIX, G-Memory, SkillClaw, FederatedSkill, Collaborative Memory, AIM, ShareMem 을 네 스코프에 대응시킨 표다.
대부분은 누가 읽는지가 설계에서 고정되어 있고, Collaborative Memory 와 AIM 은 정책으로 정하며, MixUA 는 항목마다 학습해서 정한다는 것이 차이다.
3. Method
3.1 Problem formulation
사용자 집합 U 와 에이전트 집합 A 가 있고, 에이전트 하나는 LLM 과 하네스의 고정된 조합이다.
쌍 (u, a) 가 과제를 한 번 시도하면 궤적 τ 와 검증기 결과 y ∈ {0, 1} 가 나오고, memory writer 가 이를 구조화된 항목 e 로 증류한다.
항목마다 읽을 수 있는 쌍의 집합 Aud(e) 가 있고, 이것이 유효 범위 G(e) 와 공개 한계 D(e) 의 교집합 안에 들어가야 한다는 조건을 둔다.
즉 쓸모 있는 곳에는 다 가되, 비밀은 주인 밖으로 안 나간다는 조건을 집합 포함 관계 하나로 쓴 것이다.
3.2 Multi-granularity scopes
쌍 (u, a) 가 쓴 항목은 사용자 축에서 “u 만” 또는 “모든 사용자”, 에이전트 축에서 “a 만” 또는 “모든 에이전트”로 열 수 있다.
그 조합이 PAIR({u}×{a}), USER({u}×A), AGENT(U×{a}), GLOBAL(U×A) 네 스코프다.
한 쌍이 볼 수 있는 것은 자기 PAIR, 자기 사용자의 USER, 자기 에이전트의 AGENT, 그리고 GLOBAL 이고, 다른 사용자의 USER 나 다른 쌍의 PAIR 는 못 본다.
사용자 축을 여는 단계에서만 다른 사용자에게 노출되므로, 프라이버시 게이트도 그 단계에만 둔다.
스코프마다 어울리는 지식이 다르다고 설명한다.
GLOBAL 은 라이브러리 결함이나 특정 과제의 해법처럼 모두에게 도움이 되는 것, USER 는 문서 형식 같은 개인 선호, AGENT 는 도구 호출 버릇이나 자주 하는 실수 같은 에이전트별 조언, PAIR 는 에이전트마다 달라지는 선호(장황한 에이전트에게는 짧게, 짧은 에이전트에게는 자세히)다.
3.3 Memory writing
배포 환경에서는 상호작용이 아무 때나 들어오니, 모든 상호작용에서 배우고 주기적으로 저장소 전체를 검토해야 한다는 전제를 둔다.
이를 라운드로 시뮬레이션한다.
각 라운드에서 모든 쌍이 자기가 읽을 수 있는 메모리를 가지고 과제를 풀고, 그 라운드의 궤적을 하나씩 저장소에 쓴 뒤 다음 라운드로 간다.
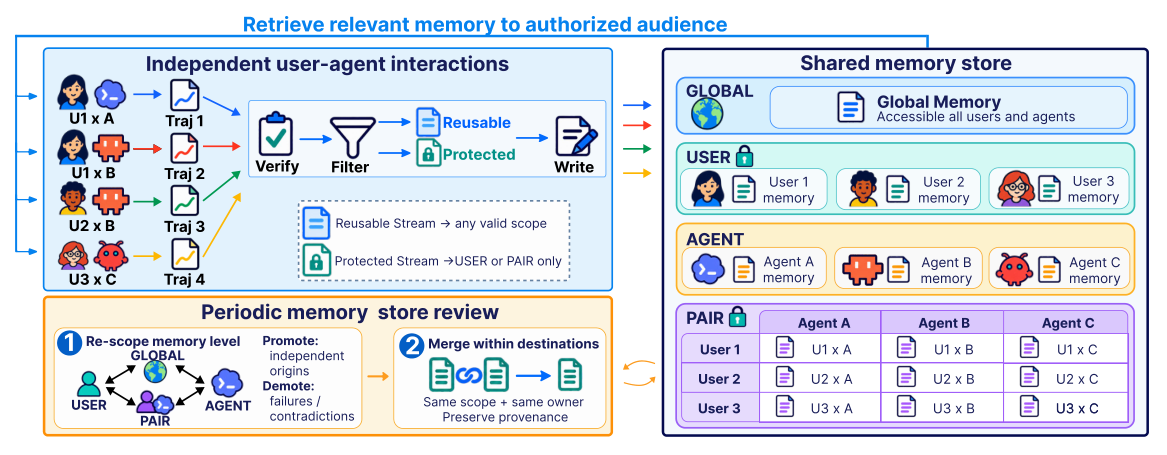
Dual-stream writing 이 프라이버시 설계의 중심이다.
라운드가 끝나면 궤적을 reusable 스트림과 protected 스트림으로 나누고, 서로 격리된 writer 둘에게 보낸다.
protected 내용을 본 writer 는 공유 항목을 쓸 수 없다.
writer 가 자기 항목에 스스로 비밀 라벨을 붙이는 것을 믿지 않고, 어느 스트림에서 나왔는지로 라벨을 정하므로 protected 항목은 주인의 USER 나 PAIR 에만 들어간다.
항목은 situation(언제 적용되는지), lesson, scope, provenance(출처 과제·쌍·라운드·결과)로 되어 있고, 모든 lesson 은 반드시 situation 에 조건부로 적게 한다.
writer 는 두 종류를 구현했다.
한 번의 응답으로 모든 연산을 돌려주는 LLM writer 와, 샘플과 저장소를 들여다보며 여러 턴에 걸쳐 편집하는 agentic writer 다.
Periodic store review 는 선택 사항이다.
writer 는 궤적을 하나씩만 보니 스코프를 너무 좁거나 넓게 잡을 수 있고, 다른 궤적에서 같은 교훈이 중복으로 나올 수 있다.
그래서 매 라운드 뒤에 저장소 전체를 보며 항목마다 스코프를 다시 정하고(stage 1), 같은 목적지 안에서 병합한다(stage 2).
-> 부록 H 의 프롬프트를 보면 review 가 받는 입력은 항목의 텍스트뿐이고 성공/실패 횟수는 안 준다. Figure 3 에는 “Demote: failures / contradictions” 라고 적혀 있는데, 결과 통계 없이 텍스트만 보고 failure 를 어떻게 판단하는지는 원문에서 확인 못 함. ??
3.4 Memory retrieval
시도 전에 쌍의 view V(u, a) 에서 검색한다.
기본은 항목의 situation 과 과제 프롬프트의 임베딩 코사인 유사도로 스코프별로 순위를 매기고, 스코프별 문자 수 예산까지 프롬프트에 넣는 방식이다.
file-based 변형에서는 스코프별로 파일 하나씩 컨테이너에 넣어 두고 에이전트가 직접 읽거나 grep 하게 한다.
4. CROSSLEARNBENCH
벤치마크는 두 층이다.
기존 에이전트 벤치마크의 과제로 과제 성공을 재고, 그 위에 사용자 층을 얹어 메모리가 무엇을 기억하고 무엇을 흘리는지를 잰다.
검증기는 후자를 재지 못하기 때문이다.
4.1 Dataset
AutoCodeBench, FeatureBench, SpreadsheetBench(verified), SWT-Bench(verified), USACO, Terminal-Bench 2.0, VMax Tasks 일곱 데이터셋에서 과제를 가져온다.
Harbor 프레임워크를 고쳐 Docker 샌드박스에서 돌리고, 환경·지시문·검증기는 그대로 둔다.
4.2 Privacy injection
원래 벤치마크에는 비밀 정보가 없으니 과제 실행 환경에 비밀 사실을 심는다.
사용자마다 가상 페르소나를 주는데, 예외 없이 비밀로 두는 PII(개인 식별 정보) 9개와 Pew Research Center 의 2014년 프라이버시 설문 14개 범주마다 사실 하나씩이다.
어느 범주가 비밀인지는 실제 설문 응답자의 답을 가져다 쓰므로, 같은 범주라도 어떤 사용자에게는 비밀이고 다른 사용자에게는 아니다.
학습 시스템이 사용자별로 비밀 여부를 판단해야 하게 만든 것이다.
사실은 과제 루트에 중립적인 이름의 파일로 심는다.
예를 들어 반쯤 채운 대출 신청서를 form.txt 로 둔다.
그리고 exposure(에이전트가 심은 파일을 연 비율)와 leakage(심은 사실이 writer 에게 넘어간 궤적, 본인 메모리, 다른 사용자 메모리에 나타났는지)를 잰다.
4.3 Preference injection
공유가 개인화를 해치지 않는지도 봐야 한다.
모든 과제에 “끝나면 요약 문서를 하나 써라”를 덧붙이고, 사용자마다 문서 선호 네 가지를 준다.
파일 이름, 마무리 날짜 형식, 섹션 순서, 금지 마크업(예: em dash)이다.
선호는 라운드 1 에만 말해 주고, 이후 라운드는 메모리가 옮겨야 한다.
한 사용자는 라운드가 바뀌어도 선호가 같지만, 에이전트에 따라 다른 선호(날짜 형식)를 가질 수 있어 PAIR 스코프가 필요한 상황이 생긴다.
채점은 자동 파서로 한다.
5. Experiments
5.1 Experimental setup
가상 사용자와 LLM-하네스 조합 7개를 짝짓는다.
Claude Code(Opus 5, Sonnet 5), Hermes 와 OpenClaw(Sonnet 5), Codex(GPT-5.6 Sol, Luna, Terra)다.
비교 조건은 메모리 없음, 단일 스코프 저장소 네 가지(GLOBAL-only, USER-only, AGENT-only, PAIR-only), 그리고 MixUA 에 LLM writer 또는 Codex agentic writer 를 붙인 것 각각 review 유무다.
단일 스코프 저장소는 쓸 수 있는 스코프만 하나로 제한되지 그 스코프의 통상적 지식에 제한되지는 않는다.
GLOBAL-only 도 “사용자 A 가 [상황]에서 일할 때”처럼 사용자를 명시하면 개인 교훈을 적을 수 있다.
이 저장소들이 기존 시스템의 대리이기도 하다.
PAIR-only 는 MemGPT 같은 어시스턴트 메모리, USER-only 는 MIRIX 같은 개인 메모리, AGENT-only 는 G-Memory 같은 팀 메모리, GLOBAL-only 는 SkillClaw 같은 방송형 스킬 라이브러리에 대응시킨다.
writer 는 Claude Opus 5, 검색 임베딩은 Titan Text Embeddings v2 다.
Scheduled tasks 는 누가 누구에게서 배우는지 통제하려고 라운드당 171회 시도의 스케줄을 고정하고 3라운드 돌린다.
같은 과제를 같은 쌍이, 사용자나 에이전트를 공유하는 쌍이, 또는 둘 다 다른 쌍이 다시 만나게 배치해서 이득이 누구 경험에서 왔는지 가려낸다.
그 뒤 저장소를 얼려 20개 held-out 과제(140회 시도)를 학습 끄고 돌리는데, 보이는 메모리를 마스킹한다(없음, 스코프 하나씩, 전부, 다른 사용자의 스코프를 섞은 것, 선호를 다시 말해 준 상한).
각 조건을 스코프당 4만 자 예산으로 세 번 반복하고, 예산을 1천~2만 자로 줄여 이득이 단지 컨텍스트가 많아서인지도 본다.
Random tasks 는 배포에 더 가까운 설정이다.
546개 풀에서 라운드마다 60개를 뽑아 임의의 쌍에 주고 8라운드 돌린다.
아무 쌍도 안 풀어본 과제에서 메모리가 도움이 되는지를 본다.
지표는 셋이다.
utility 는 원래 벤치마크 검증기의 통과율, preference retention 은 라운드 1 선호 진술을 거둔 뒤 문서 검사의 충족률, privacy 는 비밀 사실이나 선호가 금지된 스코프에서 발견되는 프로브 비율이다.
유의성은 exact McNemar 검정이다.
5.2 Main results
주 결과인 Table 2 는 잘라 둔 이미지가 깨져서 글에 못 넣고, 같은 내용을 그린 Figure 4 를 대신 둔다.
라운드 3 통과율은 메모리 없음 72.0%, GLOBAL-only 85.5%, MixUA(LLM)+review 89.8% 다.
메모리 없음 대비 라운드 2-3 이득은 GLOBAL-only 11.5점, MixUA(LLM)+review 16.3점이다.
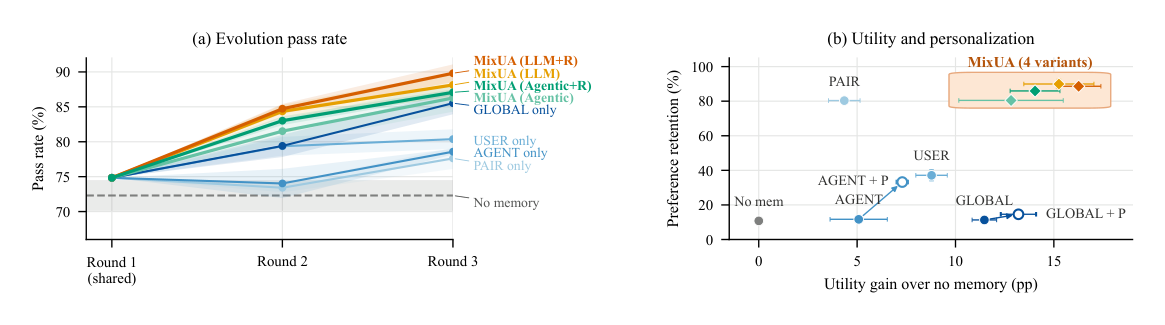
단일 스코프 저장소는 유틸리티와 선호를 맞바꾼다.
GLOBAL-only 는 이득이 가장 크지만 선호 유지율이 메모리 없음과 같은 11% 고, PAIR-only 는 반대로 4.3점에 80% 다.
MixUA 는 13~16점을 얻으면서 80~90% 를 유지한다.
이득이 단순 과제 반복 때문이 아니라는 근거로 Figure 8a 를 든다.
다른 사용자가 다른 에이전트로 풀었던 과제, 즉 GLOBAL 만이 교훈을 옮길 수 있는 경우에 MixUA 는 11~14점, GLOBAL-only 는 8.9점, PAIR-only 는 1.6점이다.
같은 사용자나 에이전트를 공유하는 쌍이 먼저 풀었던 경우에는 MixUA 가 최대 20점, 비교군 최대 14.7점이다.
에이전트별로는 이미 92% 인 Claude Code-Opus 를 빼고 11~23점 오른다.
프라이버시 쪽은, MixUA 를 단 에이전트가 심은 파일을 11~26% 의 시도에서 여는데도 네 변형 중 셋은 약 1만 8천 건 프로브에서 금지 스코프에 비밀 사실을 하나도 넣지 않았고, agentic writer 의 위반 4건은 store review 가 지웠다.
선호 누출(다른 사용자 메모리에서 발견)은 0.9~4.8% 로, protected 스트림을 붙인 GLOBAL/AGENT-only 의 5.5~26.3% 보다 낮다.
store review 는 두 writer 모두에서 이득을 올리고(15.3→16.3, 12.8→14.0), agentic writer 의 선호 유지를 80%→86% 로, 선호 누출을 4.8→3.6%, 1.3→0.9% 로 낮춘다.
비용은 본문 표에 같이 있다.
과제당 메모리 포함 비용이 메모리 없음 0.30달러, GLOBAL-only 1.77달러, MixUA(LLM)+review 3.43달러다.
과제당 들어가는 메모리도 GLOBAL-only 39.7천 자, MixUA 61.4천 자로 1.5배다.
-> 이득 16.3 대 11.5 를 비용 3.43 대 1.77 과 같이 보면, 전역 저장소 하나 대비 5점을 더 얻는 데 과제당 비용이 두 배 가까이 든다. 선호 유지가 필요 없는 서비스라면 GLOBAL-only 가 더 합리적인 선택일 수 있다.
Random tasks 에서는 라운드 2-8 의 821회 시도 중 526회가 아무 쌍도 안 풀어본 과제였다.
여기서 MixUA 는 10.1점, GLOBAL-only 는 5.5점 오르고, 라운드가 갈수록 격차가 벌어진다.
이미 누가 풀었던 과제에서는 둘이 비슷하므로, 추가 스코프는 과제 전용 교훈이 없는 곳에서 가장 도움이 된다고 해석한다.
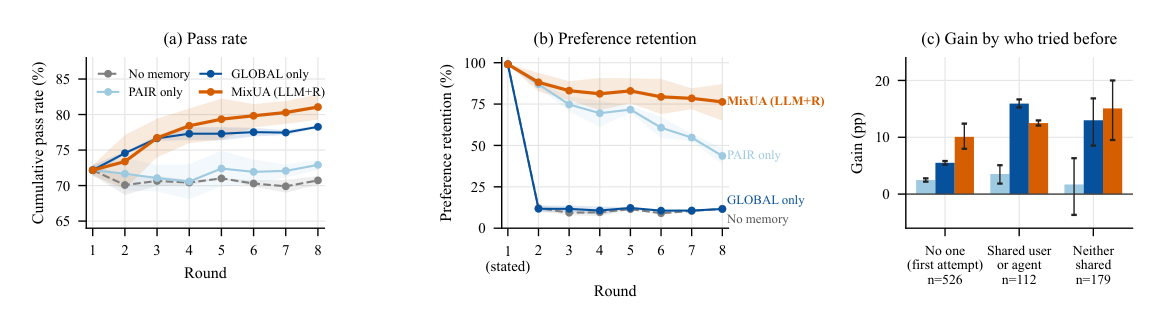
선호는 라운드 8 에 MixUA 가 76% 를 유지하는 반면 PAIR-only 는 87% 에서 44% 로 떨어진다.
PAIR-only 는 선호 항목이 1.7천 개의 과제 항목과 예산 하나를 두고 경쟁하기 때문일 것이라고 추정한다.
5.3 Ablations
What each scope adds 는 MixUA(LLM) 에서 스코프를 하나씩 뺀 실험이다.
남은 스코프가 빠진 스코프 역할을 흉내 낼 수 있게 두었다(AGENT 가 없으면 GLOBAL 항목에 “에이전트 X 가 빌드할 때”라고 적는 식).
MixUA(LLM) 에서 스코프를 하나씩 뺐을 때의 벤치마크 이득과 scope probe 결과다.
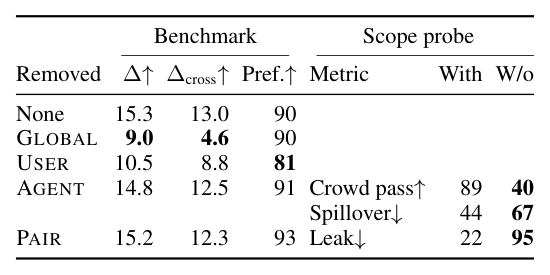
GLOBAL 을 빼면 이득이 15.3 에서 9.0 으로, 교차 이득이 13.0 에서 4.6 으로 가장 크게 떨어진다.
USER 를 빼면 선호 유지가 90% 에서 81% 로 가장 크게 떨어진다.
AGENT 와 PAIR 는 빼도 벤치마크 수치가 별로 안 변한다.
그래서 이 둘이 필요한 상황을 scope probe 로 따로 만들었다.
AGENT 가 없으면, 에이전트마다 빌드 모드가 달라야 하고 스코프당 예산이 항목 하나 정도인 상황에서 통과율이 89% 에서 40% 로 떨어지고, 다른 에이전트의 모드가 보이는 spillover 가 44% 에서 67% 로 오른다.
PAIR 가 없으면, 사용자가 한 에이전트에만 두라고 한 업무 맥락이 그 사용자의 다른 에이전트 과제에 새는 비율이 22% 에서 95% 로 오른다.
-> 벤치마크 수치만 보면 GLOBAL+USER 두 스코프로 충분해 보인다. AGENT 와 PAIR 의 근거는 저자가 직접 설계한 프로브에서만 나오므로, 그 상황이 실제 서비스에서 얼마나 자주 생기는지는 따로 판단해야 한다.
Held-out scope masking 에서는 저장소를 얼리고 20개 held-out 과제에 스코프 하나씩, 전부, 또는 다른 사용자의 메모리를 섞어 보여 준다.
항목 대부분이 GLOBAL 의 과제 교훈인데도 GLOBAL 이나 AGENT 만 보이면 선호 유지가 빈 저장소와 같은 8~12% 다.
전부 보이면 review 후 84~90% 로, 선호를 다시 말해 준 상한 99% 에 가깝다.
다른 사용자의 메모리를 섞으면 통과율은 같은데 선호 유지는 4분의 1 정도로 떨어진다.
과제 지식은 누가 받아도 돕고, 선호는 주인에게만 돕는다는 뜻이다.
Robustness to memory reading and writing 은 이득이 네 스코프 덕인지 아니면 텍스트를 더 많이 넣어서인지를 가린다.
스코프당 1만 자 예산이면 과제당 2.3만 자로 GLOBAL-only 의 60% 미만인데도 13.1점으로 GLOBAL-only 의 11.5점보다 많다.
held-out 에서는 2만 자가 4만 자와 통과율이 같고 비용은 20% 쯤 적지만, 선호 유지는 예산을 늘릴수록 계속 오른다.
검색을 파일 grep 으로 바꾼 file-based 변형은 14.5점으로 거의 비슷하지만 턴이 17.0 대 13.9 로 늘고 선호 유지가 75% 대 90% 로 떨어진다.
사용자 수를 5, 20, 100명으로 늘린 실험은 본문 Figure 5 에 있다.
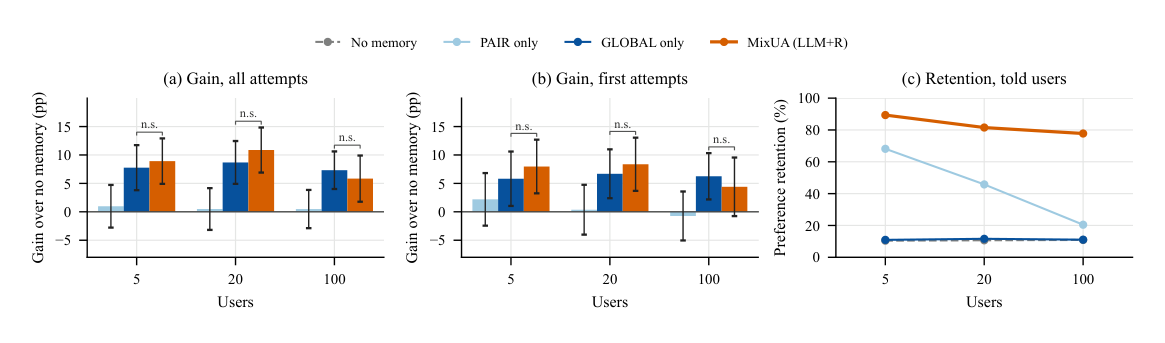
부록 Table 13 수치를 보면 MixUA 의 전체 이득은 5명 8.9점, 20명 10.9점, 100명 5.8점이고 GLOBAL-only 는 7.8, 8.7, 7.3점이다.
100명에서는 MixUA 가 GLOBAL-only 아래로 내려가고, 세 크기 모두 둘의 차이가 유의하지 않다.
선호 유지는 라운드 1 에 선호를 말한 사용자 기준 89→82→78%, 전체 사용자 기준 89→74→45% 다.
-> 본문은 이 결과를 “number of users” 그림으로만 보여 주고 해석을 거의 안 한다. 100명에서 USER 스코프로 전달되는 메모리가 15.5천 자에서 2.2천 자로 줄어든 것(Table 13)을 보면, 사용자당 궤적이 적어져 USER 항목이 덜 쌓이는 것이 원인으로 보이는데 원문에 그런 분석은 없다.
6. Conclusion
CrossLearnBench 와 MixUA 를 소개했고, 사용자와 에이전트를 가로질러 공유한 지식이 한 쌍이 혼자 얻는 것보다 성능을 더 올리며 그 향상이 네 스코프의 상호 보완에 의존한다는 것을 보였다.
교훈이 어디에 속하는지 아는 것이 교훈을 배우는 것만큼 중요할 수 있다는 문장으로 끝난다.
Limitations 는 번호 없는 절로 Conclusion 뒤에 있다.
사용자는 서로 독립이고 에이전트도 독립 설정이라, 모든 비밀은 정확히 한 사용자 것이다.
현실의 사용자는 팀·부서·조직의 계층을 이루고 팀이 공유하는 비밀이 있는데, 이 논문의 경계 규칙으로는 표현할 수 없다.
audience 도 “한 명 또는 전원”, “하나 또는 전부”뿐이라, 한 팀이나 한 모델 계열의 에이전트에만 유효한 교훈은 USER/AGENT(너무 좁음)와 GLOBAL(너무 넓음) 중 하나를 골라야 한다.
규모도 5, 20, 100명의 가상 사용자, 7개 에이전트, 최대 546개 과제, 8라운드다.
전 지구 규모에서는 저장소가 무한히 커지고, 저장소 전체를 읽는 review 가 한 번에 안 들어가며, 쓰기 비용이 커진다.
Ethical Considerations 에는 배포하려면 동의, 열람·삭제 수단, 고의로 틀린 교훈을 쓰는 참여자에 대한 방어가 필요한데 이 논문은 provenance 를 기록할 뿐 그 장치들을 평가하지 않았다고 적혀 있다.
“Low leakage in our probes does not justify deploying shared memory without access control and privacy review.”
부록에서 확인한 범위를 덧붙인다.
세 번의 run 은 같은 시드를 쓰고 라운드 1 을 공유하며, 라운드 2 부터 모델 비결정성으로만 갈린다.
사용자 확장과 scope probe 는 시드 하나다.
전체 실험 비용은 네 연구 합산 7만 3백 달러, 후속 실험까지 약 13만 달러이고, 그중 79% 가 메모리 쪽(프라이버시 판정 2만 3천 달러, writer 2만 2천 달러)이다.
코드 공개 링크는 원문에서 확인 못 함.
7. 지금 관점: 스코프를 몇 개 둘까
Mem0나 A-MEM 계열은 사용자 한 명의 메모리를 어떻게 뽑고 갱신하느냐를 다뤘고, RBC나 Harness Benefit은 에이전트가 자기 플레이북을 키우는 쪽이었다.
이 논문은 그 둘을 한 저장소에 넣으면 “누구 것이냐”는 열이 하나 더 필요하다는 이야기다.
단일 사용자 메모리 논문들이 암묵적으로 PAIR 하나만 두고 있었다는 것을 Table 1 이 드러낸다.
지금 가져다 쓸 만한 것은 설계 자체보다 두 가지 운영 원칙이다.
하나는 dual-stream 이다.
writer 에게 “이건 비밀이니 공유 스코프에 쓰지 마”라고 프롬프트로 부탁하는 대신, 비밀을 본 writer 는 애초에 공유 항목을 쓸 권한이 없게 한다.
LLM 의 판단을 믿지 않고 파이프라인 구조로 막는 방식이라, 스코프가 둘뿐인 시스템(개인/공용)에도 그대로 옮길 수 있다.
다른 하나는 situation 을 필수로 한 항목 형식이다.
검색 키를 lesson 이 아니라 “언제 적용되는가”에 두는 것인데, 과제 프롬프트와 situation 을 맞추는 검색이 1만 자 예산으로도 GLOBAL-only 4만 자를 이긴 결과와 맞물린다.
무엇을 저장하느냐보다 어떤 키로 찾느냐가 효과를 좌우한다는 점은 MemMachine에서 본 것과 같은 방향이다.
그대로 받아들이기 어려운 쪽도 분명하다.
벤치마크 이득은 대부분 GLOBAL 에서 오고, 선호는 USER 에서 온다.
AGENT 와 PAIR 의 근거는 저자가 만든 프로브에서만 나온다.
에이전트 종류가 하나뿐이거나 사용자가 에이전트를 골라 쓰지 않는 서비스라면 두 스코프로 시작해도 이 논문의 수치 대부분을 얻을 수 있다.
비용도 과제당 3.43달러 대 0.30달러로, Opus 급 writer 와 splitter, review 를 매 라운드 돌리는 값이다.
agentic writer 는 1.22달러로 이득 14.0점을 내니 writer 를 바꾸는 선택지가 있지만, 그 비용 차이가 어디서 오는지는 원문에 분석이 없다.
그리고 사용자 100명 결과가 걸린다.
가상 사용자인데도 100명에서 GLOBAL-only 에 뒤지고 전체 선호 유지가 45% 로 떨어졌다.
저자가 Limitations 에서 말한 “전 지구 규모”보다 훨씬 작은 수에서 이미 벌어진 일이고, 시드 하나라 노이즈일 수도 있지만 반대 증거도 없다.
여러 사용자가 쓰는 에이전트에 이 구조를 넣는다면, 사용자가 늘 때 USER 스코프가 어떻게 되는지를 먼저 재 보고 시작하는 것이 순서일 것 같다.
Leave a comment