
TROVE Paper review
TROVE: Adaptive Agent Skill Orchestration via Trace-Grounded Route Validation and Editing
https://arxiv.org/abs/2609.05019
TROVE는 Tianxing Wang 등 7명이 쓴 에이전트 워크플로 실행 방법이다(소속은 원문 텍스트에서 확인 못 함).
arXiv 에 올라온 논문이다.
계획한 스킬 경로를 “잠정안”으로만 들고 있다가, 스킬 하나를 실행할 때마다 남은 경로가 아직 맞는지 검사하고 틀어진 부분만 고친다.
앞에서 본 ReAct는 관찰 하나마다 다음 행동 하나만 정했는데, TROVE는 몇 스텝 앞까지 계획은 세워 두되 실행 약속은 한 스텝씩만 한다.
1. Introduction
에이전트의 성능은 각 구성요소의 능력뿐 아니라 그것들을 언제, 어떤 순서로 부르는지에도 달려 있다.
critic은 답이 불확실할 때만 필요하고, 코드 수리는 테스트가 실패한 뒤에만 필요하고, 앞 단계가 이미 맞는 답을 냈으면 예정된 검증은 필요 없다.
저자들이 문제 삼는 건 기존 방법들이 이런 구조를 실행 전에 정해 버린다는 점이다.
AFlow(학습 데이터에서 워크플로를 탐색해 데이터셋 전체에 하나를 고정해 쓰는 방법)는 데이터셋 단위로 워크플로를 고른다.
MaAS(질의마다 멀티에이전트 구조를 뽑아 쓰는 방법)는 질의 단위로 고르지만 실행 전에 고른다.
LAS(워크플로 DAG 안에서 중간 출력을 보고 다음 노드를 고르는 방법)는 실행 중에 바꾸지만 미리 정해진 그래프 안에서만 바꾼다.
실행이 진행되면 대기 중인 뒷부분이 낡는다.
review가 수정을 요구하거나, 이미 성공해서 검증이 필요 없어지거나, 도구가 실패해서 뒤 단계가 성립하지 않게 된다.
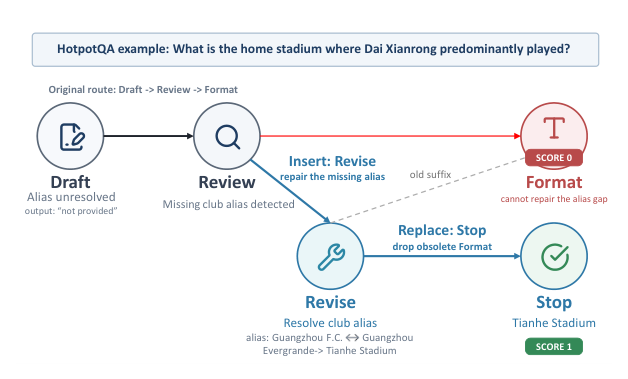
Figure 1이 그 예시다.
HotpotQA 질문에서 Draft가 구단 별칭을 못 풀어 “not provided”를 냈고, Review가 그걸 잡아냈다.
AFlow는 고정된 경로대로 Format을 실행해서 0점을 받는다.
TROVE는 Revise를 끼워 넣어 별칭을 풀고, 필요 없어진 Format을 Stop으로 바꿔 1점을 받는다.
저자들은 이 요구사항을 이렇게 적는다.
“after each execution boundary, validate the pending route and edit it at the smallest sufficient scope.”
contribution은 세 가지다.
- 실행 결과가 다음 계획을 무효로 만들 때 워크플로를 어떻게 고칠지를 별도의 오케스트레이션 문제로 정의했다
- 탐색 trace를 composite skill과 transition graph로 정리하고, 한 스텝씩만 실행을 약속하면서 경로를 고치는 TROVE를 제안했다
- 6개 벤치마크와 3개 LLM, 18개 설정에서 15개는 점수가 가장 높거나 공동 1위, 16개는 온라인 시간이 가장 짧았다
2. Related Work
2.1 Workflow Construction Before Execution
워크플로를 자동으로 만드는 연구를 연산 단위(GPTSwarm), 워크플로·시스템 단위(AFlow, ADAS), 질의 단위(MaAS, DyLAN, FlowReasoner)로 나눈다.
세 부류 모두 개별 문제의 중간 결과를 보기 전에 주 구조가 정해진다는 게 저자들의 정리다.
2.2 Skill Abstraction and Experience Reuse
SayCan, Code as Policies, ExpeL, Voyager처럼 재사용 가능한 스킬을 얻는 방법들을 든다.
TROVE도 경험을 스킬로 만들지만, 그 재료가 “평가가 끝난 워크플로 탐색 trace”라는 점이 다르다고 한다.
2.3 Execution-Time Planning and Route Adaptation
실행 중에 피드백을 받고 나서 미래 계획을 얼마나 남겨 두는지로 기존 방법을 나눈다.
ReAct는 다음 행동 하나만 만든다.
AdaPlanner와 DoReMi는 상위 계획을 유지하다가 가정이 깨지면 고친다.
StateFlow, LAS, FlowSwitch는 상태 기계나 DAG 같은 정해진 전이 공간 안에서 움직인다.
TROVE는 정해진 DAG에 묶이지 않고, 아직 실행 안 한 뒷부분만 고친다.
3. Design of TROVE
3.1 Problem Formulation and Overview
스킬 레지스트리 S가 있고, 실행 전에 제안된 경로 R = (s1, …, sk)가 있다.
t번째 스킬을 실행하고 나면 남은 경로가 안 맞게 될 수 있다.
다음 스킬에 필요한 산출물이 없거나, 예정된 수리가 필요 없어졌거나, 경로가 끝났는데 과제는 안 끝났거나, 같은 행동을 반복해도 진전이 없는 경우다.
저자들은 이 어긋남을 continuation invalidation이라고 부른다.
기존 대응은 양 끝에 몰려 있다.
워크플로를 통째로 버리고 다른 워크플로로 처음부터 다시 실행하면, 이미 끝낸 모델 호출, 도구 실행, 중간 산출물을 다시 만든다.
노드마다 LLM으로 다음 행동을 다시 정하면 반응은 빠르지만 매번 라우팅 지연과 토큰이 들고, 결정이 흔들리고, 멀쩡한 부분까지 덮어쓸 수 있다.
TROVE는 그 사이에 있다.
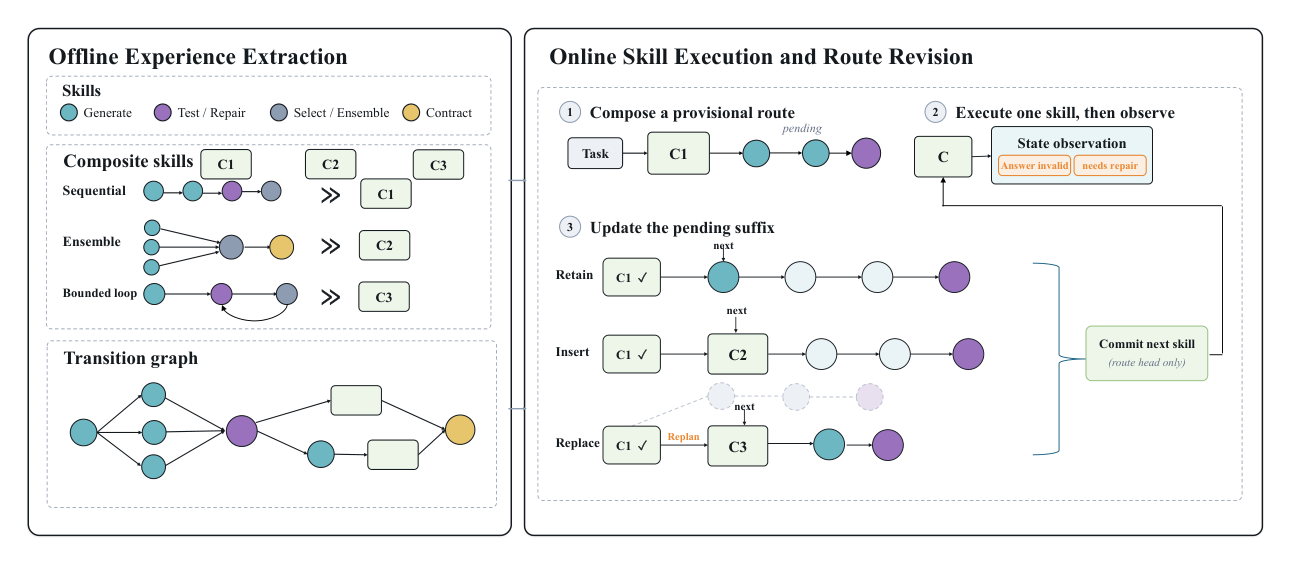
플래너가 낸 경로는 잠정안으로 두고 한 번에 최상위 스킬 하나만 실행한 뒤, 결과를 보고 남은 경로를 유지하거나 한 칸 끼워 넣거나 뒷부분만 교체한다.
전체 구조는 오프라인 경험 추출과 온라인 경로 수정 둘로 나뉜다.
3.2 Offline Experience Extraction
출발점은 AFlow의 operator다.
operator 하나가 워크플로의 실행 노드 하나이므로, 이를 atomic skill로 감싼다.
인터페이스에는 필요한 입력, 만들어 내는 산출물, 실행 상태, 반복 제약이 적힌다.
AFlow는 학습 분할에서 워크플로를 탐색하는데, 매 반복마다 노드 하나를 추가하거나 바꾸고 평가한다.
연속한 두 후보 사이의 점수 차이와 시간 차이가 남고, 이것이 노드 하나를 바꿨을 때 품질과 비용이 어떻게 달라지는지에 대한 비교 근거가 된다.
AFlow는 탐색이 끝나면 최종 워크플로 하나만 남기는데, TROVE는 탐색 과정 전체를 재료로 쓴다.
Atomic and Composite Skill Abstraction
효과가 있던 궤적에서 반복해서 나오는 국소 조각을 composite 후보로 잡는다.
후보가 composite skill로 승격되는 조건은 네 가지다.
- 내부 순서와 데이터 의존이 안정적이다
- 하나의 일관된 하위 목표를 수행한다
- 입출력 계약이 일정하다
- 바깥 경로를 참조하지 않고 실행할 수 있다
중간 결과에 따라 뒤의 최상위 결정이 달라질 수 있는 조각은 묶지 않고 쪼갠 채로 둔다.
composite는 atomic과 같은 인터페이스를 가지고, 호출되면 안에서 자식 스킬들을 실행하고, 바깥 컨트롤러에는 결과 하나만 돌려준다.
Figure 2 왼쪽을 보면 composite의 형태로 sequential, ensemble, bounded loop 세 가지가 그려져 있다.
-> “안정적이다”, “일관된 하위 목표다”를 누가 어떤 기준으로 판정하는지(규칙인지 LLM인지 사람인지)는 본문에 없다. 원문에서 확인 못 함.
Skill Transition Graph
결과에 따라 다음 행동이 달라지는 관계는 composite 안에 숨기지 않고 그래프에 남긴다.
간선 하나는 (s, e, c, g) 로 적는다.
s는 방금 끝난 최상위 스킬, e는 관찰된 경계 이벤트, c는 그 간선을 뒷받침하는 trace 조각들이 공유하는 관찰 가능한 특징, g는 바로 다음에 쓸 대응 스킬이다.
간선은 스킬이 단순히 붙어 나왔다는 사실만으로는 만들지 않고, 평가가 끝난 국소 수정에서만 만든다.
점수·시간 차이는 그 간선을 남길지 정하는 오프라인 근거로만 쓰고, 온라인 라우팅 입력으로는 쓰지 않는다.
배포 시 그래프의 역할은 두 가지로 제한된다.
실행 전에는 플래너에게 다음에 올 만한 스킬의 힌트를 준다.
스킬이 끝난 뒤에는 관찰된 결과를 조건으로 조회해서, 남은 경로가 무효일 때 다음 스킬 후보 하나를 낸다.
그래프가 워크플로 전체를 만들거나 남은 경로를 직접 고치지는 않는다.
후보를 끼워 넣을지, LLM 재계획의 참고로만 쓸지는 온라인 컨트롤러가 정한다.
3.3 Online Skill Execution and Route Revision
Provisional Route and One-Step Execution
플래너는 과제 x, 레지스트리 S, 그래프 G를 받아 짧은 경로 R0 = (s1, …, sk)를 제안한다.
TROVE는 맨 앞 스킬만 실행하고 나머지는 실행 안 한 suffix로 들고 있다.
스킬을 실행하면 경계 결과 o가 나와 실행 이력에 붙고, o에는 실행 상태, 쓸 수 있는 산출물, 다음 라우팅 결정에 관련된 신호가 요약된다.
Observation-Guided Route Update
결과가 과제 완료를 가리키면 현재 결과를 반환하고 남은 suffix는 버린다.
아니면 대기 중인 다음 스킬을 검사한다.
Retain은 다음 스킬이 최신 결과에서도 실행 가능할 때다.
suffix를 그대로 두고 LLM 라우팅 호출 없이 계속 간다.
다음 스킬이 없거나 더는 맞지 않으면 그래프를 조회한다.
그래프는 trace가 뒷받침하는 후보가 있으면 하나를 주고, 없으면 답하지 않는다.
Insert는 그 후보가 당장의 어긋남(수리, 테스트, 검증)을 해결하면서 suffix의 목적은 바꾸지 않을 때다.
후보를 suffix 앞에 둔다.
후보가 끝나면 원래 다음 스킬을 자동으로 실행하지 않고 다시 검사한다.
suffix가 비어 있으면 같은 연산이 경로를 한 칸 늘리는 역할을 한다.
Replace는 그래프가 답하지 않았거나, 그래프 근거가 모호하거나, 더 큰 변경이 필요할 때다.
LLM 재계획기가 과제, 최신 결과, 실행 이력, 대기 중인 suffix, 쓸 수 있는 스킬, 그리고 있으면 그래프 후보를 받아 새 suffix를 만든다.
워크플로를 다시 고르고 재실행하는 것과 달리 끝낸 prefix와 산출물은 남는다.
-> Retain과 Insert는 LLM 호출 없이 조회로 끝나고, Replace만 LLM을 부른다. 비용 차이는 여기서 나온다.
-> 그런데 “다음 스킬이 아직 실행 가능한가”와 “그래프 근거가 모호한가”를 무엇으로 판정하는지는 본문에 없다. 스킬 인터페이스의 입력·산출물 대조로 하는 것 같지만 ??
Iterative Execution
갱신된 경로의 맨 앞 스킬을 실행하고 같은 갱신을 반복하다가, 최종 결과가 나오거나 스텝 수·반복·무진전 한도에 걸리면 끝난다.
한도에 걸려 결과를 못 내면 미완료로 표시하고 벤치마크 평가기대로 채점한다.
4. Evaluation
4.1 Experimental Setup
벤치마크는 여섯 개다.
코드 생성은 HumanEval과 MBPP, 수학은 MATH와 GSM8K, 질의응답은 DROP(문단을 읽고 셈·비교를 해야 하는 독해)과 HotpotQA(문서 여러 개를 거쳐야 하는 multi-hop QA)다.
각각 약 1:4로 학습/테스트를 나눴고, 크기는 HumanEval 33/131, MBPP 86/341, MATH 119/486, GSM8K 264/1,055, DROP과 HotpotQA는 200/800이다.
워크플로 탐색, trace 수집, composite 구성, 그래프 구성은 학습 분할만 쓰고, 테스트 전에 전부 고정한다.
비교 대상은 AFlow, MaAS, LAS 셋이다.
각각 데이터셋 단위 오프라인 최적화, 질의 단위 실행 전 선택, 노드 단위 온라인 스케줄링을 대표한다.
LAS는 코드가 아닌 벤치마크용 gate가 공개되지 않아 코드 두 개에서만 비교했다.
지표는 점수, 온라인 실행 시간, 온라인 토큰이다.
점수는 HumanEval·MBPP가 pass@1(한 번 생성한 코드가 테스트를 통과한 비율), MATH·GSM8K가 정확도, DROP·HotpotQA가 토큰 단위 F1 평균이다.
시간은 테스트 분할 전체를 동시 실행 10으로 돌리는 데 걸린 wall-clock 시간(분)이다.
온라인 계획, 스킬 실행, 경로 검증, 재계획은 포함하고, 오프라인 탐색·레지스트리 구성·trace 정리는 뺀다.
백본은 DeepSeek-V4-Flash, GPT-4o-mini, Qwen3-8B이고 샘플당 타임아웃은 300초다.
최종 레지스트리는 atomic skill 10개와 composite skill 41개, 그래프의 실행 가능한 간선은 244개다.
초기 플래너는 최상위 스킬을 4개까지 제안하고, 온라인 실행은 최상위 스킬 호출 6번으로 제한된다.
-> 레지스트리와 그래프가 여섯 벤치마크 공용인지 벤치마크별로 따로인지는 문장만으로는 분명하지 않다. “The final TROVE registry”라고 단수로 적혀 있다.
4.2 Main Results and Analysis
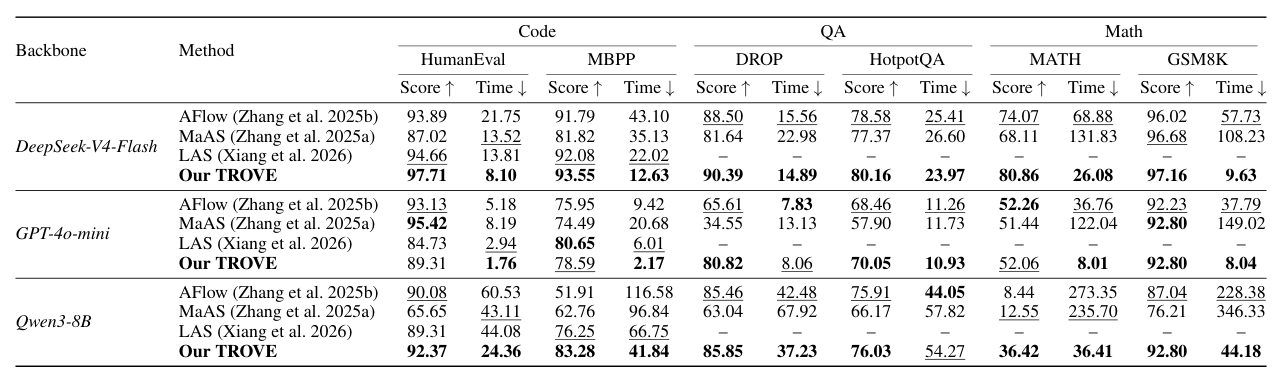
여섯 벤치마크의 테스트 분할에서 세 백본으로 점수(%)와 온라인 시간(분)을 잰 표다.
Overall Results
18개 설정 중 TROVE가 점수 1위거나 공동 1위인 게 15개, 시간이 가장 짧은 게 16개다.
AFlow와 비교하면 16개 설정에서 점수가 0.12~31.37점 올랐고, 16개 설정에서 시간이 2.9~86.7% 줄었다.
MaAS와 비교하면 17개에서 점수가 같거나 높고, 시간은 18개 전부에서 6.1~94.6% 줄었다.
LAS와 비교 가능한 코드 6개 설정에서는 5개에서 점수가 1.47~7.03점 높고, 시간은 6개 전부에서 37.3~63.9% 줄었다.
표에서 TROVE가 진 칸도 보인다.
GPT-4o-mini의 HumanEval은 AFlow 93.13, MaAS 95.42인데 TROVE는 89.31이다.
GPT-4o-mini의 MBPP는 LAS가 80.65로 TROVE(78.59)보다 높다.
GPT-4o-mini의 MATH는 AFlow 52.26, TROVE 52.06이다.
시간은 GPT-4o-mini DROP(AFlow 7.83, TROVE 8.06)과 Qwen3-8B HotpotQA(AFlow 44.05, TROVE 54.27)에서 AFlow가 더 짧다.
토큰은 DeepSeek-V4-Flash 기준 여섯 테스트 분할 합계로 TROVE 13.45M, AFlow 21.11M이어서 36.3% 적다.
다만 줄어든 건 주로 MBPP와 GSM8K이고, DROP과 HotpotQA는 TROVE가 토큰을 더 쓴다.
-> 벤치마크별 토큰 수치와 나머지 두 백본의 토큰은 본문에 없다. QA에서 얼마나 더 쓰는지는 알 수 없다.
Differences Across Tasks
MATH에서는 DeepSeek-V4-Flash 기준 AFlow보다 6.79점 높고 시간은 62.1% 줄었다.
여러 단계 추론이라 중간 결과가 뒤 단계를 무효로 만들 일이 많다는 설명이다.
GSM8K는 점수가 이미 천장 근처라 점수 차는 작지만, 일찍 끝내서 시간이 크게 줄었다.
DROP과 HotpotQA는 이득이 크지 않은데, 저자들은 이 둘의 어려움이 경로가 흔들리는 데 있기보다 근거 추출과 긴 문맥 처리에 있기 때문이라고 본다.
Differences Across Backbones
DeepSeek-V4-Flash는 여섯 과제 모두에서 점수와 시간이 같이 좋아졌다.
GPT-4o-mini는 시간은 줄지만 점수는 섞여 있다.
Qwen3-8B는 베이스라인 점수가 낮은 MBPP(51.91 → 83.28)와 MATH(8.44 → 36.42)에서 가장 크게 올랐다.
-> Qwen3-8B의 MATH에서 AFlow가 8.44, MaAS가 12.55인데 시간은 각각 273분, 235분이다. 300초 타임아웃에 걸려 미완료 처리된 샘플이 많았던 게 아닌가 싶은데, 타임아웃 비율은 본문에 없다. 그렇다면 이 칸의 차이는 경로 수정의 효과와 “시간 안에 끝냈느냐”가 섞여 있다.
Route-Adaptation Frequency
Figure 3은 DeepSeek-V4-Flash에서 실제 실행 경로가 처음 제안과 달라진 샘플 비율을 보여준다.
HumanEval은 54.20%로, 실행 중 교정이 자주 필요했다.
MBPP는 5.87%, DROP은 7.75%, HotpotQA는 2.88%로 대부분 처음 경로 그대로 갔다.
MATH는 98.97%, GSM8K는 100%인데, 앞쪽 composite가 일찍 답을 내서 남은 suffix가 필요 없어진 경우가 대부분이다.
캡션을 보면 이런 종료 가지치기도 Replace로 센다.
-> 그러면 수학 벤치마크의 시간 절감은 “틀어진 경로를 고친 것”보다 “답이 나왔으니 멈춘 것”에서 나온다. 조기 종료 규칙 하나만 AFlow에 붙여도 비슷한 시간이 나오는지는 실험에 없다.
4.3 Ablation Study
Qwen3-8B로 HumanEval 테스트 분할에서 구성요소를 하나씩 뺀 표다.
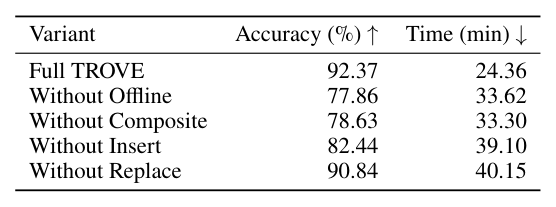
Full TROVE는 92.37%, 24.36분이다.
composite와 그래프를 둘 다 빼면(Without Offline) 77.86%로 14.51점 떨어지고 9.26분 늘어난다.
그래프는 두고 composite만 빼도(Without Composite) 78.63%로 13.74점 떨어지고 8.94분 늘어난다.
둘의 손실이 비슷하니, 이 설정에서 오프라인 이득의 대부분은 composite에서 나온다는 해석이다.
Insert를 빼면 82.44%로 9.93점 떨어지고 14.74분 늘어난다.
중간 실패마다 더 넓은 재계획으로 넘어가기 때문이다.
Replace를 빼면 정확도는 90.84%로 1.53점만 떨어지는데 시간은 15.79분 늘어난다.
Replace는 정답률보다는 가지치기와 맞지 않는 경로에서 빠져나오는 속도에 기여한다고 저자들은 해석한다.
-> Without Offline과 Without Composite의 차이가 0.77점, 0.32분이다. 그래프만 따로 뺀 변형은 없어서 transition graph 단독의 기여는 이 표로는 알 수 없다. Insert가 그래프 조회에 기대므로 Without Insert가 간접 증거이긴 하다.
5. Conclusion
저자들은 continuation invalidation을 별도의 오케스트레이션 문제로 세우고, 실행 안 한 경로를 검증해서 최소한만 고치는 것을 테스트 시점의 요구사항으로 제시했다.
TROVE는 탐색 trace를 composite skill과 transition graph로 정리하고, retain-insert-replace 컨트롤러로 끝낸 일을 보존한다.
6개 벤치마크와 3개 백본에서 품질과 온라인 효율이 세 부류의 베이스라인보다 좋았다는 게 결론이다.
원문에는 Limitations 절이 없다.
아래는 읽으면서 걸린 부분이다.
- 반복 실행 횟수나 분산이 보고되지 않았다. 0.12점, 0.48점 같은 차이가 잡음보다 큰지 알 수 없다
- 시간 지표에서 오프라인 비용(AFlow 탐색, trace 정리, 그래프 구성)이 빠져 있다. TROVE는 AFlow 탐색을 선행 조건으로 요구한다
- 시간이 API 호출의 wall-clock이라 제공자 지연에 영향을 받는다. 토큰은 한 백본의 합계만 나온다
- ablation이 Qwen3-8B × HumanEval 한 설정(테스트 131문제)뿐이다. 1.53점은 두 문제 차이다
- LAS와는 코드 두 벤치마크에서만 비교했다
- 벤치마크가 전부 단발 문제 풀이다. 도구 호출이 길게 이어지거나 환경 상태가 바뀌는 과제는 없다
6. 지금 관점: 계획을 몇 스텝까지 믿을까
ReAct는 매 스텝 LLM이 다음 행동을 정하고, 고정 워크플로는 한 번 정한 순서를 끝까지 돈다.
TROVE는 이 둘 사이에서 “계획은 4스텝까지 세우되 실행 약속은 1스텝”이라는 지점을 골랐다.
Voyager가 성공한 행동을 코드 스킬로 저장했다면, TROVE는 워크플로 탐색 중에 평가된 수정 기록에서 스킬과 전이 규칙을 뽑는다.
GenericAgent가 검증된 궤적을 SOP로 굳힌 것과도 닿아 있는데, TROVE는 굳힐 부분(composite)과 굳히면 안 되는 부분(결과에 따라 갈리는 분기)을 나누는 기준을 명시했다는 점이 다르다.
지금 가져다 쓸 수 있는 건 컨트롤러의 판단 순서다.
스킬 하나가 끝나면 먼저 끝났는지 보고, 다음 스킬이 아직 실행 가능한지 보고, 안 되면 조회 테이블에서 대응 하나를 찾고, 그것도 없을 때만 LLM에게 뒷부분을 다시 짜게 한다.
싼 판단을 앞에 두고 LLM 호출을 맨 뒤로 미루는 구조라, AFlow 없이도 기존 워크플로 엔진에 붙여 볼 수 있다.
“결과에 따라 다음 행동이 달라지는 지점은 스킬 안에 숨기지 말고 경계로 드러내라”는 composite 승격 기준도 스킬을 묶을 때 그대로 쓸 만하다.
ablation에서 이득의 대부분이 composite에서 나왔다는 것도 참고가 된다.
자주 같이 도는 스텝을 하나로 묶는 것만으로 작은 모델의 계획 부담이 꽤 줄어든다는 얘기다.
그대로 받아들이기 어려운 부분도 있다.
전이 그래프는 AFlow 탐색 trace에서 나오므로, 학습 분할과 자동 채점기가 있는 과제여야 만들 수 있다.
채점 기준이 없는 실서비스 과제에서는 무엇을 근거로 간선을 남길지부터 다시 정해야 한다.
벤치마크도 HumanEval, GSM8K처럼 이미 점수가 높은 단발 과제가 많고, 수학에서의 시간 절감은 대부분 조기 종료였다.
QA에서는 토큰이 오히려 늘었다.
그리고 판정 로직(다음 스킬이 유효한가, 그래프 근거가 충분한가)의 구현이 본문에 안 나와 있고 코드 공개도 원문에서 확인 못 했다.
재현하려면 이 부분을 직접 설계해야 하는데, 실제로는 이 판정의 정확도가 성능을 좌우할 가능성이 크다.
Leave a comment