
Jev-Mem Paper review
Jev-Mem: System-One-Controlled Agentic Memory for Efficient AI Agents
https://arxiv.org/abs/2609.23986
Jev-Mem 은 University of Texas at Dallas 에서 만든 에이전트 메모리 구조다.
저자는 3명이고 arXiv 에 올라온 논문이다.
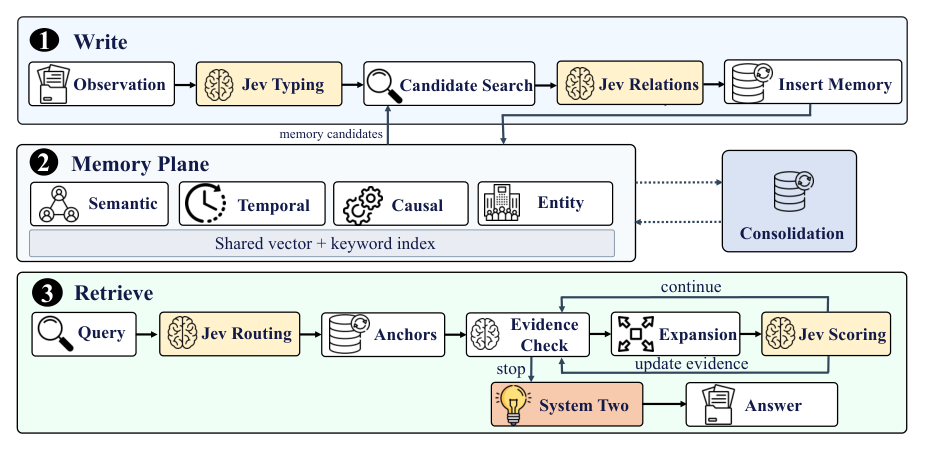
메모리를 만들고 검색하는 과정에 들어가는 판단(이 기억은 어떤 종류인가, 두 기억이 관련 있는가, 이 질의는 어느 그래프를 봐야 하는가, 증거가 충분한가)을 LLM 생성 대신 Jev 라는 컨트롤러의 확률 출력으로 처리하고, LLM 은 마지막 답변 합성에만 쓴다.
앞에서 본 REFLEX에서는 에이전트 스텝의 ‘고르는 일’을 작은 결정 모델에 맡겼는데, 이 논문은 같은 생각을 메모리 파이프라인 안쪽에 적용한다.
1. Introduction
에이전트가 오래 돌수록 사용자 선호, 작업 이력, 환경 지식이 쌓이고 컨텍스트 창에 다 넣을 수 없게 된다.
컨텍스트 길이를 늘려도 모델이 긴 입력의 모든 위치를 고르게 쓰지는 못하기 때문에 외부 메모리가 필요하다는 게 출발점이다.
저자들이 문제 삼는 건 메모리의 내용이나 구조보다 그 메모리를 제어하는 비용이다.
최근 메모리 시스템은 지식 그래프나 여러 관계 그래프를 두면서 풍부해졌는데, 그만큼 무엇을 저장하고, 무엇과 연결하고, 무엇을 꺼내고, 언제 검색을 멈출지를 계속 결정해야 한다.
기존 시스템은 이 결정을 고정 휴리스틱이나 범용 LLM 호출로 처리한다.
휴리스틱은 빠르지만 유연하지 않고, LLM 은 유연하지만 결정 하나마다 토큰을 생성해야 한다.
이 결정이 쓰기와 읽기 양쪽에 반복해서 나오기 때문에 메모리 제어가 지연과 추론 비용의 큰 부분이 된다고 본다.
여기에 System One / System Two 구분을 가져온다.
심리학의 이중 처리 이론에서 온 말로, System One 은 빠르고 자동적인 처리, System Two 는 느리고 숙고하는 처리를 가리킨다.
메모리 타입 분류, 관계 판단, 질의 라우팅, 후보 점수 매기기, 멈춤 판단은 System One 에 맞고, 증거를 종합해 답을 쓰는 일은 System Two 에 맞다는 것이다.
System One 자리에 들어가는 것이 Jev 다.
논문은 Jev 를 TypeSafe AI 의 것으로 인용하고, 자기회귀 생성 없이 타입이 정해진 확률적 결정을 내놓는다고만 설명한다.
-> Jev 가 어떤 모델인지(크기, 구조, 학습 방법)는 본문과 부록 어디에도 없다. 인용도 웹사이트 주소 하나다. 원문에서 확인 못 함.
기여는 네 가지로 적혀 있다.
- 가벼운 System One 식 결정으로 에이전트 메모리를 효율화할 수 있다는 관찰
- 메모리 제어와 생성 추론을 분리한 Jev-Mem 구조
- 쓰기와 읽기에 같은 컨트롤러를 쓰는 통합 제어 계층
- 비교한 베이스라인 중 가장 높은 정확도와 가장 좋은 효율
2. Background and Motivation
2.1 Agentic Memory
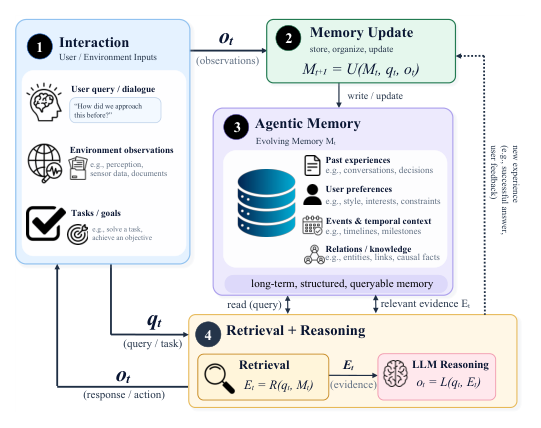
에이전트 메모리를 식 세 개로 적는다.
시점 $t$ 의 메모리를 $M_t$ 라 하면, 질의 $q_t$ 로 증거를 꺼내고($E_t = R(q_t, M_t)$), LLM 이 답을 만들고($o_t = L(q_t, E_t)$), 그 결과로 메모리를 갱신한다($M_{t+1} = U(M_t, q_t, o_t)$).
저자들의 질문은 $U$ 와 $R$ 안에 들어 있는 판단을 어떤 계산 장치가 실행해야 하느냐다.
쓰기에서는 새 정보를 어떻게 규정하고 기존 지식과 어떻게 이을지를 정해야 한다.
읽기에서는 어디를 찾을지, 어떤 후보가 쓸모 있는지, 더 찾을지, 증거가 충분한지를 정해야 한다.
Self-RAG, Adaptive-RAG 같은 적응형 RAG 연구는 검색을 제어되는 결정 과정으로 봤고, 이 논문은 그 관점을 이어받는다.
Jev-Mem 은 그 범위를 증거 수집에서 메모리 구축, 라우팅, 예산 배분, 그래프 탐색, 멈춤까지 넓힌다.
2.2 The Opportunity for System-One Memory Control
이 절의 관찰은 한 문장이다.
메모리 제어 연산의 다수는 “semantic but not generative” 하다.
의미를 이해해야 하지만 출력은 라벨, 확률, 점수처럼 범위가 정해져 있고 자유 텍스트가 필요 없다.
이런 판단에 자기회귀 LLM 을 쓰면 간단한 예/아니오에도 토큰 생성, 형식 맞추기, 파싱이 따라붙는다.
이 연산이 메모리 경로에 반복해서 나오므로 비용이 빠르게 쌓인다.
FrugalGPT, RouteLLM 같은 캐스케이드·라우팅 연구는 요청 단위로 싼 모델과 비싼 모델을 나눠 쓴다.
Jev-Mem 은 그보다 잘게, 요청 하나 안에 들어 있는 제어 결정과 생성 추론을 나눈다.
3. Jev-Mem Algorithm Design
구성 요소는 셋이다. System One 컨트롤러, 공유 메모리 평면, System Two 추론 모델.
관측 하나는 $o_t = (x_t, \tau_t, \mu_t)$, 곧 내용, 선택적인 타임스탬프, 출처로 이루어진다.
메모리는 노드 집합 $V_t$, 네 종류의 간선 집합, 벡터 색인, 키워드 색인으로 구성된다.
간선 종류는 semantic, temporal, causal, entity 넷이다.
네 관계 뷰가 같은 노드를 공유하고, 같은 노드 쌍 사이에 여러 종류의 간선이 동시에 걸릴 수 있다.
-> 네 관계 종류는 베이스라인으로 나오는 MAGMA 와 같다. 참고문헌을 보면 MAGMA 도 같은 저자들의 논문이다. 그래프 구조는 물려받고 제어 방식을 바꾼 것으로 보이는데, 본문이 그렇게 명시하지는 않는다.
3.1 Typed System-One Memory Control
컨트롤러의 인터페이스는 $J(S, Q)$ 다.
$S$ 는 구조화된 상태, $Q$ 는 명시적인 결정 질문 묶음이다.
출력은 둘 중 하나다. 서로 독립인 명제 각각의 확률이거나, 서로 배타적인 선택지에 대한 분포다.
“두 기억이 의미상 관련 있는가”, “이 후보가 질의와 관련 있는가”, “증거가 충분한가”는 앞쪽이고, 시간 관계를 before/after 등에서 하나 고르는 건 뒤쪽이다.
자유 형식 프롬프트와 다른 점은 두 가지로 설명한다.
출력 공간이 작고 미리 정해져 있어서 중간 추론 문장을 생성하고 파싱하는 단계가 없다.
같은 상태를 공유하는 질문들을 한 번의 배치 호출로 평가할 수 있다.
쓰기와 읽기가 같은 인터페이스를 쓴다는 점을 구조상의 특징으로 내세운다.
부록을 보면 질문 하나는 지시문과 true 기준, false 기준으로 이루어지고 값은 0에서 1 사이로 돌아온다.
부록에는 이런 단서도 있다. “These model-reported values are not assumed to be calibrated probabilities.”
-> 보정된 확률이라고 가정하지 않는다면서 뒤에서는 이 값에 0.60, 0.95, 0.15 같은 임계값을 건다. 임계값을 어떻게 정했는지는 원문에서 확인 못 함.
3.2 System-One-Guided Memory Construction
쓰기 경로는 타입 분류, 후보 찾기, 관계 판단, 삽입 순서다.
먼저 유효한 관측은 전부 노드로 저장한다.
들어오는 시점에 저장할지 버릴지를 학습된 판단으로 결정하지 않는다.
처음에는 중요해 보이지 않던 정보가 나중 질의에서 필요해질 수 있어서다.
선별은 관계를 만들 때와 검색할 때 한다.
컨트롤러는 노드마다 네 가지 타입 점수를 낸다. episodic, semantic, procedural, preference.
한 범주로 나누지 않고 네 점수를 노드에 함께 붙인다.
노드에는 원문 관측, 출처, 타임스탬프, 임베딩, 엔티티, 타입 점수가 남는다.
-> 이 타입 점수가 이후 검색에서 어떻게 쓰이는지는 3.3 의 식에 나오지 않는다. 붙여 두기만 하는 건지 ??
새 관측을 기존 노드 전부와 비교하면 메모리가 커질수록 컨트롤러 비용이 같이 커진다.
그래서 후보 찾기와 관계 판단을 나눈다.
후보는 결정적인 방법으로 고른다. 벡터 유사도, 단어 겹침, 공유 엔티티, 시간상 가까움을 합쳐 최대 $K_w$ 개를 뽑는다(부록 기준 10개).
Jev 는 이 후보 쌍만 본다.
쌍마다 의미 관련성, 방향 있는 인과, 같은 에피소드인지, 필요하면 엔티티 동일성을 추정한다.
이미 구조화된 정보가 있으면 추론을 건너뛴다.
타임스탬프가 있으면 순서로 temporal 간선을 바로 만들고, 엔티티 식별자가 정확히 같으면 entity 간선을 바로 만든다.
시간 순서가 암묵적일 때만 컨트롤러가 before, after, during, contains, overlaps, same_time, unknown 중 하나를 고른다.
추론한 간선은 확률이 임계값 $\theta_{rel}$ 이상일 때만 넣는다(부록 기준 0.60).
주기적인 정비도 있다.
한정된 이웃 범위에서 중복, 모순, 낡음, 추가할 링크를 살핀다.
이때도 원본 관측은 지우지 않는다.
요약이나 추상화 텍스트가 필요하면 컨트롤러가 merge 나 promote 를 승인했을 때만 System Two 를 부른다.
생성은 구조화된 결정이 승인했을 때만 따라오는 선택 사항이다.
부록 기준으로 20번 쓸 때마다 한 번 돌고, 선택 확률이 0.85 이상일 때만 요약을 만든다.
3.3 Adaptive System-One Retrieval
검색은 top-k 한 번으로 끝나지 않고 루프를 돈다.
route, retrieve, assess, expand, reassess 순으로 돈다.
라우팅과 예산 배분
질의가 들어오면 컨트롤러가 네 관계 뷰 각각의 필요도 $p_g(q)$ 와, 멀티홉 필요도 $h(q)$, 최신성 중요도 $r(q)$ 를 낸다.
각 확률을 독립으로 평가하므로 한 질의가 여러 그래프를 동시에 켤 수 있다.
$p_g(q)$ 가 임계값 이상인 그래프가 활성 그래프다.
전체 그래프 확장 예산 $B$ 를 활성 그래프에 나눈다.
활성 그래프마다 최소 예산 $m$ 을 먼저 주고, 남은 예산을 $p_g(q)^\gamma$ 비율로 나눈다.
탐색 깊이도 질의마다 다르다.
부록의 설정값은 예산 80, 활성 임계값 0.10, $\gamma$ 1.0 이다.
Anchor retrieval
그래프를 타기 전에 진입점을 잡는다.
벡터 검색 순위와 키워드 검색 순위를 RRF(reciprocal rank fusion, 각 목록에서의 순위 역수를 더해 합치는 방법)로 합친다. 상수 $\kappa$ 는 60이다.
상위 노드가 방문 집합과 탐색 경계의 초기값이 된다.
Evidence-guided expansion
라운드마다 컨트롤러가 지금까지 모은 증거를 놓고 네 가지를 추정한다.
- 증거 충분성 $s_d$
- 더 검색했을 때의 기대 효용 $u_d$
- 빠진 필수 증거 $m_d$
- 풀리지 않은 모순 $c_d$
충분성이 임계값 이상이고 빠진 증거와 모순이 임계값 미만이면 멈춘다.
충분하지 않더라도 기대 효용이 낮으면 멈춘다.
부록 기준으로 충분성 0.95 이상, 나머지는 0.15 미만이다.
너무 일찍 멈추면 필요한 증거를 놓치고, 계속 넓히면 관련 없는 기억이 섞여 답변 모델을 흐트러뜨린다는 게 이 장치를 둔 이유다.
더 찾아야 하면 그래프별 예산 안에서 이웃 노드를 넓힌다.
후보마다 컨트롤러가 네 값을 낸다. 질의 관련성 $a_v$, 관계의 유용성 $\ell_v$, 새로운 정보인지 $n_v$, 현재 증거를 뒷받침하는지 $c_v$.
이 값을 결정적 신호와 섞어 점수를 만든다.
$z_v$ 는 임베딩 유사도, $\pi_e$ 는 저장된 간선 가중치다.
타임스탬프가 있으면 $r(q)$ 로 최신성 보정을 더한다.
상위 $W$ 개가 다음 빔이 되고 증거에 누적된다(부록 기준 빔 폭 10).
-> $\lambda_1$ 부터 $\lambda_5$ 의 값은 본문에도 부록에도 없다. 원문에서 확인 못 함. 점수의 다섯 항 중 어느 것이 실제로 효과를 내는지 알 수 없다.
검색이 끝나면 점수 상위 $K$ 개 기억을 System Two LLM 에 넘겨 답을 만든다.
System Two 는 라우팅, 후보 확장, 멈춤 판단에 관여하지 않는다.
제어 비용에는 상한이 있다.
쓰기 한 번은 타입 분류 배치 요청 하나와, 후보가 있을 때 관계 판단 배치 요청 하나다.
질의 한 번은 라우팅 요청 하나와, 라운드마다 증거 평가 최대 하나, 후보 점수 배치 최대 하나다.
부록의 한도는 깊이 8, 방문 노드 60, 검사 간선 2400, Jev 호출 16번, 검색 시간 15초다.
이 한도에 걸리면 증거가 불완전해도 검색이 끝난다.
4. Experiments
4.1 Experimental Setup
데이터는 LoCoMo(여러 세션에 걸친 아주 긴 대화를 주고 시간·인과·세션 간 추론이 필요한 질문을 묻는 장기 대화 메모리 벤치마크)다.
-> 본문은 벤치마크 두 개에서 평가한다고 쓰는데 설명과 결과는 LoCoMo 하나뿐이다. 나머지 하나가 무엇인지 ??
베이스라인은 다섯이다.
- Full Context: 외부 메모리 없이 대화 이력 전체를 LLM 에 넣는다
- A-MEM: 기억 노트끼리 링크를 걸고 기존 기억을 고쳐 쓰며 진화시킨다
- Nemori: 대화를 에피소드로 나누고 그래프 기반으로 검색한다
- MemoryOS: 단기·중기·장기 계층으로 메모리를 관리한다
- MAGMA: semantic, temporal, causal, entity 네 관계로 기억을 표현한다
답변 모델은 gpt-4o-mini 이고, 적용 가능한 경우 모든 방법에 같은 답변 모델을 썼다고 적혀 있다.
지표는 셋이다.
정확도는 LLM-as-a-Judge 점수(LLM 이 생성 답과 정답을 비교해 맞았는지 판정)로 잰다.
효율은 메모리 구축 시간(대화 이력으로 메모리를 다 만드는 데 걸린 총 시간)과 질의당 평균 지연(검색부터 답 생성까지)으로 잰다.
판정에 쓴 모델과 프롬프트, 반복 실행 횟수, 실험 장비는 원문에서 확인 못 함.
4.2 Overall Performance
다음은 LoCoMo 에서 질문 유형별로 LLM-as-a-Judge 점수를 잰 표다.
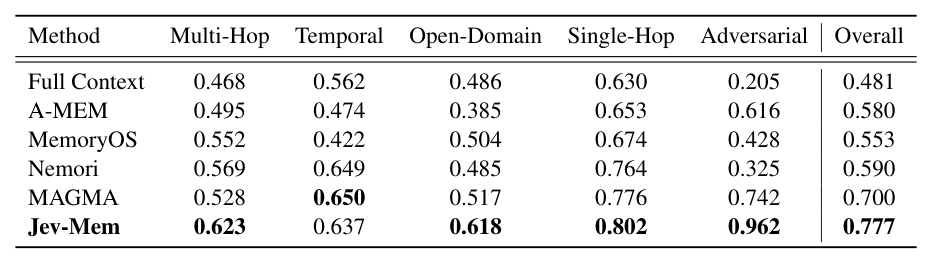
Overall 은 Jev-Mem 0.777, 가장 높은 베이스라인인 MAGMA 가 0.700 이다. 상대 11.0% 향상이다.
유형별로 MAGMA 와의 차이를 보면 Multi-Hop 0.623 대 0.528, Open-Domain 0.618 대 0.517, Single-Hop 0.802 대 0.776, Adversarial 0.962 대 0.742 다.
Temporal 은 0.637 로 MAGMA 의 0.650, Nemori 의 0.649 보다 낮다.
차이가 가장 큰 곳은 Adversarial 이다.
MAGMA 와 0.220, Full Context(0.205)와는 0.757 차이가 난다.
저자들은 여러 기억의 증거를 합쳐야 하거나, 그럴듯하지만 틀린 정보와 관련 정보를 구분해야 할 때 이득이 크다고 해석한다.
라우팅, 예산 배분, 후보 평가, 멈춤 판단이 질의마다 달라져서 답변 모델이 더 좁고 관련 있는 증거를 받는다는 설명이다.
-> Adversarial 격차가 다른 유형의 두 배 이상이라 Overall 차이의 상당 부분이 여기서 나왔을 것 같다. 다만 유형별 문항 수가 논문에 없어서 정확한 기여분은 계산할 수 없다.
본문 서술과 표가 맞지 않는 곳이 여러 군데 있다.
본문은 Multi-Hop 0.625, Open-Domain 0.610, Single-Hop 0.797 이라고 쓰는데 표는 0.623, 0.618, 0.802 다.
본문은 Temporal 에서 최고점 0.650 과 같다고 쓰는데 표의 Jev-Mem 은 0.637 이다.
본문은 여섯 유형 중 다섯에서 가장 높다고 쓰는데 표의 유형은 다섯 개이고 그중 넷에서 가장 높다.
-> 어느 쪽이 맞는 수치인지 알 수 없다. 이 글에서는 표의 값을 따랐다.
4.3 Efficiency of System-One Memory Control
Table 2 는 메모리 구축 시간과 질의당 평균 지연을 비교한다.
구축 시간은 Jev-Mem 158초, Nemori 1,044초, MAGMA 1,404초, MemoryOS 3,276초, A-MEM 3,636초다.
가장 빠른 베이스라인인 Nemori 대비 84.9% 감소, 6.6배 빠르다.
질의 지연은 Jev-Mem 0.93초, MAGMA 1.47초, Full Context 1.74초, A-MEM 2.26초, Nemori 2.59초, MemoryOS 32.68초다.
메모리 기반 베이스라인 중 가장 빠른 MAGMA 보다 36.7%, Full Context 보다 46.6% 낮다.
이유는 이렇게 설명한다.
쓰기에서는 범용 LLM 을 여러 번 부르는 대신 한정된 후보 집합에 대해 타입 결정을 배치로 처리한다.
읽기에서는 라우팅, 후보 평가, 증거 확인을 System One 이 하고 그래프 탐색은 예산으로 묶이며, 증거가 충분하면 탐색을 멈춘다.
-> 지연 0.93초에는 gpt-4o-mini 답변 생성 시간도 들어 있다. 그중 Jev 호출이 얼마이고 라운드를 평균 몇 번 도는지는 나오지 않는다. 부록의 코드명(TypeSafeClient)을 보면 Jev 도 외부 제공자를 호출하는 형태로 보이는데, 호출 수와 요금은 원문에서 확인 못 함.
5. Conclusion
Jev-Mem 은 빈도가 높은 메모리 제어 결정을 가벼운 구조화 예측으로 처리하고 System Two 는 추론과 답변 합성에만 쓴다.
LoCoMo 에서 LLM-as-a-Judge 0.777, 메모리 구축 158초, 질의 지연 0.93초를 보고한다.
저자들은 메모리 제어와 생성 추론의 분리가 유망한 방향이라고 맺는다.
논문에 Limitations 절은 없다.
읽으면서 걸린 한계를 적어 둔다.
- 벤치마크가 LoCoMo 하나이고 답변 모델도 gpt-4o-mini 하나다
- ablation 이 없다. 라우팅, 적응형 멈춤, 네 관계 뷰, Jev 자체 중 무엇이 점수를 올렸는지 분리되지 않는다
- Jev 를 같은 프롬프트의 작은 LLM 이나 분류기로 바꾼 대조군이 없다
- 본문과 표의 수치가 여러 곳에서 다르다
- 토큰 사용량과 비용, Jev 호출 횟수가 없다. 효율 지표는 시간 두 가지뿐이다
- 분산이나 반복 실행 결과가 없다
6. 지금 관점: 메모리 제어를 LLM 밖으로 빼는 게 맞는 방향인가
블로그에서 본 Anatomy of Agentic Memory는 메모리 시스템이 에이전트답게 굴수록 붙는 비용을 실측했고, 참고문헌을 보면 이 논문과 1저자가 같다.
그 비용을 줄이는 쪽으로 낸 답이 Jev-Mem 이라고 읽으면 흐름이 이어진다.
REFLEX가 에이전트 스텝에서 선택지와 확신도만 내는 결정 모델을 둔 것과 구조가 같고, 적용 위치가 메모리의 쓰기·읽기 경로라는 점이 다르다.
원본 관측을 지우지 않고 다 남긴다는 선택은 MemMachine과 같은 쪽이다.
가져다 쓸 수 있는 건 Jev 가 없어도 성립하는 설계 부분이다.
메모리 파이프라인에서 출력이 라벨이나 점수로 끝나는 판단을 골라내고, 그 판단은 자유 텍스트 생성 없이 처리한다는 구분은 어떤 스택에서든 해볼 수 있다.
후보를 결정적인 방법으로 먼저 줄이고 모델 판단은 그 후보에만 쓰는 것, 타임스탬프나 엔티티 식별자가 있으면 모델을 부르지 않고 간선을 만드는 것, 검색 루프에 깊이·노드 수·호출 수·시간 상한을 다 걸어 두는 것도 그대로 옮길 수 있다.
부록에 질문 템플릿과 임계값이 실려 있어서 작은 분류 모델이나 logprob 을 읽는 방식으로 비슷하게 만들어 보는 출발점으로는 충분하다.
그대로 받아들이기 어려운 부분은 수치다.
LoCoMo 하나에서 잰 결과이고, Anatomy of Agentic Memory가 다룬 벤치마크 포화와 백본 의존 문제가 이 실험에도 그대로 걸린다.
구조화 메모리의 이득이 구조에서 오는지를 물은 ReFind 같은 강한 단순 검색 베이스라인은 비교에 없다.
가장 큰 격차가 난 Adversarial 에서 무엇이 효과를 냈는지(후보 점수의 관련성 항인지, 증거 충분성 임계값 0.95 인지, 그래프 구조인지)는 ablation 이 없어서 확인할 길이 없다.
그리고 이 구조의 속도는 Jev 라는 특정 제품에 달려 있다.
Jev 가 무엇인지, 얼마인지, 다른 모델로 바꾸면 정확도가 얼마나 떨어지는지가 빠져 있어서 “제어를 분리하면 빨라지고 정확해진다”는 주장 중 어디까지가 분리의 효과이고 어디부터가 Jev 의 효과인지는 이 논문만으로는 가를 수 없다.
Leave a comment