
Anatomy of Agentic Memory Paper review
Anatomy of Agentic Memory: Taxonomy and Empirical Analysis of Evaluation and System Limitations
https://arxiv.org/abs/2602.19320
Anatomy of Agentic Memory는 UT Dallas · UC Davis · Texas A&M에서 쓴 에이전트 메모리 평가 논문이다. 2026년 2월 arXiv에 올라왔다.
앞 리뷰들에서 수치를 많이 가져왔다. Mem0의 66.88, Zep의 71.2, A-MEM의 순위 1.0 같은 것들이다.
이 논문은 그 수치들을 어떻게 읽어야 하는지를 따진다. 읽어보면 생각보다 약한 근거인 게 많다.
1. Introduction
introduction 부분을 보면 아키텍처는 빠르게 발전했는데 실험적 근거는 약하다는 문제의식에서 출발한다.
벤치마크는 대부분 작고, 평가 지표는 의미랑 어긋나고, 성능이 백본 모델에 따라 크게 달라지고, 시스템 비용은 잘 안 본다.
이걸 질문 네 개로 정리한다.
- 벤치마크 타당성 : 재고 있는 게 메모리인가 컨텍스트 길이인가?
- 지표 신뢰성 : 어휘 지표가 의미적 일관성을 잡아낼 수 있는가?
- 시스템 효율 : 지연과 비용의 “agency tax”(메모리 유지보수 때문에 더 드는 지연·비용)
- 백본 민감도 : 오픈웨이트 모델에서 메모리 연산이 조용히 실패하는 “silent failure”
2. Background
에이전트 메모리를 모델 가중치는 그대로 두고, 외부 메모리 상태를 검색해 프롬프트에 붙이는 방식으로 정의한다.
매 단계마다 메모리에서 꺼내 쓰는 recall과, 저장·갱신·통합하는 update 두 과정이 맞물려 돈다고 본다.
3. Taxonomy of Agentic Memory
Memory-Augmented Generation(MAG, 외부 메모리를 붙여 생성하는 시스템)을 메모리 구조에 따라 넷으로 나눈다.
- Lightweight Semantic Memory : 가벼운 의미 저장소
- Entity-Centric and Personalized Memory : 엔티티 중심 개인화
- Episodic and Reflective Memory : 일화·반성
- Structured and Hierarchical Memory : 구조화·계층
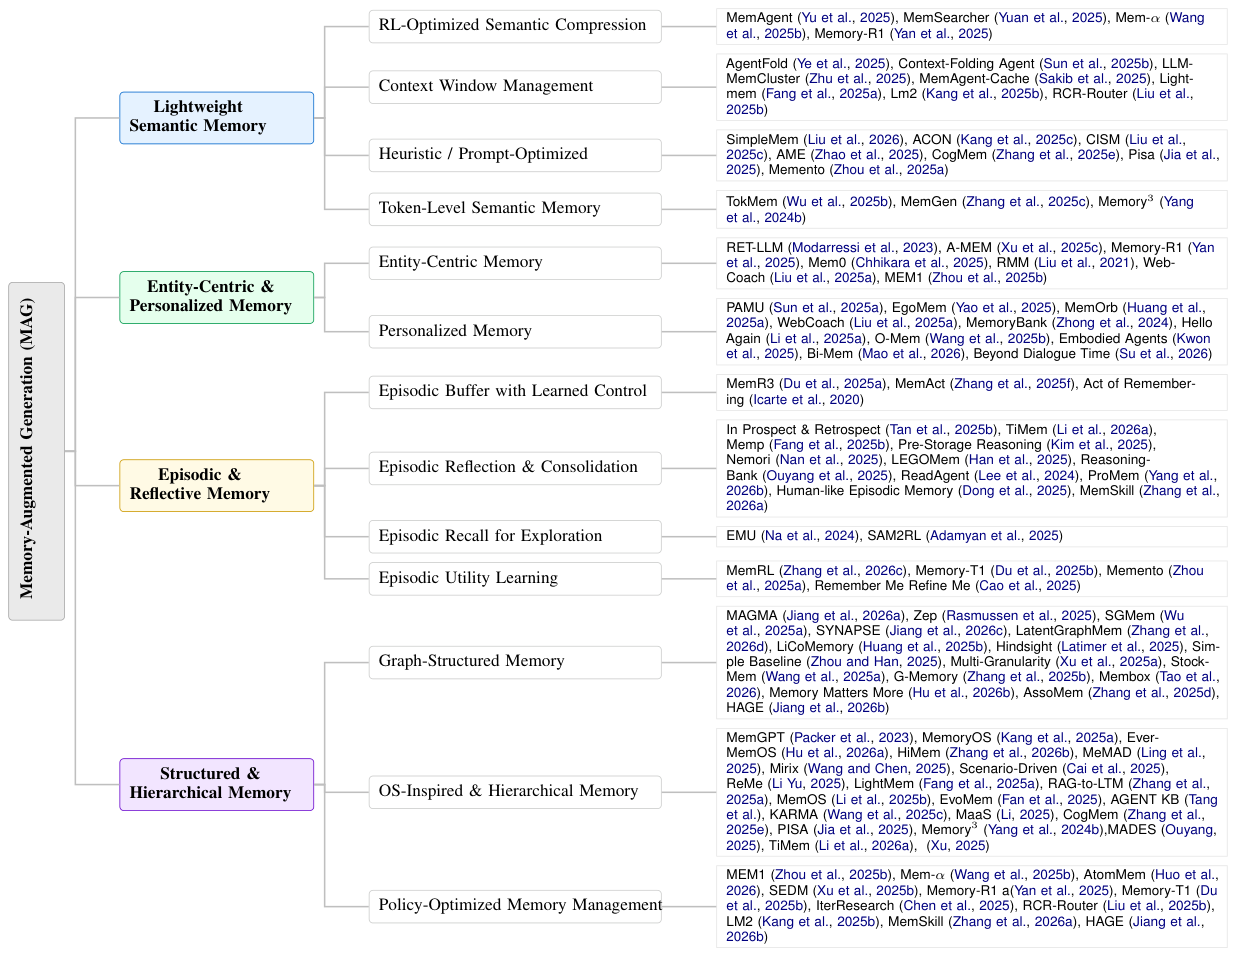
네 갈래 아래에 세부 유형과 해당 시스템들이 달려 있다. 부록에 있는 그림이다.
앞에서 본 것들을 넣어보면 Mem0와 A-MEM은 Entity-Centric, NEMORI는 Episodic Reflection, Zep과 SYNAPSE는 Graph-Structured, MemGPT는 OS-Inspired 칸에 들어가 있다.
-> A-MEM은 노트끼리 링크를 거는 구조라 그래프 쪽일 줄 알았는데 엔티티 중심에 들어가 있다. 노트에 속성을 붙이는 쪽을 본 것 같다.
분류는 앞에서 본 서베이랑 크게 다르지 않다. 실제 분석은 뒤에서부터 나온다.
4. Evaluation and Pain Points
4.1 Experimental Setup
분류 네 갈래에 걸쳐 AMem, MemoryOS, Nemori, MAGMA, SimpleMEM, MemSkill 여섯 시스템을 고른다.
각 시스템은 기본 설정을 따르고, 에이전트 컨트롤러로 gpt-4o-mini와 Qwen-2.5-3B를 쓴다.
4.2 Benchmark Scalability: The Context Saturation Risk
벤치마크 포화 문제다.
에이전트 메모리를 쓰는 이유는 유한한 컨텍스트 창을 넘어서 추론하려는 것이다.
그런데 컨텍스트 창이 128k에서 1M으로 늘어나면서 많은 벤치마크가 포화될 위험이 생겼다. 필요한 정보가 전부 프롬프트 하나에 들어가면 외부 메모리가 필요 없어 보인다.
4.2.1 Dimensions of Limitation
포화 위험을 세 가지 기준으로 본다.
- Volume : 총 토큰 양. HotpotQA(~1k), MemBench(~100k)는 128k 창에 다 들어간다
- Interaction depth : 정보가 세션에 걸쳐 얼마나 길게 이어지는지. HotpotQA는 단일 턴, LoCoMo는 35세션
- Entity diversity : 동시에 따라가야 하는 엔티티(사람·주제)가 몇 개인지
아래 표는 벤치마크 다섯 개를 이 세 기준으로 매기고 포화 위험을 적은 것이다.
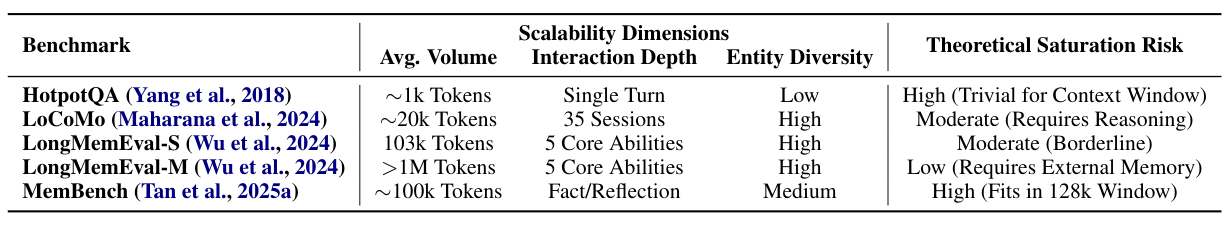
모델 성능 대신 벤치마크 자체 통계로 매긴 추정치다. 포화 위험은 long-context LLM이 프롬프트에 다 넣고 풀 수 있을지를 가늠한 값이다.
외부 메모리가 꼭 필요하다고 나온 건 1M 토큰이 넘는 LongMemEval-M 하나다. LongMemEval-S는 “보통(경계)”이다.
포화 위험은 겉보기 난이도보다 이런 구조적 특성이 long-context LLM이 감당할 수 있는 범위를 넘느냐로 정해진다는 게 논문 설명이다.
4.2.2 Context Saturation Gap as an Empirical Diagnostic
그래서 진단 지표를 하나 제안한다.
∆ = Score_MAG − Score_FullContext
같은 백본, 같은 평가 방식에서 메모리 에이전트 점수랑 대화를 통째로 넣은 full-context 점수의 차이다.
∆가 크게 양수면 외부 메모리가 증거를 전부 프롬프트에 넣는 것보다 낫다는 뜻이다. 특히 창 밖(out-of-window)이나 lost-in-the-middle 상황에서 그렇다.
다만 ∆는 합격/불합격 기준으로 쓰지 말고 진단 신호로 봐야 한다고 한다. full-context가 잘 나와도 효율, 갱신 가능성, 강건성, 증거 충실성 쪽에서 메모리를 볼 수 있기 때문이다.
이 시리즈 앞 리뷰들 수치로 ∆를 계산해보면 이렇게 된다. 논문 표가 아니라 내가 앞 리뷰 수치로 계산한 것이다.
| 논문 | MAG | Full-context | ∆ |
|---|---|---|---|
| MemGPT (DMR, GPT-4 Turbo) | 93.4 | 94.4 (Zep 측정) | −1.0 |
| Mem0 (LOCOMO, 전체 J) | 66.88 | 72.90 | −6.02 |
| Zep (LongMemEval, GPT-4o) | 71.2 | 60.2 | +11.0 |
MemGPT와 Mem0는 ∆가 음수다. 대화를 통째로 넣는 게 더 정확하다.
-> 그러면 이 두 시스템은 정확도보다는 지연이랑 토큰 비용 때문에 쓰는 거라고 봐야 할 것 같다.
Zep은 ∆가 +11이다. LongMemEval-S는 대화가 10만 토큰이 넘는다(이 논문 Table 2 기준 103k, Zep 논문은 약 115k). 앞의 Table 2에서 포화 위험이 “보통(경계)”인 벤치마크라 full-context가 덜 유리했을 수 있다.
논문은 양이 작고 구조가 얕은 데이터셋이면 full-context 베이스라인과 같이 평가해야 메모리 덕분에 좋아졌다고 말할 수 있다고 한다.
4.3 LLM-as-a-Judge Evaluation
F1과 의미가 어긋난다는 부분이다.
F1, BLEU 같은 어휘 지표는 토큰이 얼마나 겹치는지를 본다. 에이전트 메모리처럼 정확히 찾아서 일관되게 종합해야 하는 과제에는 부족하다(insufficient).
LoCoMo에서 여섯 아키텍처를 F1 순위와 LLM 판정(gpt-4o-mini) 순위로 각각 매겨 비교한다. 판정 프롬프트는 MAGMA, Nemori, SimpleMem 논문에서 하나씩 가져온 세 가지다. 아래 논문 Table 3에서 왼쪽 Lexical Metric의 Rank 열과 오른쪽 세 프롬프트 열의 괄호 속 순위를 비교하면 된다.
MAGMA는 메모리를 의미·시간·인과·개체 그래프로 나눠 두는 그래프 계열이고, SimpleMem은 턴 단위로 가볍게 저장하는 방식이다. MemoryOS는 3단 계층을 둔 OS 계열, MemSkill은 메모리 스킬을 학습해 고쳐 가는 정책 최적화 계열이다.
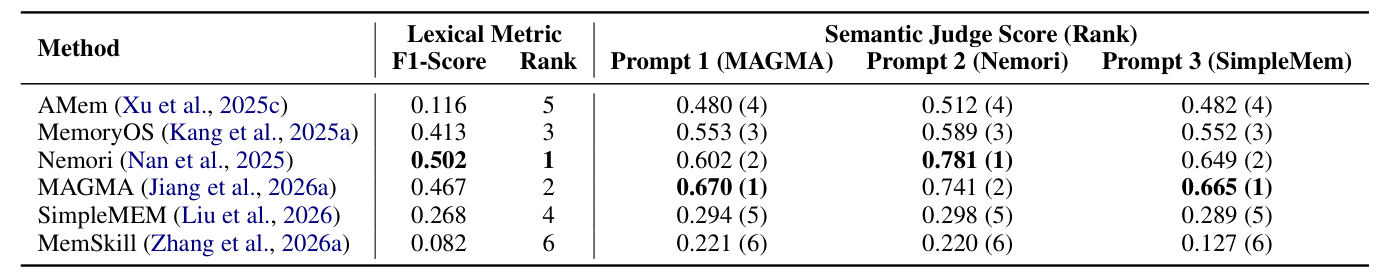
A-Mem은 F1은 0.116으로 5위인데 판정 순위는 세 프롬프트 모두 4위다. 논문은 A-Mem이 원문 단어를 그대로 쓰지 않아서 F1에서 손해를 본다고 설명한다.
반대로 SimpleMem은 판정 점수가 0.30 미만(5위)인데 F1은 0.268로 4위다.
논문은 F1만 보고 최적화하면 추론이나 메모리 통합보다 표면적인 암기를 좋아하게 된다고 지적한다.
앞에서 본 Mem0에서 A-Mem의 J 점수가 낮았다(48.38). 여기서도 판정 순위가 6개 중 4위라 A-Mem이 잘했다고 하기는 어렵다.
LLM-as-a-judge가 프롬프트에 과적합되는 게 아니냐는 걱정도 있는데, 위 Table 3처럼 프롬프트 세 개에서 상대 순서가 거의 유지됐다. 그래도 프롬프트 설계는 조심해야 한다고 덧붙인다.
4.4 Backbone Sensitivity and Format Stability
에이전트 메모리에서는 백본 모델이 질문에 답하는 것과 메모리 연산(갱신·통합)을 둘 다 해야 한다. 그래서 오래 쓰려면 출력 형식을 정확히 지켜야 한다.
API 모델(gpt-4o-mini)과 오픈웨이트(Qwen-2.5-3B)에서 답변 점수와 메모리 연산 중 형식 오류율(JSON 깨짐, 없는 키 생성 등)을 잰 것이 논문 Table 4다. Format Error 열을 보면 된다.
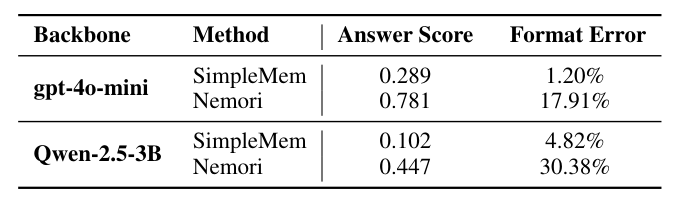
논문은 이걸 silent failure라고 부른다. 당장은 대화를 잘하는데, 쓰기 연산이 실패해서 장기 메모리가 망가진다. 겉으로는 멀쩡해 보인다.
영향은 아키텍처 복잡도에 따라 다르다.
- Append-only 시스템 : 구조화 생성이 적어서 비교적 버틴다
- 그래프 기반·일화 기반 : 엔티티 추출, 관계 구성, 중복 제거 때문에 형식 오류가 크게 는다
약한 백본에서는 그래프·일화 쪽 구조가 불안정해지거나 메모리 유지가 무너지는 경우가 많다.
앞에서 본 A-MEM에서는 “조직의 품질이 기반 모델 능력에 좌우될 수 있다”고 걱정만 했는데, 여기서는 30.38%라는 숫자가 나왔다.
gpt-4o-mini에서도 Nemori 형식 오류가 17.91%다. API 모델이라고 안전한 것도 아니다.
-> 표의 형식 오류는 “복구 가능한” 오류, 즉 fallback 파싱으로 살린 경우를 센 거라고 한다. 그럼 실제로 메모리가 망가진 비율은 이보다 낮을 텐데, 그건 따로 안 나온다.
4.5 System Performance Evaluation
논문이 agency tax라고 부르는 부분이다.
정확도 말고 지연과 비용도 봐야 한다. 읽기만 하는 RAG랑 다르게 에이전트 메모리는 추출·갱신·통합 같은 유지보수 연산이 더 붙는다.
아래 논문 Table 5는 LoCoMo에서 턴당 사용자 지연(검색 T_read + 생성 T_gen)과 메모리 인덱스를 처음 만드는 오프라인 구축 비용을 잰 것이다. LOCOMO 행은 LoCoMo 논문의 베이스라인 방법이다. MemoryOS 행의 Retrieval 열과 AMem 행의 Time 열을 보면 된다.
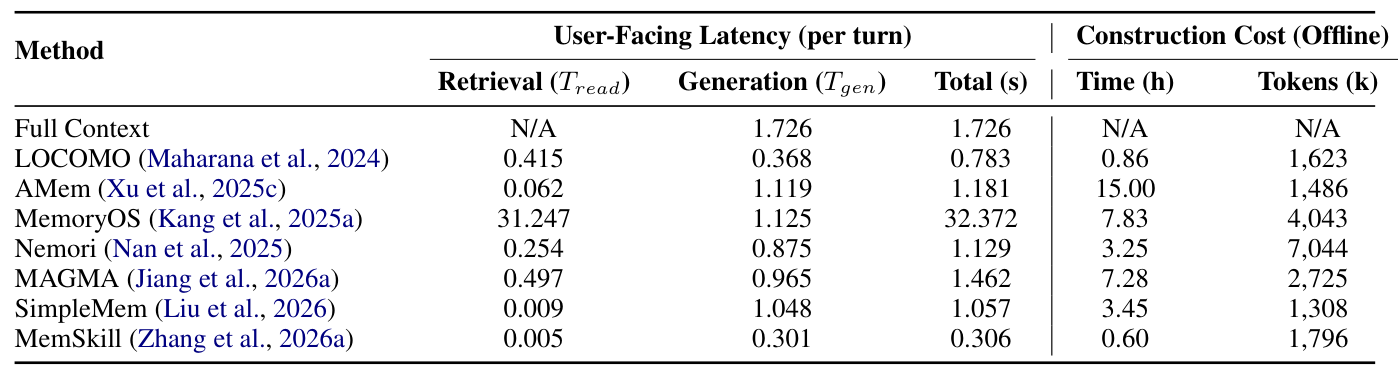
두 가지가 보인다.
- MemoryOS는 검색이 31.2초다. 턴마다 32초면 대화형으로는 못 쓴다. 정확도 표에서는 안 보이던 부분이다.
- A-Mem은 구축이 15시간이다. 검색은 0.062초로 빠른데 오프라인 구축 시간은 제일 길다.
앞에서 본 A-MEM에서는 연산 한 번당 비용(약 1,200토큰, 평균 5.4초)만 나왔는데, 여기서는 전체 오프라인 구축 시간(15시간)이 나온다. 논문은 쌍별 통합 같은 초선형 갱신 때문으로 본다.
-> 노트 구성, 링크 판단, 진화가 전부 LLM 호출이라 그런 것 같다.
토큰 쪽에서는 “intelligence tax”라는 말을 쓴다. 메모리 품질을 올리는 대신 운영 비용을 더 내는 걸 말한다. Nemori는 구축에 토큰을 7.04M 써서 SimpleMem(1.3M)의 5배쯤 된다. 정확도는 높지만 그만큼 비싸다. MAGMA는 2.7M으로 균형이 더 낫다고 한다.
유지보수 비용은 비동기로 처리되는 경우가 많아서 표에서 뺐다. 그러니까 이 표도 전체 비용은 아니다.
5. Conclusion and Future Directions
conclusion 부분을 보면 에이전트 메모리가 아키텍처뿐 아니라 평가 타당성, 확장성, 강건성에서도 제약을 받는다고 정리한다. 제안은 두 가지다.
- 벤치마크와 평가를 다시 설계할 것.
- 확장 가능하고 강건한 시스템을 설계할 것.
앞으로 벤치마크는 포화를 고려해야(saturation-aware) 한다. 컨텍스트 창이 커지면 full-context로 풀리는 과제가 많아져서 외부 메모리 효과를 따로 보기 어렵다. 태스크 양, 시간적 깊이, 엔티티 다양성, 장거리 의존성을 늘리고 ∆를 진단 신호로 쓰자고 한다.
시스템 쪽에서는 구조화 메모리는 추론은 좋아지지만 유지보수 비용이 들고, 가벼운 방식은 효율적이지만 추상화가 부족할 수 있다고 한다. 쓰기 지연, 유지보수 처리량, 사용자 쪽 비용을 따로 보고, 백본에 맞춘 메모리 연산을 써야 한다고 한다.
새 시스템을 내는 논문은 아니고, 앞 논문들이 낸 수치를 어떻게 읽을지 다시 따져본 논문이다.
6. 지금 관점: 메모리 논문 수치를 볼 때 확인할 것
이 논문을 읽고 나니 앞 리뷰들 수치가 좀 다르게 보인다.
Mem0는 ∆가 −6.02다. Mem0 리뷰에서 본 것처럼 Mem0의 장점은 정확도보다 지연 쪽이었다.
검색 p95(느린 쪽 5% 경계 지연)가 0.2초, 응답까지 합친 전체 p95가 1.44초로 full-context의 17.1초보다 훨씬 빠르다.
같은 백본의 full-context 점수가 옆에 없으면, 컨텍스트 창으로 풀리는 문제를 메모리로 푼 걸 수도 있다.
F1 수치도 그대로 믿기는 어렵다. A-Mem처럼 원문을 바꿔 쓰는 시스템은 F1에서 손해를 본다.
그렇다고 LLM 판정이 정답도 아니다. 여기서도 프롬프트에 따라 1·2위가 바뀌었다.
제일 신경 쓰이는 건 형식 오류다. 3B 모델에서 Nemori가 30%, gpt-4o-mini에서도 18% 가까이 나왔다.
그래프·일화 계열처럼 쓰기 연산이 복잡할수록 백본을 바꿨을 때 더 흔들린다.
MemoryOS의 31초 같은 검색 지연도 정확도 표만 봐서는 모른다.
-> 앞으로 메모리 논문을 볼 때 full-context 점수와 형식 오류율이 있는지부터 보게 될 것 같다.
다음은 AMV-L이다. 메모리가 쌓이면 검색이 느려지는데, 검색 후보군 크기를 직접 묶어서 느린 요청(꼬리 지연)을 줄이는 논문이다.
Leave a comment