
SYNAPSE Paper review
SYNAPSE: Empowering LLM Agents with Episodic-Semantic Memory via Spreading Activation
https://arxiv.org/abs/2601.02744
SYNAPSE는 University of Georgia 외 3개 기관에서 만든 에이전트 메모리 구조다. 2026년 1월 arXiv에 올라온 논문이다.
벡터 유사도 대신 활성 확산(spreading activation)으로 기억 사이의 관련성을 찾고, 모르는 질문에는 모른다고 답하게 만든다.
이름이 같은 다른 논문이 있다. Synapse: Trajectory-as-Exemplar Prompting(2306.07863)은 다른 논문이라 검색할 때 헷갈리기 쉽다.
이 논문은 episodic(개별 대화 턴)이랑 semantic(추상 개념) 계층을 어떻게 잇느냐를 다룬다. 그리고 그 연결을 미리 계산해두지 않고 질의가 올 때 찾는다.
두 계층을 나눠 두는 구조는 뒤에서 볼 Multi-Layered Memory에서 다시 나온다.
1. Introduction
문제를 Contextual Tunneling(또는 Contextual Isolation)이라고 부른다. 장기 에이전트 메모리의 기억들이 서로 끊겨 있는 문제다.
RAG(검색 증강 생성)는 이력을 벡터 DB에 넣고 의미 유사도로 꺼낸다. 사실 하나를 찾는 데는 괜찮은데, 서로 떨어진 기억을 엮어야 하는 상황에서는 안 된다는 게 논문의 주장이다.
그래서 인지과학 쪽에서 방법을 가져온다. 메모리를 동적 그래프로 두고, 관련성은 미리 계산해둔 링크 대신 활성 확산에서 나오게 한다.
앞에서 본 A-MEM은 LLM으로 링크를 미리 걸어뒀는데, SYNAPSE는 질의가 올 때 에너지를 흘려서 그때그때 관련된 부분그래프를 찾는다.
2. Related Work
MemGPT, MemoryOS 같은 메모리 배치 쪽 연구는 기억을 서로 독립된 텍스트로 다루고, 그래프 쪽에서는 A-Mem·HippoRAG가 그래프로 링크를 걸고, GraphRAG는 전역 요약에 맞춰져 있어 특정 에피소드를 짚기 어렵다고 본다.
벡터 유사도 검색은 의미가 먼 사건을 잇지 못하고, 기존 그래프 시스템은 처음 벡터 검색이 빗나가면 회복하지 못한다고 한다. 활성 확산으로 이 둘을 풀겠다는 게 이 논문의 위치다.
3. Methodology
3.1 Unified Episodic-Semantic Graph
메모리를 방향 그래프 G = (V, E)로 두고, 노드를 두 종류로 나눈다.
- Episodic
V_E: 턴 하나하나를(c_i, h_i, τ_i)(텍스트, 임베딩, 타임스탬프)로 턴마다 만듦 - Semantic
V_S: 엔티티·선호 같은 추상 개념. LLM으로 N=5턴마다 추출
중복은 임베딩 유사도 τ_dup = 0.92로 거른다. 임베딩 모델은 all-MiniLM-L6-v2.
엣지는 세 종류다.
- Temporal Edges : 순서대로 에피소드를 이음 (
v^e_t → v^e_{t+1}) - Abstraction Edges : 같은 통합 창(N=5) 안의 에피소드와 개념을 양방향으로 이음
- Association Edges : 개념끼리의 잠재적 상관관계를 이음
두 번째가 중요하다. 의미가 직접 비슷하지 않아도 같이 나왔다(co-occurrence)는 것만으로 개념을 이을 수 있다. 논문 예시로는 “Mark” ↔ “스키 여행”.
-> 벡터 유사도로는 “Mark”랑 “스키 여행”이 안 붙는다. 같은 시간대에 나왔다는 것만으로 잇는 게 이 구조의 장점 같다.
전체 구조는 논문 그림 하나에 다 들어 있다.
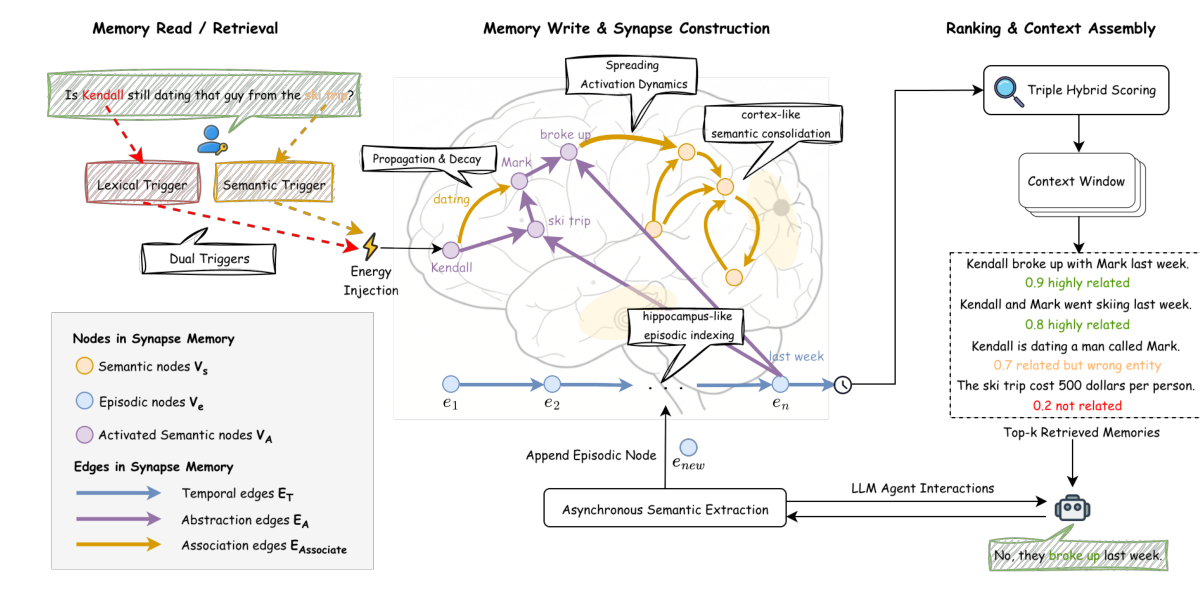
왼쪽은 질의가 어휘·의미 두 트리거로 그래프에 에너지를 넣는 부분, 가운데는 활성 확산, 오른쪽은 세 신호로 순위를 다시 매기는 부분이다.
질의에 없는 “Mark” 노드가 다리 역할로 활성화돼서 “스키 여행”과 “연애”를 잇는다.
3.2 Cognitive Dynamics: Spreading Activation
Collins와 Loftus(1975)의 사람 의미기억 모델에서 가져왔다.
먼저 초기화(Initialization)다. 질의 q가 오면 앵커 노드를 찾는데, 두 경로를 쓴다.
- Lexical Trigger : BM25(단어 일치 기반 희소 검색). “Kendall” 같은 고유명사를 정확히 매칭
- Semantic Trigger : dense(임베딩) 검색. “스키 여행”처럼 개념이 비슷한 것을 찾음
둘의 Top-k 합집합이 앵커가 되고, 앵커에만 에너지를 넣는다.
앞에서 본 Zep에서도 sparse+dense 조합을 썼는데 여기서도 나온다.
다음은 전파(Propagation with Fan Effect)다. ACT-R(Anderson, 1983의 인지 구조 모델)을 따라 주의가 나뉘는 걸 모델링한다.
u^(t+1)_i = (1−δ)·a^(t)_i + Σ_{j∈N(i)} S · w_ji · a^(t)_j / fan(j)
S = 0.8이 확산 계수, fan(j)가 나가는 엣지 수다. δ는 노드 감쇠(Node Decay)로, 이전 단계 활성 중 (1−δ)만 남긴다. 기본값은 δ = 0.5다. 연결이 많은 노드일수록 이웃 하나하나에 주는 에너지가 줄어든다. 허브 노드 하나가 전부를 활성화하는 걸 막는 장치다.
엣지 가중치는 종류마다 다르다.
- 시간 엣지 :
w_ji = e^{−ρ|τ_i−τ_j|}(시간 감쇠ρ = 0.01) - 의미 엣지 :
w_ji = sim(h_i, h_j)
마지막은 측면 억제(Lateral Inhibition)다. 주의 선택을 모델링한 부분으로, 강하게 활성화된 개념이 경쟁 개념을 누르고 나서 발화한다.
방식은 이렇다. 전파가 끝난 뒤 잠재값이 가장 높은 노드 M개(기본 7개)를 고른다. 각 노드는 자기보다 잠재값이 높은 노드들과의 차이를 더한 만큼, 거기에 β(기본 0.15)를 곱해서 깎인다. 0 아래로는 안 내려간다. 깎인 값을 시그모이드에 넣어 최종 활성값을 만든다.
û_i = max(0, u_i − β · Σ_{k∈T_M} (u_k − u_i) · I[u_k > u_i])
위쪽 노드와 차이가 클수록 많이 깎이니까, 1등 근처만 남고 나머지는 약해진다. 이게 뒤에서 적대적 질의를 거절하는 데 쓰인다.
3.3 Triple-Signal Hybrid Retrieval
점수는 세 개를 합친다.
S(v_i) = λ₁·sim(h_i,h_q) + λ₂·a^(T)_i + λ₃·PageRank(v_i)
sim: 질의와의 의미 유사도a^(T)(활성) : 국소 맥락 신호. 질의마다 관련성이 퍼짐- PageRank : 전역 구조 사전확률. 질의와 상관없이 중요한 허브(주요 인물 등)를 먼저 올림
이렇게 나누는 이유는, 새로 나왔지만 지금 질의랑 관련 있는 세부 정보가 전역 허브에 묻히지 않게 하려는 것이라고 한다.
효율 쪽으로는 점수를 캐시해두고 통합 시점(N=5턴)에만 갱신한다. 그래서 질의 지연이 이력 길이 T와 상관없이 유지된다. 기본 k = 30.
3.4 Uncertainty-Aware Rejection
없는 엔티티에 대해 묻는 적대적 질의를 다루는 부분이다. 사람 기억의 “Feeling of Knowing”(FOK, 답을 알 것 같은 느낌)에서 아이디어를 가져왔다. 두 단계로 돈다.
첫 단계는 신뢰도 기반 게이팅이다. 검색 신뢰도 C_ret를 최상위 노드의 활성 에너지로 둔다. C_ret < τ_gate(보정값 0.12)이면 ‘기록 없음’으로 답하는 절차로 넘어가서 질의를 바로 거절한다. 기억 흔적이 부족할 때 뇌가 답을 안 만들어내는 걸 흉내 냈다.
두 번째 단계는 명시적 검증 프롬프팅이다. 게이트를 통과한 애매한 경우에 “엄격한 증거” 조건을 건다.
“Is this EXPLICITLY mentioned? If not, output ‘Not mentioned’.”
생성 모델이 파라미터 지식으로 지어낸 것과 검색에 근거한 것을 구분하게 만든다.
앞에서 본 LongMemEval에서는 ABS(회피)를 다섯 능력 중 하나로 뒀는데, 여기서는 그걸 시스템에서 직접 구현했다.
4. Experiments
LoCoMo(긴 다회차 대화 기억을 묻는 QA 벤치마크)에서 GPT-4o-mini로 평가한다. 이 글의 표는 F1만 옮겼다.
4.1 Experimental Setup
LoCoMo의 다섯 범주(Single-Hop, Temporal, Open-Domain, Multi-Hop, Adversarial)에서 F1과 BLEU-1을 잰다. 베이스라인은 시스템·그래프·검색·에이전트/압축 네 계열에서 열 개를 골랐다.
재현 가능한 베이스라인은 GPT-4o-mini로 다시 돌렸다. HippoRAG는 정적 코퍼스용이라 온라인으로 읽고 쓰는 LoCoMo에 맞지 않는다며 뺐다고 한다.
4.2 Main Results
논문 Table 1이다. 적대적 범주를 뺀 네 범주 평균은 오른쪽 Average 묶음의 Performance F1 열에 있다.
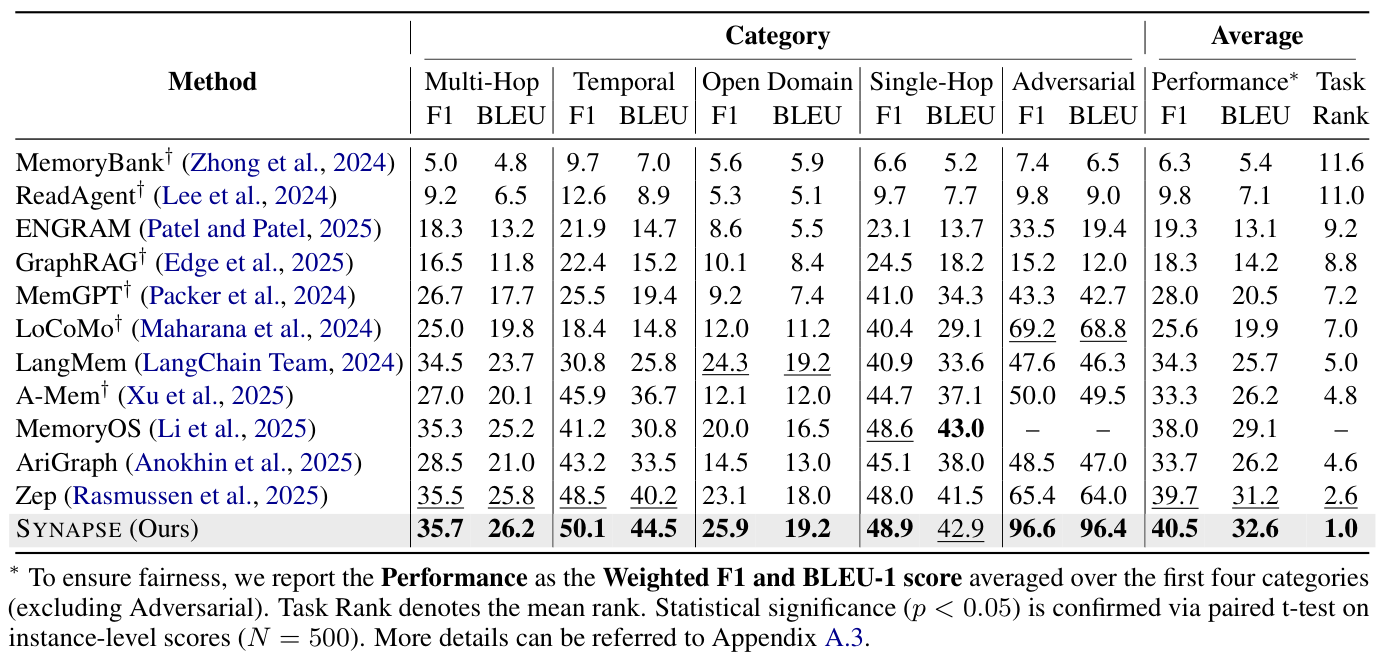
Performance F1 열에서 A-Mem 33.3, AriGraph 33.7, Zep 39.7, SYNAPSE 40.5다.
A-Mem보다 +7.2점이다. AriGraph는 지식 그래프를 쓰는 에이전트 메모리다.
태스크 순위(Task Rank)는 1.0이다. 다섯 범주 각각의 순위를 평균 낸 값이라, 모든 범주에서 1등이라는 뜻이다.
범주별로는 위 Table 1에서 A-Mem 행과 맨 아래 SYNAPSE 행의 F1 열을 비교하면 된다.
- Adversarial을 빼면 Open Domain이 +13.8점으로 가장 크게 오르고, Multi-Hop도 +8.7점 오른다. 활성 확산이 중간 노드를 거쳐 관련성을 퍼뜨려서, 벡터 검색만으로는 못 잇는 사실들을 잇는다고 한다.
- Temporal에서 +4.2점. 의미는 비슷하지만 오래된 기억보다 최근 정보를 먼저 쓴다. 뒤의 ablation에서 논문은 이 시간 인식을 노드 감쇠
δ가 전부 맡는다고 한다. - Adversarial은 96.6이다. 베이스라인 중 가장 높은 건 대화 전체를 프롬프트에 넣는 full-context 베이스라인(표에서 이름이 LoCoMo)의 69.2다.
베이스라인들은 거절하는 장치가 없어서 그럴듯한 답을 지어낸다고 한다. 게이트를 끄고도 평균 F1이 40.3이라 Zep(39.7)보다 높다는 점도 따로 밝혔다. 점수가 거절 덕분만은 아니라는 얘기다.
논문의 정성 비교 표(Table 2)에 실제 예시가 있다. 위쪽 두 행(Uncertainty-Aware Rejection, Spreading Activation)에서 왼쪽 A-Mem 칸과 오른쪽 Synapse 칸을 비교하면 된다.
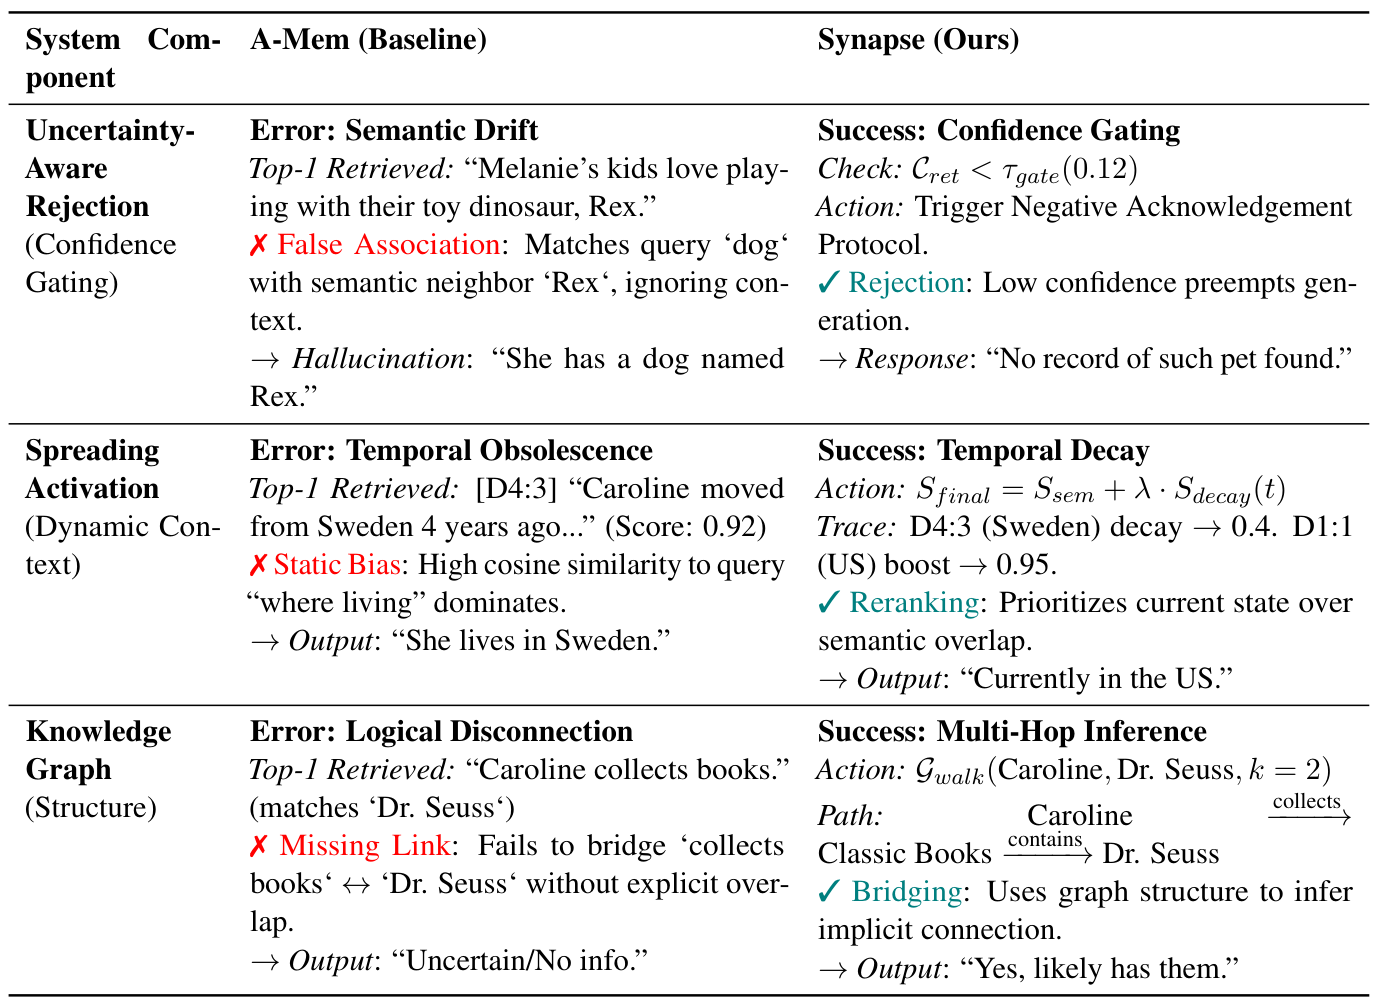
- A-Mem : 질의 ‘dog’를 의미가 비슷한 ‘Rex’에 매칭해서 “She has a dog named Rex”라고 지어냄
- SYNAPSE :
C_ret < 0.12로 게이팅이 걸려서 “No record of such pet found.”
또 하나.
- A-Mem : “Caroline moved from Sweden 4 years ago”가 유사도 0.92로 제일 위에 올라와 “She lives in Sweden”이라고 답함
- SYNAPSE : 시간 감쇠로 스웨덴 항목은 0.4로 내려가고 미국 항목은 0.95로 올라감
앞에서 본 Mem0 리뷰에서도 OpenAI 메모리가 temporal J 21.71로 크게 낮았다. 거기서는 메모리에 타임스탬프가 빠진 게 원인이었다.
-> 유사도만 보면 오래된 기억이 이긴다. 시간 정보를 저장만 해두고 점수에 안 넣으면 같은 일이 생길 것 같다.
4.3 Ablation Study
장치를 하나씩 끄고 LoCoMo 범주별 F1을 잰 표다(GPT-4o-mini).
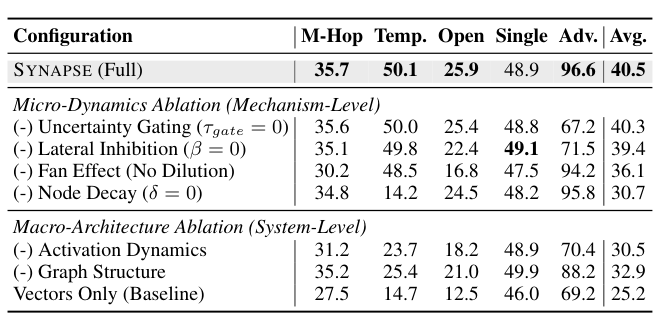
위쪽 묶음은 장치를 하나씩 끈 결과, 아래쪽 묶음은 활성 확산이나 그래프 구조 자체를 뺀 결과다.
Adversarial 열을 보면, 게이트를 끄면(τ_gate = 0, 억제는 켜둠) 96.6에서 67.2로 떨어진다. 억제를 끄면(β = 0, 게이트는 켜둠) 71.5다. 둘 다 있어야 96.6이 나온다.
논문은 이걸 측면 억제가 게이트 앞에서 전처리 역할을 한다고 설명한다. 억제가 없으면 관련 없는 후보들도 활성이 남아서, 최상위 노드의 활성 에너지를 신뢰도로 쓰기 어려워진다.
-> 본문은 “게이트를 뺀 데서 억제까지 더 빼면” 더 떨어진다고 쓰는데, 표에는 둘 다 뺀 행이 없다. 억제만 뺀 행(71.5)은 게이트만 뺀 행(67.2)보다 오히려 높다. 어느 쪽을 말한 건지??
다른 장치는 각자 맡은 범주가 있다. Fan Effect를 빼면 Open Domain이 25.9에서 16.8로, Node Decay를 빼면 Temporal이 50.1에서 14.2로 떨어진다.
4.4 Efficiency Analysis
논문 Table 4다. 질의당 토큰, 평균 지연(A100 한 장, 질의 100개 평균), 1,000질의 API 비용, 적대적 범주를 뺀 F1, 비용 효율(F1/$)이다. LoCoMo 행은 앞의 full-context 베이스라인이다.
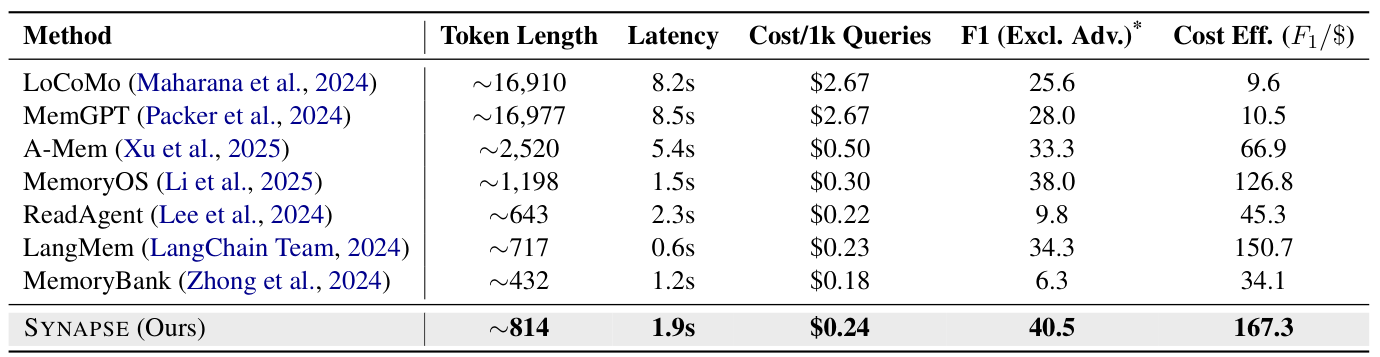
MemoryOS는 계층형 메모리 OS, LangMem은 LangChain의 메모리 라이브러리다.
토큰은 full-context 대비 95% 줄었다. 전체 이력을 넣지 않고 관련된 부분그래프만 꺼내기 때문이다. 논문은 full-context보다 11배 싸면서 성능은 거의 2배라고 쓴다.
-> 표로 계산하면 40.5 / 25.6 ≈ 1.6배, MemGPT(28.0) 대비로는 1.45배다. “거의 2배”는 좀 후하다.
LangMem도 비용 효율이 150.7로 비슷한데, F1이 34.3으로 낮다. 그래프를 만드는 비용은 에이전트를 쓰는 기간 전체에 나눠지니까 질의당으로 보면 무시할 만하다고 한다.
5. Conclusion
conclusion 부분을 보면, 생물학적 활성 확산을 흉내 내서 기존 검색 시스템의 맥락 고립 문제를 푸는 구조를 제안했다고 한다. 메모리를 동적 연상 그래프로 두고, 끊겨 있는 사실을 잇고 관련 없는 잡음은 거른다.
알고리즘 쪽 한계는 셋이다.
- Cold Start : 이력이 적은 초기 대화에서는 그래프 유지 비용에 비해 단순한 선형 버퍼보다 얻는 게 적음
- Cognitive Tunneling : 측면 억제 때문에, 다 찾는 게 나은 단순한 질의에서 성능이 떨어질 때가 있음
- 평가가 LoCoMo 텍스트 벤치마크 하나뿐
부록에 Cognitive Tunneling 실패 사례가 있다.
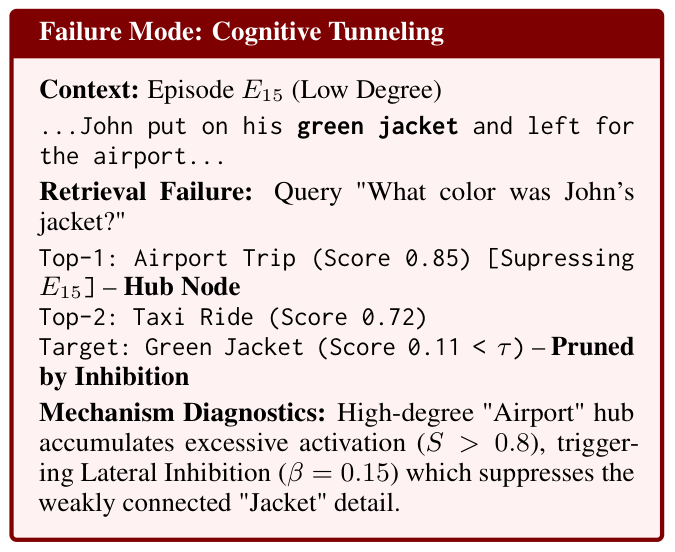
연결이 많은 “Airport” 허브가 활성을 몰아 받으면서, 연결이 적은 “초록 재킷” 에피소드가 억제로 잘려 나간다.
-> 앞에서 본 Mem0 리뷰에서 그래프 버전 Mem0g가 multi-hop에서 Mem0보다 낮았던 것과 비슷한 모양이다. 구조를 정교하게 만들면 단순한 질의에서 손해를 본다.
정리하면, SYNAPSE는 잘 찾는 것에 더해 못 찾았을 때 모른다고 하는 걸 기능으로 넣었고, 거기서 Adversarial 96.6 F1을 냈다. 챗봇에서는 모르는 걸 지어내는 쪽이 더 큰 문제일 때가 많아서, 이 부분이 제일 쓸모 있어 보인다.
6. 지금 관점: 검색에 따로 떼어 써볼 만한 부분
장치 중에 따로 떼어 쓸 수 있는 것과 같이 써야 하는 것이 나뉜다.
시간 감쇠는 따로 쓸 수 있을 것 같다.
논문 ablation에서 Temporal을 맡은 건 노드 감쇠 δ다. 그래도 엣지 쪽 e^{−ρ|Δτ|}처럼 시간 차이만큼 점수를 깎는 건 그래프가 없어도 검색 점수에 곱하면 된다.
“스웨덴에 산다” 같은 오래된 정보 오류를 막는 제일 싼 방법 같다. 앞에서 본 Zep의 양시간 모델링이 더 정확하긴 한데 구현이 크고, 이쪽은 한 줄이다.
거절은 게이트와 측면 억제를 같이 써야 한다. ablation에서 둘 중 하나만 있으면 67.2나 71.5에 머물렀다.
-> 그래프 없이 게이트만 흉내 내면 이 정도도 안 나올 수 있다.
명시적 검증 프롬프트(“EXPLICITLY mentioned인가?”)는 그래프가 없어도 어떤 검색 파이프라인에든 붙일 수 있다.
다음은 Anatomy of Agentic Memory다. 지금까지 본 메모리 벤치마크 수치를 어떻게 읽어야 하는지 직접 재본 논문이다.
Leave a comment