
AMV-L Paper review
AMV-L: Lifecycle-Managed Agent Memory for Tail-Latency Control in Long-Running LLM Systems
https://arxiv.org/abs/2603.04443
AMV-L은 Georgia Tech에서 만든 에이전트 메모리 관리 방법이다. 2026년 2월 arXiv에 올라왔고, 저자는 1명이다.
메모리가 쌓이면 검색이 느려진다. 이 논문은 검색 후보군 크기를 직접 묶어서 가끔 튀는 느린 요청(꼬리 지연)을 줄인다.
앞의 논문들이 주로 무엇을 어떻게 기억할지를 다뤘다면, 이 논문은 그게 서비스 지연에 어떤 영향을 주는지를 본다. 시스템 쪽 논문이라 다른 논문들과 좀 다르다.
1. Introduction
지금 많이 쓰는 방식은 TTL(Time-To-Live, 저장 후 정해진 시간이 지나면 지우는 방식)이다.
논문은 문제를 한 문장으로 정리한다. TTL은 항목이 얼마나 오래 남을지는 제한하지만, 요청이 들어왔을 때 메모리가 쓰는 계산량은 제한하지 않는다.
보관된 항목이 쌓이면 검색 후보군과 벡터 유사도 스캔이 예측할 수 없게 커진다. 그래서 지연이 가끔 크게 튀고(heavy-tailed) 처리량이 불안정해진다고 한다.
-> 앞 리뷰들에서 본 느린 검색 수치도 이런 경우가 아닐까 싶다. Anatomy 리뷰의 MemoryOS 검색 31.2초, Mem0 리뷰의 LangMem p95 59.8초. 두 논문 모두 후보군 크기를 재지 않아서 확인은 못 한다.
2. Background and Motivation
에이전트는 요청마다 메모리 일부를 검색해 프롬프트에 넣으니, 검색 대상 집합 크기가 곧 지연과 비용을 정한다고 본다.
TTL은 보관량과 검색 대상을 구분하지 않아서, 프롬프트 상한을 둬도 검색 작업은 묶이지 않는다고 한다. 메모리를 저장소가 아니라 계산 자원으로 관리해야 한다는 게 이 절의 주장이다.
3. Design Goals
설계 목표 네 가지를 둔다.
- 전체 보관량과 상관없이 요청 경로의 메모리 비용을 묶음
- 오래돼도 효용이 높은 메모리는 남김
- 접근 패턴이 바뀌면 온라인 신호로 따라감
- 관리 오버헤드를 작게 하고 기존 에이전트 스택에 쉽게 붙임
4. AMV-L Overview
에이전트 메모리를 그냥 쌓아두는 저장소로 보지 않고, 관리해야 하는 시스템 자원으로 본다.
각 항목에 계속 갱신되는 효용 점수 V(m)을 매기고, 그 값에 따라 올리고(승격) 내리고(강등) 빼는(축출) 식으로 계층을 유지한다.
4.1 Memory items and value state
메모리는 사실, 요약, 관측 같은 개별 항목으로 저장하고, 항목마다 내용·메타데이터·임베딩과 효용 점수 V(m)을 둔다.
V(m)은 접근, 프롬프트 기여, 비활성 시간을 보며 항목 단위로 조금씩 갱신하고, 전체를 다시 훑지 않는다.
4.2 Tiered lifecycle organization
계층은 세 개다.
- Hot : 평소 요청에서 검색하고 프롬프트에 넣을 수 있는 항목
- Warm : 중간 효용. 기본 검색 경로에서는 빠짐
- Cold : 효용이 낮음. 적은 비용으로 보관만 하고 검색에서는 빠짐
이렇게 나누면 보관(retention)과 검색 대상 여부(eligibility)가 분리된다. warm이나 cold에 남아 있는 항목은 지워지지 않지만 매 요청마다 비용을 만들지도 않는다.
4.3 Lifecycle transitions
생애주기 전이는 비동기로 한다.
요청을 처리할 때는 사용 기록과 값 갱신만 하고, 계층 이동이나 정리는 요청 처리 경로 밖에서 따로 한다. 유지보수 때문에 요청 지연이 늘어나지 않게 하려는 설계다.
4.4 Bounded retrieval and prompt construction
통제를 두 가지로 나눈다.
- Eligibility control (AMV-L 생애주기) : 어떤 항목이 검색에 참여할 수 있는가
- Injection control (프롬프트 상한) : 검색된 것 중 몇 개를 프롬프트에 넣는가
대부분의 시스템은 2번만 있다고 한다.
프롬프트 상한은 프롬프트 길이는 묶지만, 1번 없이는 큰 후보군을 검색하는 비용을 못 막는다.
4.5 System invariant
요청마다 드는 메모리 비용이 전체 보관 항목 수가 아니라 검색 대상 집합 크기에 따라 정해지게 한다는 불변식을 둔다.
TTL은 항목 나이만 묶고, LRU는 검색 대상을 최근성으로 줄이지만 효용을 보지 않는다는 점에서 이 불변식과 다르다고 한다.
5. Memory Value Model
V(m)은 세 가지 신호로 갱신한다.
- Access : 이번 요청 검색에서 고려되거나 선택됨
- Contribution : 실제로 최종 프롬프트에 들어감
- Elapsed time : 마지막 갱신 이후 지난 시간
일부러 운영 신호(operational)로 골랐다. 의미 라벨이나 오프라인 학습, 사람 피드백 없이 서빙 시스템이 바로 잴 수 있다.
앞에서 본 Experience-Following 리뷰의 “미래 태스크 평가가 공짜 품질 라벨이 된다”와 비슷하다. 따로 평가 비용 없이 사용 기록에서 효용이 나온다.
갱신은 lazy하게 한다. 항목이 요청에 닿을 때만 하고 전체를 스캔하지 않는다. 지수 감쇠 V(m) ← V(m)·e^{−λΔt}를 먼저 적용하고 이벤트에 따라 더한다.
조건은 세 가지다.
- 국소성 : 항목별 상태와 그 요청의 이벤트만 본다
- 증분성 : 전체를 다시 계산하지 않고 온라인으로
- 저오버헤드 : 닿은 항목당 상수 시간
6. Lifecycle Transitions
두 임계값으로 효용 점수를 hot·warm·cold에 대응시키고, 값이 오르면 승격, 감쇠로 내려가면 강등한다. 축출은 cold 계층에서 더 낮은 임계값 아래로 내려간 항목만 한다.
경계 근처에서 계층이 왔다 갔다 하지 않게 올라갈 때와 내려갈 때 임계값을 다르게 둔다(hysteresis).
7. Retrieval and Prompt Construction
검색 후보는 hot 전체와 warm에서 최대 k개 뽑은 샘플이고, cold는 보지 않는다. 그 안에서 유사도 top-n을 골라 시스템 프롬프트, 최근 대화와 함께 넣는다.
프롬프트에 들어간 항목은 접근과 기여를, 후보에만 든 항목은 접근만 값에 반영해서 검색 결과가 다시 효용 점수로 돌아온다.
8. System Architecture and Implementation
메모리 저장소, 검색 서비스, 생애주기 관리자, HTTP API 게이트웨이 네 부분으로 구현했다.
계층은 메타데이터로만 두고 벡터 인덱스는 하나를 쓰며, 검색 대상 ID 목록을 먼저 만들어 그 안에서만 유사도 검색을 한다. 감쇠와 정리 같은 유지보수는 요청 경로 밖에서 비동기로 돈다.
9. Evaluation Methodology
같은 서빙 스택에서 메모리를 비우고 같은 워크로드를 TTL, LRU, AMV-L 순으로 세 번 돌린다. 워크로드는 메모리 쓰기, 검색, LLM 요청을 섞은 합성 워크로드다.
지연 분위수, 처리량, 1초·2초 초과 비율, 검색 후보군 크기, 스캔한 벡터 수 등을 재고, 프롬프트 주입 상한은 모든 정책에서 같게 둔다.
10. Results and Discussion
베이스라인은 TTL과 LRU(가장 오래 안 쓴 항목부터 내보내는 방식) 둘이다. 같은 장기 실행 워크로드(합성)를 세 조건에 똑같이 돌리고, 프롬프트 주입 상한도 모든 조건에서 똑같이 고정했다.
지연은 p50/p95/p99로 본다. 요청을 지연순으로 줄 세웠을 때 50%, 95%, 99% 지점의 값이다. p99가 크면 100건 중 1건은 그만큼 느리다.
10.1 End to end latency and throughput
세 정책의 성공률, 처리량, 지연 분위수, 1초·2초 초과 비율을 같은 워크로드에서 잰 결과다(논문 Table 1). Direction 열은 값이 클수록 좋은지(Higher), 작을수록 좋은지(Lower)를 뜻한다.
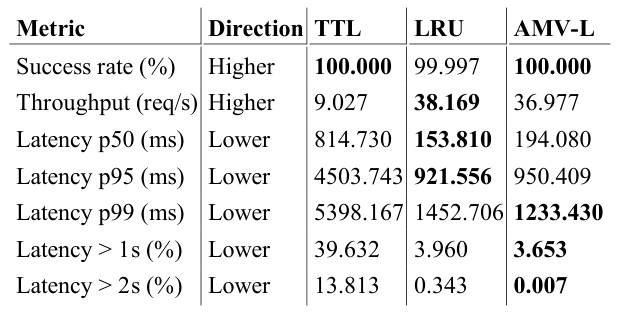
TTL과 비교하면 AMV-L은 처리량이 4.1배(9.0 → 37.0 req/s), 지연은 중앙값 4.2배, p95 4.7배, p99 4.4배 좋아졌다. 2초 넘는 요청은 13.8%에서 0.007%로 줄었다.
-> 논문 본문과 abstract에는 처리량이 “3.1×”로 적혀 있는데, 같은 문단에 “9.0 to 37.0 requests/s”라고도 쓴다. 37.0 / 9.0은 4.1이라 둘 중 하나가 틀렸다. 표 값을 따랐다.
LRU와는 주고받는 관계다. 중앙값과 p95는 LRU가 조금 낫다(154 vs 194ms, 922 vs 950ms). 대신 p99는 AMV-L이 낫고(1233 vs 1453ms), 2초 넘는 요청은 98% 줄였다(0.343% → 0.007%).
값 기반으로 관리하면 recency 기반인 LRU에서도 남아 있는 극단적으로 느린 요청을 줄일 수 있다고 한다.
꼬리 분포는 그림으로 보면 더 분명하다.
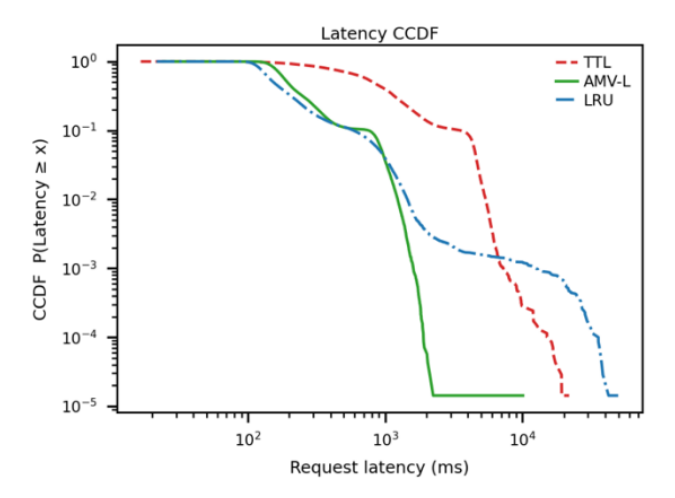
CCDF(지연이 x 이상인 요청의 비율)를 로그 축으로 그린 것이다.
TTL은 1초 넘는 구간에 요청이 많이 남아 있고, LRU와 AMV-L은 둘 다 꼬리를 크게 줄인다.
오른쪽 끝을 보면 LRU는 드물게 매우 느린 요청이 길게 남고, AMV-L은 그보다 앞에서 끊긴다.
10.2 Mechanism: retrieval working set and vector search footprint
지연이 줄어든 이유를 검색 후보군 크기로 설명한다.
논문 Table 3이다. Retrieval set p95 행이 요청마다 검색 대상이 된 항목 수 |R|의 p95, Vectors scanned p95 행이 실제로 스캔한 벡터 수의 p95다.
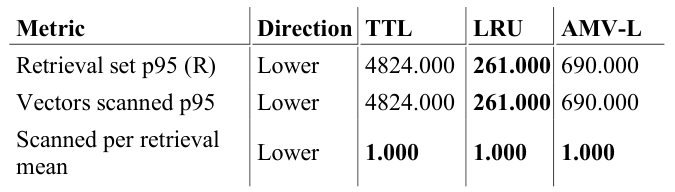
TTL에서는 p95 후보군이 4,824개까지 커진다. AMV-L은 690으로 85.7% 줄이고, LRU는 261로 94.6% 줄인다.
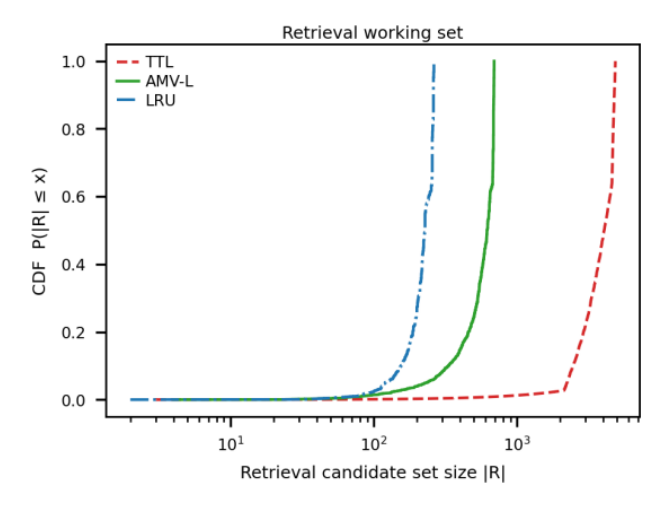
검색 후보군 크기 |R|의 누적 분포다.
TTL은 위쪽 꼬리가 길고, AMV-L은 hot 항목과 상한이 있는 warm 샘플만 검색 대상으로 두어서 분포가 좁아진다.
|R|가 유사도 검색 비용을 곱으로 키우는 요인이라서, 이 분포가 곧 검색 비용을 예측한다고 한다.
근데 LRU가 더 적게 스캔하는데 극단 꼬리는 AMV-L이 낫다. 스캔 수만으로는 설명이 안 된다. 논문도 이걸 “important systems nuance”라고 하고, 효용으로 검색 대상을 고르면 어떤 항목이 검색 경로에 남는지가 달라져서 드문 비싼 요청이 줄어든다고 설명한다. 최근성만 보는 LRU는 국면이 바뀔 때 검색 대상이 자주 뒤바뀌면서(eligibility churn) 효용 낮은 맥락이 올라올 수 있는데, AMV-L은 이걸 피한다는 설명도 덧붙인다.
-> 그럼 LRU의 p99가 왜 더 느린지는 뭐 때문인지?? 자세한 이유는 잘 모르겠다.
10.3 Cost and quality tradeoffs
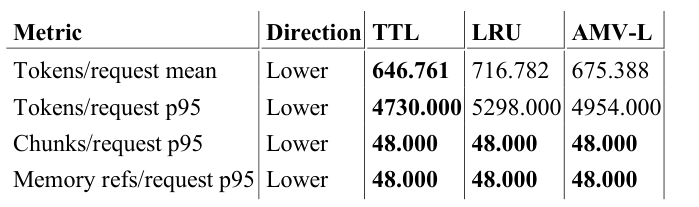
토큰 오버헤드는 LRU보다 약 6% 낮다. 아래 논문 Table 4의 Tokens/request mean 행에서 LRU 716.782, AMV-L 675.388이다. 주입 상한을 고정했으니 Chunks/request p95와 Memory refs/request p95는 세 정책 모두 48로 같다.
검색 품질은 검색된 항목의 값 평균(retrieved value mean)으로 잰다. 워크로드가 항목마다 붙여둔 값 라벨의 평균이라, AMV-L과 LRU는 0.947 vs 0.949로 거의 같고 TTL(0.714)보다는 높다. 아래 논문 Table 5의 Retrieved value mean 행이다.
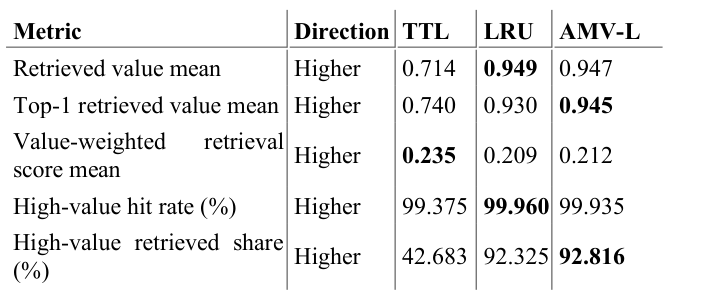
-> 에이전트가 과제를 맞혔는지(과제 정확도)는 안 쟀다. 그래서 “품질은 그대로”라고 하려면 이 값 라벨이 실제 과제 품질을 따라간다는 가정이 필요하다.
10.4 Discussion
병목이 무엇인가를 따진다.
논문 Discussion에서는 장기 실행 에이전트 메모리의 병목이 저장 용량보다는 요청마다 커지는 계산이라고 본다. 검색 대상을 통제하지 않아서 생기는 계산이다.
프롬프트 주입 상한을 고정해도 지연이 튀고 처리량이 낮게 나온다. 비싼 단계는 top-n 항목을 넣는 쪽보다 후보군 전체를 스캔하고 점수 매기는 쪽이기 때문이다.
그래서 검색 대상을 먼저 묶고 그다음에 주입 개수를 묶는 두 단계 통제를 권한다.
11. Conclusion
conclusion 부분을 보면, AMV-L은 메모리를 관리해야 하는 시스템 자원으로 보고, 계속 갱신되는 효용 점수로 생애주기를 관리한다.
논문은 p95, p99 지연을 최대 2~3자릿수 줄이면서 밀리초 단위 중앙값을 유지한다고 쓴다. 전체 보관량과 상관없이 검색 대상 크기를 묶었기 때문이라고 한다.
-> 그런데 논문 Table 1에서 TTL 대비 p95, p99는 4.7배, 4.4배 줄었다. 2~3자릿수가 어디서 나온 건지 표에서는 못 찾았다.
한계는 논문 Discussion에 두 가지가 적혀 있다. LRU 베이스라인이 순수 recency 기반이라 recency와 value를 섞은 하이브리드가 더 나을 수 있다는 것, 그리고 AMV-L은 hot 계층 크기에 딱 정해진 상한이 없어서 최악의 경우를 확실하게 보장하지는 못한다는 것이다.
정리하면 AMV-L은 기억은 그대로 두고, 그중 무엇을 검색 대상으로 둘지를 관리하는 방법이다.
12. 지금 관점: 검색 지연을 줄일 때 해볼 만한 것
이 시리즈 논문들이 주로 보는 건 정확도다.
Mem0나 Anatomy도 지연을 재긴 했지만, 꼬리 지연의 원인(후보군 크기)을 직접 통제 변수로 다룬 건 이 논문뿐이다.
앞 리뷰에서 본 LangMem이 이 논문에서 말하는 경우에 맞는 것 같다. 메모리 토큰은 127개까지 줄였는데 검색에 p95 59.8초가 걸렸다.
-> 넣는 양은 묶었는데 후보군은 안 묶어서 그런 게 아닐까?
반대로 Mem0는 p95 0.2초였는데, 사실만 남겨서 후보군이 작았을 것 같다. 둘 다 내 추정이다.
실제로 쓴다면 원본은 지우지 않고 검색 대상에서만 빼는 계층을 두면 될 것 같다.
앞에서 본 Zep은 오래된 사실을 지우지 않고 무효 표시만 했다. 그렇게 남긴 걸 전부 검색 대상으로 두면 이 논문의 문제가 그대로 생긴다.
앞에서 본 NEMORI는 저장할 때 내용을 증류해서 성능을 올렸는데, 이 논문은 저장은 그대로 두고 검색 대상만 줄인다.
저장과 검색 중 어디가 병목인지는 뒤에서 볼 MemMachine에서, 원본을 남기는 쪽은 Rate-Distortion과 ReFind에서 다시 나온다.
보통 응답 지연만 모니터링하는데, |R|(검색 후보군 크기)를 따로 재면 느려진 원인을 찾기 쉬울 것 같다.
access·contribution·elapsed 세 값은 벡터 DB의 메타데이터 필드로도 만들 수 있어 보인다.
다만 저자 1명이 시스템 하나로 한 실험이다. 합성 워크로드이고 비교 대상도 TTL, LRU 둘뿐이다.
중앙값, p95, 처리량은 LRU가 조금 낫고 AMV-L이 나은 건 극단 꼬리다.
논문도 둘을 “tradeoff frontier 위의 다른 지점”이라고 한다. p99나 2초 초과 비율이 중요한 서비스면 AMV-L, 중앙값과 처리량이 중요하면 LRU를 권한다.
다음은 Multi-Layered Memory다. 대화 이력을 working·episodic·semantic 세 계층으로 나누고, 계층을 하나씩 떼어보는 ablation으로 각 계층이 얼마나 기여하는지 잰 논문이다.
Leave a comment