
A-MEM Paper review
A-Mem: Agentic Memory for LLM Agents
https://arxiv.org/abs/2502.12110
A-MEM은 Rutgers University 등에서 만든 LLM 에이전트용 메모리 시스템이다. 2025년 2월에 나왔고, NeurIPS 2025에 실렸다.
앞에서 본 Zep은 에피소드-엔티티-커뮤니티 3계층을 사람이 설계했다. 구조를 사람이 정해두고 기억을 거기에 넣는다.
A-MEM은 구조를 에이전트가 스스로 만들게 한다.
1. Introduction
introduction 부분을 보면 문제 제기가 Zep이랑 좀 다르다.
지금 메모리 시스템들은 저장과 검색은 되는데 메모리를 정교하게 조직하지는 못한다고 한다. 그래프 DB를 쓴 최근 시도들도 마찬가지고, 연산과 구조가 고정돼 있어서 태스크가 바뀌면 적응을 못 한다.
Figure 1이 이 차이를 보여준다. 기존 메모리 시스템은 워크플로에 메모리 접근 패턴을 미리 정해둬야 한다. 그래서 새 환경에서 일반화가 안 되고 장기 상호작용에서 효과가 떨어진다.
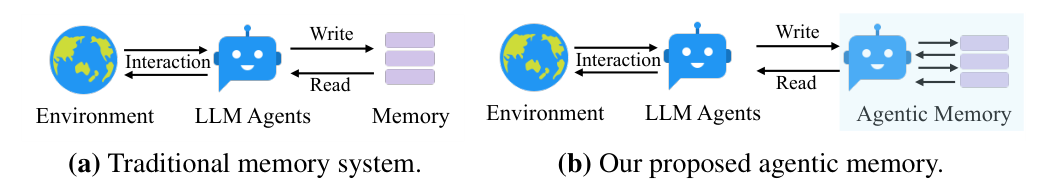
(a)는 에이전트가 메모리를 단순히 읽고 쓰기만 하고, (b)는 메모리 쪽에도 에이전트가 붙어 있다.
A-MEM은 메모리 연산을 동적으로 해서 에이전트를 더 유연하게 만든다고 한다.
2. Related Work
LLM 에이전트 메모리(MemGPT, MemoryBank, SCM 등)와 RAG를 정리한다. 기존 메모리는 정해진 구조와 고정된 워크플로에 묶여 있고, agentic RAG는 언제 뭘 검색할지는 스스로 정하지만 메모리 구조 자체를 바꾸지는 않는다고 한다.
3. Methodology
설계를 제텔카스텐에서 가져왔다. 원자적 노트 작성과 유연한 조직화, 이 두 원칙이다. 노트끼리 동적 색인과 링크로 이어서 지식 네트워크를 만든다.
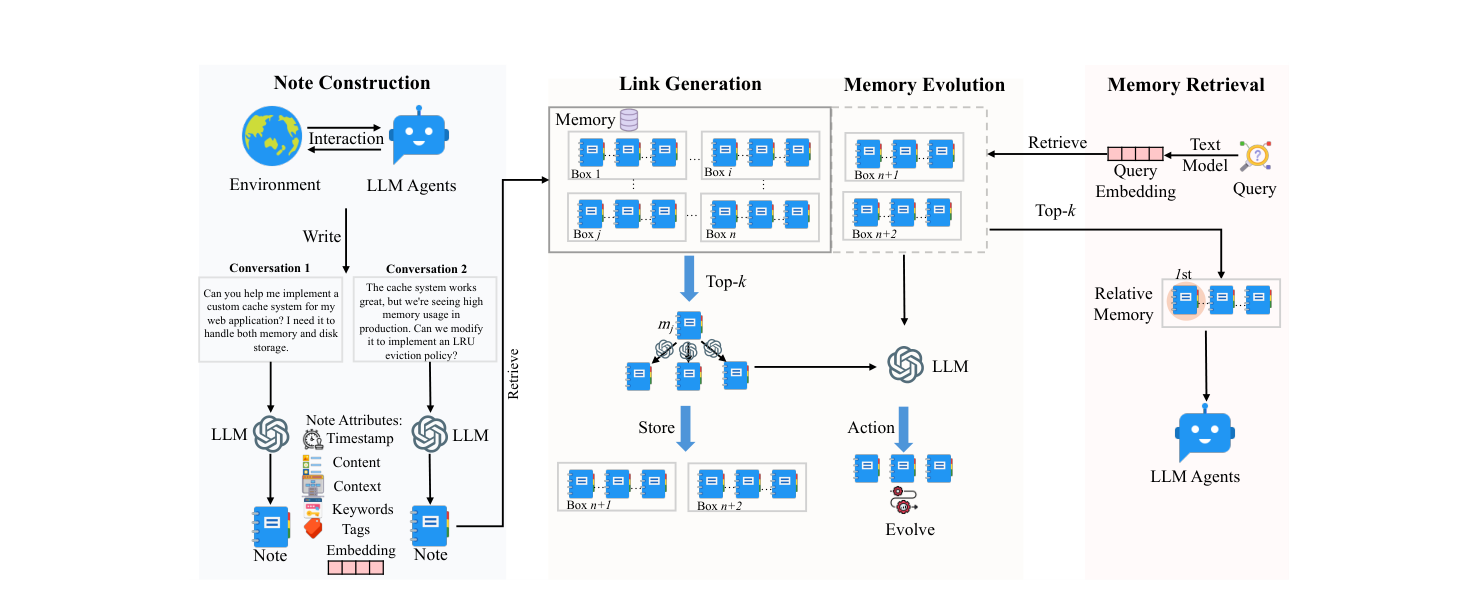
세 부분으로 돌아간다.
3.1 Note Construction
메모리 노트 하나는 일곱 항목으로 되어 있다.
m_i = { c_i, t_i, K_i, G_i, X_i, e_i, L_i }
c_i: 원본 상호작용 내용t_i: 타임스탬프K_i: LLM이 뽑은 키워드G_i: LLM이 만든 태그X_i: LLM이 쓴 맥락 서술e_i: 임베딩L_i: 연결된 메모리 집합
c_i가 남아 있다. 원본 내용을 버리지 않는다.
임베딩은 텍스트 항목을 전부 이어 붙여서 만든다.
e_i = f_enc[ concat(c_i, K_i, G_i, X_i) ]
원문 + 키워드 + 태그 + 맥락 서술을 벡터 하나에 넣는다.
앞에서 본 LongMemEval의 CP 2(키 확장)랑 비슷한 발상이다. 다만 LongMemEval은 뽑은 사실을 별도 키로 붙여서 검색 경로를 여러 개 만들고, A-MEM은 전부 이어 붙여 벡터 하나로 만든다. 검색 경로는 하나다.
제텔카스텐의 원자성 원칙에 따라 노트 하나에 지식 단위 하나를 담는다.
3.2 Link Generation
새 노트가 들어오면 임베딩 코사인 유사도로 가까운 과거 메모리 상위 k개를 먼저 꺼내고, 연결을 맺을지는 LLM이 판단한다. 규칙으로 정하지 않는다. 논문 구현 설명에서 주로 10으로 둔 k는 메모리 검색의 top-k 값이다.
논문은 이걸 box라고 부른다. 맥락 서술이 비슷한 메모리들이 서로 연결돼서 상자 하나를 이룬다.
제텔카스텐이랑 다른 점은 메모리 하나가 여러 상자에 동시에 들어갈 수 있다는 점이다.
3.3 Memory Evolution
이 논문에서 제일 다른 부분이다. 링크를 만든 다음 꺼내온 기존 메모리들을 고친다.
링크 생성 때 꺼낸 가까운 이웃 k개(M_near)의 메모리 m_j 각각에 대해 맥락·키워드·태그를 갱신할지 판단한다.
m*_j ← LLM( m_n ∥ M_near \ m_j ∥ m_j ∥ P_s3 )
고친 m*_j가 원래 m_j를 대체한다.
새 경험이 들어오면 옛 기억의 해석이 바뀐다는 생각이다. 논문은 이게 사람이 배우는 과정이랑 비슷하다고 본다. 시간이 지나면 지식 구조가 정교해지고 여러 메모리에 걸친 패턴을 찾게 된다.
-> 그런데 이 대체는 되돌릴 수 없다. c_i(원본)는 남지만 X_i(맥락 서술), K_i, G_i는 덮어쓴다. 진화가 잘못 가면 이전 해석으로 못 돌아가는 거 아닌가?? 되돌릴 수 있느냐는 나중에 볼 Rate-Distortion에서 따로 다룬다.
3.4 Retrieve Relative Memory
질의도 노트와 같은 인코더로 임베딩하고, 코사인 유사도로 상위 k개 메모리를 꺼내 프롬프트에 넣는다.
4. Experiment
4.1 Dataset and Evaluation
LoCoMo를 주로 쓰고 DialSim도 같이 본다. LoCoMo는 대화 하나가 평균 9K 토큰, 최대 35세션이고 질문은 single-hop, multi-hop, temporal, open-domain, adversarial 다섯 범주다. 지표는 F1과 BLEU-1이다.
4.2 Implementation Details
모든 방법에 같은 시스템 프롬프트를 쓴다. Qwen·Llama 작은 모델은 Ollama로 로컬에서 돌리고, 검색 top-k는 주로 10, 임베딩은 all-minilm-l6-v2다.
4.3 Empirical Results
LoCoMo(긴 다중 세션 대화 QA 벤치마크)에서 파운데이션 모델 여섯 개로 비교한다. 비교 대상은 네 가지다.
- LoCoMo : 메모리 없이 이전 대화 전체를 프롬프트에 넣는 방식
- ReadAgent : 긴 글을 페이지로 나눠 요약해두고 필요할 때 원문을 찾아보는 방식
- MemoryBank : 망각 곡선으로 기억 강도를 조절하는 메모리
- MemGPT : 앞에서 본 MemGPT
아래는 LoCoMo 결과다(논문 Table 1). 모델별로 다섯 줄씩이고, 각 묶음의 마지막 회색 줄이 A-MEM이다. 범주별 F1 열과 오른쪽 Average의 Ranking F1, Token Length 열을 보면 된다. 순위는 다섯 범주(Multi Hop, Temporal, Open Domain, Single Hop, Adversarial) 순위의 평균이다. 논문에 정의가 따로 없어서 표 값으로 계산해 맞춰 봤다. 토큰은 질문 하나에 답할 때 쓴 평균 토큰 수다.
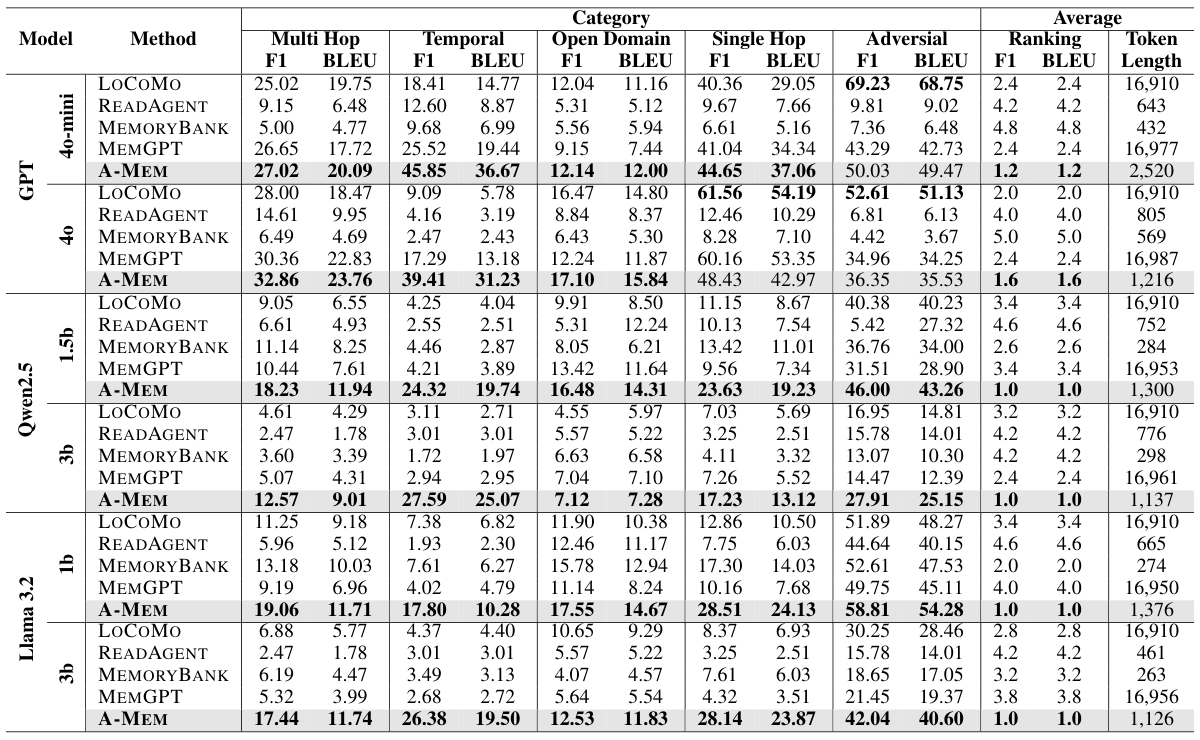
토큰을 훨씬 적게 쓴다. LOCOMO와 MEMGPT는 16,900토큰 정도를 쓰는데 A-MEM은 1,200~2,500토큰이고 순위는 더 높다. 7~14배 차이다.
작은 모델에서 차이가 더 크다. Qwen2.5-3b에서 A-MEM은 순위 1.0, MemGPT는 2.4다. Multi Hop F1이 12.57 vs 5.07로 2.5배다. 논문도 GPT가 아닌 모델에서는 모든 범주에서 기준선을 이겼다고 한다.
-> 컨텍스트에 다 넣어주는 방식은 약한 모델이 잘 소화를 못 하는 것 같다.
GPT 모델에서는 다르다. GPT-4o의 Single Hop은 LOCOMO가 더 높고(61.56 vs 48.43), Adversarial도 LOCOMO가 높다(52.61 vs 36.35). 논문도 GPT 모델에서는 LoCoMo와 MemGPT가 일부 범주에서 강하다고 인정한다. 그래서 여섯 모델 모두 평균 순위로는 A-MEM이 1위지만, 범주마다 다 이긴 건 아니다.
뒤에서 볼 Mem0 논문도 A-MEM을 LoCoMo에서 다시 돌리는데, 그 재현 결과에서는 순위가 다르게 나온다.
4.4 Ablation Study
Link Generation(LG)과 Memory Evolution(ME)을 하나씩 빼본다.
아래는 GPT-4o-mini를 기반 모델로 잰 LoCoMo 결과다(논문 Table 3). 범주별 F1 열을 세 줄끼리 비교하면 된다.
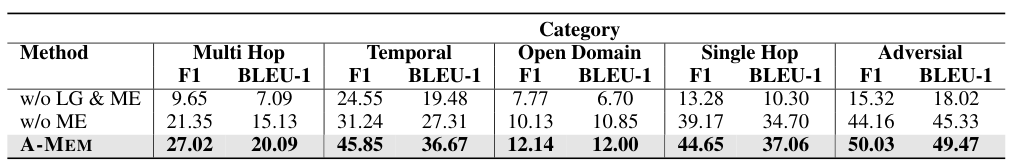
둘 다 빼면 모든 범주에서 크게 떨어진다. Multi Hop은 27.02 → 9.65다. 링크만 두면(w/o ME) 중간이고, 진화까지 켜면 Temporal이 31.24 → 45.85로 제일 많이 오른다.
링크 생성이 메모리 조직의 토대고, 진화는 거기에 정제를 더하는 거라고 한다.
4.5 Hyperparameter Analysis
GPT-4o-mini에서 검색 k를 10~50으로 바꿔 본다. k를 늘리면 대체로 오르다가 점점 평평해지고, 큰 값에서는 조금 떨어지기도 한다고 한다.
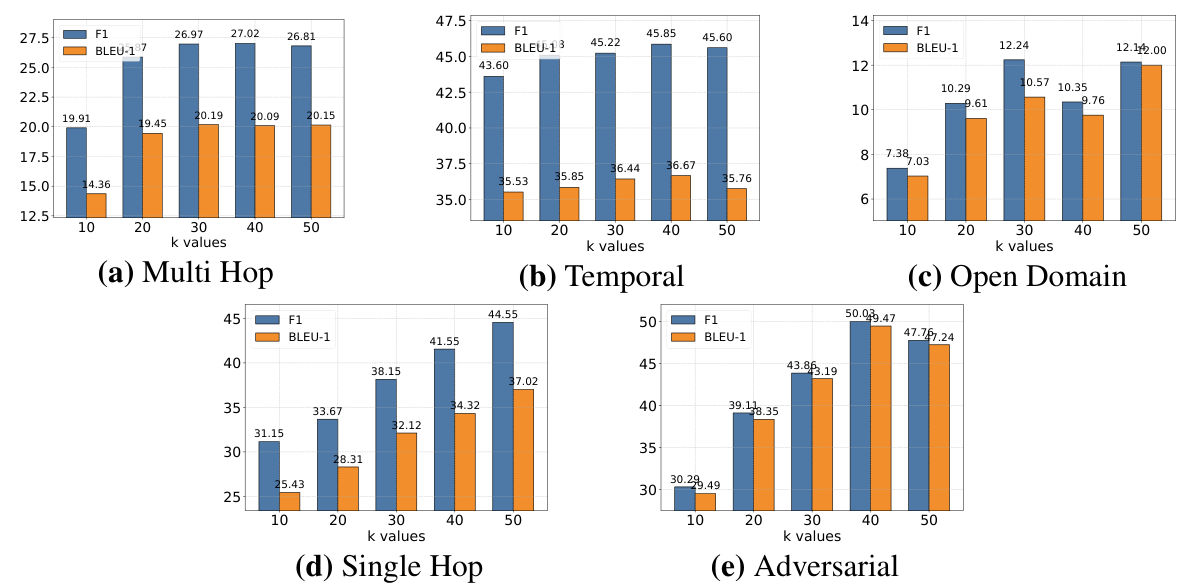
범주마다 k를 10~50으로 바꾼 F1(파란색)과 BLEU-1(주황색) 막대다. Multi Hop은 30 이후 거의 그대로고, Single Hop은 50까지 계속 오르고, Adversarial은 50에서 조금 내려간다.
4.6 Scaling Analysis
1,000 → 10,000 → 100,000 → 1,000,000 항목으로 열 배씩 늘려가며 잰다.
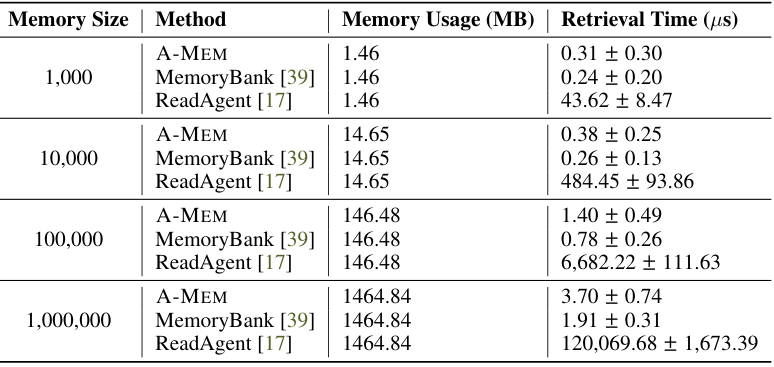
메모리 사용량은 세 방법이 같은 값이고, 검색 시간은 ReadAgent만 크게 늘어난다.
- 공간 복잡도 : 세 시스템 모두 선형
O(N), A-MEM이 저장 공간을 더 쓰지 않음 - 검색 시간 : 100만 메모리에서도 0.31µs → 3.70µs 정도, MemoryBank가 조금 더 빠름
비용은 본문 4.3절에 따로 나온다. 메모리 연산 한 번에 약 1,200토큰이다. top-k로 골라 검색하는 덕에 LoCoMo·MemGPT(16,900토큰)보다 85~93% 적다고 한다. 연산 한 번에 상용 API 기준 $0.0003 미만이고, 메모리 처리 시간은 GPT-4o-mini로 평균 5.4초, 로컬 Llama 3.2 1B로 1.1초다.
-> 토큰 절감은 검색 쪽 얘기다. 노트 생성·링크·진화에 드는 쓰기 비용, 진화가 연쇄될 때 쌓이는 비용은 따로 안 나온다??
4.7 Memory Analysis
LoCoMo 대화 두 개의 메모리 임베딩을 t-SNE로 그린다. 링크 생성과 진화를 뺀 기본 메모리보다 A-MEM 쪽이 더 뭉쳐서 군집을 이룬다고 한다.
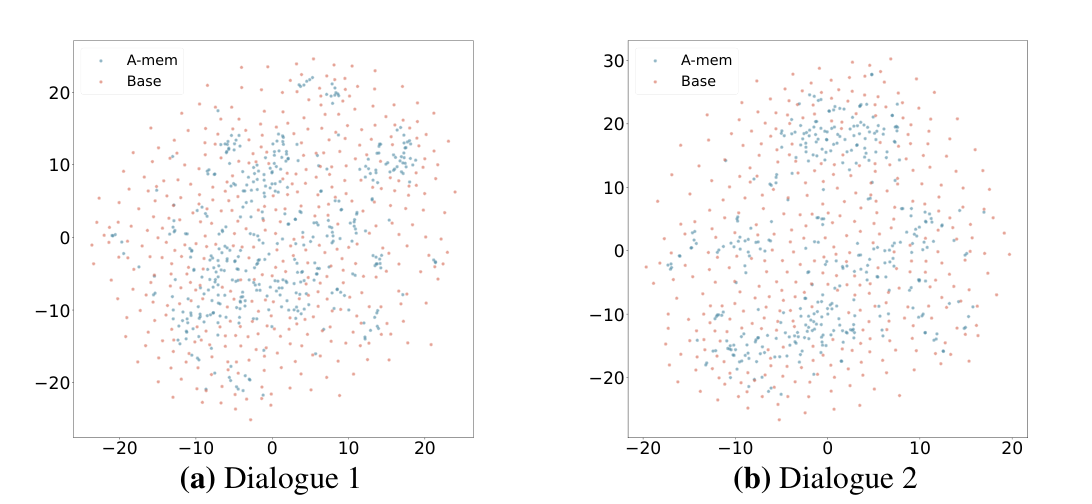
파란 점이 A-MEM, 빨간 점이 링크·진화를 뺀 Base다. 논문은 Dialogue 2에서 가운데 군집이 특히 잘 보인다고 한다.
5. Conclusions
conclusion 부분을 보면 제텔카스텐의 조직 원리에 에이전트가 직접 판단하는 유연성을 합친 메모리 시스템이라고 정리한다. 노트 구성, 링크 생성, 메모리 진화 세 모듈로 돌아간다. 논문은 파운데이션 모델 여섯 개에서 기존 SOTA를 넘었다고 하는데, 평균 순위 기준이고 GPT-4o의 Single Hop과 두 GPT 모델의 Adversarial은 LoCoMo가 더 높았다.
새 기억이 들어올 때 링크만 거는 데서 그치지 않고, 옛 기억의 설명까지 다시 쓰는 게 이 논문에서 새로운 부분이다.
6. Limitations
한계도 직접 적어두었다. 메모리를 동적으로 조직하긴 하지만 그 품질이 기반 언어모델 능력에 달려 있고, 모델이 다르면 맥락 서술이나 연결이 다르게 만들어질 수 있다고 한다.
-> 구조를 에이전트한테 맡기면 구조가 모델에 따라 달라진다. 나중에 볼 Memory Portability 논문에서 다루는 문제랑 이어진다.
지금 구현은 텍스트만 다루고, 이미지나 오디오 같은 멀티모달로 넓히는 건 앞으로 할 일로 남겨둔다.
7. 지금 관점: 진화 기능을 켤지 정할 때 볼 것
A-MEM은 원본은 남기고 해석은 덮어쓰는 쪽이다. Zep이 원본을 에피소드로 남기고 모순은 무효화로 처리했다면, A-MEM은 원본 c_i는 남기되 키워드·태그·맥락 서술은 새 기억이 들어올 때마다 고쳐 쓴다.
진화가 연쇄되는 게 걸린다. 새 메모리가 들어올 때마다 이웃 k개의 맥락이 바뀌고, 그 이웃들이 또 다른 메모리의 이웃이다.
해석이 고쳐지고 또 고쳐지면서 원래 뜻에서 멀어질 수 있을 것 같은데, 논문은 이걸 재지 않았다. ablation은 진화를 켰을 때 한 번 더 좋아진다는 결과다. 진화가 오래 쌓여도 괜찮은지는 모르겠다.
가져다 쓰기 쉬운 건 임베딩 쪽이다. concat(원문, 키워드, 태그, 맥락)으로 임베딩을 만드는 건 링크나 진화 없이도 쓸 수 있다.
링크 생성은 ablation을 보면 효과가 있다. 다만 쓰기마다 LLM 호출이 붙으니 쓰기가 잦으면 비동기로 돌려야 할 것 같다.
-> 작은 모델을 쓴다면 얘기가 달라질 수도 있다. Qwen2.5-3b에서 MemGPT 대비 2.5배 차이면 꽤 크다.
다음은 Mem0다. 대화에서 사실을 뽑아 ADD·UPDATE·DELETE·NOOP 중 하나로 반영하는 방식이고, full-context 대비 p95 지연(느린 쪽 5% 경계의 응답 시간)을 91% 줄였다.
Leave a comment