
What Does a Harness Buy Paper review
What Does a Harness Buy? Tokens, Mostly
https://arxiv.org/abs/2610.04433
What Does a Harness Buy 는 Shandong University 에서 쓴 측정 논문이다.
코딩 에이전트에서 모델을 고정하고 하네스(시스템 프롬프트, 도구 집합, 컨텍스트 관리 등 모델을 감싸는 전부)만 바꾸면 점수가 얼마나 움직이는지를 잰다.
저자는 2명이고 2026년 10월 3일에 arXiv 에 올라온 논문이다.
앞에서 본 Harness Benefit에서는 하네스가 갱신해 주는 스킬·메모리가 어떤 모델에 득이 되는지를 봤는데, 이 논문은 그보다 한 단계 아래에서 하네스 자체가 점수를 움직이는지를 묻는다.
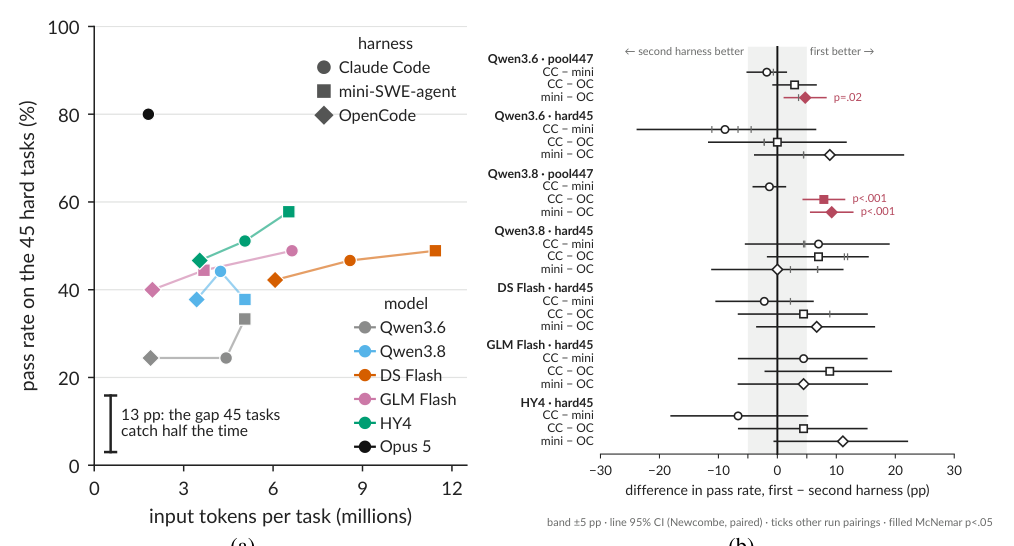
같은 모델을 세 하네스에 넣었을 때 토큰과 통과율이 어떻게 흩어지는지를 한 장에 담은 그림이다.
1. Introduction
코딩 에이전트는 모델 더하기 하네스다.
하네스는 시스템 프롬프트, 호출 가능한 도구, 도구 출력을 되돌려 주는 방식, 대화가 길어졌을 때 자르는 방식까지를 말한다.
논문에 따르면 인기 하네스는 하루에 두 번 넘게 릴리스를 내고, 그 대부분은 프롬프트·도구·컨텍스트 관리의 변경이고 모델 변경은 드물다.
이 엔지니어링이 점수를 움직인다는 믿음에는 근거가 있어 보인다.
같은 모델이 한 하네스에서 52.1%, 다른 하네스에서 57.8% 로 올라와 있고, 하네스 여섯 개가 23.8점, 다섯 개가 27.4점 범위로 퍼진 보고가 있다.
벤더는 자사 모델 기준으로 Claude Code 보다 2.4점 높다고 하네스를 광고한다.
리더보드는 하네스를 섞어서 올리므로 모델 순위가 사실은 하네스 순위이기도 하다.
저자들은 이 숫자들이 읽기 어렵다고 본다.
거의 전부 셀당 한 번만 돌린 결과인데, 같은 설정을 열 번 돌린 선행 연구에서 이미 2.2~6.0점이 퍼진다.
또 비교 대상 하네스들이 벤치마크에 같은 수준으로 연결되어 있지 않아서, 한 하네스가 최소 어댑터로는 19.1%, 전체 어댑터로는 73.4% 를 내는 식이다.
그래서 “하네스를 바꾸는 것이 같은 하네스를 다시 돌리는 것보다 점수를 더 움직이는가”는 같은 과제·같은 모델에서 측정된 적이 없다는 것이 논문의 출발점이다.
측정 설계는 이렇다.
Claude Code, mini-SWE-agent, OpenCode 세 제품 하네스를 버전 고정해 그대로 쓴다.
모델은 Qwen3.6-35B-A3B, Qwen3.8-27B, DeepSeek-V4-Flash, GLM-5.3-Flash, HY4-Preview 다섯 개이고, Claude Opus 5 는 Claude Code 안에서만 상단 기준으로 돈다.
SWE-bench Verified(사람이 검수한 500개 GitHub 이슈 해결 과제) 중 오프라인으로 돌아가는 492개를 쓰고, 가장 어려운 두 난이도 밴드 45개와 나머지 447개로 나눈다.
같은 설정을 다시 돌린 쌍 10개로 하네스 차이를 재런 차이 옆에 놓고 읽는다.
결과를 미리 말하면 하네스는 통과율을 거의 움직이지 못한다.
hard45 에서 하네스 세 개 사이의 차이는 모든 모델에서 45개 중 2~5개 과제이고, 한 하네스를 다시 돌리면 최대 3개가 움직인다.
pool447 에서 가장 무거운 Claude Code 와 가장 가벼운 mini-SWE-agent 는 5점 이내로 동등하다.
잡음을 넘는 유일한 효과는 OpenCode 가 큰 풀에서 최대 9점 뒤지는 손실이고, 그 절반은 출력 토큰 상한에 잘린 실행에서 나온다.
“Every harness effect we can name is a way to lose a task, and none we measured is a way to win one.”
대신 하네스는 비용을 정한다.
같은 모델, 같은 과제, 같은 가격표에서 과제당 비용이 하네스에 따라 최대 3배 차이 난다.
차이는 매 스텝마다 실어 보내는 시스템 프롬프트와 도구 스키마의 고정 분량에서 나오는데, Claude Code 가 16k 토큰, OpenCode 가 7k, mini-SWE-agent 가 1천 미만이다.
2. Related Work
하네스를 통째로 바꾸는 비교 연구들은 큰 차이를 보고하지만 전부 셀당 한두 번 실행이다.
가장 가까운 선행 연구는 세 제품 하네스를 50개 과제에서 한 번씩 돌려 0~8점 차이와 40배의 토큰 차이를 보고했는데, 그 8점이 하네스 때문인지 실행 잡음인지는 그 설계로는 알 수 없다.
하네스 내부 구성요소 연구들은 컨텍스트 창이 좁을 때 컨텍스트 관리가 작은 모델 점수를 거의 두 배로 올린다거나, 도구 표면을 제한해도 통과율은 같고 비용만 바뀐다고 한다.
에이전트 평가의 잡음에 대해서는 같은 설정 열 번 재런이 2.2~6.0점 퍼지고 temperature 0 에서도 표준편차가 1.5점을 넘는다는 보고가 있다.
이 논문은 재런 분산을 자로 삼아 모든 하네스 차이를 그 옆에, 그리고 그 차이를 해소하는 데 필요한 표본 크기와 함께 보고한다.
3. Setup
하네스는 Claude Code 2.1, mini-SWE-agent 2.4.6, OpenCode 1.18 이다.
mini-SWE-agent 는 bash 도구 하나만 주고 긴 관찰값만 잘라내며 컨텍스트 관리가 없어서 모델 창에 닿으면 멈춘다.
Claude Code 와 OpenCode 는 타입이 있는 파일·검색·편집 도구와 긴 시스템 프롬프트를 주고, 대화가 커지면 자동으로 압축한다.
세 하네스 모두 샘플링 파라미터를 보내지 않으므로 디코딩은 제공자 기본값이다.
스텝(모델 호출 1회) 예산은 300 으로 통일했고, 벽시계 제한은 안전망으로만 둔다.
다만 로컬 Qwen 에서는 Claude Code 가 36,000초까지 돌 수 있었던 반면 OpenCode 는 자체 소프트 타임아웃 5,760초에서 멈춰서, 이 비대칭은 appendix 에 통제 안 된 요인으로 적혀 있다.
모델은 Qwen 두 개를 vLLM 으로 직접 서빙하고, DeepSeek-V4-Flash, GLM-5.3-Flash, HY4-Preview 는 벤더 API 로 부른다.
세 API 모델은 OpenRouter 토큰 처리량 기준 2~4위에 올라 있는 모델이다.
실행은 Harbor 0.22.0 이 과제당 컨테이너 하나로 돌리고 벤치마크 자체 테스트로 채점한다.
과제는 SWE-bench Verified 500개 중 검증에 외부 웹 서비스가 필요한 8개를 뺀 492개다.
hard45 는 “1~4시간”과 “4시간 초과” 난이도 밴드 전체(42+3개)라서 샘플링 여지가 없다.
pool447 은 나머지 447개이고, 여기서는 직접 서빙하는 Qwen 두 모델만 돌린다.
에이전트 단계는 모델 엔드포인트 외 네트워크를 막는다.
초기 웹 허용 실행을 감사했더니 DeepSeek 과 Qwen 시도의 71% 가 GitHub 에서 업스트림 수정을 가져왔고, 그 실행은 모두 버렸다.
오프라인에서는 OpenCode 의 검색 도구가 첫 사용 시 바이너리를 내려받아야 해서 실패하므로, 미리 넣어 둔 arm 을 rg 로 표기해 보고한다.
채점 규칙은 결과를 읽기 전에 정했다.
셀 점수는 매 과제의 첫 예정 실행이고, 컨텍스트 창 초과·스텝·시간·출력 상한에 걸린 시도는 그대로 채점되어 거의 모두 실패로 잡힌다.
인프라 예외로 잃은 과제만 같은 설정의 재런으로 채운다.
하네스 차이는 같은 모델에서 과제 단위로 짝지어 McNemar 정확검정(짝지은 이진 결과에서 한쪽만 맞춘 과제 수를 비교하는 검정)으로 검정하고 Newcombe 구간으로 보고한다.
pool447 에서는 δ=5점 동등성 검정(두 단측검정, 90% 구간이 ±5 안에 들면 통과)도 한다.
비용은 각 시도의 토큰 수를 캐시 히트·미스·출력으로 나눠 벤더 정가로 계산하며, 벤더 API 모델 두 개만 실제 청구액이 있다.
4. Results
4.1 The Harness Barely Moves Pass Rate
pool447 에서 Qwen 두 모델로 세 하네스를 짝지어 비교한 표다.
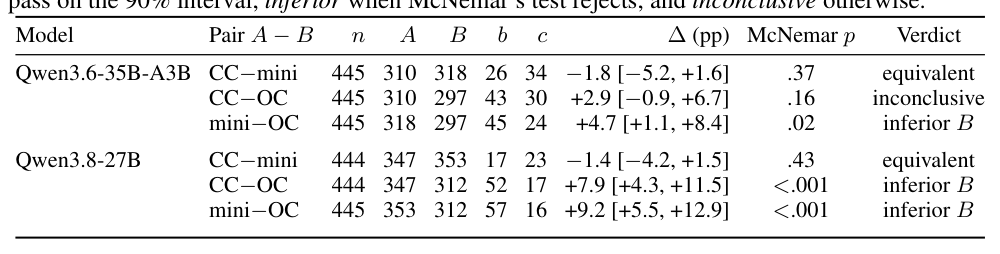
Claude Code 와 mini-SWE-agent 의 차이는 Qwen3.6-35B-A3B 에서 -1.8점, Qwen3.8-27B 에서 -1.4점이다.
두 모델 모두 90% 구간이 ±5 안에 들어서 5점 기준 동등하고, Claude Code 가 앞서더라도 기껏 1점 정도다.
두 하네스가 엇갈리는 과제(b, c 열)는 거의 반반으로 갈린다.
잡음을 넘는 쌍은 전부 OpenCode 가 지는 쪽으로, Qwen3.6 에서 +4.7점, Qwen3.8 에서 +7.9~+9.2점이다.
여섯 비교에 Holm 보정을 걸면 Qwen3.8 의 두 차이는 살아남고 Qwen3.6 의 차이는 사라진다.
hard45 는 하네스가 가장 중요해야 할 자리인데, 여기서 하네스 차이는 재런 차이와 같은 크기다.
세 하네스의 스프레드는 모든 모델에서 2~5개 과제이고, 한 셀을 다시 돌리면 최대 3개가 움직인다.
순서도 고정이 아니어서 mini-SWE-agent 가 다섯 모델 중 셋에서, Claude Code 가 둘에서 앞선다.
세 하네스 모두에서 가장 강한 HY4-Preview 도 패턴을 깨지 않는다.
Claude Code 가 mini-SWE-agent 에 -6.7점, mini-SWE-agent 가 OpenCode 에 +11.1점 차이지만 둘 다 45개 과제가 해소할 수 있는 크기 아래다(p=.45, .12).
Claude Opus 5 는 Claude Code 에서 36/45, 80% 로 사다리 꼭대기에 있다.
4.2 The Noise Floor and What It Can Resolve
재런, 하네스 교체, 모델 교체가 과제 결과를 각각 얼마나 뒤집는지를 한 눈금에 놓은 그림이다.
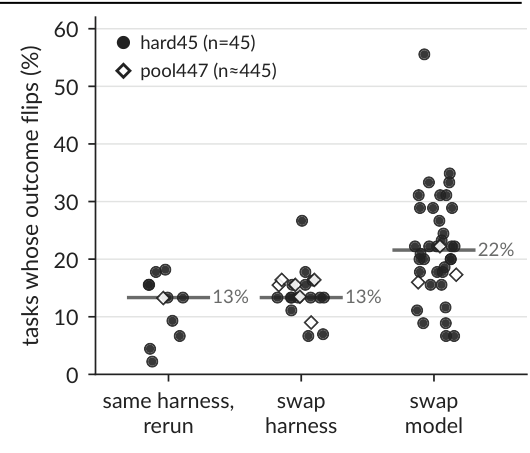
플립률은 두 실행 사이에 결과가 달라진 과제의 비율이다.
hard45 에서 재런은 중앙값 13% 를 뒤집고, 하네스 교체도 같은 13% 를 뒤집는다.
모델 교체는 22% 로 더 많이 뒤집고, pool447 도 더 큰 n 에서 같은 그림이다.
점수가 플립률보다 덜 움직이는 이유는 플립이 양방향으로 일어나기 때문인데, 하네스를 바꿔서 생기는 과제 단위 변동은 재런의 변동과 같다.
하네스의 플립은 과제 수준에서 재현되지도 않는다.
한 하네스가 고정된 과제 집합을 이긴다면 1차 실행의 갈림이 2차 실행에서 반복되어야 한다.
양쪽 모두 두 번 돌린 하네스 쌍 여섯 개에서, 같은 방향으로 갈린 과제가 5개, 반대 방향이 7개로 동전 던지기와 구분이 안 된다.
반면 같은 하네스 아래 모델 교체에서는 15개 중 10개가 양쪽 실행에서 같은 방향으로 갈려서 실제 효과의 흔적이 다르게 남는다.
이 플립률이 비교의 해상도를 정한다.
두 arm 사이 불일치율 14% 에서, 45개 과제는 12.9점 차이를 절반 확률로 잡고 80% 검정력으로는 어떤 차이도 잡지 못한다.
447개 과제는 그 검정력으로 5.2점을 잡는다.
그러니 Table 2 의 2~5개 과제 차이는 0 과 구분할 수 없고, 몇 점짜리 하네스 이득 주장은 이 논문보다 큰 짝지은 풀이 필요하며, 수십 개 과제 한 번 실행에서 읽은 값은 잡음 안이다.
-> appendix F 를 보면 45개에서는 불일치 과제가 전부 한 방향이어도 검정력 상한이 62% 라고 한다. 하네스 리더보드에 올라가는 수십 개 과제짜리 비교는 설계상 아무것도 보일 수 없는 셈이다.
4.3 A Harness Can Lose Tasks
잡음을 넘는 유일한 하네스 효과는 OpenCode 가 과제를 잃는 것이고, 궤적이 그 방식을 말해 준다.
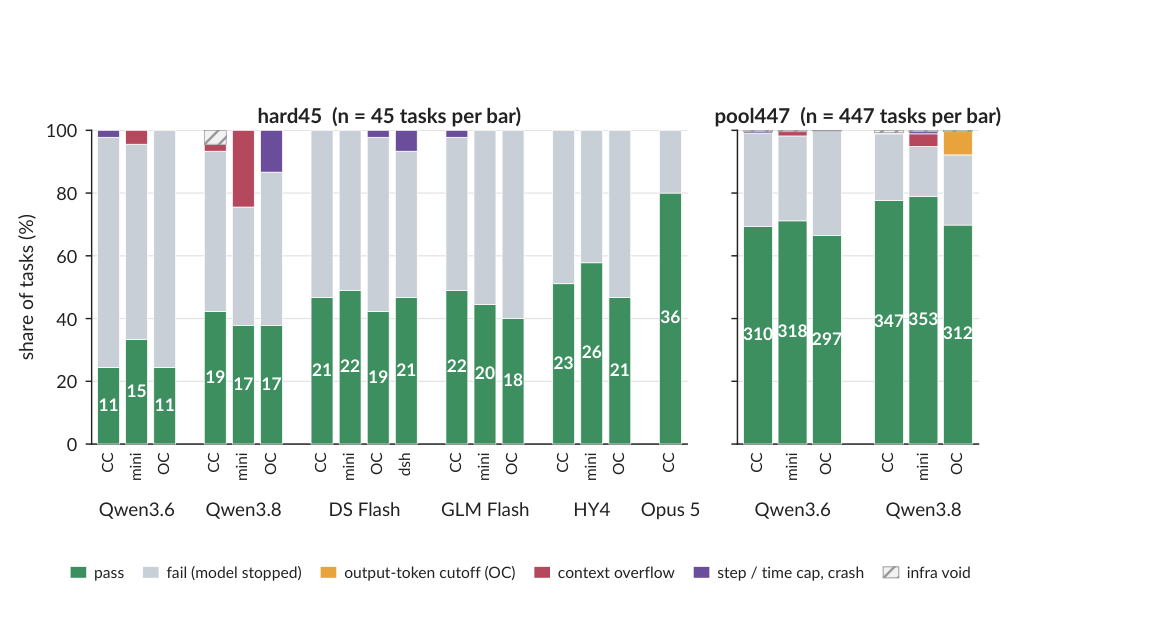
첫 번째는 복구 없는 출력 상한이다.
모델의 추론이 스텝 중간에 제공자 출력 상한(32k 토큰)을 넘으면 OpenCode 는 다시 프롬프트하지 않고, 마지막 스텝에서 잘린 시도는 디스크에 있는 것으로 끝나는데 보통 아무것도 없다.
pool447 의 Qwen3.8-27B 에서 OpenCode 시도 33개가 이렇게 실패하고, 같은 모델에서 같은 상한에 걸리는 Claude Code 는 모델에게 계속하라고 재프롬프트해서 1개만 잃는다.
잘리지 않은 과제만 채점하면 OpenCode 의 격차는 대략 절반으로 줄고, Claude Code 의 복구 프롬프트를 OpenCode 에 이식하면 41개 과제에서는 0 과 구분 안 되는 비율로 과제를 되찾는다.
appendix H 를 보면 잘림을 부르는 폭주 추론이 같은 과제 재런에서 15% 정도만 재발해서, 이 실패는 과제가 아니라 실행에 속한다.
나머지 격차는 두 번째 습관과 같이 간다.
OpenCode 아래에서는 모델이 더 빨리 멈춘다.
잘린 시도가 없는 Qwen3.6 pool447 에서 OpenCode 는 중앙값 28회 호출에 끝나는데 mini-SWE-agent 는 71회, Claude Code 는 55회다.
무엇이 모델을 빨리 멈추게 하는지는 데이터가 말해 주지 않고, 짧은 실행과 잃은 과제가 같이 다닌다는 것만 안다.
다른 실패 양상도 전부 손실이고 각각 설계 선택 하나로 거슬러 올라간다.
mini-SWE-agent 는 컨텍스트 관리가 없어서 긴 시도가 모델 창에 부딪히며, Qwen3.8-27B 에서 hard45 의 11개, pool447 의 18개가 그렇다.
다만 그 초과 대부분은 증상이다.
다른 두 하네스도 그 과제를 대개 실패했고, 다른 하네스가 통과한 것만 되찾는 압축 단계가 있었다면 hard45 에서 6.7점이 움직이며, 재런하면 대부분 다시 초과한다.
제품형 하네스 둘은 자기 한계에서 실패하는데, Claude Code 와 OpenCode 는 압축을 하므로 창에 잃는 시도는 많아야 1개이고 Claude Code 는 스텝 상한에 arm 당 최대 2개를 잃는다.
OpenCode 는 Qwen3.8 hard45 에서 벽시계 제한에 6개를 잃지만 그 과제를 빼도 격차는 줄지 않는다.
어느 것도 과제를 이기는 길은 아니다.
4.4 The Harness Sets the Bill
하네스는 토큰 청구액을 같은 모델에서 최대 3배까지 정한다.
청구액은 대략 스텝당 입력 곱하기 스텝 수이고, 하네스는 두 항을 다 움직인다.
GLM-5.3-Flash 에서 Claude Code 와 mini-SWE-agent 는 스텝 수가 비슷해서 차이는 스텝당 무게다.
시도당 Claude Code 1.81 CNY, mini-SWE-agent 0.97 CNY 이고, OpenCode 는 스텝당 무게도 가볍고 가장 빨리 멈춰서 0.56 CNY 로 둘 다에서 가장 싸다.
DeepSeek-V4-Flash 에서는 스텝 수가 갈려서 mini-SWE-agent 가 141 스텝, Claude Code 가 104 스텝이고, 가장 가벼운 하네스가 가장 많은 토큰을 옮기게 된다.
스텝당 무게와 스텝 수는 서로 맞바꾸는 관계이고 어느 쪽이 이기는지는 모델에 달렸다.
스텝당 무게는 도구가 돌려주는 텍스트에서 오지 않는다.
호출당으로 보면 세 하네스가 모델에 주는 텍스트 양은 평균에서도 90분위에서도 비슷하다.
다른 것은 매 호출에 실리는 프리앰블(시스템 프롬프트, 도구 스키마, 메시지 래퍼)로, Claude Code 16,581 토큰, OpenCode 7,025 토큰, mini-SWE-agent 829 토큰이 매 스텝 다시 지불된다.
Claude Code 는 모델의 추론도 transcript 에 남기므로 mini-SWE-agent 실행의 몇 배에 달하는 모델 텍스트가 쌓이고, 스텝도 가장 많이 쓴다.
이 항들을 도구 반환값·호출 인자에 더하면 세 arm 모두에서 측정된 스텝당 입력이 대략 재구성된다.
-> 추론이 매 턴 다시 보내진다는 항은 appendix G 에서 “fit 이 닫히려면 그래야 한다”로 추정한 것이지 관측한 것이 아니다. 제공자 usage 가 추론과 텍스트를 나눠 주지 않아서 생긴 한계로 읽힌다.
스텝마다 모델이 읽는 입력 토큰을 그린 그림이다.
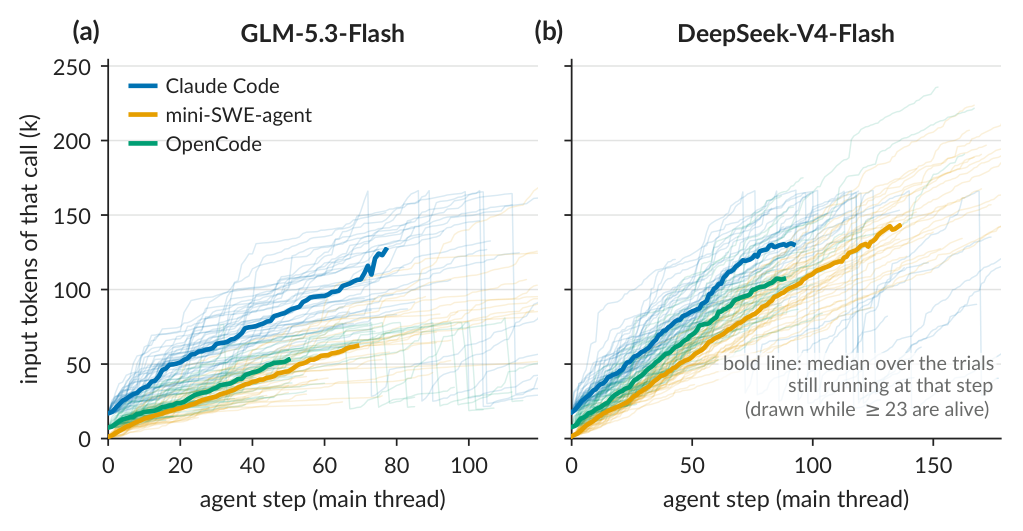
모든 arm 에서 입력은 거의 직선으로 오르므로 하네스는 선의 시작점과 기울기로 기술된다.
하네스는 시작점에서 먼저 갈린다.
GLM-5.3-Flash 의 첫 호출은 Claude Code 17.1k, OpenCode 7.6k, mini-SWE-agent 1.4k 토큰이고, DeepSeek-V4-Flash 에서도 같은 세 크기다.
기울기는 두 모델 모두에서 서로 1.5배 안에 들어 있고, Claude Code 가 transcript 에 남기는 추론이 더 가파른 기울기의 일부를 설명한다.
DeepSeek-V4-Flash 에서는 세 선이 거의 평행해서 Claude Code 의 스텝당 입력이 mini-SWE-agent 와 비기고 청구액은 스텝 수가 정한다.
Claude Code 는 시도의 1/5~1/3 에서 압축하고 그것이 그림의 절벽이며, mini-SWE-agent 는 압축하지 않고 초과한다.
첫 호출, 스텝당 증가, 스텝 수가 하네스 청구액을 정하는 세 숫자다.
캐시 히트 가격은 청구액의 크기를 바꾸지 순서를 바꾸지 않는다.
매 스텝이 직전 transcript 를 다시 보내므로 모든 arm 에서 입력 토큰의 96~99% 가 캐시 히트다.
Zhipu 는 히트에 미스의 0.287배를 받아서 캐시 입력이 GLM 청구액의 대부분이고 Claude Code 가 mini-SWE-agent 의 거의 두 배로 나온다.
DeepSeek 은 0.033배라 캐시된 transcript 가 청구액의 절반 미만이고 출력이 같은 크기의 항이 되어, 더 많이 읽는 mini-SWE-agent 와 더 많이 쓰는 Claude Code 가 같은 값으로 나온다.
각 모델의 토큰을 상대 벤더 가격표로 다시 매겨도 세 하네스의 순서는 유지된다.
4.5 What We Looked For and Did Not Find
벤더 자체 하네스는 자기 모델에서 점수 이득이 없다.
DeepSeek 의 커맨드라인 하네스는 DeepSeek-V4-Flash 에서 45개 중 21개를 통과해 Claude Code 와 같고 mini-SWE-agent 보다 하나 적으며, 시도당 1.04 CNY 로 Claude Code 의 0.98 보다 비싸다.
Claude Code 는 transcript 를 길게 만들지만 모델이 더 깊이 추론하게 하지는 않는다.
Qwen3.8-27B pool447 에서 출력 중 추론 비중은 Claude Code 82.5%, OpenCode 82.9% 로 같고, 시도당 총 출력은 Claude Code 가 1.23배다.
가장 약한 모델이 가장 하네스에 민감하지도 않다.
Qwen3.6-35B-A3B 에서 OpenCode 를 빼고 가장 넓은 차이는 hard45 의 Claude Code 대 mini-SWE-agent -8.9점(p=.39)인데, 재런에서 줄고 pool447 에서는 5점 내 동등하다.
한 하네스 안에서 도구를 빼거나 1년 전 릴리스를 써도 점수는 안 움직인다.
Claude Opus 5 에서 Claude Code 의 파일 편집 도구를 빼서 bash 로만 편집하게 해도, 반대로 셸을 빼도, 대조 실행 세 번과 한 과제 이내다.
1년 전 릴리스 1.0.100 도 같은 띠 안에 들어오는데 비용은 0.44배로, 확장 사고(extended thinking)를 기본으로 켜지 않았기 때문이다.
찾은 상호작용은 thinking 하나다.
Qwen3.6-35B-A3B 에서 thinking 을 끄면 Claude Code 와 OpenCode 는 두 실행 평균 +2.2, +3.4점으로 오르내리는 과제 수가 비슷한데, mini-SWE-agent 는 11점을 잃는다(p=.04).
thinking 의존은 모델 단독이 아니라 모델과 하네스 쌍에 속한다는 것을 시사한다.
5. Discussion and Conclusion
“What a harness buys, on this evidence, is fewer ways to lose a task, and a bill, not pass rate.”
측정된 하네스 효과는 모두 모델이 풀 수 있었을 과제를 잃는 방식이다.
복구 없는 출력 상한, 압축 없는 컨텍스트 창, 오프라인에서 안 도는 검색 도구가 그것이다.
하네스가 과제를 이기는 경우는 찾지 못했으므로 엔지니어링은 손실이 있는 자리에 둬야 한다.
세 하네스가 가장 크게 다른 부분, 즉 프롬프트·도구 표면·압축 정책은 가장 많은 주목을 받는 부분인데 그 어느 차이도 점수 이득을 사지 않는다.
thinking 상호작용은 저자들이 쫓고 싶은 한 가지 단서다.
Qwen3.6 에서는 끄면 mini-SWE-agent 만 11점을 잃지만, HY4-Preview 에서는 같은 스위치가 Claude Code 안에서 11점을 잃게 하고 출력 토큰을 절반 이하로 줄인다.
명시적 추론 의존이 모델·하네스 쌍에 특정하다는 뜻이지만 그리드가 너무 작아서 메커니즘은 못 가린다.
범위의 한계는 두 가지다.
결과는 벤치마크 하나에서 나왔고, Terminal-Bench 2.1 의 단일 모델 점검(appendix L)은 전이 확인일 뿐이며 범용 에이전트는 다른 영역일 수 있다.
닫힌 기준 모델은 Claude Code 에서만 돌았으므로 세 하네스 사다리는 HY4-Preview 에서 멈추고, 닫힌 프런티어 모델이 같은 격차를 보이는지는 알 수 없다.
하네스 비교에서 가장 싼 통제는 같은 셀의 두 번째 실행이며, 저자들은 모든 하네스 차이 옆에 그것을 보고하라고 권한다.
6. 지금 관점: 하네스 비교에 재런 한 번을 끼워 넣기
Dynamic Concurrency는 Claude Code 같은 제품 하네스의 기능 하나를 켜고 끄며 토큰이 1.41~3.31배 늘지만 통과율은 거의 안 움직인다고 했고, GenericAgent는 컨텍스트 밀도를 올려 토큰을 덜 쓰면서 더 푼다고 했다.
이 논문은 그 둘 사이에 자를 하나 놓는다.
어떤 하네스 변경이 점수를 올렸다고 하려면 재런 분산보다 커야 하고, SWE-bench Verified 에서 그 분산은 45개 과제 기준 13% 플립이다.
Anatomy of Agentic Memory가 메모리 벤치마크 수치를 어떻게 읽을지 물었다면, 이 논문은 하네스 벤치마크 수치에 같은 질문을 던진다.
지금 가져다 쓸 수 있는 부분은 비용 쪽이다.
하네스 청구액이 첫 호출 크기, 스텝당 증가, 스텝 수 세 숫자로 거의 설명된다는 것은 내가 만드는 에이전트에도 그대로 적용된다.
시스템 프롬프트와 도구 스키마를 합친 프리앰블이 몇 토큰인지, 그것이 캐시 히트 가격으로 얼마가 되는지는 지금 당장 잴 수 있다.
Claude Code 의 16k 프리앰블이 점수를 안 사고 mini-SWE-agent 의 829 토큰과 5점 내 동등하다면, 긴 시스템 프롬프트와 도구 열 개를 넣는 쪽이 먼저 근거를 대야 한다.
반대로 벤더의 캐시 가격이 싸면 프리앰블보다 스텝 수가 청구액을 정하므로, 어느 항을 깎을지는 가격표를 보고 정해야 한다.
그대로 받아들이기 어려운 부분도 있다.
벤치마크가 SWE-bench Verified 하나이고, 모델 다섯 중 둘은 로컬 서빙이며, 닫힌 프런티어 모델은 Claude Code 에서만 돌았다.
Opus 5 를 mini-SWE-agent 에 넣었을 때도 같은지는 이 논문이 답하지 않는다.
thinking 을 껐을 때 mini-SWE-agent 만 11점을 잃는 결과는 bash 하나짜리 하네스가 모델의 추론에 더 기댄다는 뜻일 수 있어서, 약한 모델에 가벼운 하네스를 붙일 때는 이 상호작용을 따로 봐야 한다.
-> 한 하네스 안에서 도구를 빼도 Opus 5 점수가 안 움직인다는 Table A5 결과는 강한 모델 이야기이고, 작은 모델에서도 그런지는 원문에서 확인 못 함.
그리고 이 논문의 처방은 간단하다.
하네스 A 와 B 를 비교하기 전에 A 를 두 번 돌려서 플립률을 재라.
그 숫자가 A 와 B 의 차이와 비슷하면 그 비교에서는 아무것도 읽을 수 없다.
내부 평가셋이 수십 개 과제라면 거의 그럴 것이고, 그때는 과제를 늘리거나 점수 대신 실패 종류(출력 상한, 컨텍스트 초과, 조기 종료)를 세는 쪽이 하네스 변경의 효과를 더 잘 보여 준다.
Leave a comment