
UniToolCall Paper review
UniToolCall: Unifying Tool-Use Representation, Data, and Evaluation for LLM Agents
https://arxiv.org/abs/2604.11557
UniToolCall 은 University of Science and Technology of China, Eastern Institute of Technology(Ningbo), The Hong Kong Polytechnic University 에서 만든 도구 호출 학습·평가 프레임워크다.
저자는 8명이고 arXiv 에 올라온 논문이다.
도구 모음 구축, 학습 데이터 생성, 평가를 QAOA(Query–Action–Observation–Answer) 라는 한 가지 표현으로 묶고, 그 데이터로 Qwen3-8B 를 파인튜닝해서 GPT·Gemini·Claude 계열과 비교한다.
앞에서 본 Toolformer에서는 LM 이 도구 호출 학습 데이터를 스스로 만들었는데, 이 논문은 그 뒤로 쌓인 공개 데이터셋들을 한 형식으로 모으고 빠진 구조만 합성으로 채운다.
1. Introduction
도구 사용(tool use)은 자연어 지시를 실행 가능한 함수 호출로 바꾸는 능력이다.
지금은 이 능력을 데이터로 가르치는데, 그 데이터는 에이전트가 외부 환경과 주고받은 궤적(trajectory)이다.
초기에는 ToolLLM, API-Bank 처럼 실제 API 를 실행해서 궤적을 모았다.
현실적인 신호를 주지만 외부 시스템에 의존해서 규모를 키우기 어렵고 불안정하다.
그래서 최근에는 도구 환경을 흉내 내고 궤적을 자동으로 합성하는 쪽(ToolForge, LoopTool, ASTRA)으로 넘어왔다.
평가 쪽에서도 ComplexFuncBench, HammerBench, ACEBench 같은 벤치마크가 따로따로 나왔다.
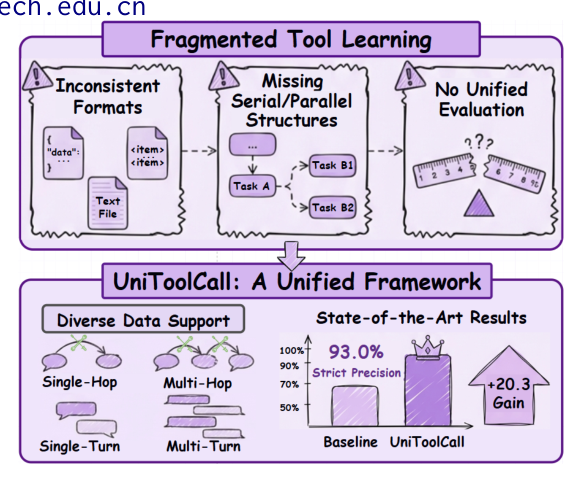
저자들은 이 작업들이 서로 떨어져서 만들어진 탓에 세 가지가 어긋난다고 본다.
- representation inconsistency: 데이터셋마다 도구 호출·인자·관찰을 적는 스키마가 달라 섞어서 학습하기 어렵다
- structural incompleteness: 도구를 순서대로 부르는 경우(serial)와 한꺼번에 부르는 경우(parallel)를 구분해서 만든 데이터가 드물다
- evaluation mismatch: 벤치마크마다 프로토콜, 도구 정의, 채점 스크립트가 달라 데이터셋 간 비교가 안 된다
UniToolCall 은 이 셋을 한꺼번에 다룬다.
도구 22K+ 개를 모아 걸러 내고, 공개 데이터셋 10개를 표준화한 것에 구조를 통제한 합성 궤적을 더해 390K 건의 학습 코퍼스를 만든다.
공개 벤치마크 7개도 같은 QAOA 형식으로 바꿔 같은 매칭 규칙과 지표로 채점한다.
contribution 은 셋이다.
- single/multi-hop, single/multi-turn, serial/parallel 을 통제하는 합성 파이프라인과 Anchor Linkage
- function-call, turn, conversation 세 단위로 채점하는 통합 벤치마크
- Qwen3-8B 파인튜닝 결과: Hybrid-20 설정에서 single-turn Strict Precision 93.0%
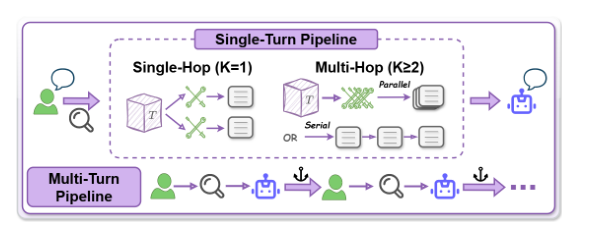
hop 은 한 턴 안에서 도구를 부르는 횟수이고, turn 은 사용자 발화의 횟수다.
single-hop 은 도구 한 번, multi-hop 은 한 질의에 도구 여러 번, multi-turn 은 사용자가 여러 번 말하는 대화다.
2. Related work
합성 데이터 쪽에서는 ToolACE, ToolMind, APIGen-MT, BUTTON 이 멀티 에이전트 시뮬레이션으로 대화를 만들고, MAGNET, ToolDial, ToolFlow 는 그래프 경로로 multi-hop 을 합성한다.
저자들은 이 파이프라인들이 serial 과 parallel 을 명시적으로 통제하지 않고, 멀티턴에서 상태를 이어 가는 일을 LLM 의 안정성에 맡긴다고 본다.
벤치마크 쪽에서는 TRAJECT-Bench 가 parallel 과 sequential 궤적을 나눠 평가하지만, 벤치마크마다 스키마와 채점 규칙이 달라 서로 비교하기 어렵다는 점을 든다.
3. UniToolCall
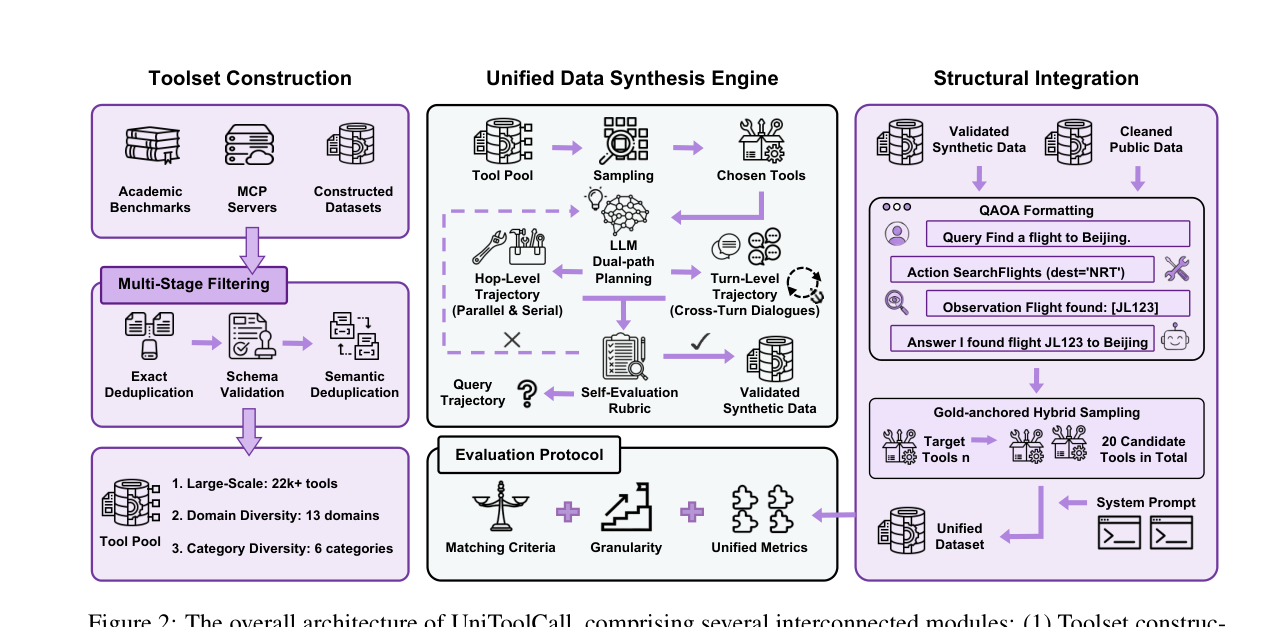
프레임워크는 도구 모음, 데이터 생성 파이프라인, 구조 조립 단계로 이루어지고 여기에 통합 벤치마크가 붙는다.
모든 데이터는 QAOA 형식으로 적는다.
Query(사용자 질의), Action(함수 호출), Observation(도구 반환값), Answer(최종 답) 네 칸이다.
3.1 Toolset construction
도구는 세 군데에서 모은다.
- academic benchmarks: FC-RewardBench, ToolRet 학습셋의 도구
- MCP servers: mcp.so 상위 40개 서버와 MCP-Universe 에서 쓴 11개 서버
- constructed datasets: 이 논문의 학습·평가 데이터에서 뽑은 도구 정의
모은 도구는 JSON Schema 한 형식으로 맞추고 네 단계로 거른다.
이름과 설명이 같은 것을 지우고(exact deduplication), 스키마에 시간 속성이 있는 도구를 빼고, 파라미터 스키마가 없거나 깨진 도구를 빼고, 마지막으로 Qwen3-Embedding-8B 로 이름+설명을 임베딩해서 코사인 유사도가 0.9 를 넘는 것을 중복으로 지운다.
남은 도구 풀은 22,606개다.
시간 속성 도구를 빼는 이유는 벤치마크마다 “tomorrow” 같은 상대 시간을 처리하는 방식이 달라서다.
ACEBench 는 절대 시각으로 바꾸고 HammerBench 는 상대 표현 그대로 두기 때문에, date, time, schedule 같은 키워드가 스키마에 있으면 제외한다.
-> 예약, 일정, 알림처럼 날짜 인자를 받는 도구가 통째로 빠진다. 채점을 공정하게 하려는 선택이지만 실제 에이전트가 자주 틀리는 자리가 평가에서 사라진다.
도구에는 기능 카테고리 6개(analysis, search 등)와 응용 도메인 13개(finance, technology 등) 라벨을 붙여, 데이터를 만들 때 고르게 뽑는 데 쓴다.
3.2 Training dataset construction
학습 데이터는 공개 데이터와 합성 데이터 두 덩어리다.
Public data integration
공개 도구 호출 데이터셋 10개(API-Bank, ToolAlpaca, ToolHop, APIGen, Seal-Tools, Toucan 등)를 QAOA 로 바꾼다.
변환 전과 후에 한 번씩 거르는데, 기준은 스키마가 온전한지, 함수 호출과 파라미터가 빠지지 않았는지, 영어인지, 걸러진 도구를 참조하지 않는지다.
변환 직후 1,520,684건이던 것이 387,123건으로 줄어든다.
이 중 Toucan(실제 MCP 환경에서 합성한 데이터셋)이 319,669건이다.
-> 남은 공개 데이터의 약 83% 가 Toucan 한 곳에서 온다. 10개를 합쳤다고 하지만 분포는 Toucan 에 가깝다.
Unified synthetic data pipeline
공개 데이터에 부족한 구조를 채우려고 합성 데이터를 만든다.
도구 풀에서 일부를 뽑고, LLM(Qwen3-32B)이 궤적을 생성하고, 자기 평가를 통과한 것만 QAOA 로 조립한다.
조립할 때 후보 도구 목록을 Hybrid-20 이라는 설정으로 만든다.
정답 도구를 넣고, 임베딩 유사도가 높은 hard negative(정답과 비슷해서 헷갈리는 오답 도구)를 채우고, 무작위 easy negative 5개를 붙여 20개를 맞춘다.
여기에 도구 사용 규칙을 적은 시스템 프롬프트를 붙인다.
세 종류의 합성 데이터는 뽑는 도구 수와 궤적 모양이 다르다.
Single-Hop
도구 하나를 뽑아 질의-호출-관찰-답 한 번짜리 궤적을 만든다.
Multi-Hop
같은 도메인에서 도구 2~5개를 뽑아 2스텝 이상의 궤적을 만든다.
serial 은 한 스텝씩 생성하면서 다음 호출이 앞 관찰에 나온 구체적인 값을 참조하도록 강제한다.
parallel 은 질의와 모든 호출을 한 번에 생성해서 의도와 도구가 어긋나지 않게 한다.
Multi-Turn
사용 빈도를 맞춰 도구 10개를 뽑고 2~4턴 대화를 만든다.
에피소드 전체 줄거리를 먼저 짜고 턴별 의도를 정하는 2단계 계획을 쓴다.
여기에 Anchor Linkage 를 건다. 2번째 턴부터는 사용자 질의가 직전 턴의 구체적인 상태값(거래 ID, 좌표, 반환된 파라미터 값)을 반드시 이어받아야 한다는 제약이다.
제약이 없으면 생성기는 문장은 자연스러운데 앞 턴과 상관없는 턴을 만든다.
Anchor Linkage 는 세 단계로 구현된다.
- dynamic prompting: 처음엔 anchor 를 넣으라는 약한 힌트를 주고, 실패하면 재시도에서 강한 포함 제약으로 올린다
- programmatic verification: 정규식으로 anchor 문자열이 질의에 있는지 확인하고, 끝내 실패하면 “About [anchor], …” 처럼 질의 앞에 붙인다
- evaluation gating: anchor 가 뒤 도구 호출에 실제로 쓰이는지를 LLM rubric 점수로 확인하고, 통과 못 하면 버린다
자기 평가는 생성한 모델(Qwen3-32B)이 직접 한다.
질의 쪽 3개(Tool-fit, Clarity, Naturalness)와 궤적 쪽 3개(Success, Grounding, Efficiency)를 1~10점으로 매기고, 최저 4.0 이상이면서 평균 8.0 이상이어야 통과다.
multi-turn 은 anchor 점수를 0.2 가중으로 더한 종합 점수가 8.0 이상이어야 한다.
떨어지면 같은 도구로 3번까지 다시 만든다.
생성한 모델이 자기 출력을 채점하는 구조이고, 사람이 검수한 비율은 원문에서 확인 못 함.
3.3 Evaluation protocol
평가 데이터는 공개 벤치마크 7개(BFCL v3, ACEBench, Seal-Tools, HammerBench, ComplexFuncBench, API-Bank, ToolAlpaca)를 QAOA 로 바꾼 것이다.
보는 능력은 두 가지, 맞는 도구를 고르는가와 인자를 맞게 채우는가다.
대화는 여러 턴으로, 턴은 여러 함수 호출로 이루어지니 채점도 세 단위로 나눈다.
Function call-level verification
호출 하나하나의 도구 이름과 인자를 정답과 맞춰 보는 가장 작은 단위다.
Turn & Conversation-level aggregation
single/multi-hop 은 턴 단위로, single/multi-turn 은 대화 전체 단위로 모은다.
Strict 지표는 호출 하나라도 틀리면 그 인스턴스가 0점이고, Flexible 지표는 맞은 호출의 비율만큼 점수를 준다.
Matching criteria
먼저 규칙 기반 매칭을 한다.
도구 이름은 구두점·숫자·구분자를 지우고 소문자로 바꾸고, 인자는 날짜 형식 통일, 문자열로 적힌 배열 파싱, 대소문자·관사 제거, 숫자 문자열과 숫자의 동일 처리를 거친 뒤 정확히 같아야 한다.
그다음 의미 매칭으로 ROUGE-L(예측과 정답의 가장 긴 공통 부분열로 재는 겹침 점수)이 0.7 이상이면 맞은 것으로 본다.
변환하면서 빠지는 것들이 있다.
정답 호출이 하나로 정해지지 않는 샘플(관련 없는 질의를 거절하는지 보는 irrelevance 분할 등), 사용자가 빠진 인자를 후속 턴에서 채워 주는 slot-filling 멀티턴(HammerBench multi-turn, API-Bank Level-1/2), 영어가 아닌 질의다.
변환 직후 12,459건이 도구 필터를 거쳐 6,163건으로 줄고, 이 중 HammerBench 가 4,340건이다.
-> 평가셋의 70% 가 HammerBench single-turn 이다. 본문 표가 micro 평균이라 single-turn 수치는 사실상 HammerBench 점수에 가깝다. 저자들도 이를 알고 데이터셋별 macro 평균을 부록에 따로 둔다.
4. Experiments
4.1 Experimental setup
Qwen3-8B 를 LoRA(가중치 전체 대신 저랭크 행렬만 학습하는 파인튜닝 방식)로 rank 8, alpha 16, 1 epoch, learning rate 1e-5, 최대 길이 8192 토큰으로 학습한다.
학습 데이터는 390,060건으로 공개 387,123건과 합성 2,937건(single-hop, multi-hop, multi-turn 각 979건)이다.
-> 합성 데이터는 전체의 0.75% 다. 본 결과의 향상 폭을 합성 파이프라인의 효과로 읽으면 안 되고, 대부분은 표준화한 공개 데이터 38만 건으로 학습한 효과로 읽어야 한다.
학습 목표는 Action 뿐이고, Observation 과 Answer 칸은 데이터에 남아 있지만 예측 대상에서 뺀다.
비교 대상은 GPT-5.2 Instant, Gemini 3 Flash Preview, Claude 4.6 Sonnet, Kimi-K2-Instruct, DeepSeek-V3.2, Qwen3-32B 여섯 개다.
추론 효율을 이유로 모두 reasoning 을 끄거나 non-reasoning 변종을 썼다.
-> 상용 모델은 reasoning 을 끈 상태이고, 프롬프트도 이 논문의 통합 시스템 프롬프트와 출력 형식(<tool_call> 태그, 한 라운드에 호출 하나)이다. 파인튜닝한 모델은 이 형식을 39만 번 본 뒤에 시험을 치른다. 표의 순위를 “8B 가 상용 모델보다 도구를 잘 쓴다”로 옮기기는 어렵다.
평가 설정은 3.2절의 후보 20개를 주는 Hybrid-20 과, 정답 도구만 후보로 주는 GT 둘이다.
본 표는 모델당 한 번 돌린 결과이고, Qwen3-8B vanilla 와 UniToolCall 만 3번 학습해서 평균과 표준편차를 부록에 둔다.
지표는 넷이다.
- Strict Precision(SP): 예측한 호출 수가 정답과 같고 도구 이름이 전부 맞으면 1, 아니면 0
- Flexible Precision(FP): 예측한 호출 중 도구 이름이 맞은 비율
- Strict Parameter Accuracy(SPA): 예측한 호출 중 이름과 모든 인자 값이 정확히 맞은 비율
- Flexible Parameter Accuracy(FPA): 이름이 맞고 인자가 규칙 매칭이나 ROUGE-L 기준을 넘은 비율
SP 와 FP 는 도구 이름만 보고, 인자까지 보는 건 SPA 와 FPA 다.
abstract 의 93.0% 는 SP, 그러니까 이름을 맞힌 비율이다.
4.2 Main results
주 결과는 Table 1 이고, 잘라 둔 이미지가 없어서 수치를 글로 옮긴다.
아래는 모두 Hybrid-20 설정, 7개 벤치마크 micro 평균이다.
Strong gains in tool selection
UniToolCall 의 SP 는 single-hop 92.9%, single-turn 93.0% 로 비교 모델 중 가장 높다.
vanilla Qwen3-8B 는 66.9%, 63.3% 였고, 그다음으로 높은 Qwen3-32B 가 72.6%, 72.7% 다.
multi-hop SP 는 80.7% 로 Claude 4.6 Sonnet(83.3%) 다음이고, vanilla 는 22.7% 였다.
Improved parameter grounding
인자 쪽은 숫자가 훨씬 낮다.
single-turn 에서 SPA 31.6%, FPA 52.4% 로 비교 모델 중 가장 높지만, 이름을 93.0% 맞히는 모델이 인자까지 정확히 맞히는 비율은 3분의 1 이 안 된다.
multi-hop 은 SPA 66.6%, FPA 78.8% 로 vanilla(38.1%, 47.0%)보다 오르고 Claude 4.6 Sonnet(74.1%, 84.1%)보다는 낮다.
?? single-hop SPA 는 정답 도구만 준 GT 설정의 vanilla 도 28.7% 다. 모든 모델이 20%대에 몰려 있는데, 인자 정답이 원래 맞히기 어려운 건지 매칭 규칙이 엄격한 건지는 본문만으로는 모르겠다.
Approaching GT upper bound
GT 설정의 vanilla Qwen3-8B 는 distractor(정답이 아닌 후보 도구)가 없을 때의 참고점이다.
single-hop SP 는 GT vanilla 96.1% 에 UniToolCall 이 Hybrid-20 에서 92.9% 로 다가간다.
single-turn(93.0% 대 92.6%)과 multi-hop(80.7% 대 47.5%)에서는 distractor 를 안은 채로 GT vanilla 를 넘는다.
저자들은 이를 distractor 에 강해진 것 이상으로 도구 호출 예측 자체가 나아진 근거로 든다.
Long-horizon execution remains a challenge
multi-turn SP 는 Qwen3-32B(8.3%)를 뺀 모든 모델이 0.0% 이고, UniToolCall 도 0.0% 다.
원문은 이렇게 설명한다.
“a single incorrect call zeros the entire episode”
대화 단위 Strict 채점이라 호출 하나만 틀려도 대화 전체가 0점이 된다.
BFCL v3 multi-turn 30개 대화에서 “k 번째 턴까지 전부 맞은 대화의 비율”을 따로 보면, 2번째 턴에서 vanilla 는 3.3%, UniToolCall 은 50.0% 다.
부분 점수를 주는 multi-turn FP 는 UniToolCall 이 39.4% 로 가장 높다.
-> 30개 대화에서 본 진단이고 뒤 턴으로 갈수록 n 이 25, 8, 2 로 준다. 3회 반복 실험에서도 multi-turn SPA 가 16.6 ± 4.0 으로 흔들린다. multi-turn 쪽 순위는 넓게 봐야 한다.
Scaling and cross-family generalization
전체 데이터 대신 2만 건(Syn+Pub Balanced 20K)으로 줄여 Qwen3 0.6B~14B 와 Gemma-3-4B-it, Llama-3.2-3B-Instruct 에 같은 방법을 적용한다.
single-hop / single-turn SP 는 모든 크기에서 오르고, 8B 에서 +25.8 / +23.2 pp, Gemma 에서 +33.2 / +31.4 pp, Llama 에서 +33.6 / +32.5 pp 다.
다만 8B 의 multi-hop SP 는 20K 에서 21.0% 로 vanilla(22.8%)보다 낮고, 저자들도 이 숫자는 본 결과의 80.7% 와 비교할 수 없다고 적는다.
-> multi-hop 이 22.7% 에서 80.7% 로 뛴 것은 2만 건으로는 재현되지 않았다. 구조를 맞춘 2만 건보다 39만 건이라는 양이 multi-hop 을 올렸다는 뜻으로 읽힌다.
4.3 Ablations
ablation 은 셋이고, 저자들이 먼저 합성 데이터의 역할을 이렇게 한정한다.
“The synthetic pipeline supplies missing structure rather than replacing the scale and domain coverage of public corpora.”
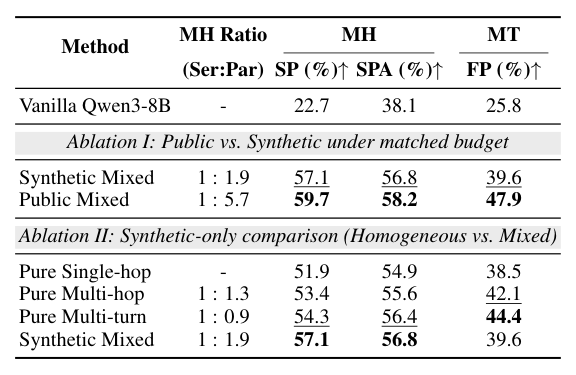
아래 표는 학습 데이터를 979건으로 맞춰 놓고 구성만 바꾼 뒤 multi-hop SP·SPA 와 multi-turn FP 를 잰 것이다.
Ablation I: Public vs. synthetic structure
같은 979건이면 Public Mixed 가 세 칸 모두에서 Synthetic Mixed 보다 높다(multi-hop SP 59.7% 대 57.1%, multi-turn FP 47.9% 대 39.6%).
저자들이 보는 것은 구조 비율이다.
공개 데이터는 serial 대 parallel 이 1:5.7 이고 합성은 1:1.9 다.
공개 데이터에는 서로 독립인 호출을 한 번에 내는 예가 많고, 앞 결과를 받아 다음을 부르는 예가 적다.
이 치우침은 평가셋에도 있다.
BFCL v3 의 걸러진 multi-hop 분할에는 parallel 이 141개인데 순수 serial 은 3개뿐이다.
아래 그림은 그 serial 3개에 parallel 을 섞는 비율을 바꿔 가며 점수를 본 것이다.
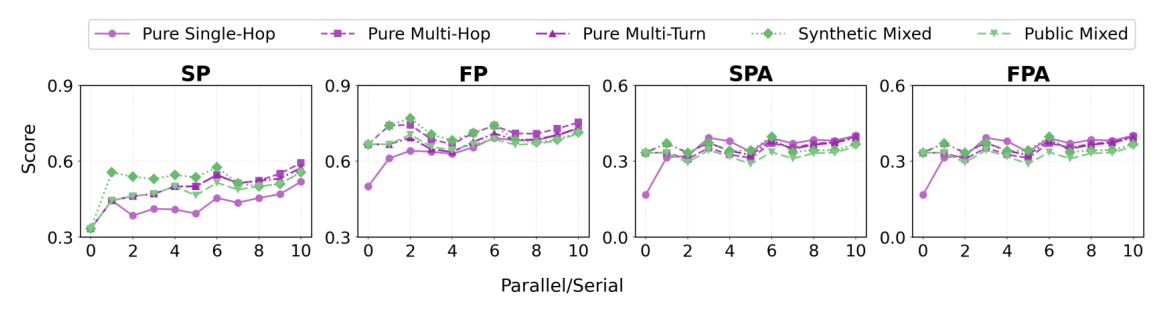
serial 쪽에서는 Synthetic Mixed 가 상대적으로 높고, parallel 이 늘수록 Public Mixed 가 따라붙는다.
저자들은 serial 표본이 작아서 이 그림을 순위의 근거로 쓰지 않고, 공개 벤치마크에 serial 이 드물다는 것을 보이는 용도로만 읽는다고 적는다.
Ablation II: Mixing synthetic complexities
합성 데이터 안에서 한 구조만 쓴 것과 섞은 것을 비교하는데, 어느 쪽이든 vanilla 보다는 높다.
multi-turn 만 쓰면 multi-turn FP 가 44.4% 로 가장 높고 multi-hop SP 는 54.3% 다.
섞으면 multi-hop SP 가 57.1% 로 가장 높지만 multi-turn FP 는 39.6% 로 내려간다.
한 구조로만 학습하면 그 구조에서만 잘한다는 것이 저자들의 정리다.
Ablation III: Efficacy of the Anchor Linkage Mechanism
Anchor 제약을 켠 것과 끈 것으로 multi-turn 궤적을 10개씩 만들어 LLM rubric 으로 점수를 매긴다.
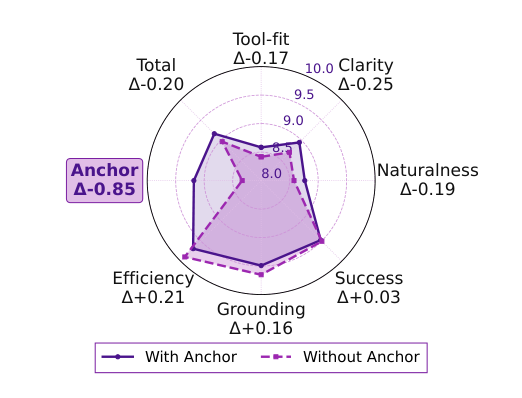
Clarity, Naturalness, Success 같은 일반 항목은 -0.25 에서 +0.21 사이로 거의 안 움직이고, Anchor 항목만 0.85 떨어진다.
제약을 끄면 청소 서비스 예약 다음 턴에 채식 장보기 목록, 그다음 턴에 앱 알림 설정이 나오는 식으로 턴끼리 이어지지 않는 대화가 생기는데, 문장 품질 점수는 그대로 높다.
그래서 턴 간 의존을 보는 점수를 따로 둬야 한다고 저자들은 결론 낸다.
-> 이 ablation 은 데이터 품질 점수만 본다. Anchor 를 켠 데이터로 학습한 모델이 multi-turn 에서 더 잘하는지는 재지 않았다. 표본도 조건당 10개다.
5. Conclusion
UniToolCall 은 도구 모음 구축부터 데이터 합성, 평가까지를 QAOA 한 형식 아래에 놓았다.
공개 코퍼스에 구조를 통제한 합성 궤적을 더한 390K+ 건으로 학습하면 도구 선택과 인자 생성이 모두 오른다는 것이 실험의 결론이다.
앞으로는 실제 도구를 실행하는 동적 환경과 긴 상호작용으로 넓히겠다고 한다.
Limitations 는 번호 없는 절로 따로 있다.
- 컨텍스트 길이가 8192 토큰이라 아주 긴 상호작용이나 큰 도구 출력은 다루지 못한다
- 평가는 고정된 정답 호출과 맞춰 보는 정적 채점이라, 실행 중 오류를 복구하거나 방침을 고치는 능력은 잡지 못한다
- QAOA 로 바꾸면서 원래 벤치마크의 고유한 특성이 빠질 수 있다
- 빠진 인자를 후속 턴에서 물어 채우는 대화형 slot-filling 은 평가 범위 밖이다
6. 지금 관점: 가져다 쓸 부분과 조심해서 읽을 숫자
블로그에서 도구 사용을 학습 데이터 쪽에서 다룬 글은 Toolformer 하나였다.
Toolformer 는 도구 호출이 다음 토큰 예측에 도움이 되는지로 데이터를 걸렀고, 도구는 계산기·검색 같은 몇 개였다.
이 논문은 도구가 2만 개를 넘고 필터는 스키마 검사와 LLM 자기 평가다.
ReAct 식 루프에서 Action 한 줄을 얼마나 정확히 쓰는지만 떼어 내서 본다고 생각하면 위치가 잡힌다.
Observation 을 받고 다음 행동을 고치는 부분은 범위 밖이다.
가져다 쓸 수 있는 것은 모델보다 도구들이다.
코드와 데이터가 공개되어 있고, 흩어진 도구 호출 데이터셋을 한 스키마로 맞추는 변환 규칙, 이름·인자 정규화 후 비교하는 매칭 규칙, 호출·턴·대화 세 단위로 Strict 와 Flexible 을 나눠 보는 채점 방식은 자기 에이전트의 회귀 테스트에 옮기기 쉽다.
Hybrid-20 처럼 정답 도구에 비슷한 오답 도구를 섞어 후보 목록을 만드는 방법도, 도구가 수십 개 붙은 에이전트의 선택 정확도를 재거나 학습 데이터를 만들 때 그대로 쓸 수 있다.
Anchor Linkage 는 멀티턴 합성 데이터를 만들어 본 사람이면 겪는 문제를 다룬다.
턴마다 그럴듯한데 서로 상관없는 대화가 나오고 일반 품질 점수로는 안 걸러진다는 관찰은, 정규식 확인이라는 단순한 장치와 함께 참고할 만하다.
조심해서 읽을 것은 표의 순위다.
93.0% 는 도구 이름을 맞힌 비율이고, 같은 조건에서 인자까지 정확히 맞힌 비율은 31.6% 다.
상용 모델은 reasoning 을 끈 채 이 논문의 프롬프트 형식으로 시험을 봤고, 평가셋의 70% 는 HammerBench single-turn 이다.
데이터셋별 macro 평균으로 바꾸면 single-turn SP 는 81.0% 로 내려간다.
합성 파이프라인이 논문 분량의 큰 부분을 차지하지만 학습 데이터의 0.75% 이고, 2만 건 실험에서 합성을 더했을 때의 차이는 multi-hop SPA +0.9 정도다.
“구조를 통제한 합성 데이터가 성능을 올린다”보다는 “공개 데이터를 한 형식으로 잘 정리해서 작은 모델을 파인튜닝하면 정해진 형식의 도구 선택은 많이 오른다”가 이 실험이 받쳐 주는 범위다.
multi-turn 은 아직 열려 있다.
대화 단위로 전부 맞힌 비율이 거의 모든 모델에서 0.0% 라는 건 지표가 엄격해서이기도 하지만, 실제 에이전트는 호출 하나가 틀리면 그 뒤 상태가 달라진다는 점에서 의미 없는 숫자는 아니다.
다만 이 평가는 정답 궤적과 맞춰 보는 정적 채점이라, 틀린 뒤에 Observation 을 보고 고치는 에이전트의 실제 성공률과는 다른 것을 잰다.
시간 인자 도구, 거절해야 하는 질의, 되물어서 인자를 채우는 대화가 모두 빠져 있다는 것도 같이 기억해 둘 일이다.
Leave a comment