
Multi-Harness RL Paper review
Multi-Harness Reinforcement Learning for Coding Agents: Training Gains and Harness Dependence
https://arxiv.org/abs/2609.04518
Multi-Harness RL은 New York University, University of Washington, University of Southern California, Columbia University, Dimension Gate 소속 저자 6명이 쓴 통제 실험 논문이다. arXiv 에 올라온 논문이다.
코딩 에이전트를 하네스(모델에 파일 열기·편집·테스트 실행 도구를 붙여 주는 실행 틀) 네 개에서 모은 궤적으로 강화학습시키고, 그 이득이 얼마나 되는지와 학습에 안 쓴 하네스로 옮겨 가는지를 잰다.
새 방법을 내놓는 논문은 아니고, 같은 데이터에서 보상 정규화 묶음 하나만 바꿔 비교한 측정 논문이다.
앞에서 본 What Does a Harness Buy는 같은 모델을 하네스 세 개에 넣고 추론 결과를 비교했는데, 이 논문은 같은 질문을 학습 쪽으로 가져간다.
1. Introduction
최근 시스템들은 여러 하네스에서 모은 궤적으로 하나의 정책을 강화학습(RL)시킨다.
그런데 학습에 쓴 하네스에서 점수가 올랐다는 사실만으로는 모델이 문제를 더 잘 풀게 된 것인지, 그 하네스의 도구와 피드백을 더 잘 쓰게 된 것인지 가릴 수 없다.
논문은 이 둘을 나누려면 학습 하네스에서의 이득과 다른 실행 인터페이스로 옮겨 가는 이득을 따로 재야 한다고 본다.
논문이 붙잡는 변수는 보상을 어느 묶음 안에서 정규화하느냐다.
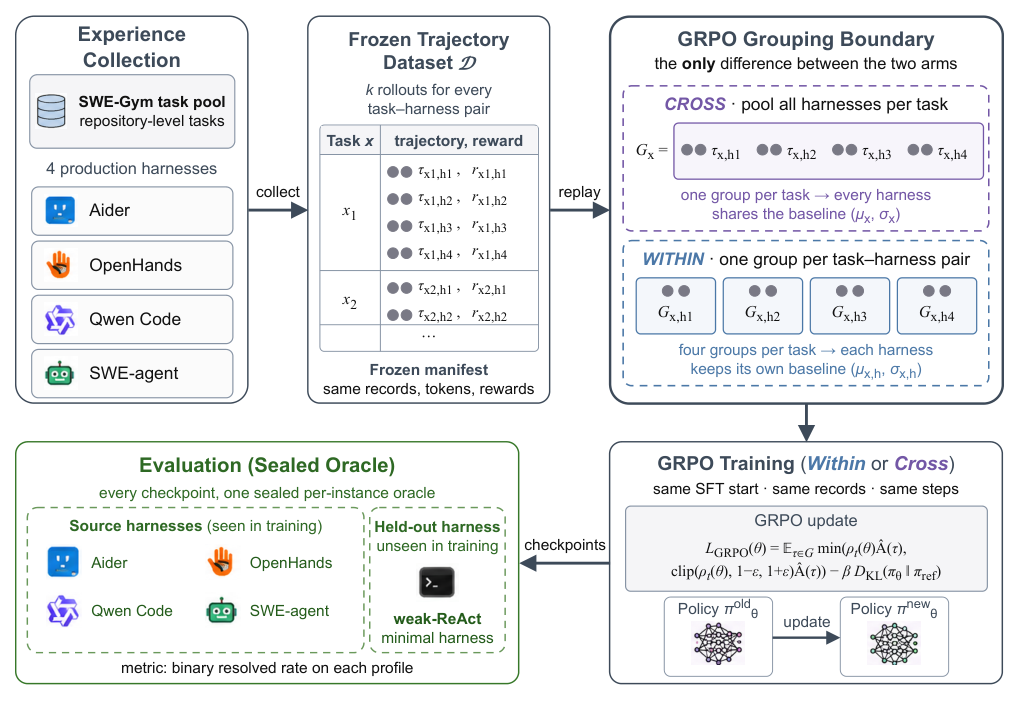
GRPO(같은 과제에 대한 여러 시도를 한 묶음으로 놓고, 묶음 평균보다 잘한 시도를 밀어 주는 정책 최적화 방법)는 같은 궤적을 두고도 묶음을 다르게 잡을 수 있다.
하네스별로 따로 묶으면 Within, 한 과제의 모든 하네스를 합쳐 묶으면 Cross 다.
introduction 에 나온 예시가 차이를 잘 보여준다.
어떤 과제에서 하네스 A 의 시도는 전부 성공하고 하네스 B 의 시도는 전부 실패했다고 하자.
보상이 0 아니면 1 이라, Within 에서는 두 묶음 모두 분산이 0 이 되어 모든 시도의 advantage(묶음 평균 대비 얼마나 잘했는지 나타내는 가중치)가 0 이다.
Cross 에서는 A 의 성공 궤적은 양수, B 의 실패 궤적은 음수를 받는다.
“Pooling thus adds a learning signal without adding training data.”
다만 그 성공 궤적은 A 의 도구와 피드백으로 만들어진 것이라, 여기서 배우는 것이 A 에 특화된 행동일 수 있다.
선행 시스템을 보면 HarnessX 는 하네스를 합쳐 묶고 ClawGym II 는 과제-하네스 쌍 안에서 정규화하는데, 두 시스템은 모은 궤적도 학습 방식도 달라서 묶음 방식의 효과만 떼어 볼 수 없다.
그래서 이 논문은 학습 데이터와 최적화 예산을 고정하고 묶음만 바꾼다.
결과를 먼저 적으면 다음과 같다.
- 학습 하네스 네 개 평균에서 SFT 대비 이득은 Within +0.48pp, Cross +0.77pp 다.
- 학습에 안 쓴 하네스에서는 두 방식 모두 SFT 대비 유의한 향상이 없고, Cross 가 Within 보다 일관되게 낫지도 않다.
- 모델 변형을 평균한 뒤 하네스별 해결률의 가장 높은 값과 가장 낮은 값의 차이는 7.13pp 로, 학습 이득보다 훨씬 크다.
pp 는 퍼센트포인트, SFT 는 성공 궤적을 따라 하도록 지도학습으로 미세조정한 모델이다.
2. Related work
세 갈래로 정리한다.
LLM 에이전트 RL 쪽에서는 SWE-RL, SWE-Gym, Polar, OpenForgeRL 같은 코딩 에이전트 학습 연구와, 여러 하네스를 섞는 Kimi K3·HarnessBandit·HarnessX·ClawGym II 를 든다.
보상 설계와 advantage 추정 쪽에서는 GRPO, Dr. GRPO, DAPO, GiGPO 를 들고, 이 논문은 보상은 그대로 두고 평균과 표준편차를 계산하는 묶음만 바꾼다고 위치를 잡는다.
평가 쪽에서는 Harness-Bench 처럼 모델-하네스 조합에 따라 성공률이 달라진다는 연구를 들고, 이 논문은 그 이동을 RL 학습 뒤에 잰다고 한다.
3. Study Design
RL 변형 두 개가 학습 데이터, 초기 체크포인트, 최적화 설정을 공유하고 보상 정규화만 다르다.
3.1 Policy Optimization and Advantage Estimation
GRPO 목적함수에서 advantage 는 보상에 따라 달라지는 항의 가중치다.
advantage 가 양수면 그 궤적에서 뽑힌 토큰의 확률을 올리고, 음수면 내린다.
0 이면 그 궤적은 보상 항에 기여하지 않고, 기준 정책에서 멀어지지 않게 하는 KL 정규화 항만 남는다.
과제 x, 하네스 h, i 번째 시도의 보상 r 은 0 또는 1 이다.
두 방식의 advantage 는 다음과 같다.
Within 은 평균과 표준편차를 과제-하네스 쌍마다 구하고, Cross 는 과제마다 하네스를 합쳐서 구한다.
궤적과 보상은 같고 정규화 묶음만 다르다.
3.2 Controlled Training Setup
두 RL 변형 모두 같은 Qwen3-8B SFT 체크포인트에서 출발한다.
학습은 offline replay 다.
미리 모아 둔 궤적과 미리 계산한 advantage 를 그대로 재생하고, 학습 도중에 새 궤적을 모으지 않는다.
궤적은 SWE-Gym(실행 가능한 저장소 단위 코딩 과제 모음)에서 Aider, OpenHands, Qwen Code, SWE-agent 네 하네스로 모았다.
1,008개 과제 풀에서, 하네스를 합쳤을 때 성공과 실패가 둘 다 있는 183개 과제만 남겼다.
이렇게 만든 replay 데이터는 5,543 에피소드에서 나온 81,216개 학습 레코드다.
에피소드는 한 과제를 한 하네스로 한 번 푼 시도 하나를 뜻한다.
두 변형은 데이터, 보상, loss mask, optimizer 설정, 1 epoch(81,200 optimizer step)를 공유한다.
비교 대상은 여섯 개다.
- Base: 사전학습된 Qwen3-8B 그대로
- SFT: 네 하네스의 성공 궤적으로 지도 미세조정한 모델, 모든 RL 변형의 출발점
- Within: 과제-하네스 쌍 안에서 정규화
- Cross: 과제 안에서 하네스를 합쳐 정규화
- Coverage-matched: Cross 의 advantage 일부를 0 으로 만들어 0 이 아닌 궤적 수를 Within 과 맞춘 대조군
- Residualized: 하네스별 평균 보상을 먼저 뺀 뒤 Cross 처럼 정규화한 대조군
-> 183개 과제를 고르는 기준이 “합쳤을 때 성공·실패가 섞인 과제”라서, Cross 가 모든 궤적에 0 이 아닌 advantage 를 주는 것은 과제 선택에서 이미 정해진 결과다. 논문도 5.1 에서 이 점을 적어 둔다.
3.3 Evaluation Protocol
평가는 SWE-bench Verified(실제 GitHub 이슈를 고치는 과제 중 사람이 검수한 500개)로 하고, 학습 과제와 겹치지 않는다.
하네스는 학습에 쓴 네 개(source)와 학습에서 뺀 weak-ReAct(held-out) 하나다.
weak-ReAct 는 저자들이 직접 만든 단일 루프 ReAct 구현으로, 도구가 최소한만 붙어 있다.
채점은 sealed oracle 이 한다.
에이전트가 실행 중에 볼 수 있는 피드백 테스트와 분리된 숨은 테스트로, 다섯 하네스 모두 같은 테스트로 패치를 채점한다.
지표는 avg@k 다.
과제당 k 번 시도해서 과제별 성공률을 구하고, 그걸 과제 전체에서 평균한다.
차이는 과제 단위로 짝지어 구하고, 과제를 재표집하는 bootstrap 으로 95% 신뢰구간(CI)을 붙인다.
인프라 오류로 채점이 안 된 시도는 분모에서 뺀다.
4. Performance and Portability
source 하네스에서의 이득, held-out 하네스로의 이전, 행동 분포 순서로 본다.
4.1 Training Gains and Harness Dependence
아래 그림은 SWE-bench Verified 에서 모델 변형 여섯 개를 source 하네스 네 개에 넣고 과제당 2회 시도(avg@2)로 잰 해결률이다.
시도한 에피소드는 모두 24,000개다.
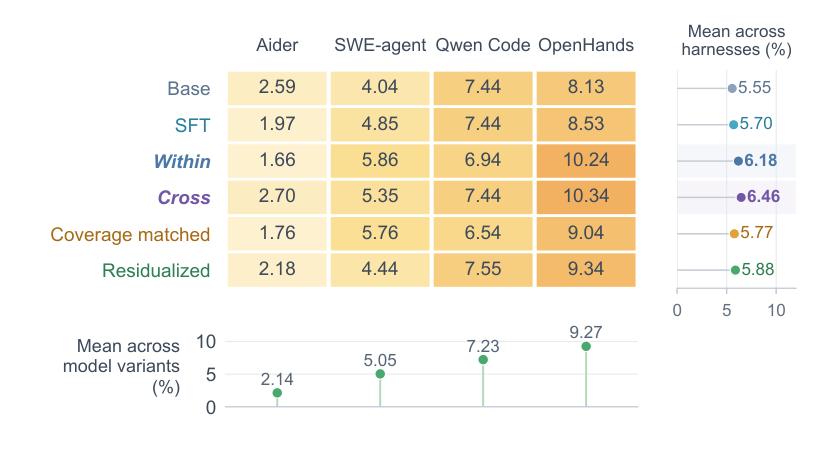
모델별 평균(오른쪽)은 Base 5.55% 에서 Cross 6.46% 까지 0.91pp 범위에 들어 있다.
하네스별 평균(아래)은 Aider 2.14% 에서 OpenHands 9.27% 까지 7.13pp 벌어진다.
SFT 대비 이득은 Within +0.48pp, Cross +0.77pp 다.
Cross−SFT 의 95% CI 는 [+0.03, +1.52] 로 0 을 겨우 넘지만, 다섯 개 비교에 대한 Bonferroni 보정(여러 번 비교할 때 우연히 유의해지는 것을 막으려고 구간을 넓히는 보정)을 한 99% CI 는 [−0.21, +1.75] 로 0 을 포함한다.
-> 칸별로 보면 이득이 고르지 않다. OpenHands 열은 SFT 8.53 에서 Within 10.24, Cross 10.34 로 오르는데, Aider 열에서 Within 은 1.66 으로 SFT(1.97)와 Base(2.59)보다 낮고, Qwen Code 열은 7.44 에서 거의 안 움직인다. 평균 이득의 대부분이 OpenHands 한 열에서 나온다.
-> 절대 해결률이 2~10% 대다. 500개 과제에서 1pp 는 과제 5개 분량이라, 이 표의 칸 하나하나를 비교하기엔 숫자가 작다.
4.2 Portability to the Held-Out Harness
학습에 안 쓴 weak-ReAct 에서의 결과다.
Main results
과제당 8회 시도에서 SFT 대비 이득은 Within −0.03pp, Cross +0.13pp 이고 둘 다 95% CI 가 0 을 포함한다.
이 논문의 주 비교인 Cross−Within 은 +0.25pp, 95% CI [−0.48, +1.02] 다.
아래 그림 (a)는 여섯 변형 전부를 weak-ReAct 에서 과제당 4회 시도로 잰 해결률이고, (b)는 5장에서 다룰 advantage 진단이다.
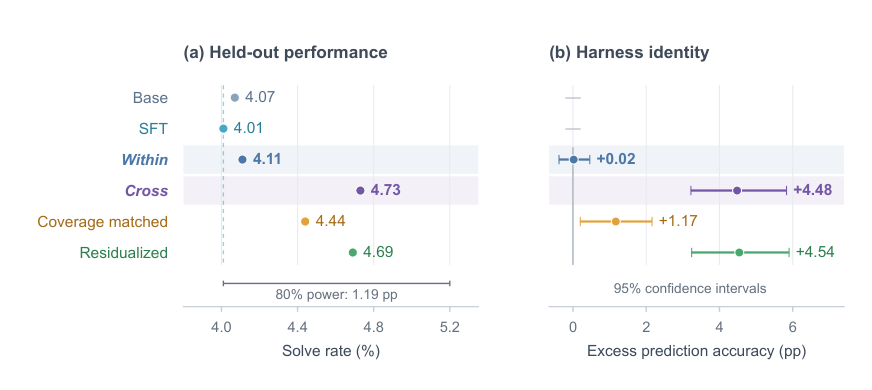
(a)에서 여섯 변형은 4.01%(SFT)에서 4.73%(Cross) 사이에 있다.
그림 아래 자는 이 평가가 80% 검정력으로 잡아낼 수 있는 가장 작은 차이가 1.19pp 라는 표시인데, 여섯 변형의 전체 범위(0.72pp)가 그보다 좁다.
계획한 짝 비교는 전부 95% CI 가 0 을 포함한다.
논문은 이 구간들이 작은 이득과 작은 손실 모두와 양립하므로, 두 학습 방식이 동등하다는 결론도 내릴 수 없다고 적는다.
-> SFT−Base 도 held-out 에서 −0.07pp 다(Table 6). 성공 궤적으로 지도학습한 것부터 weak-ReAct 에서는 Base 와 구분이 안 된다.
Sensitivity analyses
평가 예산, 학습 seed, 데이터 갱신 세 가지를 바꿔 본다.
- 시도 횟수를 4회에서 8회로 늘리면, 같은 과제 집합에서 Cross−Within 이 +0.58pp 에서 +0.25pp 로 0 에 가까워진다.
- seed 를 두 개 더 돌리면 Cross−Within 이 seed 별로 +0.62, +0.05, −0.20pp 로 부호가 바뀐다. 세 seed 평균은 +0.16pp, 95% CI [−0.41, +0.72] 다.
- 같은 방식 안에서 seed 간 가장 높은 값과 가장 낮은 값의 차이가 Within 0.45pp, Cross 0.42pp 로, 두 방식 사이 평균 차이 0.16pp 보다 크다.
- 학습 중간에 궤적을 한 번 새로 모은 Cross 변형은 offline Cross 대비 +0.13pp, 95% CI [−0.85, +1.10] 로 유의한 차이가 없다.
첫 seed(17)만 봤다면 Cross 가 0.62pp 앞선다고 읽었을 텐데, seed 를 늘리니 방향이 뒤집히는 경우가 나왔다.
이 절의 마지막 문장은 다음과 같다.
“The held-out results leave the transfer of the observed source-harness gains unresolved under either normalization rule, with no consistent advantage from pooling rewards.”
4.3 Action Distributions Across Harnesses
해결률에서 본 하네스 의존성이 도구 사용 패턴에도 나타나는지 본다.
규칙 기반 파서가 assistant 턴마다 search, inspect, edit, test, submit 같은 주 행동 라벨을 하나 붙이고, 에피소드 안에서 각 라벨의 비율을 구해 과제 평균을 낸다.
분포끼리는 JSD(Jensen–Shannon divergence, 두 분포가 얼마나 다른지 재는 값으로 0 이면 같다)로 비교한다.
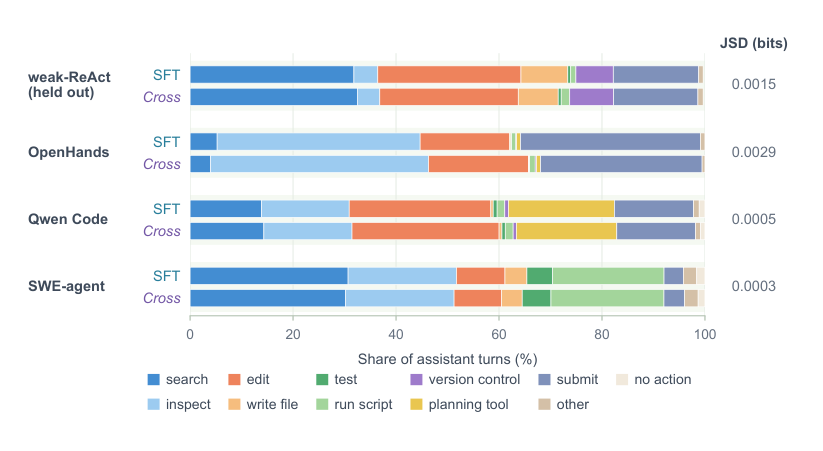
같은 하네스 안에서 SFT 와 Cross 의 JSD 는 0.0003~0.0029 bits 다.
같은 모델을 다른 하네스에 넣었을 때의 JSD 는 0.17~0.35 bits 다.
하네스 사이 차이 중 가장 작은 값도 SFT-Cross 차이 중 가장 큰 값의 59배 이상이다.
그림으로 보면 OpenHands 에서는 inspect 와 submit 이, SWE-agent 에서는 search 와 run script 가, Qwen Code 에서는 planning tool 이 큰 비중을 차지한다.
Aider 는 로그가 도구 호출 없는 일반 대화 형식이라 이 분석에서 빠졌다.
논문은 이 분석의 범위도 적어 둔다.
Within 과 Cross 를 비교한 것이 아니고, 개별 행동이 문제 해결에 도움이 됐는지도 재지 않는다.
-> 행동 비율을 정하는 쪽은 RL 81,200 step 보다 하네스가 내주는 도구 목록과 프롬프트다. 다만 턴당 라벨 하나만 붙이는 파서라 “편집 후 테스트” 같은 복합 명령은 edit 으로만 잡힌다. 부록에 따르면 수작업 점검에서 160턴 중 11턴이 잘못 라벨됐다.
5. Analysis of Advantage Estimates
held-out 성능 차이는 작았지만, 두 방식이 만드는 학습 신호 자체는 측정 가능하게 다르다.
5.1 Effects of Cross-Harness Normalization
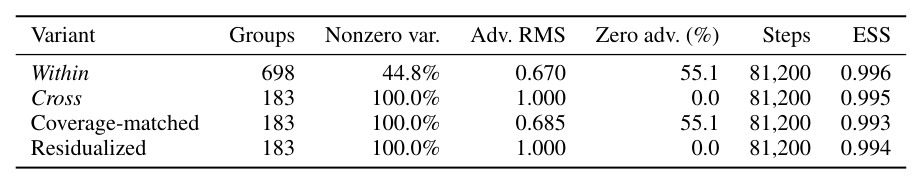
아래 표는 고정된 학습 데이터(183개 과제)에서 RL 변형 네 개의 정규화 묶음 수, 보상 분산이 0 이 아닌 묶음 비율, advantage 가 0 인 궤적 비율을 정리한 것이다.
Nonzero advantages
Within 에서는 과제-하네스 묶음 698개 중 44.8% 만 성공과 실패가 섞여 있고, 전체 궤적의 55.1% 가 advantage 0 을 받는다.
Cross 에서는 과제 묶음 183개가 전부 섞여 있어서 모든 궤적이 0 이 아닌 advantage 를 받는다.
두 방식 모두 궤적 전체를 재생하지만, Within 에서는 절반 넘는 궤적이 보상 항에 기여하지 않는다.
Harness identity
합쳐서 정규화하면 하네스 사이의 평균 보상 차이가 advantage 에 남는다.
어떤 과제에서 한 하네스의 평균 보상이 전체 평균보다 높으면, 그 하네스의 궤적은 Cross 에서 평균적으로 양의 advantage 를 받는다.
논문은 이걸 advantage 숫자 하나만 보고 그 궤적을 만든 하네스를 맞히는 분류기로 잰다.
학습 과제와 테스트 과제를 분리하고, 과제 안에서 하네스 라벨을 섞었을 때의 정확도를 뺀 초과 정확도를 보고한다.
Cross 는 +4.48pp(95% CI [+3.22, +5.83]), Within 은 +0.02pp 다(Figure 3(b)).
-> 부록 A.1 을 보면 학습 데이터에서의 하네스별 성공률이 Aider 6.9%, SWE-agent 9.8%, Qwen Code 20.9%, OpenHands 27.0% 다. Cross 는 OpenHands 궤적을 평균적으로 더 밀어 주는 구조고, 4.1 에서 이득이 OpenHands 열에 몰린 것과 방향이 맞는다. 다만 Within 도 OpenHands 에서 비슷하게 올랐으니(10.24) 이것만으로 설명되지는 않는다.
5.2 Ablations of the Pooled Advantage
Cross 의 두 성질, advantage 가 붙는 궤적 수와 하네스 간 보상 차이 중 어느 쪽이 held-out 성능에 영향을 주는지 보려고 대조군 둘을 돌렸다.
Coverage matching
Cross 의 advantage 중 55.1% 를 0 으로 만들어 Within 과 개수를 맞춘다.
그런데 이 조작은 하네스 예측 초과 정확도도 +1.17pp 로 같이 낮춘다.
held-out 해결률은 Cross 대비 −0.28pp(95% CI [−1.27, +0.65])로 유의한 변화가 없다.
Reward residualization
다른 과제들에서 구한 하네스별 평균 보상을 먼저 빼고 정규화한다.
그런데 이 평균을 1,008개 과제 풀 전체에서 구했고, 그 풀의 과제 대부분은 모든 하네스에서 실패한 것들이다.
학습에 쓴 183개 과제와 분포가 달라서 하네스 간 차이를 지우지 못했다.
초과 정확도는 +4.54pp 로 Cross(+4.48pp)와 거의 같고, held-out 해결률 차이는 −0.03pp(95% CI [−1.03, +0.95])다.
논문은 두 대조군이 겨냥한 성질을 같이 바꾸거나 덜 바꿨다고 정리한다.
그래서 각 성질이 이전 성능에 얼마나 기여하는지는 미해결로 남긴다.
-> 대조군 두 개가 모두 의도대로 작동하지 않았다는 걸 본문에 그대로 적어 두었다. 이 절에서 얻을 수 있는 건 “어느 성질 때문인지 모른다”까지다.
6. Discussion and Conclusion
source 하네스에서 multi-harness RL 은 두 정규화 방식 모두 SFT 대비 작은 이득을 냈고, 평가 하네스에 따른 차이는 그보다 훨씬 컸다.
하네스를 합쳐 정규화하면 같은 경험이 정책 갱신에 기여하는 방식은 달라지지만, held-out 하네스에서 일관된 우위는 없었다.
논문은 정책 최적화와 실행 하네스를 에이전트 성능의 공동 구성 요소로 다뤄야 하고, source 하네스 이득과 그 이전 가능성은 따로 평가해야 하는 별개의 결과라고 말한다.
후속으로는 궤적을 반복해서 다시 모으는 설정과, held-out 하네스를 돌아가며 바꾸는 설정을 든다.
Limitations
원문에 번호 없는 Limitations 절이 따로 있다.
- 고정된 multi-harness 궤적에 조건부인 결과다. 하네스를 여러 개 쓰는 것 자체의 효과는 단일 하네스 학습과 맞춰 비교해야 하는데 이 설계 밖이다.
- offline replay 라서, 정책이 바뀌면 모이는 궤적도 바뀌는 online 학습의 상호작용은 다루지 않는다.
- 인과 해석은 정규화 개입에만 해당한다. 하네스는 도구·관찰·프로토콜이 한 덩어리라 하네스 간 차이가 어느 구성 요소 때문인지는 알 수 없다.
- advantage 진단과 행동 분포 진단은 일반적인 문제 해결 능력 향상과 특정 인터페이스 적응을 분리하지 못한다.
- 평가는 저장소 단위 코드 수정의 숨은 테스트 통과 여부만 본다. 유지보수성이나 상호작용 효율은 범위 밖이다.
- 절대 해결률이 낮은 모델 설정에서 나온 결과라, 성능이 높은 에이전트나 다른 도메인에 적용되는지는 검증하지 않았다.
-> held-out 하네스가 weak-ReAct 하나다. 도구가 최소한인 하네스로의 이전만 본 것이라, 도구가 풍부한 다른 하네스(예를 들어 네 개 중 하나를 빼고 학습)에서는 다를 수 있다. 저자들도 후속 과제로 적었다.
7. 지금 관점: 하네스를 바꾸는 것과 모델을 학습시키는 것 비교
What Does a Harness Buy는 같은 모델을 세 하네스에 넣고 같은 설정을 한 번 더 돌려 잡음 크기를 쟀다.
이 논문도 비슷한 태도로 측정한다.
부록 B.2 에 따르면 같은 평가를 다시 돌렸을 때 과제 단위 결과의 약 6% 가 달라졌고, 에이전트가 실행 중에 본 테스트 결과와 숨은 테스트 채점이 2.58% 어긋났는데 어긋난 건 전부 실행 중 결과가 낙관적인 쪽이었다.
held-out 하네스가 ReAct 루프 하나짜리 구현이라는 점도 이어진다.
Harness Benefit이 스킬·프롬프트 갱신에서 득을 보는 능력을 따로 쟀다면, 이 논문은 가중치 갱신에서 얻는 득이 하네스를 넘어가는지를 쟀다.
에이전트를 만드는 입장에서 지금 가져다 쓸 수 있는 건 학습 방법보다 측정 절차 쪽이다.
학습 방식 A 와 B 를 비교할 때 seed 하나, 시도 4회로 0.6pp 차이를 보고 결론 내리면 안 된다는 걸 이 논문의 seed 실험이 보여준다.
방식 사이 차이보다 같은 방식의 seed 간 차이가 더 컸다.
미세조정한 모델을 평가할 때 학습에 쓴 하네스와 안 쓴 하네스를 나눠 보고하는 것, 에이전트가 볼 수 있는 테스트와 채점 테스트를 분리하는 것, 채점 불가 시도를 실패와 구분하는 것도 그대로 따라 할 수 있다.
8B 급 모델을 8만 step RL 시켜 얻은 평균 이득이 1pp 미만이고 하네스를 바꾸면 7pp 가 움직였으니, 이 조건에서는 학습 설정을 손보기 전에 하네스부터 비교해 보는 편이 싸다.
그대로 받아들이기 어려운 부분도 분명하다.
모델이 Qwen3-8B 하나이고 해결률이 2~10% 대라, 해결률이 수십 퍼센트인 모델에서도 “하네스 차이가 학습 이득보다 크다”가 유지되는지는 이 논문으로 알 수 없다.
RL 도 고정 데이터를 한 번 재생한 것이라, 궤적을 계속 새로 모으는 online RL 의 이득을 낮게 잡았을 가능성이 있다.
그리고 held-out 결과는 “이전되지 않는다”가 아니라 “이 평가의 검정력(약 0.8~1.4pp)으로는 차이를 못 잡았다”로 읽어야 한다.
Cross 와 Within 중 무엇을 쓸지에 대해서도 이 논문은 답을 주지 않는다.
Cross 는 모든 궤적에 학습 신호를 주는 대신 어느 하네스에서 나온 궤적인지가 advantage 에 섞여 들어가는데, 그게 held-out 성능에 득인지 실인지는 대조군이 가르지 못했다.
?? 하네스 네 개의 궤적을 섞어 학습한 것 자체가 단일 하네스 학습보다 나은지는 이 설계에서 비교하지 않아서 알 수 없다.
Leave a comment