
Memory Trust Gap Paper review
The Memory Trust Gap: Reliance on Stale Evidence Across Model Scales in LLM Agents
https://arxiv.org/abs/2609.01852
Memory Trust Gap 은 PayPal AI 에서 만든 벤치마크와 그 위에서 돌린 실험 논문이다.
저자는 2명이고 arXiv 에 올라온 논문이다.
메모리에 저장된 값이 이미 낡았는데도 에이전트가 그 값대로 행동하는 현상을, 모델 크기와 메모의 겉모습(라벨, 날짜, 출처, 위치)을 바꿔 가며 잰다.
앞에서 본 Zep에서는 낡은 사실을 지우지 않고 타임스탬프로 무효화했는데, 이 논문은 그렇게 날짜가 붙은 메모를 모델이 읽을 때 무슨 일이 생기는지를 본다.
1. Introduction
장기 메모리가 있는 에이전트는 “늘 타는 항공사”, “기본 회의실” 같은 것을 기억해 두고 사용자 대신 행동한다.
문제는 저장된 사실이 낡았을 때다.
늘 타던 항공사가 바뀌었는데 에이전트가 메모리를 읽고 그대로 예약하면, 지금 컨텍스트에 맞는 답이 들어 있어도 틀린 행동을 한다.
앞선 연구들은 에이전트가 갱신된 정보를 못 따라간다는 것, 주어진 컨텍스트가 모델이 원래 알던 지식을 덮어쓸 수 있다는 것까지는 보였다.
남은 질문은 모델 크기가 달라지면 이 피해가 언제 시작되는지, 메모의 어떤 겉모습이 피해를 일으키는지다.
질문은 셋으로 나뉘고 각각 결과 절이 하나씩 있다.
- harm: 낡은 메모리가 실제로 손해를 만드는가 (4장)
- trigger: 메모의 어떤 특징이 낡은 값을 따르게 만드는가 (5장)
- mitigation: 무엇으로 줄일 수 있는가 (6장)
contribution 은 “메모리 없음”의 두 가지 뜻을 갈라놓은 2-suite 벤치마크, 세 질문 각각의 결과, 그리고 외부 데이터셋·다른 모델 계열·대조 실험으로 한 검증이다.
contribution 에 이런 문장이 있다.
“the Trust Gap is over-trust rather than confusion”
모델이 헷갈려서 아무 값이나 고르는 것과는 다르고, 저장된 값을 믿고 고른다는 뜻이다.
2. Related Work
가장 가까운 선행 벤치마크는 STALE 이다.
에이전트가 무효화된 메모리대로 행동하는지를 400개 시나리오로 재고(가장 잘한 모델이 55.2%), Qwen3.5-9B/27B 한 쌍을 포함한다.
낡은 메모리가 해롭다는 건 STALE 이 이미 보였고, 이 논문은 거기에 모델 크기에 따른 변화를 더한다고 적는다.
knowledge conflict(컨텍스트와 모델 내부 지식, 또는 컨텍스트끼리 충돌하는 상황) 쪽에서는 ConflictBank 가 큰 모델이 충돌 증거에 더 취약할 수 있다고 이미 보고했다.
이 논문은 같은 계열 0.6B→8B 시리즈 위에서 4개 특징의 factorial 과 크기 간 interaction 검정을 같이 돌린 조합이 없었다는 점을 차이로 든다.
3. Experimental Setup
모든 실험이 같은 벤치마크, 같은 4개 메모리 조건, 같은 지표를 쓴다.
3.1 Benchmark and 2 Suites
“메모리 없음”이 두 가지 뜻을 갖기 때문에 벤치마크를 둘로 나눈다.
Benefit suite (A)
저장된 사실 없이는 못 푸는 과제다(“늘 타는 항공사로 예약해줘”).
현재 컨텍스트가 없으니 no_memory 기준선은 찍기 수준(3지선다, 약 0.33)에 붙고, 낡은 저장값을 얼마나 믿는지를 본다.
Safety suite (B)
모든 조건에서 권위 있는 도구가 맞는 값을 갖고 있어서 no_memory 기준선은 천장에 붙는다.
그래서 메모리를 넣었을 때 정확도가 메모리 없을 때보다 내려가면 그게 순손해(net harm)다.
Safety suite 의 회의실 예약 시나리오 하나를 네 조건으로 펼친 표다.
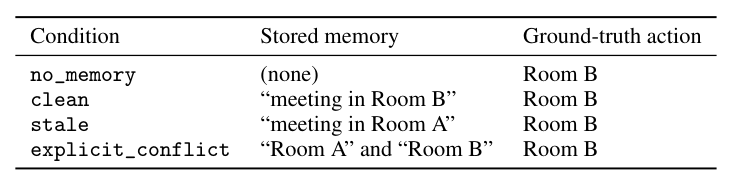
도구 값과 저장된 메모리는 둘 다 고정된 프롬프트 텍스트로 들어간다.
도구 값은 날짜가 붙은 [CURRENT CONTEXT] 항목으로 적혀 있고 실제 도구 호출은 일어나지 않아서, 고정된 컨텍스트를 읽고 행동을 고르는 시점만 잰다.
-> “에이전트” 실험이라기보다는 메모리와 도구 결과가 이미 프롬프트에 깔린 뒤의 한 스텝을 잰 것으로 읽어야 한다.
벤치마크 v1 은 base scenario 300개(suite 당 150개)다. 56개짜리 파일럿을 생성기로 늘려 SHA-256 으로 고정했고, suite 당 150개는 33개 template family(같은 템플릿에 슬롯 값만 다른 묶음)에 걸쳐 있다.
300개 전부를 저자들이 직접 읽고 정답 행동이 하나로 정해지는지 확인했고, 벤치마크와 하네스 공개는 내부 승인 대기 중이다.
3.2 Conditions and Scoring
조건은 넷이다.
- no_memory: 기준선. Benefit 에서는 바닥, Safety 에서는 천장
- clean: 메모리가 정답과 일치. 상한
- stale: 메모리에 옛 값이 있음. 피해 조건
- explicit_conflict: 옛 값과 맞는 값이 둘 다 저장돼 있음
각 문항은 정해진 형식의 행동 하나를 낸다.
채점은 exact, regex, canonical match 로 하고 LLM judge 는 쓰지 않으며, 선택지 위치에 대한 선호를 없애려고 선택지 3개를 순환시킨 모든 배치에서 채점한 뒤 평균한다.
부록 A 를 보면 모델은 Qwen3 0.6/1.7/4/8B 이고 thinking 은 끈 상태, greedy decoding 이다.
A100 40GB 를 MIG 슬라이스로 쪼개 쓴 것이 0.6~8B 범위를 고른 이유 중 하나로 적혀 있다.
3.3 Metrics
두 양을 따로 보고한다.
- reliance = P(모델의 행동 = 낡은 값). 행동을 잰다
- Δmem = acc(조건) − acc(no_memory). 시나리오별로 짝지은 결과 차이
둘을 나눈 이유는 reliance 가 1.0 에 가까워도 Δmem 은 기준선에 따라 달라져서다.
기준선이 높은 모델일수록 낡은 값을 믿었을 때 잃을 정확도가 많다.
Safety suite 에서는 ρ* 도 보고한다.
ρ* 는 stale Δmem 의 신뢰구간 상한이 0 아래로 내려가는 첫 번째 trap level 이다.
통계 단위는 base scenario 이고, 구간은 전부 시나리오 id 위의 95% percentile bootstrap 이다.
4. Question 1: Over-trust and net harm
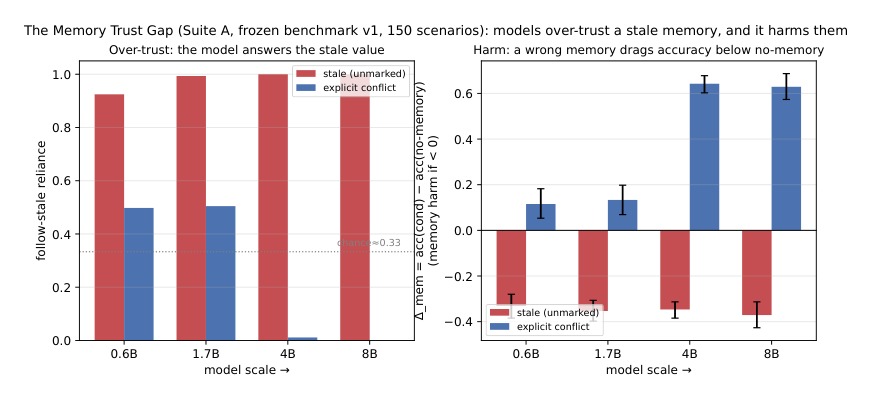
낡은 값을 믿는 건 모든 크기에서 나타나고, 그게 순손해로 이어지는지는 메모가 어떻게 보이는지에 달려 있다.
4.1 Over-Trust Is Universal
Benefit suite 에서 stale reliance 는 0.6/1.7/4/8B 순으로 0.92 / 0.99 / 1.00 / 1.00 이다.
Δmem 은 −0.33 / −0.35 / −0.35 / −0.37 이고 신뢰구간 상한이 전부 0 아래다.
no_memory 정확도가 0.35~0.37 로 찍기 수준(0.33)을 구간에 포함하니, suite 가 의도대로 바닥에 붙어 있다는 확인도 된다.
-> 찍으면 0.33 인데 stale 에서는 그보다 0.33~0.37 낮다. 거의 0 점이라는 얘기고, reliance 1.00 과 맞아떨어진다.
explicit_conflict 가 크기 차이를 드러낸다.
맞는 값이 낡은 값 바로 옆에 저장돼 있어도 reliance 는 0.50 / 0.50 / 0.01 / 0.00 이다.
작은 두 모델은 절반은 낡은 값을 고르고, 큰 두 모델은 거의 안 고른다.
다만 Benefit suite 의 explicit_conflict 는 no_memory 에 없는 현재 값을 주는 조건이라 여기 Δmem 은 순손해 지표로 쓸 수 없고, 순손해는 Safety suite 에서 본다.
4.2 Net Harm in the Safety Suite: The Trap Sweep
Safety suite 는 no_memory 가 모든 칸에서 0.98 이상이라, Δmem 이 음수면 도구 값을 두고 낡은 메모를 따랐다는 뜻이다.
두 suite 의 주 결과 표와 Safety suite 의 trap sweep 그래프다.
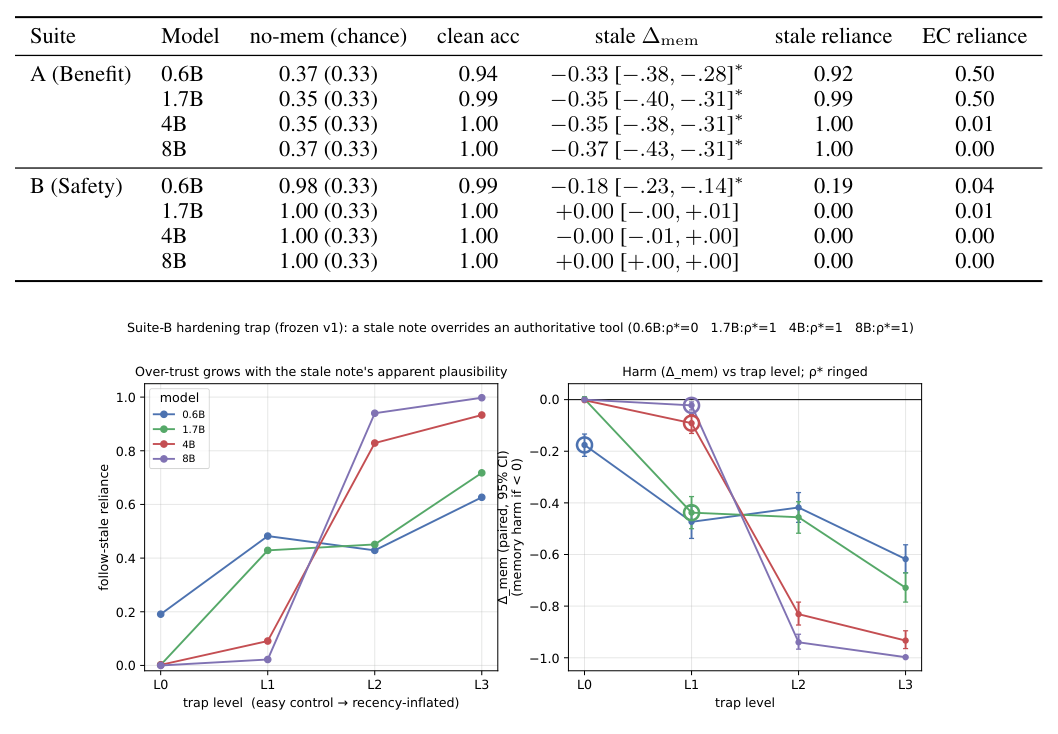
기본 stale 조건에서는 0.6B 만 손해를 보고(Δmem −0.18, reliance 0.19) 1.7B 이상은 reliance 0.00 이다.
도구 값이 있고 메모가 평범하게 낡아 보이면 큰 모델은 메모를 안 따른다.
trap sweep 은 낡은 메모를 L0 에서 L3 까지 점점 그럴듯하게 만든다(예: 메모의 날짜를 더 최신으로 보이게 함).
-> L1, L2, L3 각각이 정확히 무엇을 바꾸는지는 원문에서 확인 못 함. “e.g. inflating its apparent recency” 가 설명의 전부다.
ρ* 는 0 / 1 / 1 / 1 이다.
0.6B 는 L0 부터, 나머지 셋은 L1 부터 유의한 순손해가 나서, 이 문턱값은 0.6B 와 나머지를 가를 뿐 크기 순서를 만들지는 않는다.
높은 레벨에서는 순서가 뒤집힌다.
L3 에서 8B 는 reliance 1.00, Δmem −1.00 이고, L2 에서 4B 는 reliance 0.83 이다.
같은 L3 에서 0.6B 는 0.63, 1.7B 는 0.72 다(Table 3).
부록의 실패 사례를 보면 Qwen3-8B 가 캘린더는 Room B, 더 최신 날짜가 붙은 낡은 메모는 Room A 인 상황에서 ACTION: Room A 를 낸다.
5. Question 2: Which memory feature triggers over-trust, and does it scale?
어떤 특징이 낡은 값을 따르게 만드는지는 모델 크기에 따라 달라진다.
5.1 The Memory Feature Factorial
낡은 메모의 겉모습 네 가지를 각각 켜고 끄는 2×2×2×2 factorial 을 Safety suite 에서 돌린다(시나리오당 16칸).
- label: [NOTES] 라벨 아래 둠 / 라벨 제거
- recency: 현재 항목보다 옛 날짜 / 더 최신 날짜
- authority: 평범한 출처 / 공식처럼 보이는 출처
- position: 낡은 메모를 마지막에 / 처음에
뒤쪽이 trap-on(reliance 를 올릴 거라고 가정한 설정)이고, main effect 는 그 특징이 켜진 8칸의 평균 reliance 에서 꺼진 8칸의 평균을 뺀 값이다.
Safety suite 에서 네 특징의 main effect 를 모델 크기별로 잰 표다.
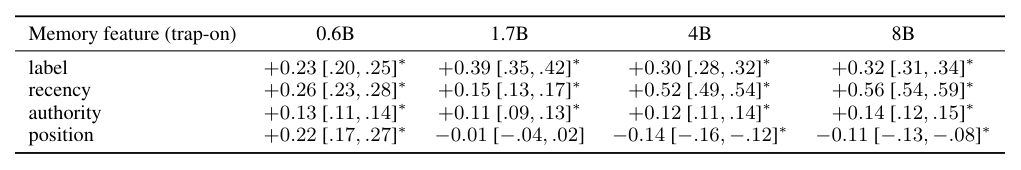
패턴이 넷으로 갈린다.
- label 제거: 모든 크기에서 reliance 가 오른다(+0.23~+0.39)
- recency: 4B/8B 에서 훨씬 크다(+0.52, +0.56 대 +0.26, +0.15)
- authority: 약하고 크기에 따라 거의 안 변한다(+0.11~+0.14)
- position: 0.6B 는 +0.22, 4B/8B 는 −0.14, −0.11 로 부호가 바뀐다
저자들은 이 결과가 관찰 가능한 특징을 조작했을 때의 행동 효과이고 내부 메커니즘을 밝힌 건 아니라고 적는다.
main effect 는 나머지 세 특징에 대해 평균한 값이라 특징끼리의 interaction 은 가려질 수 있고, 그건 다 분석하지 않았다고도 한다.
5.2 Direct Cross-Size Interaction Tests
모델별 신뢰구간이 겹치는지 안 겹치는지만으로는 interaction 이 있다고 할 수 없어서, 크기 간 짝지은 차이를 bootstrap 한다(Table 6).
- recency: 8B − 0.6B = +0.302, 큰 모델 평균 − 작은 모델 평균 = +0.333. 둘 다 유의
- position: 8B − 0.6B = −0.326. 부호 반전이 유의
- authority: interaction 없음
- label: 8B − 0.6B 는 +0.098 로 유의하지만 큰 모델 묶음 대 작은 모델 묶음은 +0.005 로 유의하지 않음
label 은 그래서 크기에 따라 커지는 효과로 보지 않고 모든 크기에 있는 효과로 부른다.
template family 통째로 재표집하는 cluster bootstrap 에서도 유의했던 main effect 는 전부 유의하게 남았다(구간이 1.1~2.2배 넓어짐).
5.3 Dose-Response Deep-Dives
특징 세 개를 연속적으로 바꿔 보는 실험이고, 각각 모델이 그 특징을 읽을 수 있는지 묻는 probe 를 붙였다.
Recency
낡은 메모의 날짜가 현재 항목보다 며칠 앞서거나 뒤지는지에 따른 reliance 그래프다.
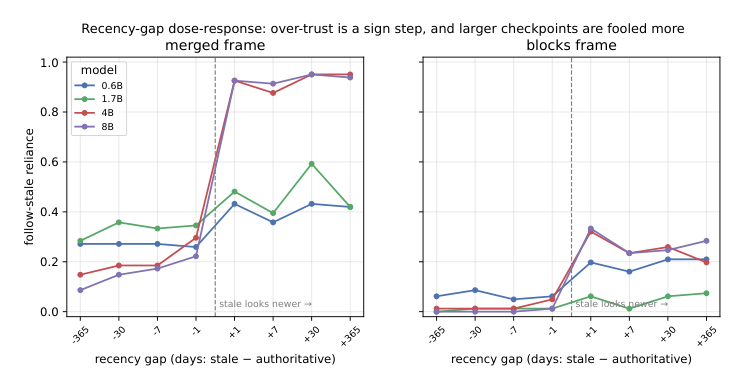
reliance 는 날짜 차이에 따라 서서히 오르지 않고, 낡은 메모가 하루라도 더 최신으로 찍히는 순간 뛴 뒤 포화한다.
날짜를 읽는 probe 에서 큰 모델이 타임스탬프를 더 정확히 읽었고, 그 정확도가 낡은 메모를 따르는 것과 같이 움직였다.
라벨을 되살리면 이 계단이 사라진다.
-> 날짜를 잘 읽는 모델이 “더 최신인 쪽을 따른다”는 규칙을 충실히 적용해서 당하는 모양이다. 틀린 건 모델의 읽기보다 메모에 찍힌 날짜 쪽이다.
?? 그림의 merged frame 과 blocks frame 이 각각 어떤 프롬프트 배치인지 본문에 정의가 없다. blocks frame 쪽이 reliance 가 훨씬 낮은데 이유를 모르겠다.
Source authority and provenance
factorial 의 authority 효과가 약하고 평평한 건 recency 조건들에 대해 평균했기 때문이다.
recency 를 중립으로 고정하면 authority 효과가 작게 있고 모델이 커질수록 커진다.
반대 방향 실험에서는, 사용자가 직접 한 말을 두고 공식처럼 들리는 메모를 따르면 오답인 상황에서, [CURRENT CONTEXT] 라벨을 붙이면 8B 의 reliance 가 0 으로 내려간다.
Intervention comparison
낡은 메모는 그대로 두고 권위 있는 항목에 [AUTHORITATIVE] 표시를 붙이면, +1일 조건에서 reliance 가 4B 는 0.42, 8B 는 0.33 내려간다.
0.6B 는 0.06, 1.7B 는 0.00 이다.
“가장 최신의 권위 있는 출처를 따르라”는 말로 된 규칙은 효과가 거의 없고 어떤 설정에서는 reliance 를 올린다.
6. Question 3: Mitigation is size-dependent
같은 충돌을 세 가지 표현으로 넣어 정확도를 비교한다.
- raw: 낡은 항목과 현재 항목이 표시 없이 둘 다 있음
- metadata: 항목마다 출처와 타임스탬프를 붙임
- representation-oracle: 낡은 항목을 아예 뺌(무엇이 무엇을 대체했는지 미리 처리한 상태)
stale 조건에서 세 표현의 정확도와 raw 대비 이득을 잰 표다.
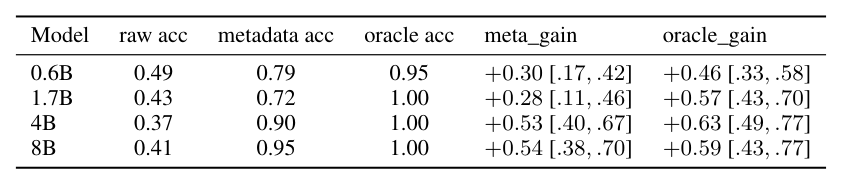
metadata 는 모든 크기에서 정확도를 올린다(+0.30 / +0.28 / +0.53 / +0.54).
정확도 0.90 이상을 회복으로 치면 metadata 로 회복되는 건 4B(0.90)와 8B(0.95)뿐이고, 0.6B 는 0.79, 1.7B 는 0.72 에 머문다.
충돌을 미리 풀어 준 oracle 은 넷 다 회복시킨다(0.95 / 1.00 / 1.00 / 1.00).
-> 0.90 이라는 회복 기준이 어디서 온 숫자인지는 설명이 없다. 4B 가 정확히 0.90 이라 기준을 조금만 올려도 “큰 모델은 회복”이라는 문장이 8B 하나로 줄어든다.
-> raw 정확도가 0.37~0.49 인데 이 raw 가 4장의 어느 trap level 에 해당하는지는 원문에서 확인 못 함.
7. Validation: External, Cross-Family, and Controls
같은 지표 계산을 외부 데이터와 다른 모델 계열, 대조 실험에 돌린다.
External datasets
RGB 와 MisBench 에서 틀린 문서를 따르는 비율(pooled reliance)은 크기에 걸쳐 0.81~0.94 다.
순손해 검증은 더 제한적이어서, closed-book 기준선이 0 이 아닌 건 RGB 뿐이고 거기서 Δmem 은 8B 에서 −0.32(free-text 에서는 −0.37)다.
MisBench 는 모델이 원래 모르는 사실이 대부분이라 reliance 만 잰다.
MisBench 의 문체 6종 실험에서 reliance 는 문체에 따라 크게 안 변하고(모델별 편차 0.19 이하), 캐주얼한 블로그 문체가 8개 칸 전부에서 가장 덜 신뢰받았다.
Cross-family comparison
같은 시나리오에서 Llama-3.2-1B/3B 와 Llama-3.1-8B 의 Benefit suite reliance 는 0.46 / 0.96 / 1.00, Δmem 은 −0.10 / −0.31 / −0.36 이다.
3B/8B 에서 label, recency, authority 효과는 양수, position 효과는 음수다.
Qwen3-0.6B 에서 보였던 양수 position 효과는 재현되지 않아서, 부호 반전은 Qwen 계열에 한정된 결과다.
The failure is not memory-specific
같은 틀린 항목을 [MEMORY], [DOCUMENT], [EARLIER MESSAGE] 세 가지 틀로 넣어 본다.
reliance(memory) − reliance(document) 는 −0.311 / −0.058 / −0.013 / +0.016(ns)이다.
작은 세 크기에서는 문서 틀이 더 신뢰받고 8B 에서는 차이가 없어서, 저자들은 이를 메모리에 한정되지 않는, 낡거나 충돌하는 증거 전반의 문제로 해석한다.
Thinking mode does not remove the gap
0.6B 와 8B 에서 thinking 을 켜 봐도 8B 는 1.000 그대로이고, 0.6B 는 Benefit suite reliance 가 0.924 에서 0.991 로 오히려 오른다.
8. Discussion and Conclusion
모델이 크다고 고르게 안전해지지 않는다.
저자들이 그럴듯하다고 보는 설명은 큰 체크포인트가 메모의 특징을 더 정확히 읽어서, 제대로 읽힌 낡은 타임스탬프는 더 많이 따르고 근거 없는 출처 표시는 더 잘 거른다는 것이다.
다만 이 설명은 인과적으로 분리해 보인 게 아니라고 저자들이 직접 적는다.
메모리 시스템에 대한 함의로는, 라벨을 유지하면 모든 크기에서 reliance 가 줄어든다.
권위 있는 항목을 구조적으로 표시하는 방식은 도움이 되지만 작은 모델은 충돌을 미리 풀어 줘야 한다.
출처의 권위를 올리고 내리는 건 약한 수단이다.
Limitations
- Benefit suite 는 explicit_conflict 에서 순손해를 표현하지 못해서, 순손해 주장은 Safety suite 에만 기댄다
- 채점이 닫힌 선택지와 행동 기반이라 열린 생성으로 일반화하는 데 한계가 있다
- 주 실험의 크기 시리즈가 한 계열이고, 계열×크기 전체 격자는 없다
- 300개 시나리오를 독립된 annotator 가 아닌 저자들이 검토했다
- “권위 있는 도구”는 프롬프트 텍스트이고 실행되는 도구 환경은 없다
- 메모리를 읽는 시점만 쟀고 write/update/retrieve 를 도는 전체 시스템은 보지 않았다
모델 크기에 대해서는 이렇게 적는다.
“Model size here is an observational index over separately-trained checkpoints”
0.6B 와 8B 는 데이터, 튜닝, 구조가 다 다르게 따로 학습된 체크포인트라, 크기 하나만 바꾼 실험으로 읽으면 안 된다.
9. 지금 관점: 메모리에 날짜를 붙이면 안전해질까
Zep은 사실마다 타임스탬프를 달아 언제 참이었는지를 남겼고, Mem0는 쓰는 시점에 UPDATE·DELETE 로 옛 값을 정리했다.
이 논문의 6장에 대어 보면 Zep 식은 metadata 표현, Mem0 식은 representation-oracle 쪽에 가깝다.
4B/8B 는 날짜와 출처만 붙여도 0.90 이상으로 돌아왔고, 0.6B/1.7B 는 낡은 항목을 아예 빼 줘야 돌아왔다.
작은 모델로 에이전트를 돌린다면 읽는 모델이 날짜를 보고 알아서 고르기를 기대하기보다, 쓰는 시점이나 프롬프트 조립 시점에 충돌을 풀어서 하나만 넘기는 쪽이 이 결과와 맞는다.
Memory Portability에서 저장소는 그대로인데 모델을 바꾸면 행동이 달라졌던 것처럼, 여기서도 같은 메모가 모델 크기에 따라 다르게 읽힌다.
지금 가져다 쓸 수 있는 건 프롬프트 조립 쪽 이야기다.
메모리에서 꺼낸 항목과 도구가 방금 돌려준 값을 한 덩어리로 섞지 말고 라벨을 유지하는 것, 권위 있는 값에 구조적인 표시를 붙이는 것은 비용이 거의 안 든다.
“최신 출처를 우선하라”는 문장을 시스템 프롬프트에 넣는 건 이 실험에서는 효과가 거의 없었다.
그리고 메모에 찍히는 날짜가 무엇의 날짜인지를 따져 볼 필요가 있다.
큰 모델은 날짜를 잘 읽고 더 최신인 쪽을 따랐으니, 옛 값을 다시 요약하거나 옮겨 적으면서 기록 시각이 새로 찍히는 구조라면, 이 논문의 L3 조건과 같은 상황을 시스템이 스스로 만들게 된다.
-> 다만 실제 메모리 시스템에서 낡은 값에 더 최신 날짜가 붙는 일이 얼마나 자주 생기는지는 이 논문이 재지 않았다. trap sweep 은 일부러 만든 조건이다.
그대로 받아들이기 어려운 부분도 분명하다.
모델이 8B 까지라, API 로 쓰는 큰 모델에서 recency 효과가 더 커지는지, 어느 크기부터 꺾이는지는 이 데이터로 알 수 없다.
도구 값은 프롬프트에 적힌 텍스트이고, 3지선다 행동 하나로 채점한다.
여러 스텝을 도는 에이전트가 중간에 도구를 다시 호출해 확인할 수 있는 환경이라면 숫자가 달라질 수 있다.
벤치마크도 아직 공개 전이라 다른 모델로 재현해 볼 수 없다.
position 부호 반전처럼 Llama 에서 재현되지 않은 결과도 있어서, 네 특징 중 다른 계열에서도 같은 방향으로 확인된 건 큰 크기에서의 label·recency·authority 정도로 좁혀 읽는 게 맞다.
Leave a comment