
MemGPT Paper review
MemGPT: Towards LLMs as Operating Systems
https://arxiv.org/abs/2310.08560
MemGPT는 UC Berkeley에서 만든 LLM 메모리 관리 시스템이다. 2023년 10월 arXiv에 올라온 논문이다.
OS가 메모리와 디스크 사이를 페이징하듯이, LLM이 컨텍스트 창과 외부 저장소 사이에서 정보를 옮기게 한다.
이후 메모리 논문들에서 계속 베이스라인으로 나오는 시스템이다. 뒤에서 볼 Zep이 DMR에서 비교한 상대이고, A-MEM 표와 Mem0 논문의 비교 대상에도 나온다. 시간순으로는 이 계열의 출발점이라 제일 먼저 읽었다.
2023년 논문이라 지금 기준으로는 오래되었다. 그래도 이후 메모리 시스템들이 쓰는 용어가 여기서 많이 나왔다.
1. Introduction
introduction 부분을 보면 문제는 단순하다. 고정 길이 컨텍스트 창 때문에 긴 대화나 긴 문서를 다루기 어렵다.
2023년 기준으로 많이 쓰던 오픈소스 LLM은 수십 번 주고받거나 짧은 문서 하나만 넘어가도 최대 입력 길이를 넘었다.
컨텍스트를 그냥 늘리면 되는 것도 아니라고 한다. 컨텍스트가 큰 모델은 어텐션이 고르게 가지 않는다. 처음과 끝은 잘 기억하고 중간은 잘 못 한다(lost in the middle).
그래서 가상 컨텍스트 관리(virtual context management)를 제안한다.
아이디어는 운영체제의 계층적 메모리에서 가져왔다. OS는 물리 메모리와 디스크 사이를 페이징해서 메모리가 더 큰 것처럼 보이게 한다.
LLM이 자기 컨텍스트에 뭘 넣을지 스스로 관리하게 하고, 이걸 ‘LLM OS’라고 부른다.
2. MemGPT (MemoryGPT)
메모리를 둘로 나눈다.
- Main context : LLM 프롬프트 토큰. 물리 메모리(RAM)에 해당, 추론할 때 바로 씀
- External context : 컨텍스트 창 밖의 정보. 디스크에 해당, 쓰려면 main context로 옮겨와야 함
external context는 다시 둘이다.
- Recall Storage : MemGPT 메시지 DB. 큐 매니저가 쓰고 함수로 읽는다
- Archival Storage : 함수로 읽고 함수로 쓴다
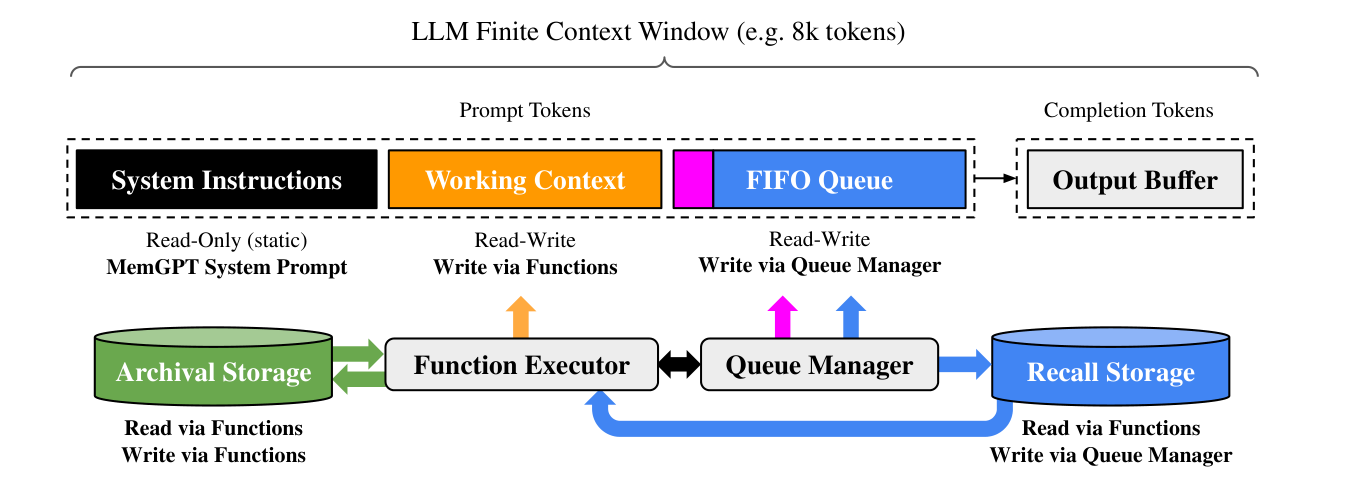
위쪽 점선 안이 main context(프롬프트 토큰)이고, 아래 두 저장소가 external context다. 구역마다 읽기/쓰기 권한과 누가 쓰는지가 붙어 있다.
2.1 Main context (prompt tokens)
프롬프트 토큰을 연속된 세 구역으로 나눈다.
- System Instructions : 읽기 전용(정적). MemGPT 제어 흐름 정보
- Working Context : 읽기·쓰기, 함수로 씀. 에이전트가 직접 관리하는 사실
- FIFO Queue : 읽기·쓰기, 큐 매니저가 씀. 최근 메시지, 시스템 경고, 함수 입출력
FIFO 큐의 첫 인덱스에는 큐에서 밀려난 메시지들을 재귀적으로 요약한 시스템 메시지가 들어간다. 밀려나도 요약으로 흔적은 남는다.
2.2 Queue Manager
새 메시지가 오면 큐 매니저가 FIFO 큐에 붙이고, 프롬프트 토큰을 이어 붙여서 LLM 추론을 돌린다.
들어온 메시지랑 생성된 출력은 둘 다 recall storage에 쓴다. 함수 호출로 recall storage에서 메시지를 꺼내면 큐 뒤에 다시 붙여서 컨텍스트 창에 넣는다.
컨텍스트가 넘칠 때 처리하는 것도 큐 매니저가 한다. 메모리 압력 경고도 큐 매니저가 큐에 넣는다.
Figure 1 예시를 보면 동작 방식이 잘 보인다.
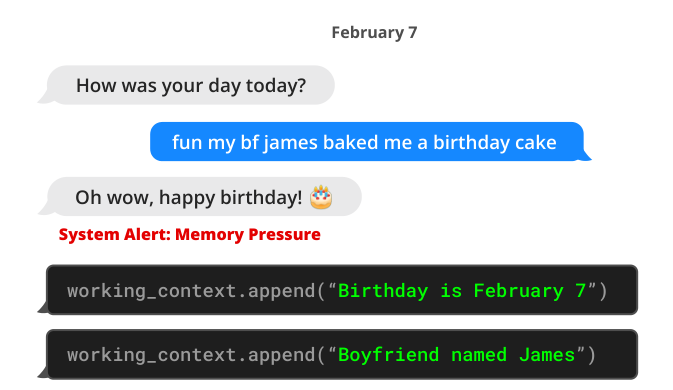
컨텍스트 공간이 부족해지면 시스템 경고(System Alert: Memory Pressure)가 LLM에 전달되고, LLM이 working_context.append("Birthday is February 7") 같은 함수를 직접 호출해서 영구 메모리에 쓴다.
Figure 4는 갱신하는 예시다. 사용자가 헤어졌다고 하니 working_context.replace("Boyfriend named James", "Ex-boyfriend named James")를 호출한다.
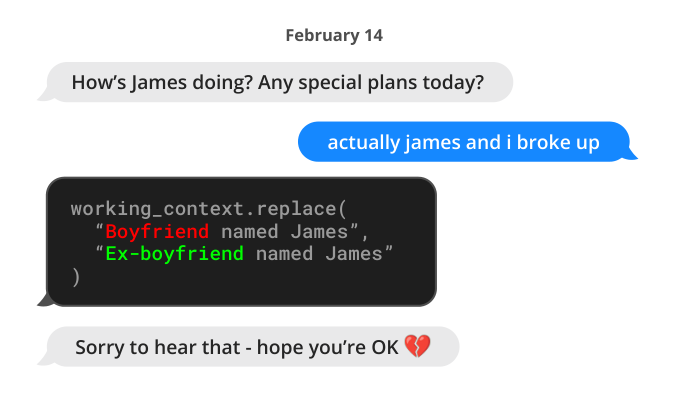
갱신되는 정보는 프롬프트 토큰 안의 working context에 들어 있다.
replace로 덮어쓰니까 working context에서는 이전 값이 사라진다. 원래 대화는 recall storage에 남아 있다.
2.3 Function executor (handling of completion tokens)
LLM 출력을 함수 호출로 해석한다. 함수 실행기가 main context와 external context 사이로 데이터를 옮긴다.
2.4 Control flow and function chaining
여기서 재밌는 게 하나 있다.
LLM이 출력에 request_heartbeat=true라는 인자를 넣으면 바로 다음 추론을 요청할 수 있다고 한다. 이렇게 함수를 연쇄해서 여러 단계 검색을 한다.
이 플래그가 없으면(yield) 다음 외부 이벤트(사용자 메시지나 예약된 인터럽트)가 올 때까지 LLM을 돌리지 않는다.
-> 앞에서 본 ReAct 루프랑 거의 같은 구조다. 2023년에 이미 에이전트가 검색을 여러 번 이어서 하고 있었다.
3. Experiments
3.1 MemGPT for conversational agents
3.1.1 Deep memory retrieval task (consistency)
이전 대화(세션 1~5)에서 나온 주제에 대해 구체적으로 물어본다. 데이터는 MSC(Multi-Session Chat)이고, 대화마다 세션 5개, 세션당 메시지 열두 개 안팎이다.
아래는 MemGPT를 백본별로 돌린 결과다(논문 Table 2). 모델 이름만 있는 줄이 MemGPT 없이 그 모델만 쓴 베이스라인이다.
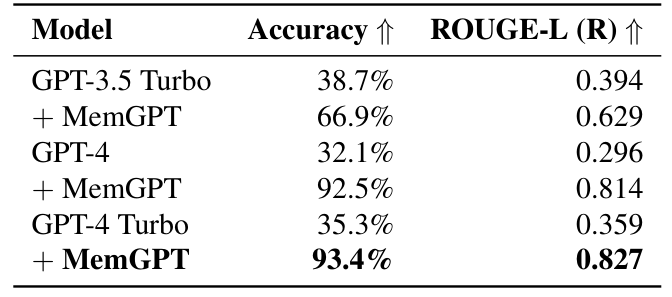
베이스라인은 지난 다섯 세션을 손실 있게 요약한 것만 본다. 논문은 이걸 재귀 요약(recursive summarization)을 흉내 낸 설정이라고 한다. MemGPT는 대화 이력 전체를 recall storage에 두고 검색해서 꺼내 쓴다.
GPT-4에서 32.1% → 92.5%다.
-> 베이스라인이 요약만 보는 설정이라, 대화를 통째로 넣은 것과 비교한 건 아니다. 그 비교는 뒤에서 볼 Zep이 한다.
3.1.2 Conversation opener task (engagement)
에이전트가 먼저 말을 거는 품질을 본다. 페르소나 라벨과의 유사도(SIM-1/3), 사람이 쓴 오프너와의 유사도(SIM-H)로 잰다.
아래도 MemGPT를 백본별로 돌린 결과다(논문 Table 3). Human 줄만 사람이 쓴 오프너다.
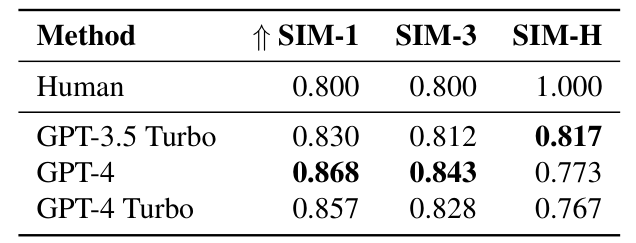
사람이 쓴 오프너보다 높게 나온다(SIM-1 0.868 vs 0.800). working context에 정보를 저장해두는 게 좋은 오프너를 만드는 데 중요하다고 한다.
3.2 MemGPT for document analysis
문서 QA에서는 컨텍스트 한계를 훨씬 넘는 문서를 처리한다.
고정 컨텍스트 베이스라인은 검색기가 가져온 상위 K개 문서만 보니까, 성능이 검색기 성능에 묶인다. 문서를 더 넣으려고 잘라 넣으면 정확도가 떨어진다. MemGPT는 archival storage를 페이지 단위로 여러 번 검색하니까 문서 수가 늘어도 성능이 유지된다(논문 Figure 5).
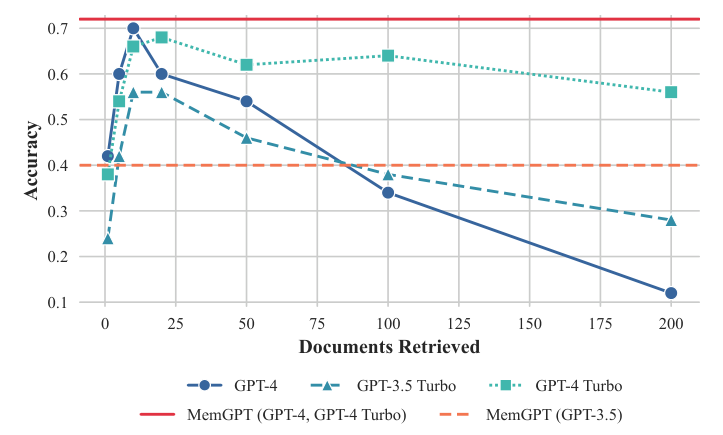
가로축이 검색해 온 문서 수다. 고정 컨텍스트 베이스라인은 곡선이고, MemGPT는 문서 수와 상관없이 가로선 하나로 그려져 있다.
다만 MemGPT도 검색 결과를 끝까지 넘기지 않고 중간에 멈출 때가 많았고, GPT-3.5에서는 함수 호출 능력이 부족해서 크게 떨어진다.
그리고 중첩 key-value 검색 과제를 새로 만들었다. 값이 다시 키가 되는 구조라 여러 번 찾아 들어가야 하는 다중홉 검색이다.
GPT-3.5는 중첩 1단계에서, GPT-4와 GPT-4 Turbo는 3단계에서 정확도 0%가 된다. GPT-4 기반 MemGPT는 중첩 단계가 늘어도 떨어지지 않는다(논문 Figure 7).
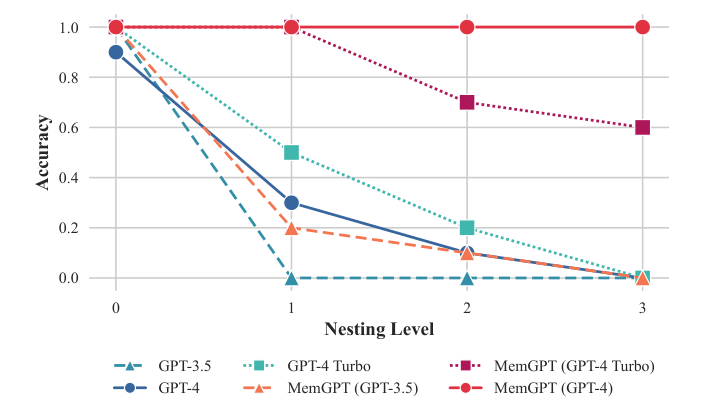
가로축이 중첩 단계다. MemGPT (GPT-4) 선만 3단계까지 위에 붙어 있고, MemGPT (GPT-4 Turbo)는 단계가 늘면서 조금씩 내려간다.
Wikipedia 2천만 문서 임베딩 데이터셋도 같이 공개했다.
4. Related Work
컨텍스트 길이를 늘리는 연구, 외부 검색기를 붙이는 retrieval-augmented 모델, LLM을 에이전트로 쓰는 연구를 정리한다.
긴 컨텍스트 LLM은 MemGPT의 main context 크기를 키워주는 쪽이고, 이 논문은 그 위에 계층형 메모리를 얹는 거라고 한다.
5. Conclusion
conclusion 부분을 보면 OS에서 아이디어를 가져와 LLM의 제한된 컨텍스트 창을 관리하는 시스템이라고 정리한다. 메모리 계층과 제어 흐름을 OS처럼 설계해서 컨텍스트가 더 큰 것처럼 보이게 한다.
문서 분석에서는 컨텍스트 한계를 훨씬 넘는 텍스트를 페이징으로 처리했고, 대화 에이전트에서는 장기 기억과 일관성을 유지했다고 한다.
계층적 메모리 관리나 인터럽트 같은 OS 기법을 LLM의 자원 문제에 쓸 수 있다는 걸 보였다고 한다.
여태까지 LLM이 컨텍스트 창 안의 정보만 썼다면, MemGPT는 LLM이 함수로 직접 컨텍스트와 외부 저장소 사이를 오가게 한다.
3년이 지난 지금 벤치마크 수치는 대부분 추월당했지만, 여기서 나온 용어들은 이후 논문들에서 계속 쓰이고 있다.
6. 지금 관점: 현재에도 쓰이는 개념
벤치마크 숫자보다 여기서 나온 용어가 더 오래 갔다.
main context와 external context를 나누는 구도는 뒤에 나오는 시스템 대부분이 그대로 쓴다. LLM이 함수 호출로 자기 메모리를 고치는 것도 뒤에서 볼 Mem0의 추가·수정·삭제 연산으로 이어진다.
MemGPT 안에는 원본이 남는 부분과 안 남는 부분이 섞여 있다. recall storage와 archival storage에는 원본이 남는다. FIFO 큐에서 밀려난 메시지의 재귀 요약과 working context의 replace는 원본을 덮는다. 요약이 또 요약되면서 오차가 쌓이는 문제는 나중에 볼 Rate-Distortion에서 따로 다룬다.
그래도 recall storage에 원본을 남기니까 요약에서 빠진 걸 검색으로 다시 찾을 수는 있다.
-> 설계는 되어 있는데, 에이전트가 검색을 안 하면 소용없는 거 아닌가??
지금 써볼 만한 건 프롬프트를 세 구역으로 나눈 것이다. 시스템 지시(정적), 에이전트가 관리하는 사실(함수로 씀), 최근 메시지(자동으로 씀)로 쓰는 주체를 나누면 프롬프트 관리가 편해진다.
토큰이 차면 그냥 자르지 않고 메모리 압력 경고로 LLM한테 알려서 뭘 남길지 고르게 하는 것도 괜찮아 보인다.
대신 전부 LLM 판단에 달려 있다. 언제 저장할지, 뭘 검색할지, 언제 함수를 연쇄할지 다 모델이 정한다. 2023년 GPT-4 기준으로 설계됐고, 이 논문에서도 GPT-3.5로 돌리면 문서 QA가 크게 떨어졌다.
뒤에서 볼 A-MEM 논문의 비교에서도 작은 모델에서 MemGPT가 약하고 토큰을 많이 쓰는 쪽으로 나온다. main context에 FIFO 큐를 들고 가는 구조 때문일 것 같은데, 논문에서 따로 재지는 않았다.
반복 검색을 하는 구조가 나중에 ReFind에서 어떻게 다시 나오는지도 뒤에서 본다.
다음은 HippoRAG다. 해마 색인 이론을 RAG에 옮겨서, LLM으로 스키마 없는 지식그래프를 만들고 Personalized PageRank로 한 번의 검색에 다중홉을 푼다.
Leave a comment