
MemMachine Paper review
MemMachine: A Ground-Truth-Preserving Memory System for Personalized AI Agents
https://arxiv.org/abs/2604.04853
MemMachine은 MemVerge, Inc.에서 만든 오픈소스 메모리 시스템이다. 2026년 4월 arXiv에 올라온 논문이다.
제목의 ground-truth-preserving은 대화 원문을 그대로 보관한다는 뜻이다. LLM으로 뭔가 뽑아내는 건 최소한으로 하고, 대신 검색 쪽을 손보는 게 더 효과가 크다고 한다.
앞에서 본 Mem0는 대화에서 사실만 뽑아 남겼는데, 이 논문은 원문을 남기고 꺼내는 방법을 다듬는다. 원문을 남기는 쪽이 왜 좋은지는 뒤에서 볼 Rate-Distortion에서 다시 나온다.
1. Introduction
설계 입장부터 보자.
단기 메모리, 장기 일화 메모리, 프로필 메모리 세 개를 원문 보존 구조로 묶는다.
원시 대화 에피소드를 그대로 저장하고, LLM으로 추출하는 건 최소화한다. 아예 안 쓰는 건 아니고, 프로필 메모리는 여전히 LLM으로 추출한다.
2. Related Work
MemGPT, Generative Agents 같은 에이전트 메모리 연구와 Mem0, Zep, Memobase, LangMem, Mastra, MemOS 같은 기존 메모리 시스템, LoCoMo·LongMemEval·EpBench 벤치마크를 정리한다.
Mem0처럼 메시지마다 LLM으로 사실을 뽑으면 비용이 들고 추출 오류가 쌓인다는 게 이 논문의 문제의식이다.
3. Memory Types for AI Agents
인지과학의 구분을 빌려 일화 메모리(무엇이 언제 있었나), 의미 메모리(사용자 선호 같은 일반화된 지식), 절차 메모리(어떻게 하나)를 나눈다.
MemMachine은 일화 메모리와 의미 메모리(프로필 메모리)만 구현하고 절차 메모리는 아직 없다. 시간 정보는 따로 모듈을 두지 않고 모든 에피소드에 타임스탬프를 붙여 검색 때 거른다.
4. MemMachine Architecture
4.1 System Overview
전체 구조는 이렇다.
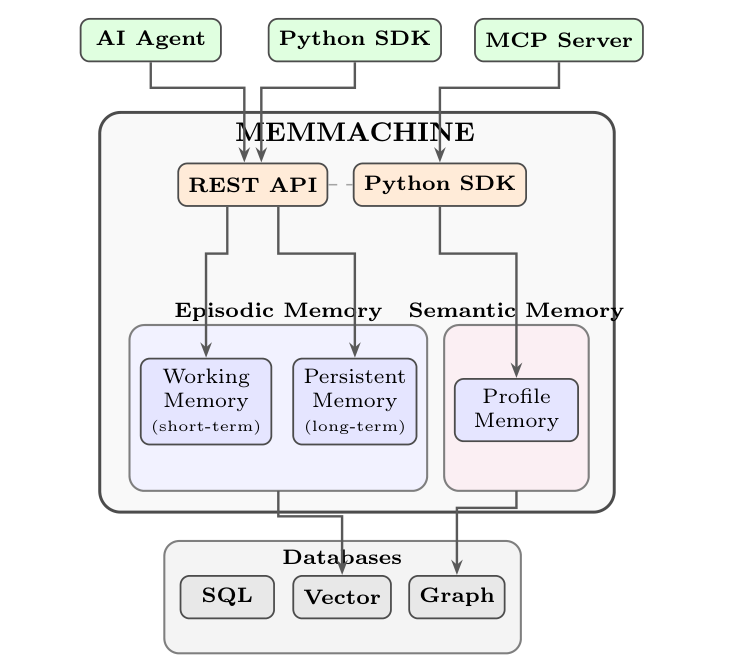
에이전트, Python SDK, MCP 서버가 REST API·SDK로 붙는다.
일화 메모리는 working memory(단기)와 persistent memory(장기)로 나뉘고, 프로필 메모리는 semantic memory 쪽에 있다.
저장소는 PostgreSQL(pgvector), SQLite, Neo4j를 쓴다.
4.2 Data Ingestion
메시지 하나(대화 턴 하나)를 Episode라는 단위로 저장한다. 보낸 쪽, 타임스탬프, 세션 ID, 사용자 정의 메타데이터가 붙는다.
원본 저장소에 넣으면서 동시에 일화 메모리와 프로필 메모리로 보내 색인한다.
4.3 Short-Term Memory
논문은 단기 쪽을 STM(Short-Term Memory)이라고 부른다. STM은 최근 에피소드를 정해진 개수만큼 들고 있으면서 LLM으로 세션 요약을 만든다. 검색 없이 바로 최근 문맥을 쓸 수 있다.
4.4 Long-Term Memory
장기 쪽은 LTM(Long-Term Memory)이다. STM 창을 벗어난 에피소드는 LTM으로 넘어가 문장 단위로 쪼개고, 원래 에피소드의 메타데이터와 연결해 문장마다 임베딩해서 저장한다.
4.5 Memory Search and Recall
검색은 STM을 먼저 보고, LTM에서 문장 임베딩으로 찾은 뒤 원래 에피소드로 거슬러 올라가는 순서다. STM과 겹치는 에피소드는 빼고 시간순으로 정렬해서 돌려준다.
4.6 Contextualization
대화 메모리 검색이 어려운 이유를 이렇게 설명한다.
맥락상 중요한 에피소드가 질의와 임베딩이 꽤 다를 수 있다. 일반 RAG 문서는 청크 하나하나가 어느 정도 혼자 말이 되는데, 대화 턴은 서로 강하게 의존한다.
예를 들어 “그 식당 추천” 관련 질문에 답하려면, 추천이 들어 있는 턴 말고도 무엇을 왜 물었고 어떤 제약이 있었는지 나온 주변 턴이 필요하다.
그래서 네 단계로 검색한다.
- 임베딩 검색으로 핵(nucleus) 에피소드를 찾는다
- 바로 옆 에피소드를 앞 1개, 뒤 2개 가져와서 클러스터를 만든다
- 클러스터를 cross-encoder 등으로 재랭킹한다
- 상위 k개 클러스터를 LLM에 준다
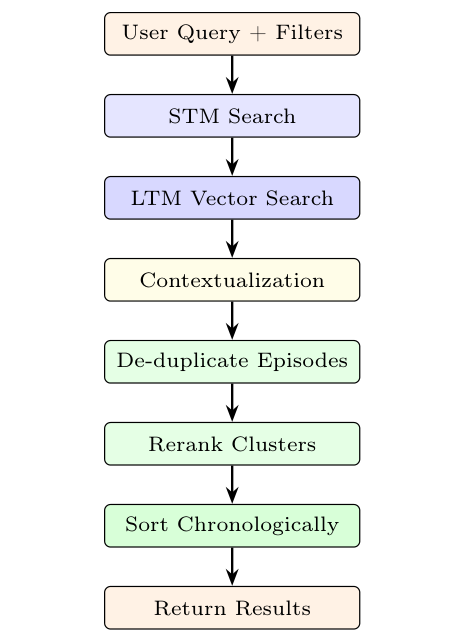
전체 recall 흐름으로 보면 STM 검색, LTM 벡터 검색 다음에 contextualization이 들어가고, 중복 제거, 재랭킹, 시간순 정렬을 거쳐 결과를 돌려준다.
-> 앞 1개, 뒤 2개로 비대칭인 건 대화에서 답이 질문 뒤에 오니까 뒤쪽을 더 보는 것 같다. 이웃 턴을 같이 꺼내는 장치는 뒤에서 볼 ReFind에서도 다시 나온다.
4.7 Profile Memory (Semantic Memory)
일화 메모리가 원시 상호작용을 그대로 두는 거라면, 프로필 메모리는 사용자 속성을 요약해서 모아둔다.
- 사용자가 스스로 밝힌 인구통계 정보
- 말한 선호와 관심사
- 행동 패턴
LLM 추출은 여기서만 쓴다. 원문은 일화 메모리에 남아 있으니까 프로필 추출이 틀려도 다시 복구할 수 있다.
앞에서 본 Mem0에서는 사실만 남기고 원문을 버렸는데, 여기서는 원문을 남긴다.
4.8 Multi-Tenancy and Isolation
프로젝트 단위(org_id/project_id)로 메모리를 나누고, 그 안에서 user_id, agent_id, session_id로 다시 격리한다.
5. Retrieval Agent
다중홉 질의를 위해서 에이전트를 따로 둔다.
5.1 The Late Binding Problem
논문 예시는 이렇다. Acme의 CEO(Person X)를 찾고, 그 배우자 Person Y를 찾고, Person Y의 고용주 Company Z를 찾아야 한다.
질의 시점에는 원래 질의 문자열밖에 없다. 그 임베딩은 “Acme”, “CEO”, “company” 같은 표면 단어 근처에 모여 있어서, 중간 엔티티를 모르면 Company Z까지 갈 방법이 없다.
논문은 이게 임베딩 모델 탓이 아니고 다중홉 사슬 자체의 구조 문제라서, 한 번의 벡터 검색으로는 풀 수 없다고 한다.
기존 방법들도 한계가 있다.
- 질의 확장(HyDE), BM25 하이브리드, 청크 재랭킹 : 단일홉 재현율은 올라가지만 질의 하나로 검색하니까 의존 사슬은 못 품
- 지식그래프 순회 : 정확히 풀긴 하는데 그래프를 미리 만드는 게 비싸고 정보 손실이 있음
반복 검색으로 이 문제를 푸는 방식은 뒤에서 볼 ReFind에서도 나온다.
5.2 Architecture
해법은 도구 트리다. ToolSelectAgent가 질의를 보고 셋 중 하나로 보낸다.
- MemMachine Agent : 직접 검색
- SplitQuery Agent : 질의를 병렬로 쪼갬(fan-out)
- ChainOfQuery Agent : 증거를 반복해서 모음(다중홉)
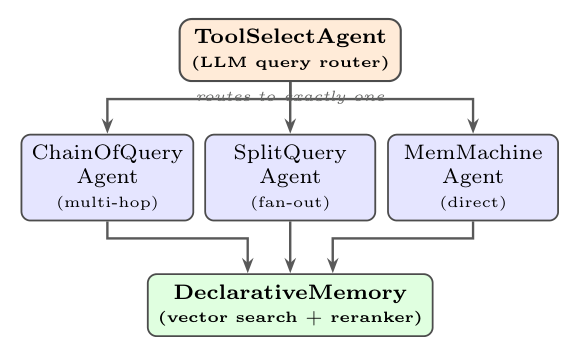
세 전략 모두 같은 DeclarativeMemory 검색(벡터 검색 + 재랭커)을 부른다. 그래서 인덱스나 재랭커를 개선하면 세 경로에 다 반영된다고 한다.
5.3 Query Routing
ToolSelectAgent가 LLM 한 번 호출로 질의를 다중홉 의존 사슬, 여러 엔티티 단일홉, 단순 단일홉 셋 중 하나로 분류한다. 의존 사슬이 하나라도 보이면 다중홉으로 보낸다.
5.4 Strategy Details
ChainOfQuery는 검색, 충분한지 판단하고 질의 다시 쓰기, 증거 쌓기를 최대 3번 반복한다. SplitQuery는 질의를 독립된 하위 질의 2~6개로 쪼개서 동시에 검색한다.
5.5 Multi-Query Reranking
마지막 재랭킹에 원래 질의만 쓰지 않고, 중간에 다시 쓴 질의와 하위 질의까지 이어 붙여서 넣는다. 중간 단계에서만 필요한 사실도 순위에서 밀리지 않게 하려는 장치다.
5.6 Benchmark Results
다중홉 에이전트 결과다. 정확도는 LLM 판정 점수이고, 세 가지 방식을 비교한다. 메모리 없이 전체 텍스트를 LLM에 넣는 베이스라인, 기본 MemMachine 검색, Retrieval Agent다. 논문 Table 3이다. 벤치마크별로 Acc.가 정확도, Recall이 정답 근거 재현율이고, 맨 오른쪽 Baseline 열이 전체 텍스트 베이스라인이다.
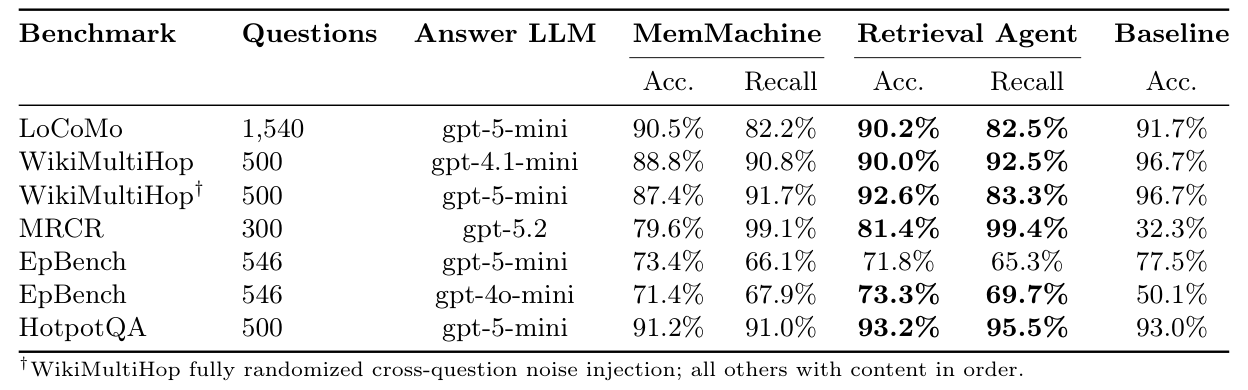
HotpotQA hard 500문항(답변 모델 gpt-5-mini)에서 Retrieval Agent는 93.2%다. 기본 MemMachine 검색은 91.2%, 전체 텍스트 베이스라인은 93.0%였다.
WikiMultiHop에서 질문들의 문맥을 한 저장소에 무작위로 섞어 넣은 조건에서는 Retrieval Agent가 92.6%, 기본 MemMachine이 87.4%다. 전체 텍스트 베이스라인은 96.7%로 더 높다.
-> 에이전트가 기본 검색보다는 확실히 낫지만, 문맥이 창에 다 들어가는 이 벤치마크들에서는 전체 텍스트를 넣는 쪽이 비슷하거나 더 높다.
5.7 Token Cost Analysis
라우팅과 전략 실행에 LLM 호출이 더 들어간다. 바로 기본 검색으로 가는 질의는 라우팅 호출 비용만 들고, ChainOfQuery는 반복 3번 제한이 있어서 비용에 상한이 있다고 한다.
5.8 When to Use Agent Mode
다중홉이나 여러 엔티티를 묻는 질의, 지연보다 정확도가 중요한 경우에 쓰라고 한다. 단일홉 조회 위주이거나 지연·토큰 예산이 빡빡하면 필요 없다.
5.9 OpenClaw Integration
Retrieval Agent를 오픈소스 에이전트 프레임워크 OpenClaw의 플러그인으로도 제공한다.
6. LLM Integration and Model Impact
LLM은 STM 요약, 프로필 추출, agent 모드 추론 세 군데에만 쓰고, 메시지마다 사실을 뽑거나 중복을 정리하는 데는 안 쓴다고 한다.
답변 모델에 따른 점수 차이, 토큰 비용, 대화가 컨텍스트 창에 다 들어가는 경우에도 메모리가 필요한지를 같이 다룬다.
7. Experimental Setup
벤치마크(LoCoMo, LongMemEval_S. HotpotQA·WikiMultiHop·EpBench는 5.6의 Retrieval Agent 실험에서 따로 쓴다), 평가 지표, 실험 환경, 비교 시스템을 정리한다.
비교 시스템 중 Mem0는 직접 다시 돌렸고, Zep, Memobase 등은 발표된 수치를 가져왔다.
8. Results and Analysis
8.1 LoCoMo Benchmark Results
LoCoMo 점수는 judge LLM(gpt-4o-mini)이 답을 정답과 비교해 0/1로 매긴 점수의 평균이다. 논문 Table 10이다. 왼쪽 두 열이 답변 모델(Eval-LLM)과 모드이고, Overall 열이 전체 점수다.
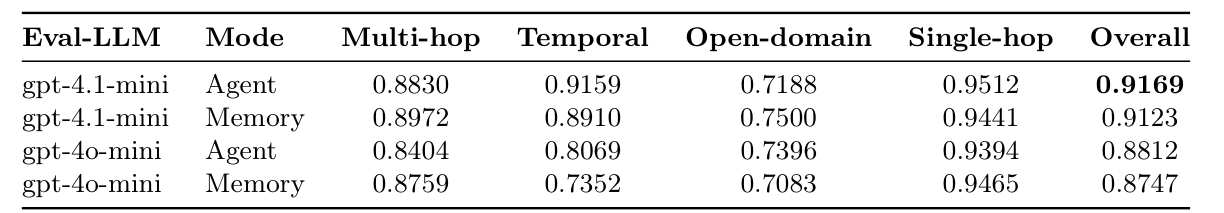
abstract에 나온 0.9169는 제일 좋은 조합(gpt-4.1-mini, agent 모드) 점수다.
8.2 Comparative Analysis
다른 시스템과는 gpt-4o-mini, memory 모드로 비교한다. 발표된 베이스라인들이 gpt-4o-mini 기준이라서다. 논문 Table 11이다. 맨 위 MemMachine 행과 바로 아래 차순위 Memobase 행을 보면 된다.
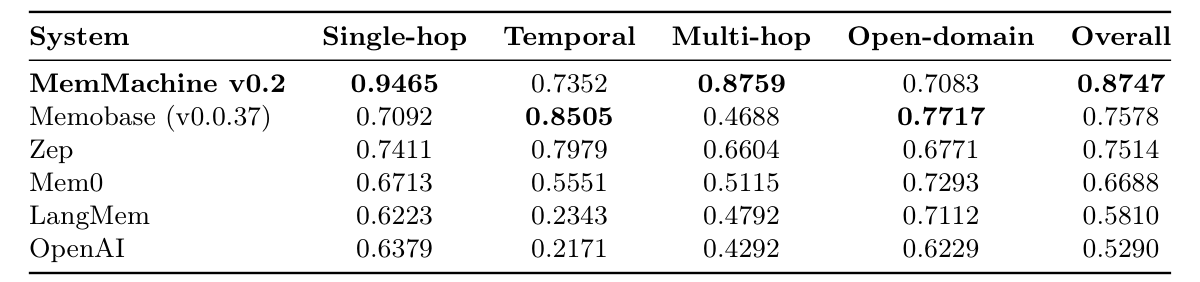
논문은 차순위 시스템(Memobase)보다 전체 점수가 +9.7점(0~1 점수를 100점으로 환산) 높다고 쓴다.
-> 표대로 빼면 0.8747 − 0.7578 = 0.1169라서 11.7점이다. 9.7은 어디서 나온 건지??
Temporal과 Open-domain에서 진다. Temporal은 Memobase가 0.8505, Open-domain은 Memobase가 0.7717로 더 높다(MemMachine 0.7083).
논문은 타임스탬프를 고려한 검색으로 개선할 수 있다고 본다. 그리고 gpt-4.1-mini agent 모드에서는 Temporal이 0.9159까지 올라가서, 시간 추론은 답변 모델 능력에 많이 좌우된다고 한다.
8.3 Efficiency Analysis
효율도 같이 보고한다.
- 입력 토큰 : Mem0 대비 약 80% 절감 (LoCoMo, memory 모드, 4.20M vs 19.21M)
- 메모리 추가 속도 : MemMachine 이전 버전 대비 약 75% 빨라짐
- 검색 속도 : 최대 75% 빨라짐 (비교 기준은 안 적혀 있음)
추가 속도는 다른 시스템이 아니라 자기 이전 버전과 비교한 수치다. 검색 속도는 무엇과 비교했는지 논문에 안 나온다.
입력 토큰 수치는 논문 Table 8이다. 답변 모델은 gpt-4.1-mini이고, 맨 위 MemMachine memory 행과 맨 아래 Mem0 행의 Input Tokens 열을 보면 된다.
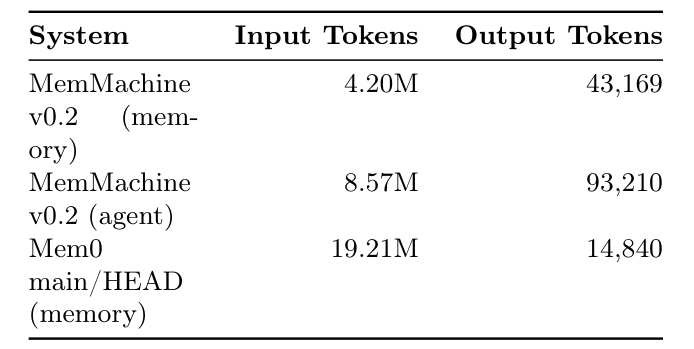
표대로 계산하면 4.20M / 19.21M로 약 78% 절감이다.
8.4 LongMemEvalS Ablation Study
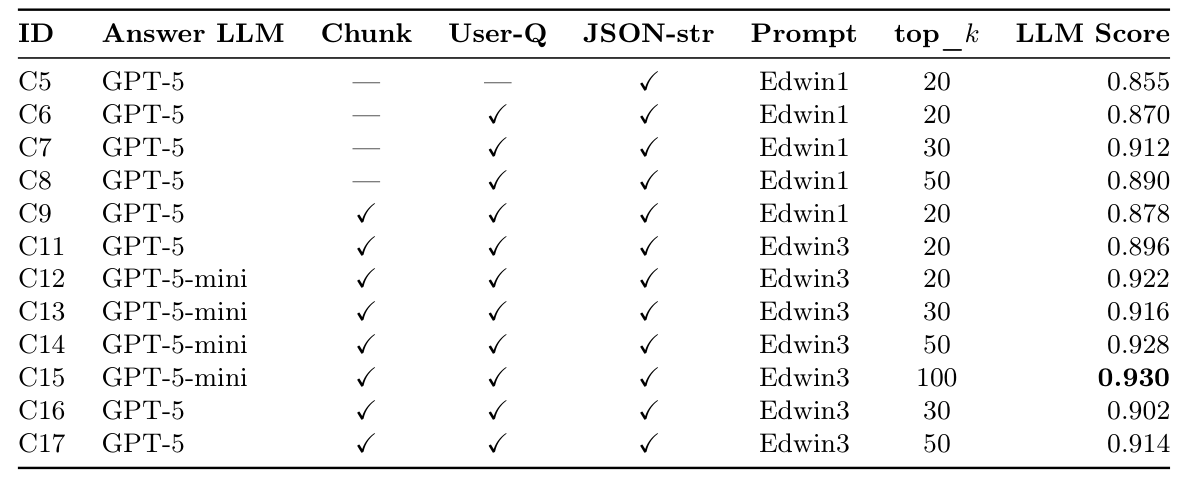
LongMemEval_S는 앞에서 본 LongMemEval에서 질문마다 약 115k 토큰짜리 대화 이력을 붙인 버전이다. 500문항 전체에서 설정을 하나씩 바꿔가며 쟀고, 최고 점수는 93.0%다.
설정 조합별 점수는 논문 Table 12다. C5~C17이 설정 ID이고, 맨 오른쪽 LLM Score 열이 500문항 점수다.
아래는 논문 Table 13이다. 한 가지만 다른 설정 두 개(Comparison 열의 설정 ID)를 비교한 점수 차이(%p)이고, 단계 구분(Retrieval-stage, Ingestion-stage, Model selection)은 논문 분류를 따랐다.
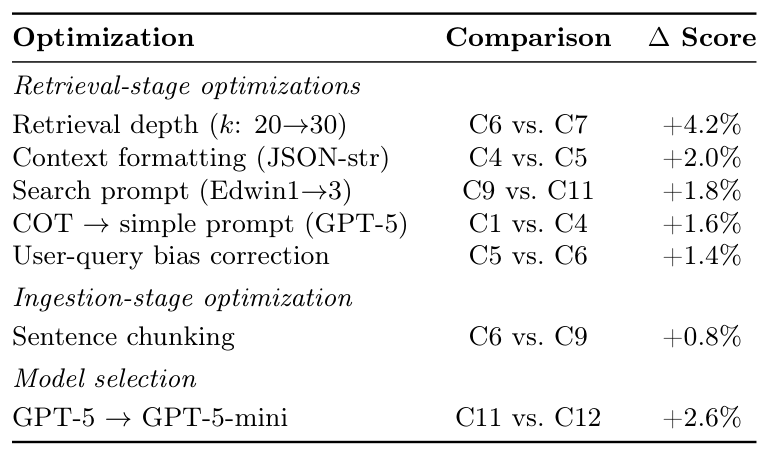
검색 쪽 항목 하나하나가 저장 쪽(문장 청킹 +0.8%p)보다 크다.
-> 다만 CoT 제거는 답변 LLM에 주는 프롬프트를 바꾼 거라 검색보다는 답변 생성 단계에 가까워 보인다. 검색 프롬프트(논문이 차례로 다듬은 세 버전)도 논문 설명을 보면 CoT 없이 간결하게 지시하는 프롬프트라서 답변 쪽과 섞여 있는 것 같다. 이 둘을 빼도 검색 깊이와 포맷팅이 청킹보다 크긴 하다.
그래서 논문은 메모리 시스템에서는 어떻게 저장하느냐보다 어떻게 꺼내느냐가 더 중요하다고 한다. 단, 저장할 때 원문을 보존한다는 전제에서다.
그리고 사실 추출이나 지식그래프 구축처럼 저장 단계에 LLM을 많이 쓰는 시스템은 엉뚱한 단계를 최적화하고 있을 수도 있다고 한다. 앞에서 본 Mem0(사실 추출), Zep(그래프), A-MEM(링크와 메모 진화)이 다 저장 단계에 LLM을 많이 쓴다.
작은 모델이 이긴다는 결과도 있다.
답변 LLM으로 GPT-5-mini가 GPT-5보다 +2.6%p 높았다(0.896 → 0.922). 최적화된 프롬프트와 같이 썼을 때 그렇고, 토큰 비용도 더 싸다.
이유는 모델과 프롬프트를 같이 맞춰야 해서라고 본다. 최종 프롬프트는 chain-of-thought 없이 간결하게 지시하는 형태라 GPT-5-mini와 잘 맞았다고 한다. 반대로 GPT-5는 자체 추론이 있어서, 명시적인 추론 지시를 주면 서로 부딪힐 수 있다고 한다.
9. Discussion
9.1 Retrieval Stage Dominates Accuracy
8.4의 ablation을 다시 정리한다. 검색 쪽 개선을 다 합한 효과가 저장 쪽(문장 청킹)보다 훨씬 크다고 한다.
9.2 Model–Prompt Co-optimization
모델을 바꿀 때 프롬프트를 그대로 가져다 쓰지 말고, 답변 모델이 바뀌면 프롬프트를 다시 평가해야 한다고 한다.
9.3 The Role of Personalization
일화 메모리는 무슨 일이 있었는지, 프로필 메모리는 사용자가 어떤 사람인지를 맡아서 세션이 바뀌어도 개인화를 이어간다고 한다.
9.4 Summary vs. Full Context vs. Compressed Observations
전체 문맥을 넣으면 길어질수록 모델이 놓치고, 요약만 쓰면 세부 사실과 시점이 빠진다. Mastra의 압축 관찰 로그는 그 중간이라고 본다.
9.5 Single-Agent vs. Multi-Agent Memory
여러 에이전트가 메모리를 공유하면 같은 정보를 다시 모으지 않아도 되고, 에이전트 사이에 넘길 때 문맥을 잃지 않는다고 한다.
9.6 Privacy and Data Sovereignty
임베딩 모델과 LLM을 로컬에서 돌리면 데이터가 밖으로 나가지 않는다. 자체 호스팅이라 로컬 모델과 외부 API를 코드 수정 없이 바꿔 쓸 수 있다고 한다.
9.7 Limitations and Threats to Validity
논문이 밝힌 한계다. 점수는 답변 모델, 프롬프트 템플릿, 제공자 쪽 모델 업데이트에 따라 달라진다. 시스템 간 비교는 직접 다시 돌린 결과와 발표된 수치를 섞은 거다. ablation은 차원을 하나씩 따로 바꾼 거라 차원끼리 상호작용은 안 봤고, 일부 설정은 일부 문항으로 먼저 돌린 다음 500문항으로 늘렸다. 그래서 일반적인 성능 보장보다는 평가한 설정 안에서의 근거로 봐달라고 한다.
9.8 Architectural Design Tensions
논문 Table 16은 여러 메모리 시스템을 설계 속성별로 비교한다. Ground truth preserved 행과 LLM calls per message 행을 보면 된다.
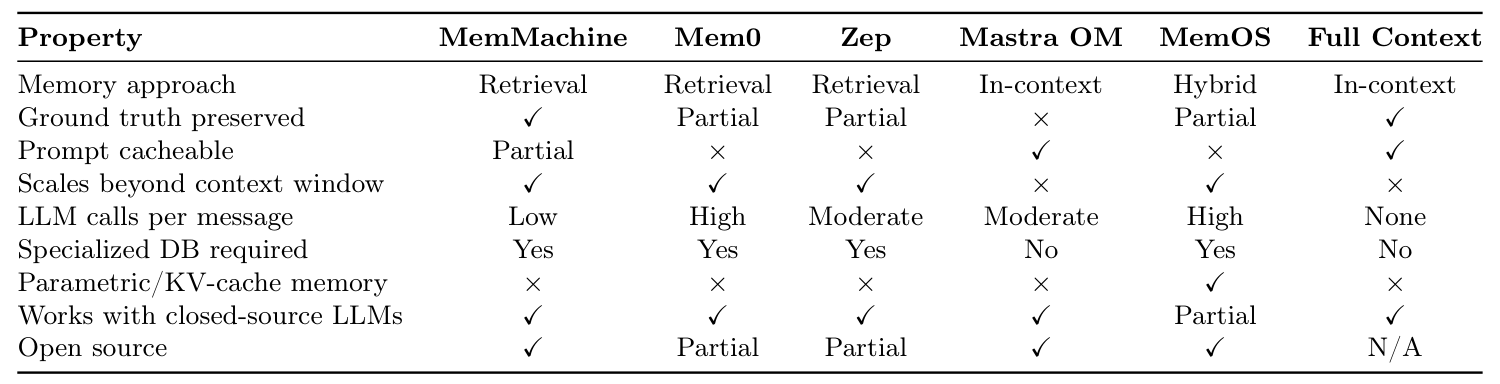
Ground truth preserved 행에서 Mem0이 Partial인 건 논문 Table 16의 평가다. 위에서 Mem0이 원문을 버린다고 한 것과는 기준이 다르다.
메시지당 LLM 호출이 Low라는 게 다른 검색형 시스템과 다른 점이다.
앞에서 본 Anatomy 리뷰에서는 A-Mem 구축에 15시간, Nemori 형식 오류 30%가 나왔는데, 둘 다 쓰기 단계 LLM 호출에서 생긴 문제였다. 호출이 적으면 이런 위험도 줄어든다.
9.9 When Memory Helps (and When It Doesn’t)
논문이 이걸 절을 따로 두고 적었다.
도움이 되는 경우
- 다중 세션 상호작용 (고객 지원, 의료, 교육)
- 개인화가 중요한 애플리케이션 (콘텐츠 추천, 개인 비서)
- 상태를 계속 들고 가야 하는 워크플로 (프로젝트 관리, CRM)
- 상호작용 이력이 필요한 컴플라이언스·감사
필요 없거나 오히려 손해인 경우
- 단일 턴, 무상태 질의 (검색, 번역, 단순 QA)
- 양은 많고 개인화는 적은 작업 (배치 처리, 데이터 추출)
- 개인정보 제약 때문에 상호작용 이력을 저장하면 안 되는 경우
10. Future Work
절차 메모리, 시간 추론 강화, LongMemEval_M(질문당 약 1.5M 토큰) 평가, 질의에 따라 k를 정하는 방법, 오래된 메모리 정리, 멀티모달 메모리를 앞으로 할 일로 든다.
11. Conclusion
원문 보존, 비용 효율, 개인화를 우선으로 둔 오픈소스 메모리 시스템이다.
단기·장기 일화 메모리 2계층에 프로필 메모리를 더해서, LLM 추출 방식에서 생기는 비용과 오류 누적 없이 과거 경험을 저장하고 꺼내 쓰게 했다고 한다.
LongMemEval_S ablation에서는 검색 단계 최적화가 저장 단계 변경보다 효과가 컸고, 프롬프트를 맞춘 작은 모델(GPT-5-mini)이 큰 모델(GPT-5)보다 나았다.
저장 구조는 단순하게 두고 검색 깊이, 포맷, 프롬프트를 조정하는 것만으로 점수를 많이 올린 논문이다.
12. 지금 관점: 저장 구조를 그대로 두고 해볼 만한 것
이 논문에서 가져올 만한 건 대부분 저장 구조를 안 바꾸고도 해볼 수 있다. 여섯 가지 중에 제일 큰 게 k를 20→30으로 올린 +4.2%p인데, 파라미터 하나 바꾼 거다. 다만 GPT-5에서는 k=50이 오히려 0.890으로 떨어졌으니 무조건 늘린다고 좋은 것도 아니다.
이웃 턴을 같이 꺼내는 것도 대화 데이터에서는 해볼 만하다. 대화는 턴 하나만으로는 말이 안 되는 경우가 많다.
모델을 바꿀 때 프롬프트도 다시 봐야 한다. CoT 제거 +1.6%p, GPT-5-mini가 GPT-5보다 +2.6%p였다.
-> 추출·그래프를 쓰는 무거운 메모리 시스템을 들이기 전에 이런 것부터 해보는 게 순서일 것 같다.
그런데 5.6절에서 본 Retrieval Agent 실험(논문 Table 3)을 보면 LoCoMo에서도 gpt-5-mini 기준으로 전체 텍스트 91.7%, MemMachine 90.5%다. abstract의 0.9169(gpt-4.1-mini, agent 모드)와는 답변 모델과 설정이 다른 실험이다. 메모리를 쓰는 이유가 정확도보다는 토큰과 지연 쪽일 수 있다.
다음은 LongMemEval-V2다. V1이 사용자 이력을 물었다면 V2는 웹 에이전트가 환경에서 쌓은 경험을 묻는다.
Leave a comment