
Multi-Layered Memory Paper review
Multi-Layered Memory Architectures for LLM Agents: An Experimental Evaluation of Long-Term Context Retention
https://arxiv.org/abs/2603.29194
Multi-Layered Memory는 Fulloop에서 만든 에이전트 메모리 구조다. 2026년 3월에 arXiv에 올라왔다.
대화 이력을 working·episodic·semantic 세 계층으로 나누고, 계층을 하나씩 떼어보는 ablation으로 각 계층이 얼마나 기여하는지 잰다.
앞 리뷰들에서 계속 미뤄둔 질문이 계층을 몇 개 둘 것인가였다. CoALA는 네 개(working·episodic·semantic·procedural)를 말했고 Zep은 세 개(episode·entity·community)를 썼다. 그런데 계층을 하나 뺐을 때 얼마나 나빠지는지 잰 실험은 NEMORI 논문 Table 5의 w/o e·w/o s(에피소드 검색이나 의미 검색을 하나씩 뺀 설정) 정도였다. 이 논문의 ablation은 계층을 하나씩 다 빼본다.
다만 이 논문은 앞의 논문들보다 근거가 약하다. 확인이 안 되는 부분은 결과 앞에 따로 적어둔다.
1. Introduction
introduction 부분을 보면, 연구 문제는 이렇다.
여러 세션에 걸친 대화가 있을 때, 컨텍스트가 계속 늘거나 추론 비용이 커지지 않으면서 세션을 넘어 안정적인 의미 표현을 유지하려면 어떻게 해야 하는가.
기존 방법의 한계를 네 가지로 정리한다.
- 계층적 working memory : 컨텍스트는 줄이지만 세션 안의 과제만 보고, 세션 간 지속성이 없음
- 검색 기반 통합 : 관련된 걸 더 잘 고르지만 거짓 기억이 쌓이기 쉬움
- 파라미터 기반 메모리 : 보존율은 재지만 의미가 안정적인지 구조적으로 통제하지 않음
- 컨텍스트 압축 : 토큰은 줄지만 세션 간에 다층 메모리를 유지하지 않음
정리하면 효율은 올리는데 보존이 안정적이지 않거나, 재현율은 올리는데 드리프트를 못 막는다고 한다.
그래서 대화 이력을 세 계층으로 나누고, 계층별 검색 가중치와 드리프트를 막는 손실항을 붙인 구조를 제안한다.
2. Literature Review
계층형 working memory, 3계층 메모리 OS, 사실 유지 메모리 에이전트, 파라미터 메모리 보존, KV 축출과 컨텍스트 압축 같은 선행 연구를 하나씩 소개하고 각 논문이 보고한 수치를 옮겨 적는다.
이 연구들이 다층 메모리와 컨텍스트 관리의 바탕이 됐다고 정리한다.
3. Proposed Methodology
논문은 이 구조를 MLMF라고 부른다.
대화 이력을 세 계층으로 나눈다.
- Working memory : 제한된 창 안에서 최근 상호작용을 보존
- Episodic memory : 압축한 세션 요약을 쌓음
- Semantic memory : 구조화된 엔티티 단위 추상을 유지
여기에 장치 두 개를 더한다.
Adaptive retrieval gating은 계층마다 검색 가중치를 주는 장치다. 입력과 각 계층 메모리의 유사도를 softmax로 정규화해서 가중치를 만들고, 그 가중치로 세 계층을 섞는다. 날카로운 정도는 β로 조절한다. 따로 학습하는 게이트 네트워크는 없고 유사도로 계산한다.
Retention regularization은 손실항이다. semantic 메모리를 엔티티 임베딩으로 옮긴 뒤, 세션이 바뀔 때 그 임베딩이 크게 바뀌면 벌점을 준다. 전체 목적함수는 생성 손실에 이걸 더한 L = L_gen + λ·L_ret이고, 파라미터를 이 손실로 경사하강해서 업데이트한다.
Algorithm 1을 보면 θ는 상태를 합치는 f_θ와 답을 만드는 P_θ에 같이 들어간다. 생성 쪽 파라미터도 같이 학습한다는 뜻이다.
-> 그런데 그 바탕 모델이 뭔지는 논문에 안 나온다??
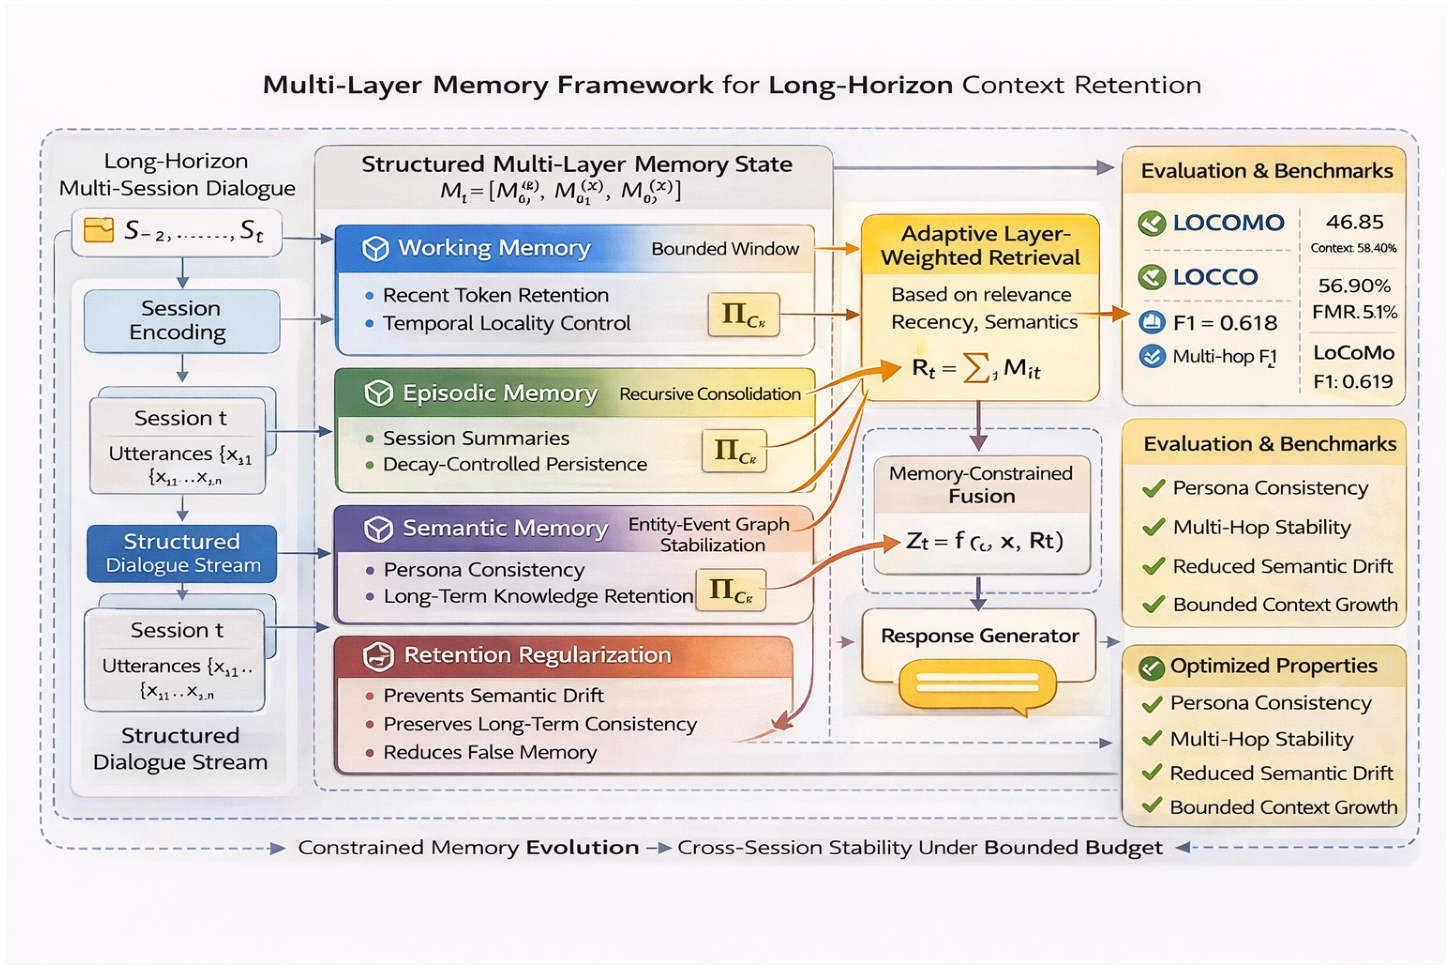
가운데 세로로 working, episodic, semantic 계층이 쌓이고, 그 아래 retention regularization이 붙어 있다.
세 계층이 오른쪽의 adaptive layer-weighted retrieval로 모인 뒤 fusion(cross-attention)을 거쳐 응답 생성으로 간다.
앞에서 본 서베이(Memory in the Age of AI Agents)의 분류로 보면 이렇다. 서베이는 저장 형태(Forms)에서 텍스트 단위로 쌓는 방식을 Token-level이라 부르고, 그 안에서 단위끼리 층을 이루는 구조를 Hierarchical(3D)라고 불렀다. 이 논문이 여기에 들어간다. 쓰임새(Functions)로는 지금 생각 중인 것을 담는 Working과 사용자·환경에 대한 사실을 담는 Factual 조합이다.
겪은 경험에서 배우는 Experiential은 없다. CoALA의 procedural에 해당하는 계층도 없다.
4. Experimental Setup
같은 디코딩 설정에서 계층형 working memory, 메모리 OS, 파라미터 메모리 보존 쪽 베이스라인과 비교하고, SR, F1, BLEU-1, 여러 기간 뒤 보존율, 컨텍스트 사용률을 잰다.
벤치마크는 LOCOMO, LOCCO, LoCoMo 세 개라고 적고, α, β, λ는 검증 분할에서 맞췄다고 한다.
5. Results and Analysis
결과를 보기 전에, 앞에서 본 Anatomy 리뷰에서 평가가 타당한지 따져보라고 했으니 그 기준을 여기에도 대본다. 확인이 안 되는 게 네 가지 있다.
같은 벤치마크를 두 번 센 것 같다.
abstract에 “Experiments on LOCOMO, LOCCO, and LoCoMo” 라고 쓰고, 표에서도 LOCOMO와 LoCoMo를 다른 행으로 둔다. 실험 설정을 보면 LOCOMO에는 [15] Maharana et al.(평균 588.2턴, 27.2세션짜리 대화 메모리 벤치마크)을 붙이고, LoCoMo에는 [18] EvolveMem을 붙인다. EvolveMem은 데이터셋이 아니라 메모리 시스템 논문이다.
아래 논문 Table II에서 Dataset 열의 LOCOMO 두 행과 LoCoMo 두 행이 따로 있는 걸 볼 수 있다.
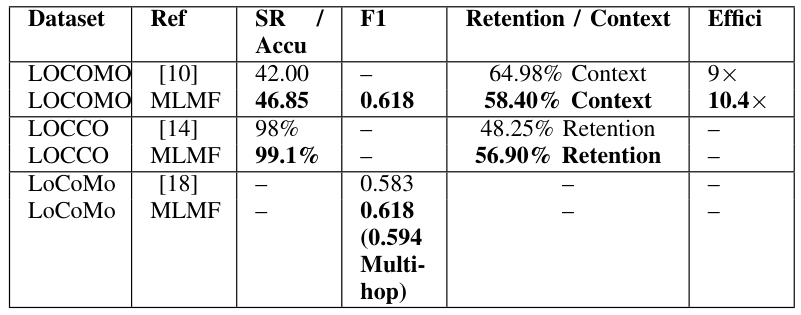
-> 이름만 보면 둘 다 Maharana et al.의 LoCoMo인데, 한쪽은 원래 벤치마크고 한쪽은 EvolveMem이 LoCoMo에서 낸 수치와 비교한 것 같다. 그러면 데이터셋은 세 개가 아니라 두 개다. 본문 설명만으로는 확실하게 모르겠다.
베이스라인이 참조 번호로만 나온다.
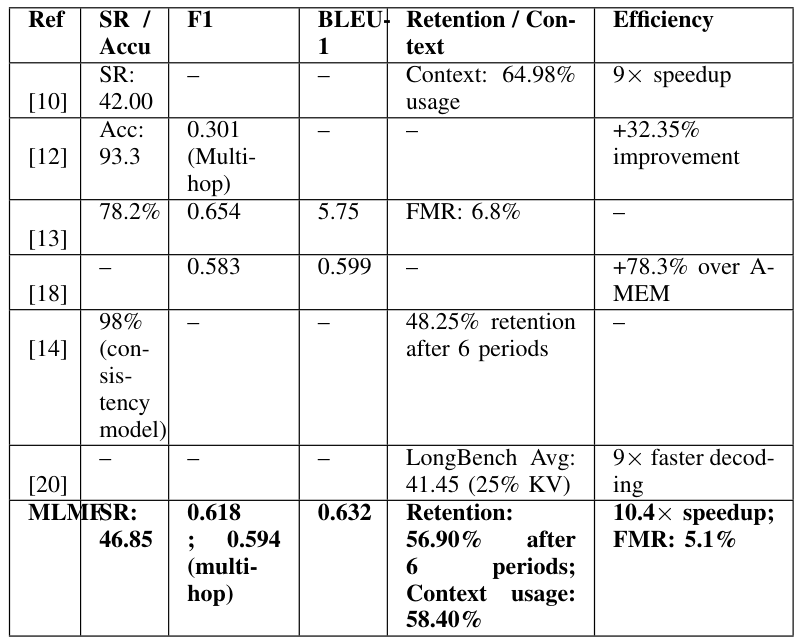
표에 [10], [12], [13], [14], [18], [20]으로만 적혀 있다. 따라가 보면 HiAgent, MemoryOS, Truth-Maintained Memory Agent, Jia et al., EvolveMem, LaVa다. 서로 다른 과제와 지표를 쓰는 논문들이라, 각 논문이 보고한 수치를 한 표에 가져다 놓은 건지 같은 조건에서 다시 돌린 건지 알 수 없다.
아래 논문 Table III의 Ref 열이 그 참조 번호다. 칸마다 지표가 SR, Acc, FMR, LongBench Avg처럼 제각각인 것도 보인다.
날짜가 안 맞는다.
PDF 머리에는 “Published online in June 2025” 라고 찍혀 있는데 arXiv 제출은 2026년 3월 31일이다. journal_ref는 비어 있어서 어디에 실렸는지 확인이 안 된다.
full-context와 비교가 없다.
Anatomy에서 본 Context Saturation Gap(∆, 메모리 시스템 점수에서 대화 전체를 프롬프트에 넣었을 때 점수를 뺀 값)을 계산할 수 없다. 메모리 구조를 쓰는 게 그냥 다 넣는 것보다 나은지를 모른다.
그래서 절대 수치는 인용하기 어렵다. 대신 같은 시스템 안에서 계층을 하나씩 떼는 ablation은 조건이 같으니까 상대 비교로는 볼 만하다. 아래는 그 부분 위주로 본다.
A. Training and Evaluation Across Benchmarks
세 벤치마크에서 MLMF가 SR, F1, BLEU-1, 보존율, 컨텍스트 사용률 모두 각 참조 논문이 보고한 수치보다 낫다고 한다. 다섯 번 돌린 평균이고, F1과 보존율 차이는 paired t-test로 유의하다고 적는다.
F1은 논문이 따로 그림으로 비교한다.
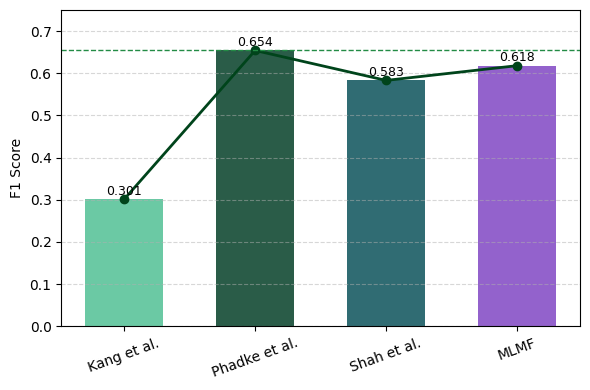
점선이 가장 센 베이스라인이다. 그런데 그 점선은 Phadke et al.(0.654)이고, MLMF(0.618)는 그 아래에 있다. 위 Table III의 [13] 행 F1도 0.654다.
-> 논문 그림으로 봐도 F1은 모든 참조 논문보다 낫다고 하기 어렵다.
B. Long-Term Retention and Stability Analysis
LOCCO에서 6기간 뒤 보존율과 거짓 기억률을 따로 보고, 보존율은 오르고 거짓 기억률과 컨텍스트 사용률은 내려갔다고 한다.
아래 논문 Table IV다. 비교 대상이 지표마다 다른 논문([14], [13], [10])이라 한 행에 한 칸씩만 채워져 있다.
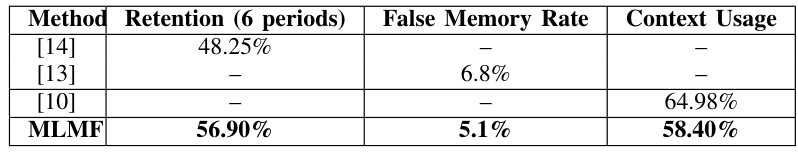
논문은 이걸 세션 간 드리프트를 막는 retention regularization 덕분으로 본다.
C. Ablation Study
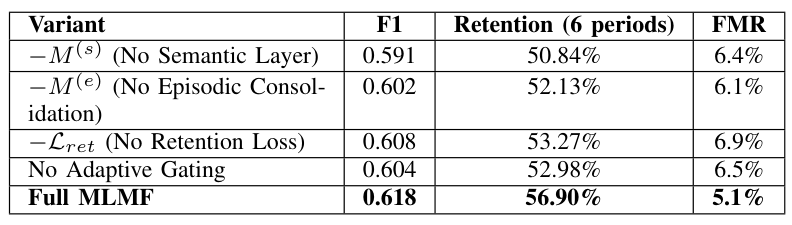
모듈을 하나씩 떼면서 세 가지를 잰다.
- F1 : LoCoMo 질문에 대한 답의 overall F1
- 6기간 보존율 : LOCCO에서 여섯 번의 시간 간격이 지난 뒤에도 남아 있는 기억의 비율
- FMR(거짓 기억률) : 없던 내용을 기억한다고 답하는 비율
F1을 어떻게 계산했는지는 논문에 안 나온다. LoCoMo에서는 보통 답과 정답이 겹치는 토큰으로 잰다. FMR은 Table IV 제목과 V.B 본문에 LOCCO에서 쟀다고 나온다.
아래가 논문 Table V다. 다섯 번 돌린 평균이라고 한다. 맨 아래 Full MLMF 행과 위의 네 변형 행을 비교하면 된다.
논문은 같은 결과를 막대그래프로도 보여준다.
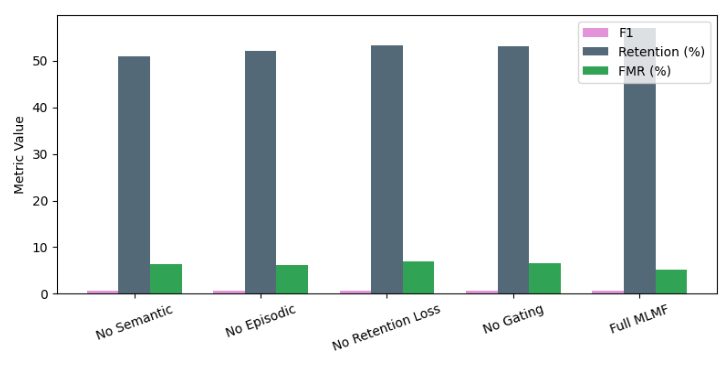
변형마다 F1, 보존율, FMR 막대를 나란히 놓은 그림이다. 전체 모델이 모든 지표에서 축소 변형보다 낫다고 한다.
F1은 0~1 값이라 같은 눈금에서는 막대가 거의 안 보인다. F1 차이는 위 표로 보는 게 낫다.
표를 보면,
- semantic 계층을 빼면 보존율이 제일 많이 떨어진다. 56.90% → 50.84%로 6.06%p이고, F1도 0.618 → 0.591로 제일 많이 준다. episodic을 빼면 4.77%p 떨어져서 semantic보다는 작다.
- 보존 손실을 빼면 거짓 기억이 제일 많이 는다. 5.1% → 6.9%다. F1은 0.010만 떨어져서 제일 작은데 FMR만 튄다.
-> 1번을 보면 세션 요약(episodic)만으로는 부족하고, 엔티티 단위로 정리해둬야 오래 남는다는 얘기 같다.
2번은 드리프트를 막는 장치가 정확도보다는 없는 걸 지어내는 쪽을 막는 데 효과가 있다는 결과다. 앞에서 본 LongMemEval 리뷰에서 ABS(답이 없는 질문에 모른다고 하는 능력)를 따로 잰 것과 이어진다.
6. Conclusion
conclusion 부분을 보면, 계층적 메모리 분해에 adaptive retrieval gating과 retention regularization을 붙인 프레임워크를 제안했다. working·episodic·semantic을 나눠서 세션 간 드리프트를 막으면서 컨텍스트가 늘어나는 것도 막는다.
그리고 ablation으로 semantic consolidation(의미 통합)과 보존 통제가 장기 성능에 기여한다는 걸 확인했다고 한다.
한계 절은 없다. 8쪽 안에 Limitations도 Future Work도 없다.
계층을 몇 개 둘지는 앞의 논문들이 각자 정해서 썼는데, 이 논문은 계층을 하나씩 빼보면서 얼마나 기여하는지를 쟀다. 앞에서 본 SYNAPSE는 episodic과 semantic을 잇는 방식까지 다뤘는데, 이 논문은 식 (6) M(s)=A(M(e))처럼 episodic에서 semantic을 한 방향으로 뽑기만 하고, 질의 때 두 계층을 오가며 잇지는 않는다.
검증이 안 되는 부분이 많아서 계층 ablation 표 하나 말고는 가져오기 어렵다. 그래도 그 표는 다른 데서 못 본 수치다.
7. 지금 관점: 메모리 계층을 나눌 때 참고할 것
ablation에서 보존율이 떨어진 폭으로 줄 세우면 semantic(−6.06%p), episodic(−4.77%p), adaptive gating(−3.92%p), 보존 손실(−3.63%p) 순이다.
보존 손실은 보존율로는 꼴찌지만 FMR로는 제일 크다.
semantic 계층이 1순위라는 건 앞에서 본 Zep, Mem0와 맞는다. 둘 다 엔티티를 중심에 둔다. Zep은 semantic entity subgraph를, Mem0g는 엔티티 노드를 둔다.
-> 계층을 몇 개 둘지 고민한다면 세션 요약보다 엔티티 정리를 먼저 두는 게 맞아 보인다.
다만 앞에서 본 Experience-Following 리뷰에서는 과거 실행 경험이 행동을 직접 바꿨는데, 여기 ablation에는 experiential 계층이 아예 없다.
사실 기억만 다룬 실험이라 경험 계층을 둘지는 이 표로 판단할 수 없다.
FMR을 정확도와 따로 재는 건 가져와 볼 만하다. 정확도가 같아도 지어내는 비율은 다를 수 있다.
사용자 입장에서는 모른다고 하는 것보다 틀린 걸 기억이라고 말하는 쪽이 더 곤란하다.
절대 수치(0.618, 56.90%, 5.1%)는 5장 첫머리에 적은 문제들 때문에 인용하지 않고, ablation의 상대 순서만 참고한다.
다음은 MemMachine이다. 대화 원문을 그대로 보관하고 LLM 추출을 최소화하는 개인화 메모리 시스템인데, ablation을 보면 저장 방식을 바꾼 것보다 검색 단계를 손본 쪽이 점수를 더 많이 올렸다.
Leave a comment