
What Deserves Memory Paper review
What Deserves Memory: Adaptive Memory Distillation for LLM Agents
https://arxiv.org/abs/2508.03341
NEMORI는 Fudan University, Shanda Group, Beihang University 등에서 만든 에이전트 메모리 프레임워크이다. 2025년 8월 arXiv에 v1이 올라왔을 때 제목은 “Nemori: Self-Organizing Agent Memory Inspired by Cognitive Science”였고, 2026년 4월 v4에서 지금 제목으로 바뀌었다. 시스템 이름은 그대로 NEMORI다.
무엇을 기억으로 남길지를 중요도 점수 대신 “예측 실패”로 정한다. 기존 지식으로 예상한 것과 실제가 어긋난 부분만 기억으로 남긴다.
앞 리뷰에서는 무엇을 넣고 지우느냐가 에이전트 행동을 바꾼다는 걸 봤는데, 이 논문은 처음에 무엇을 뽑을지를 다룬다. 뒤에서 볼 Janus는 갱신 후보를 만든 뒤, 반영하기 전에 옛 메모리와 비교해 검증하는 쪽이다.
1. Introduction
introduction 부분을 보면 문제를 이렇게 적는다.
LLM 에이전트 메모리는 어떤 정보를 남길 가치가 있는지 정하기 어렵다. 기존 방법들은 중요도 점수, 감정 태그, 사실 템플릿 같은 미리 정해둔 휴리스틱을 쓰는데, 논문은 이걸 데이터에서 배운 것 없이 설계자의 직관을 그대로 넣은 것으로 본다.
그래서 생기는 문제가 두 가지다.
- 주관적 편향 : 증류 단계에서 한 번 잘못 뽑으면 되돌릴 수 없는 정보 왜곡이 생김
- 시스템 비대화 : 그 왜곡을 피하려고 이것저것 다 저장하게 되고, 검색 잡음이 커짐
앞에서 본 Generative Agents의 recency·relevance·importance 3점수 회상이 딱 이런 휴리스틱이다. importance를 LLM한테 1~10점으로 매기게 하는 방식이 여기서 말하는 설계자 직관이다.
2. Related Works
에이전트 메모리를 증류(무엇을 남길지), 관리, 검색 세 단계로 나누고, 기존 연구를 메타데이터를 관리 시점에 붙이는지 증류 시점에 붙이는지로 나눠 정리한다.
인지 쪽에서는 Predictive Coding Theory와 Free Energy Principle을 소개하고, 예측 오차가 남길 정보라는 생각을 여기서 가져왔다고 한다.
3. Methodology
3.1 Overview & Motivations
Predictive Coding Theory(Rao & Ballard 1999, Friston 2010, Clark 2013)에서 기준을 가져온다. 위쪽 뇌 영역이 예측을 내려보내고, 아래쪽은 예측과 어긋난 오차를 주로 올려보낸다는 이론이다.
상호작용 안의 정보는 대부분 중복이고, 예상 밖의 정보가 기억으로 남길 후보라고 본다.
그래서 경험이 나중에 쓸모 있을지를 “예측할 수 있느냐”의 문제로 바꾼다. 기존 지식으로 맞출 수 있는 건 저장하지 않고, 예측하지 못한 관측만 증류한다.
설계는 사전 가정(prior) 세 가지를 따름.
- Structure Prior : 대화는 자연스럽게 에피소드로 묶이고, 임의로 자르면 맥락이 끊김
- Representation Prior : 원시 대화는 잡음이 많으니 이야기 형태로 바꿔 둬야 떠올리기 좋음
- Distillation Prior : 예측할 수 있는 정보는 중복임
모듈은 두 개가 이어진 구조다. 논문은 이걸 에피소드 기억과 의미 지식을 나눠 보는 Complementary Learning Systems 이론(McClelland et al. 1995)에 대응시킨다.
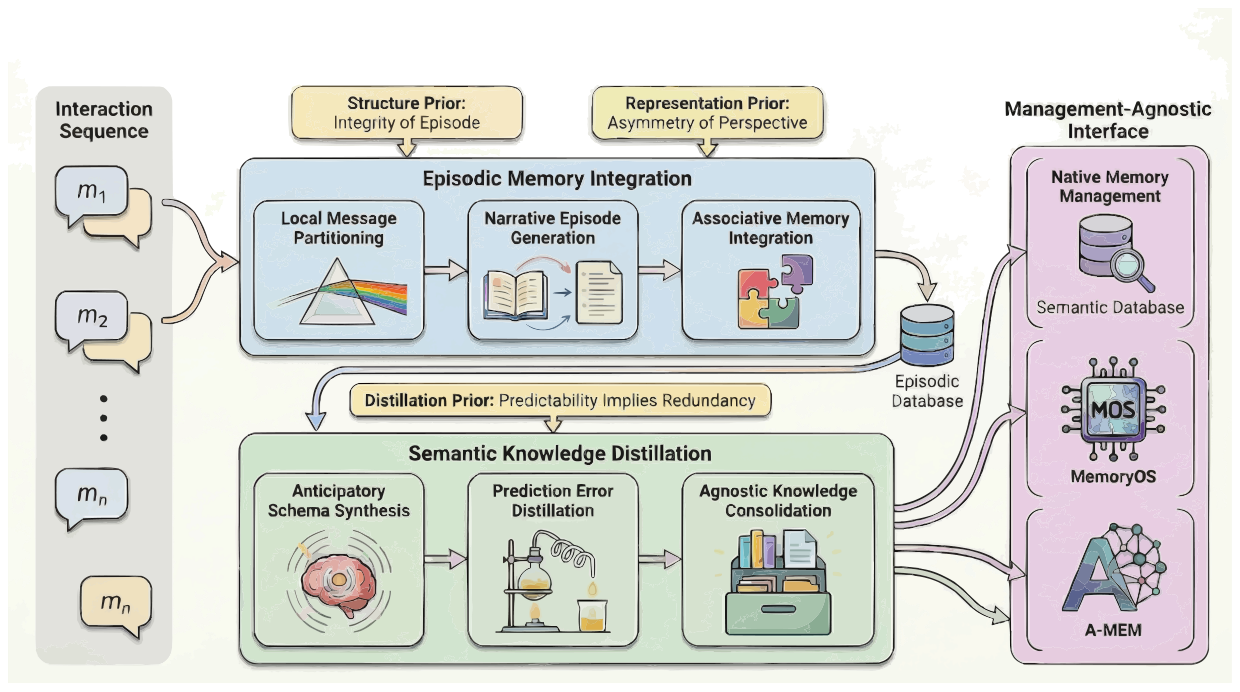
위쪽 Episodic Memory Integration이 원시 대화를 이야기처럼 이어지는 에피소드로 바꾸고, 아래쪽 Semantic Knowledge Distillation이 예측 오차로 지식을 뽑는다.
오른쪽은 뽑은 지식을 받는 쪽이다. 자체 관리 모듈이나 MemoryOS(OS에서 착안한 계층형 저장 메모리), A-MEM 같은 외부 시스템에 증류 층으로 붙일 수 있다고 한다.
3.2 Episodic Memory Integration
원시 대화를 이야기처럼 이어지는 에피소드로 바꾼다. 세 단계다.
- Local Message Partitioning : 메시지가 관측 창 길이
w만큼 쌓이면 LLM이 보고 에피소드 경계를 나눔 - Narrative Episode Generation : 나눈 묶음을 이야기 형태의 에피소드로 만듦
- Associative Memory Integration : 창 경계에서 잘린 에피소드가 있으면 기존 것과 합치고, 없으면 따로 넣음
앞에서 본 LongMemEval 리뷰에서도 뭘 한 덩어리로 저장하나(세션, 라운드, 사실)를 비교했다. 거기서는 라운드가 낫다는 고정 답이었고, 여기서는 LLM이 경계를 찾는다.
3.3 Semantic Knowledge Distillation
예측 오차로 지식을 뽑는 모듈이다. 메모리를 어떻게 관리하든 붙을 수 있게(management-agnostic) 인터페이스만 정해뒀다.
- Anticipatory Schema Synthesis (예상 스키마 합성)
- Prediction Error Distillation (예측 오차 증류)
- Agnostic Knowledge Consolidation
1번은 들어온 에피소드를 보기 전에, 기존 지식만으로 무슨 일이 있었을지 먼저 예측하는 단계다.
관리 시스템에서 관련 맥락 S_in을 불러오고(임계값으로 거른 유사도 검색), 에피소드 요약 한 줄과 불러온 맥락만 가지고 예상 스키마를 만든다. 프롬프트 P_ant가 LLM한테 “주어진 맥락으로 실제 무슨 일이 있었을지 예측하라”고 시킨다. 결과는 기존 지식만으로 한 추측이다.
2번은 원래 에피소드와 예상 스키마를 같이 LLM에 넣고, 예상에서 벗어나거나 예상보다 더 나간 정보만 뽑는다. 맞힌 부분은 버린다.
3번은 뽑은 지식을 관리 시스템에 넣는 단계다. 기본 구현에서는 지식 하나마다 비슷한 기존 항목 5개를 찾고, LLM이 new(새로 추가), merge(합침), conflict(옛 항목을 지우고 교체) 중 하나를 고른다.
-> 예측 오차 기준은 넣을 때만 쓰고, 합치거나 지우는 건 결국 LLM 판단이다.
3.4 Response Generation
질문 임베딩으로 에피소드 DB에서 top-k, 의미 DB에서 top-m을 따로 검색하고, 이야기 에피소드·원시 에피소드 일부·의미 지식을 이어 붙여 LLM에 넣어 답을 만든다.
답변 단계는 메모리 구축과 따로 놀아서 다른 검색 전략으로 바꿔도 된다고 한다.
4. Experiments
4.1 Experimental Setup
벤치마크는 LoCoMo와 LongMemEvalS 두 개, 베이스라인은 Full Context, RAG-4096, LangMem, Zep, Mem0, A-MEM, MemoryOS 일곱 개다.
지표는 gpt-4o-mini가 채점하는 LLM-judge 점수가 주이고, 백본은 gpt-4o-mini와 gpt-4.1-mini 두 가지를 쓴다.
4.2 Main Results (RQ1)
아래는 LoCoMo(대화 10개, 평균 24K 토큰, 질문 1,540개) 결과인 논문 Table 2다. 맨 오른쪽 Average 묶음의 LLM 열(gpt-4o-mini가 0~100으로 채점한 LLM-judge 점수)을 보면 된다. Improv. 행은 밑줄 친 가장 센 베이스라인 대비 상대 개선율이다. gpt-4o-mini에서는 73.0으로 Mem0(61.3)보다 19.1%, gpt-4.1-mini에서는 80.8로 LangMem(73.4)보다 10.1% 높다.
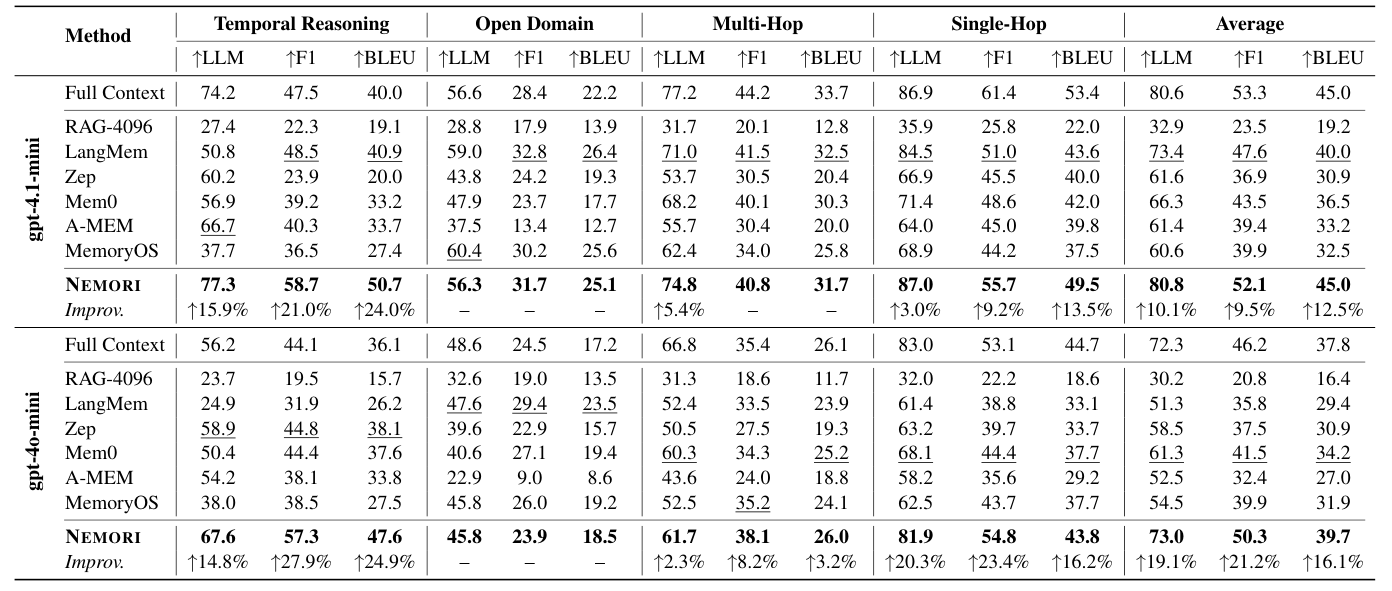
LangMem은 세션을 넘어 지식을 자동으로 추출하는 메모리 라이브러리다.
Full Context(대화 전체를 그대로 넣는 방식)도 두 모델 모두에서 조금 넘는다(80.8 vs 80.6, 73.0 vs 72.3).
차이가 1점도 안 된다. LoCoMo는 전부 넣어도 되는 길이라서 그렇고, 논문도 이걸 알고 뒤에서 더 긴 벤치마크로 넘어간다.
Full Context와 비교하는 이 차이는 뒤에서 볼 Anatomy 리뷰에서 다시 나온다.
Temporal Reasoning이 특히 높다. gpt-4.1-mini에서 77.3(A-MEM 대비 +15.9%), gpt-4o-mini에서 67.6(Zep 대비 +14.8%)이다.
논문은 에피소드 중심으로 만들어두면 추론 부담 일부가 답변 생성 단계에서 메모리 만들 때로 옮겨가기 때문으로 본다.
4.3 Efficiency Analysis (RQ2)
먼저 메모리 구축 비용(논문 Table 3)이다. LoCoMo, gpt-4o-mini 기준이고 베이스라인 수치는 Fang et al.(2025)에서 가져왔다. Calls 열과 Total 열을 보면 되고, Improv. 행은 가장 나은 베이스라인 대비 상대 변화다.
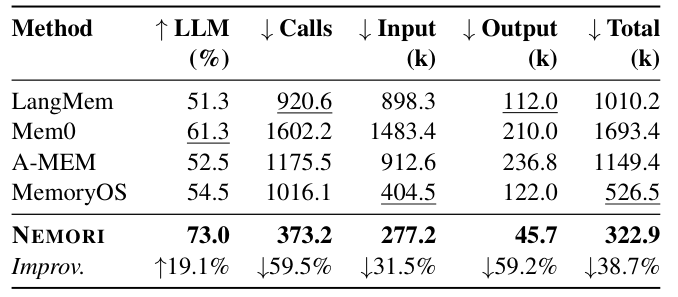
LLM 호출이 59.5% 줄었다. 프롬프트를 여러 개 쓰는 복잡한 파이프라인인데도 그렇다. 논문은 메시지 단위 대신 에피소드 단위로 처리해서라고 설명한다.
다음은 응답 생성 비용(논문 Table 4)이다. 같은 LoCoMo, gpt-4o-mini에서 질문을 받고 답을 낼 때까지를 쟀다. FullContext 행과 NEMORI 행의 Tokens, Total 열을 비교하면 된다.
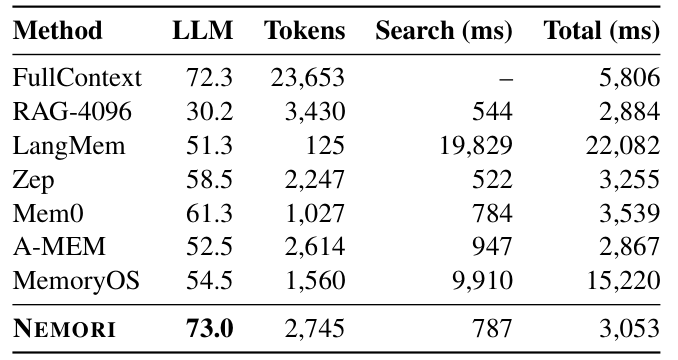
Full Context 대비 토큰은 88%, 지연은 47% 줄었고 정확도는 더 높다.
LangMem은 토큰이 125개인데 검색에 19.8초를 쓴다. 앞에서 본 Mem0 리뷰에서도 같은 패턴이었다. 토큰이 적다고 빨라지지는 않는다.
4.4 Ablation Study (RQ3)
예측 오차로 증류하는 것과, 들어온 에피소드에서 바로 지식을 뽑는 직접 증류를 비교한다. 아래 논문 Table 5(LoCoMo)에서 볼 행은 두 개다.
- NEMORI-s : 예측 없이 원래 에피소드에서 바로 지식을 뽑는 직접 증류
- w/o e : NEMORI의 예측 오차 증류는 그대로 두고, 답변할 때 에피소드 DB만 뺀 설정
둘 다 답변할 때 의미 DB만 쓰니 다른 건 증류 방식뿐이다. 표에서 Nemori-s와 w/o e의 Mgmt가 ✗인 행(native 관리 모듈을 끄고 단순 RAG로 관리한 경우)의 LLM 열을 비교하면 된다. gpt-4o-mini는 52.0 vs 65.0, gpt-4.1-mini는 65.5 vs 74.9다.
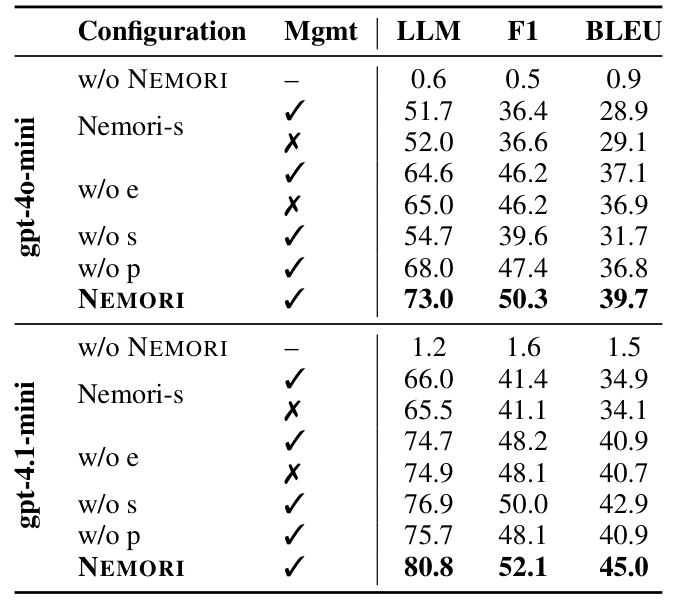
gpt-4o-mini에서 예측 오차 쪽이 13점, 상대로 25% 높다.
native 관리 모듈(3.3의 new/merge/conflict 처리)은 켜고 꺼도 거의 차이가 없다. w/o e 설정에서 켰을 때 64.6, 껐을 때 65.0이고(gpt-4o-mini), gpt-4.1-mini에서는 74.7 vs 74.9다.
논문은 LoCoMo에 지식이 바뀌는 경우가 드물어서 그렇다고 보고, 실제 서비스에서는 업데이트가 잦을 수 있어 관리 모듈을 남겨둔다고 한다.
-> 켰을 때가 오히려 조금 낮다. 업데이트가 많은 데이터로 따로 재봤으면 좋았을 것 같다.
관측 창 길이 w도 5~40으로 바꿔 봤다. gpt-4.1-mini에서 80.4~81.2로 거의 같다(기본값 20에서 80.8). 경계를 LLM이 찾고 잘린 건 뒤에서 합치니 창 길이에 덜 민감하다는 설명이다.
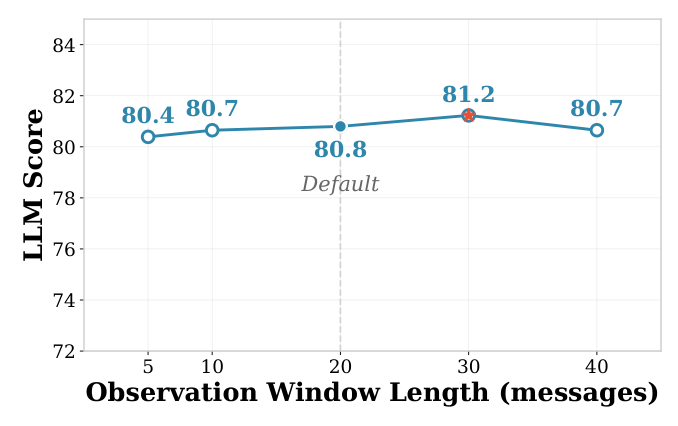
가로축이 창 길이(메시지 수), 세로축이 LLM 점수다. 점선이 기본값 20이고, 5부터 40까지 선이 거의 평평하다.
4.5 Retrieval Hyperparameter Analysis (RQ4)
검색 개수 k를 2에서 30까지 바꿔 보면 10까지는 크게 오르고, 그 뒤로는 Full Context보다 높은 수준에서 평평하다.
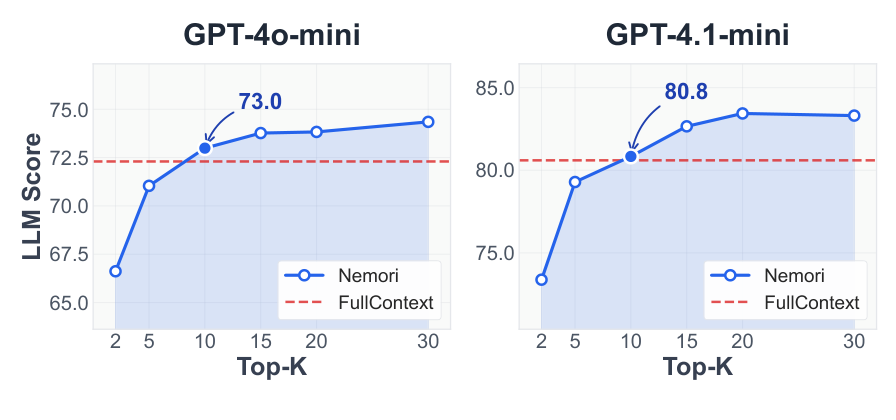
왼쪽이 gpt-4o-mini, 오른쪽이 gpt-4.1-mini이고 빨간 점선이 Full Context다. 표시된 점(73.0, 80.8)이 본 실험에서 쓴 k=10이다.
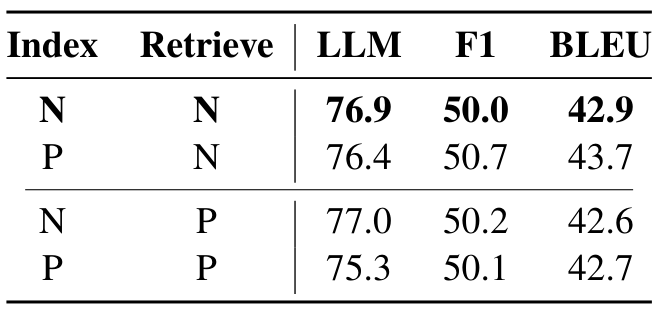
검색해 넣는 내용을 고정하고 인덱스만 바꾸면, 이야기 에피소드로 만든 임베딩이 원시 에피소드 임베딩보다 낫다고 한다. 아래 논문 Table 6(LoCoMo, gpt-4.1-mini)에서 Retrieve가 같은 두 행끼리 Index N(이야기 에피소드)과 P(원시 에피소드)의 LLM 열을 비교하면 된다. N을 꺼낼 때 76.9 vs 76.4, P를 꺼낼 때 77.0 vs 75.3이다.
4.6 Third-Party Integration (RQ5)
NEMORI를 다른 메모리 시스템 앞단의 증류 모듈로 붙여본다.
원시 메시지 대신 증류한 의미 지식을 넣어주면, A-MEM과 MemoryOS 둘 다 저장량이 45~64% 줄고 평균 성능은 ±4% 안에서 유지된다. Temporal을 뺀 나머지 유형의 가중 평균(core)은 +1.9% ~ +6.1% 올랐다.
아래 논문 Table 7에서 P는 원시 메시지, K는 NEMORI가 증류한 의미 지식을 넣은 경우이고, Δ 행이 그 차이다.
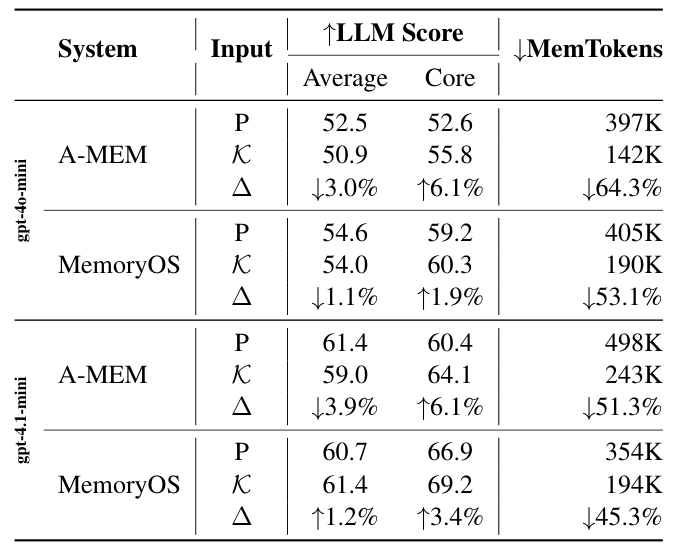
기존 시스템을 바꾸지 않고 앞에 끼워 넣을 수 있다는 얘기다.
4.7 Scalability Analysis (RQ6)
LongMemEvalS(대화 500개, 평균 105K 토큰)에서 질문 유형별 LLM-judge 점수다(논문 Table 8). 아래쪽 gpt-4.1-mini 부분을 기준으로 본다.
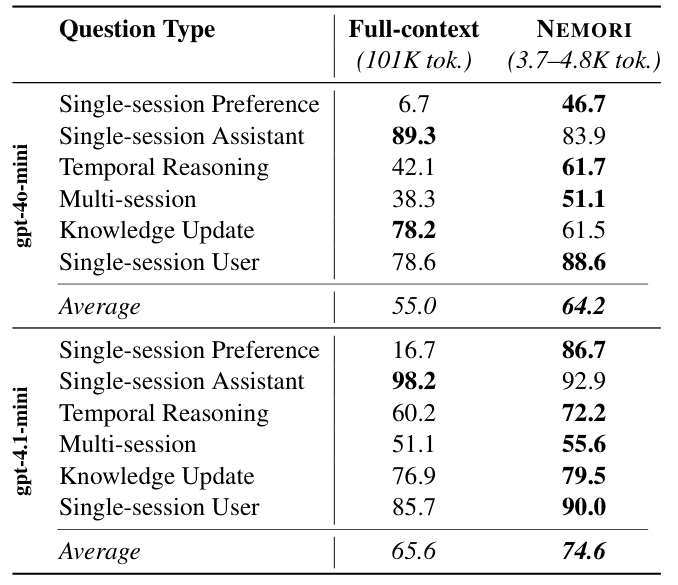
Full Context와 평균 차이가 +9.0점이다. LoCoMo에서 +0.2점이던 게 커졌다. gpt-4o-mini에서도 55.0 → 64.2로 비슷하게 오른다.
논문은 맥락이 길수록 증류가 더 도움이 된다고 본다. Full Context는 입력이 길면 어텐션이 흐려지고, NEMORI는 필요한 것만 검색해서 넣는다는 설명이다.
컨텍스트를 95~96% 줄이면서 정확도가 더 높다.
-> 그런데 토큰 수가 논문 안에서 서로 다르다. LoCoMo는 실험 설정에서 평균 24K인데 여기 본문에서는 9K, LongMemEvalS는 105K인데 표에서는 101K다. 어느 기준으로 센 건지??
gpt-4.1-mini에서는 single-session-assistant에서만 진다(92.9 vs 98.2). 앞에서 본 Zep 리뷰에서도 gpt-4o에서는 이 유형만 떨어졌다(gpt-4o-mini에서는 knowledge-update도 떨어졌다). 어시스턴트 발화는 추출하면서 흐려지는 것 같다.
gpt-4o-mini에서는 single-session-assistant(89.3 → 83.9)에 더해 Knowledge Update에서도 크게 진다(78.2 → 61.5). 이건 논문이 따로 설명하지 않는다.
5. Conclusion
conclusion 부분을 보면, 인지과학 아이디어를 가져와 증류 단계에서 경험이 나중에 쓸모 있을지를 판단하는, 학습이 필요 없는 프레임워크를 만들었다고 한다. 예측 오차가 기억으로 남길 가치가 있다고 본다.
마지막 문장은 agentic하다고 해서 휴리스틱일 필요는 없고, 데이터 성질을 보고 기준을 세울 수 있다는 내용이다. 오래 일관되게 동작해야 하는 에이전트는 대부분 사람이 직접 관리하지 못하는 곳에서 돌기 때문에 이게 점점 중요해진다고 한다.
한계는 두 가지를 적어뒀다. NEMORI는 증류에만 집중했고 관리와 검색은 단순하게 했다. 여기 벤치마크에서는 충분했지만 메모리를 더 복잡하게 추론해야 하는 과제에서는 병목이 될 수 있다. 그리고 외부 시스템과 붙이는 인터페이스가 아직 개념 수준이라, 실제로 붙이려면 시스템마다 따로 구현해야 한다.
여태까지 나온 방법들이 무엇을 남길지를 점수나 LLM 판단으로 정했다면, 이 방법은 기존 지식으로 예측해보고 틀린 부분만 남긴다.
뒤에서 볼 MemMachine은 반대로 검색 쪽을 손보는 논문이라 거기서 다시 비교해본다.
6. 지금 관점: importance 점수 대신 써볼 만한가
앞에서 본 시스템들은 무엇을 남길지를 대부분 LLM이 판단했다.
Generative Agents는 LLM이 importance를 1~10점으로 매기고, Mem0는 LLM이 대화에서 기억할 사실을 골라 뽑는다.
Experience-Following은 조금 다르다. 넣을 때는 평가기가 채점하고, 지울 때는 몇 번 검색됐고 그때 결과가 어땠는지 같은 사용 기록을 본다.
NEMORI도 예상 스키마를 LLM이 만드니 LLM 판단이 빠지진 않는다.
다른 건 묻는 질문이다. “무엇이 중요한가” 대신 “지금 메모리로 맞힐 수 있나”를 묻는다. 기준이 이미 쌓인 메모리에 따라 바뀐다.
-> 그래서 importance 점수보다는 데이터 쪽에 가깝다고 본다.
실제로 쓴다면 제3자 통합 실험처럼 지금 쓰는 메모리 앞에 증류 층으로 끼우는 게 제일 현실적일 것 같다. 저장이 45~64% 줄고 평균 성능은 ±4% 안이었다.
다만 어시스턴트 발화에 약했다. 안내나 추천처럼 어시스턴트가 한 말을 다시 찾아야 하면 그 부분은 원문을 따로 남겨두는 게 나을 것 같다.
예상 스키마를 만드는 데 LLM 호출이 하나 더 붙는다. 구축 비용이 줄어든 건(LLM 호출 −59.5%, 총 토큰 −38.7%) 에피소드 단위로 처리해서다.
-> 메시지가 올 때마다 바로 반영해야 하는 구조라면 어떻게 될지??
다음은 Memory in the Age of AI Agents다. 장기기억·단기기억 이분법 대신 Forms·Functions·Dynamics 세 가지 기준으로 에이전트 메모리를 다시 정리한 107쪽짜리 서베이다.
Leave a comment