
LongMemEval-V2 Paper review
LongMemEval-V2: Evaluating Long-Term Agent Memory Toward Experienced Colleagues
https://arxiv.org/abs/2605.12493
LongMemEval-V2는 UCLA에서 만든 에이전트 메모리 벤치마크다. 2026년 5월 arXiv에 올라왔고, V1과 1저자(Di Wu)가 같다.
웹 에이전트가 같은 환경에서 반복해서 일한 경험을 메모리로 잘 쌓아서, 숙련된 동료처럼 되는지를 잰다.
이름만 보면 V1 대신 쓰면 되는 후속판 같은데, 읽어보니 V1과는 다른 문제를 잰다. 둘 중 무엇을 쓸지는 무엇을 재려는지에 따라 다르다.
1. Introduction
V1에서 무엇이 달라졌는지부터 보자.
V1은 사용자-어시스턴트 대화에서 사용자에 대한 사실을 기억하는지 물었다.
V2는 메모리 시스템이 에이전트를 맞춤 환경을 잘 다루는 숙련자로 만들어주는지를 묻는다.
기존 에이전트 메모리 벤치마크는 대부분 사용자 이력, 짧은 궤적, 다운스트림 태스크 성공률을 봤고, 메모리 시스템이 환경마다 다른 경험을 제대로 익히는지를 직접 재는 방법은 없었다고 한다.
논문 Table 1은 기존 벤치마크와 V2를 비교한 표다. 맨 아래 LongMemEval-V2 행과 중간의 LongMemEval-V1 행을 같이 보면 된다. 오른쪽 Memory Ability 칸은 V2가 정의한 다섯 능력(3.1절) 중 어떤 걸 다루는지를 논문이 체크한 것이다.
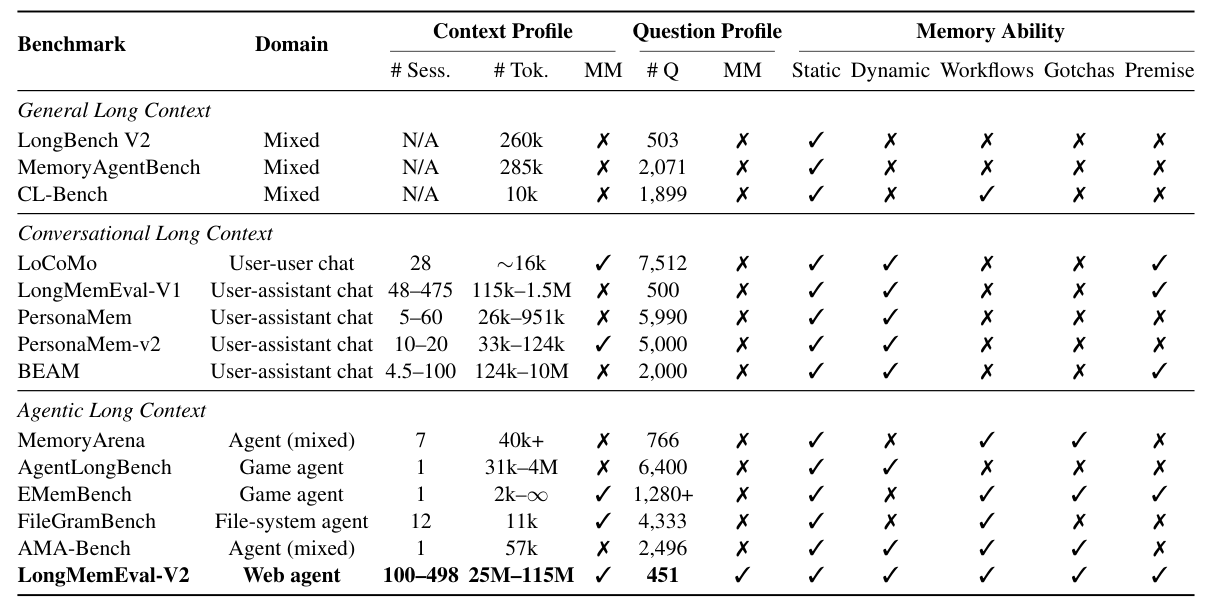
최대 토큰이 약 77배 늘었다. V1은 1.5M, V2는 115M이다.
V1은 원래 자기 능력 분류가 따로 있었다. IE(정보 추출), MR(다중 세션 추론), KU(지식 갱신), TR(시간 추론), ABS(답이 없으면 모른다고 하기) 다섯 개다. 논문은 이걸 V2 기준으로 다시 매겨서 V1이 세 개를 다룬다고 표시했다.
Table 1에 있는 벤치마크 열네 개(V2 포함) 중에 V2 기준 다섯 능력에 다 체크된 건 V2 하나다.
2. Related Work
긴 문맥·개인화 메모리 벤치마크(LoCoMo, LongMemEval 등), 에이전트 궤적을 쓰는 메모리 벤치마크(MemoryArena, AMA-Bench 등), LLM이 메모리 읽기·쓰기를 직접 하는 시스템(MemGPT, A-MEM, Mem0 등)을 정리한다.
가장 가까운 AMA-Bench는 궤적 하나를 이해하는지 보고, V2는 여러 궤적에 걸쳐 쌓인 환경 지식을 본다고 한다.
3. LongMemEval-V2
3.1 Core Memory Ability Definition
한 환경에서 반복해서 일하고 나면 숙련된 동료는 뭘 익히게 되는가? 라는 질문에서 시작한다.
다섯 가지로 나눈다.
- Static State Recall : 중요한 랜드마크, 페이지 레이아웃, 모듈 기능, 상태 사이의 작은 차이를 기억
- Dynamic State Tracking : 상태와 행동이 주어지면 환경이 어떻게 바뀌는지 앎 (환경의 월드 모델)
- Workflow Knowledge : 그 환경에서 자주 하는 작업의 단계를 앎
- Environment Gotchas : 그 환경에서 반복되는 함정을 알고 피함
- Premise Awareness : 다른 환경에서는 맞지만 지금 환경에서는 틀린 전제를 알아챔
V1의 다섯 가지와 비교하면 사실보다 절차와 함정 쪽으로 옮겨갔다.
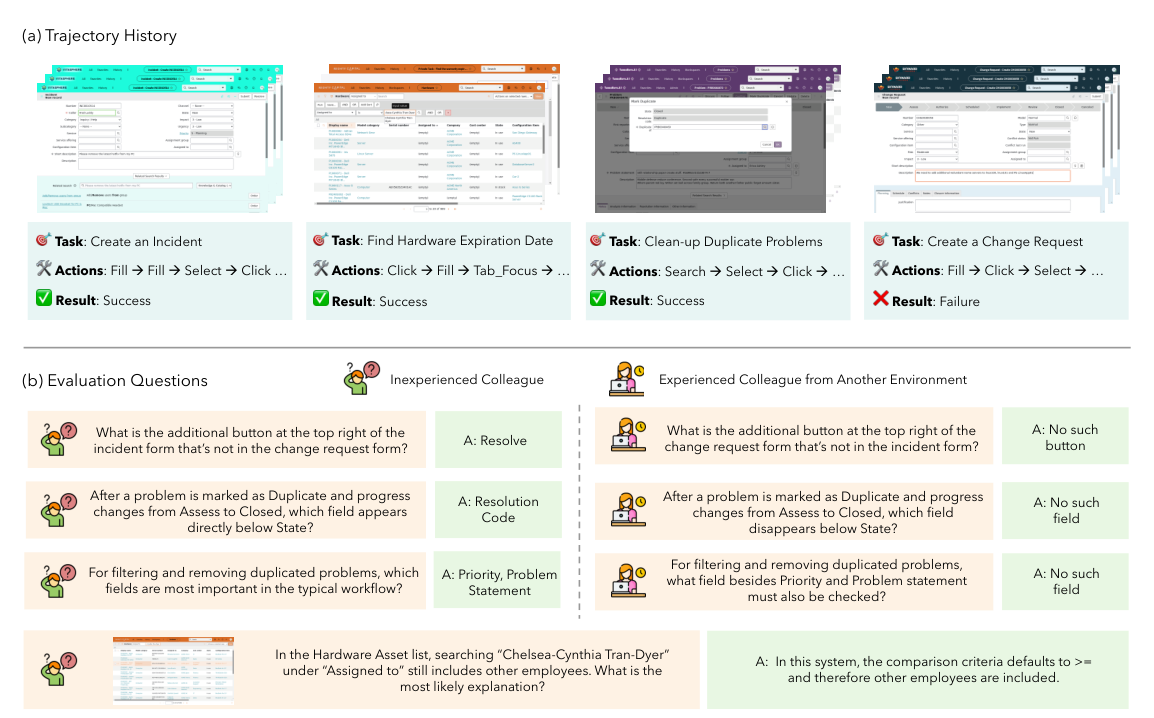
위는 WorkArena 궤적 이력이고, 아래는 그 궤적에서 만든 평가 질문이다.
왼쪽 행들이 static, dynamic, workflow, gotchas 질문이고, 오른쪽 열이 premise awareness 질문이다.
오른쪽 질문의 답은 “No such button”, “No such field”다. 다른 환경에서 온 사람이 할 법한 잘못된 전제를 알아채는지 본다.
앞에서 본 서베이(Memory in the Age of AI Agents)의 Functions 분류로 보면 V1은 사실 기억(factual memory)을, V2는 겪은 경험에서 배우는 기억(experiential memory)을 잰다. 앞에서 본 메모리 논문들은 거의 다 factual 쪽이었다.
Gotchas는 이 시리즈에서 처음 보는 축이다. 논문 Table 1에서 Gotchas까지 다루는 건 MemoryArena, EMemBench, 여러 종류의 에이전트 궤적을 다루는 AMA-Bench, 그리고 V2 네 개다.
문항은 WorkArena-ServiceNow(46.8%), WebArena-Reddit(20.2%), WebArena-CMS(18.4%), WebArena-OneStopShop(14.6%)에서 나온다. 형식은 단답(50.1%), 자유형(34.6%), 객관식(15.3%)이다.
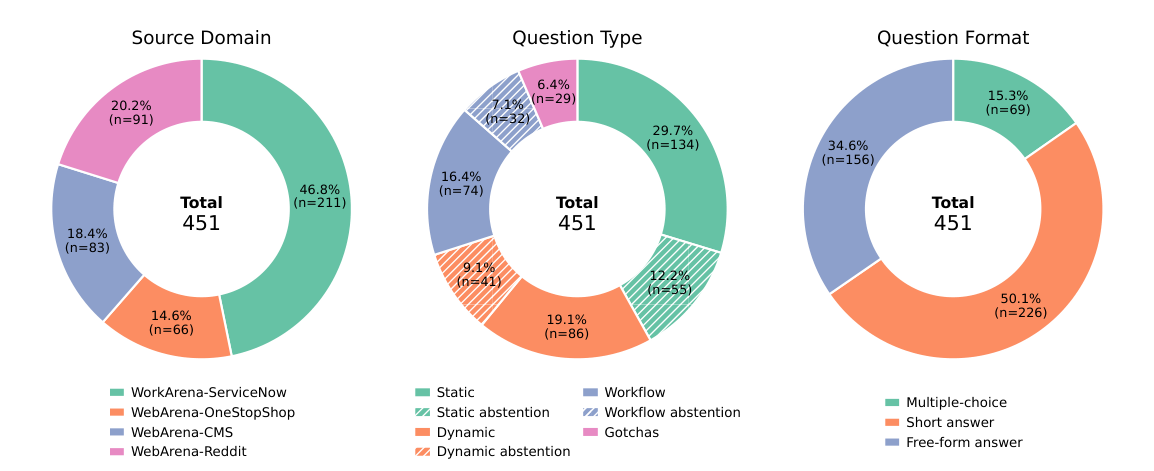
전체 451문항을 출처 도메인, 질문 유형, 형식별로 나눈 그림이다.
가운데 질문 유형에는 static, dynamic, workflow마다 abstention 문항이 따로 있다.
3.2 Annotation
WebArena, WorkArena, WorkArena++에서 웹 에이전트 궤적을 모으고, 사람이 궤적을 보고 질문을 직접 만들었다. 그다음 질문마다 답이 들어 있는 궤적을 표시하고, 이 궤적들로 이력(haystack)을 구성한다.
3.3 Evaluation Formulation
평가를 맥락 수집(context gathering) 과제로 둔다.
메모리 시스템은 API 두 개를 지원해야 한다.
Insert(h)   — 궤적을 순차 삽입
Query(q)    — 최종 메모리에 질의
궤적 이력 전체(논문은 haystack이라고 부른다)를 순서대로 넣고, 질문으로 질의해서 나온 맥락을 받는다. 그걸 고정된 리더 모델(Qwen3.5-9B)이 읽고 답한다.
haystack은 두 크기가 있다. Small은 도메인마다(ServiceNow, WebArena) 그 도메인 질문들이 같이 쓰는 궤적 100개짜리이고(전체 약 25M 토큰), Medium은 질문마다 따로 만든 궤적 약 500개(약 115M 토큰)다. 정답이 들어 있는 궤적은 그중 몇 개뿐이다.
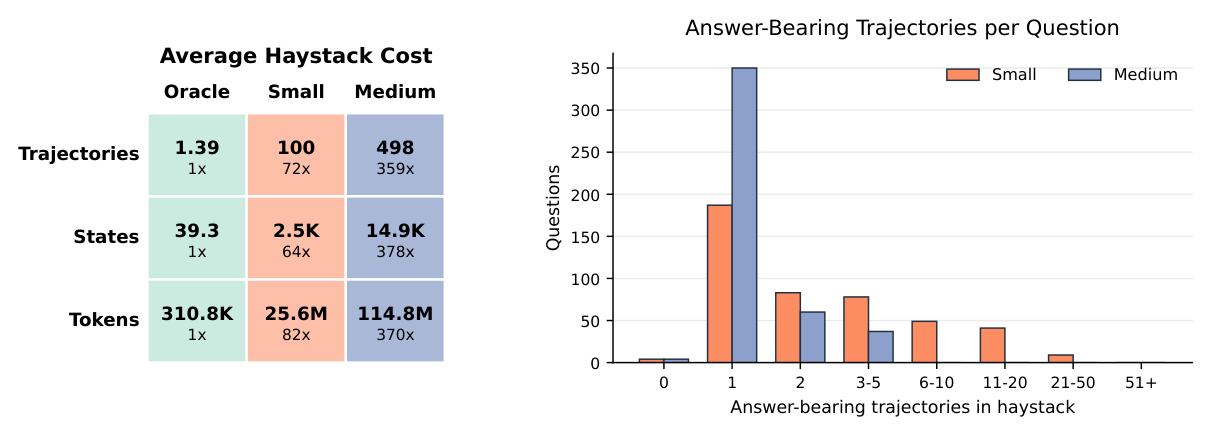
왼쪽은 oracle, Small, Medium의 평균 궤적·상태·토큰 수이고, 오른쪽은 질문마다 haystack 안에 정답 궤적이 몇 개 있는지다.
Medium은 대부분 정답 궤적이 1개이고, Small은 2개 이상인 질문이 더 많다.
메모리가 쓸 만한 증거를 돌려주는지를 리더 성능과 떼어서 재려는 설계다. 논문도 한계 절에서 이건 일부러 한 설계라고 밝힌다. 엔드투엔드 태스크 성공률은 재지 않는다.
앞에서 본 Anatomy 리뷰에서는 메모리를 재는 건지 컨텍스트 길이를 재는 건지 따졌는데, 여기서는 리더를 고정해서 차이가 메모리에서만 나오게 했다.
3.4 Pilot Studies
난이도를 두 가지로 검증한다.
첫째, 궤적 없이 풀 수 있나?
질문만 주고 프런티어 LLM에 물어봤다. 제일 좋은 모델이 14.1%다. 공개 지식이나 파라미터 지식만으로는 대부분 못 푼다.
둘째, 정답이 들어 있는 궤적만 주면 풀리나?
정답이 들어 있는 궤적(oracle)만 주면 long-context 프롬프팅 점수가 많이 오르지만, 그래도 한계가 있다고 한다. 궤적이 모델 컨텍스트 창보다 크기 때문이다.
oracle은 질문당 평균 궤적 1.39개, 약 310.8K 토큰이다. haystack 전체(25M~115M)를 주는 게 아닌데도 창을 넘는다. 웹 에이전트 궤적은 화면 상태가 계속 들어가서 하나하나가 길다.
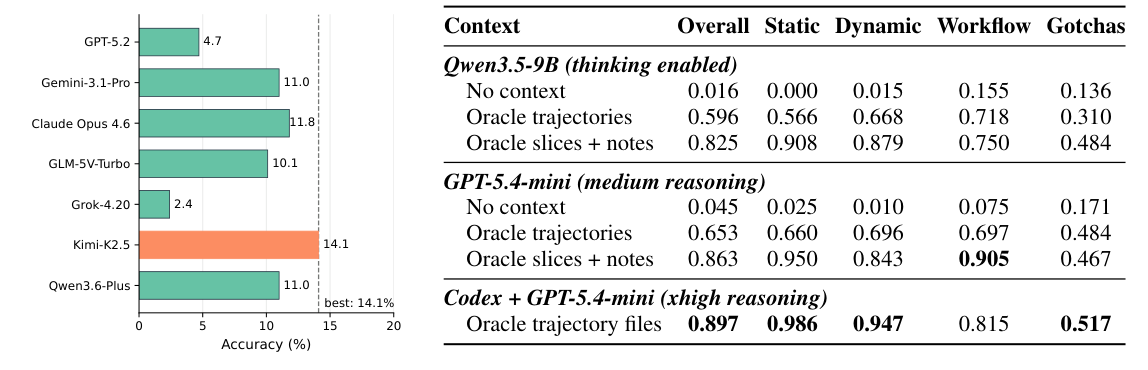
왼쪽이 질문만 준 프런티어 LLM 정확도이고, 오른쪽이 oracle 궤적을 준 direct QA 결과다.
oracle 궤적을 통째로 주는 것보다 정답 상태 주변만 자른 slice와 요약 노트로 줄이거나, 코딩 에이전트 하네스를 쓰면 더 오른다고 한다.
4. AgentRunbook
논문이 같이 내놓은 메모리 방법 두 개다.
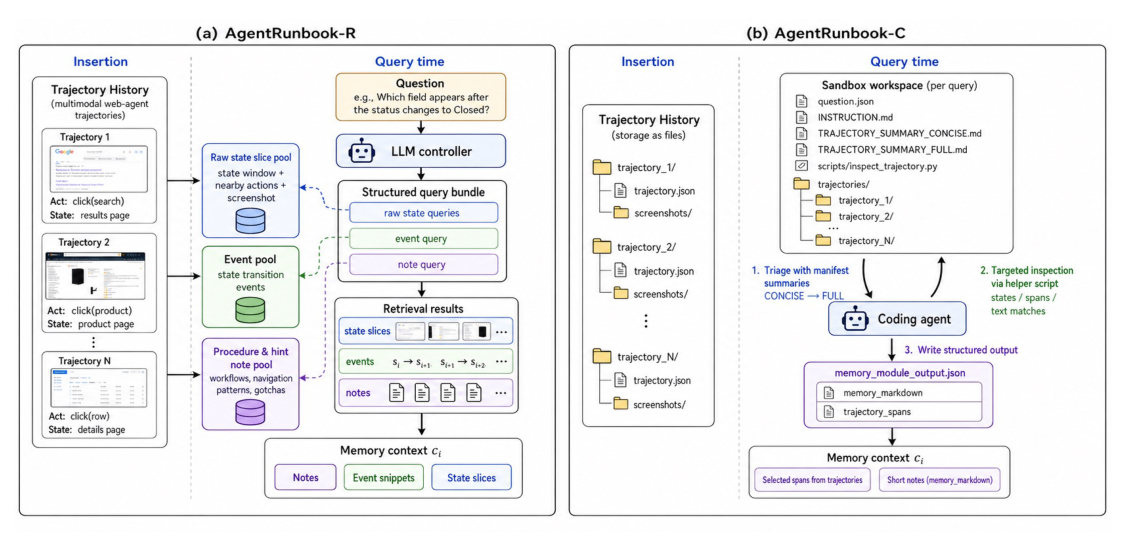
(a) AgentRunbook-R은 넣을 때 궤적을 raw state, event, note 풀로 나눠 담고, 질의할 때 LLM 컨트롤러가 풀마다 질의를 만든다.
(b) AgentRunbook-C는 궤적을 파일로 저장하고, 질의마다 지시문과 manifest를 넣은 샌드박스를 만들어 코딩 에이전트가 증거를 모으게 한다.
4.1 AgentRunbook-R
R은 RAG를 뜻한다.
넣을 때 구조화된 메모리 항목을 뽑아두고 질의할 때 검색한다. 단위가 다른 지식 풀 세 개를 둔다.
- raw state slice : 궤적 상태 주변을 자른 창. 세밀한 UI 관측과 주변 행동을 그대로 남김
- state transition event : 연속된 상태에서 뽑은 이벤트. 행동이 환경을 어떻게 바꾸는지
- procedure and hint note : 궤적 단위 노트. 재사용할 워크플로, 탐색 패턴, 환경별 함정
질의할 때는 LLM 컨트롤러가 질의와 지금 메모리 스냅샷을 보고 풀마다 검색 질의를 만든다.
원본 조각과 추상 노트를 같이 두는 구조는 뒤에서 볼 Rate-Distortion 리뷰에서 다시 나온다.
4.2 AgentRunbook-C
C는 코딩 에이전트를 뜻한다. 이쪽은 방식이 다르다.
검색을 고정된 벡터 검색 파이프라인으로 하지 않고, 궤적을 파일로 그대로 저장한 다음 코딩 에이전트가 질의할 때 직접 찾아보고 골라내게 한다.
기성 코딩 에이전트는 메모리 모듈로 쓰라고 만든 게 아니라서 너무 많이 찾거나, 너무 적게 찾거나, 비효율적으로 본다고 한다. 그래서 가벼운 장치 세 개를 붙인다.
- workflow 문서 : 메모리 모듈로 행동하라는 지시와 증거 수집 단계
- query-time manifest : 지금 메모리 구조 요약. 자세히 보기 전에 관련 궤적을 추리는 데 씀
- helper script : 상태 구간 보기, 궤적 안 검색 같은 자주 쓰는 연산
원본을 두고 에이전트가 직접 찾게 하는 방식은 뒤에서 볼 ReFind에서도 나온다.
5. Experiments
리더는 항상 Qwen3.5-9B다. 메모리가 돌려준 맥락은 200K 토큰에서 자른다.
5.1 Main Results
아래는 논문 Table 2다. 각 방법의 Overall 열(Small, Medium)과 Small의 Latency 열을 보면 된다. “–”로 시작하는 행은 ablation이다. RAG 쪽 컨트롤러는 Qwen3.5-9B, 코딩 에이전트 쪽은 GPT-5.4-mini다.
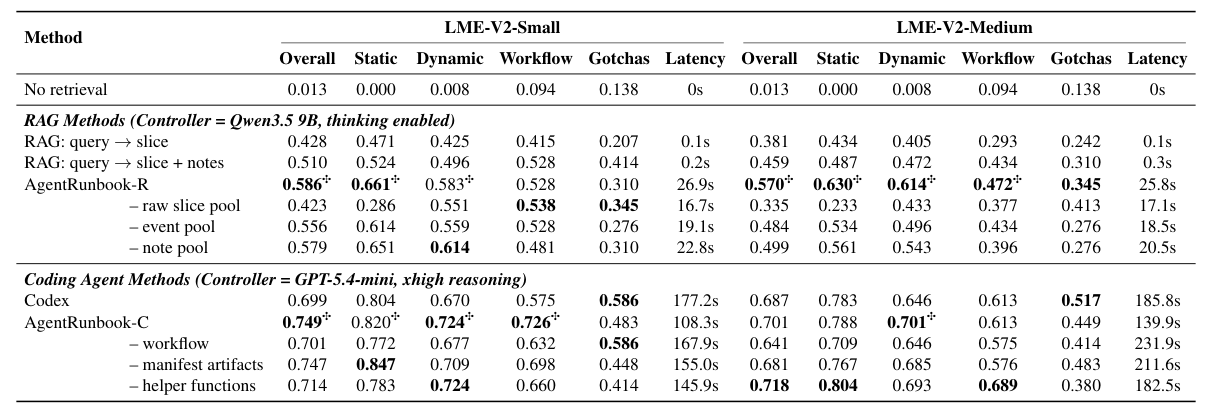
표를 보면,
- no-retrieval이 1.3%다. 메모리 없이는 리더가 못 푼다.
- 노트를 더하면 Small에서 8점 넘게 오른다. slice만 쓰면 0.428, slice+notes는 0.510이다. 국소 관측만으로는 부족하다.
- AgentRunbook-R이 RAG 중 제일 좋은 slice+notes보다 높다. Small과 Medium 평균으로 57.8%다. abstract에 나온 48.5%는 R이 아니라 slice+notes의 평균이다.
- 코딩 에이전트가 제일 높다. AgentRunbook-C가 평균 72.5%로 vanilla Codex(69.3%)보다 높고, 붙인 장치들이 +3점 정도 기여한다.
ablation을 보면 풀마다 역할이 다르다.
- raw slice 풀은 static 질문에 중요
- event 풀을 빼면 static, dynamic, gotchas가 전부 나빠짐
- Workflow 질문은 이벤트와 노트로 묶어둔 경험이 있을 때 좋아짐
5.2 Accuracy and Latency Trade-off
메모리 컨트롤러의 reasoning effort가 전체 질의 지연에 크게 영향을 준다고 한다.
AgentRunbook-R은 정확도는 중간이고 지연은 26초 정도다. thinking을 끄면 훨씬 낮아진다. AgentRunbook-C는 정확도를 더 올리지만 지연이 100초 넘게 든다. 그래도 vanilla Codex보다는 32% 빠르다고 한다.
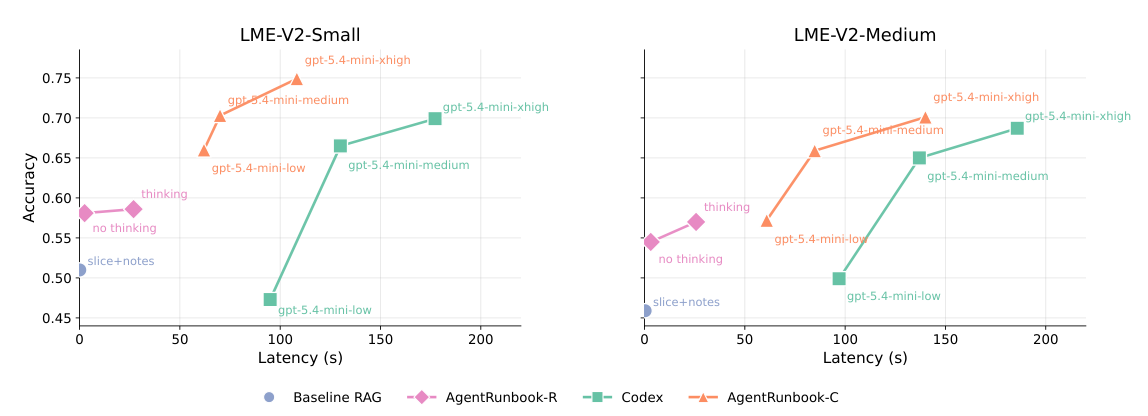
가로축이 질의 지연, 세로축이 정확도다. 점마다 컨트롤러의 reasoning effort 설정이 다르다.
같은 reasoning effort에서 AgentRunbook-C(주황)가 vanilla Codex(초록)보다 위에 있다.
코딩 에이전트는 워크플로 안내, manifest, 궤적 검사 도구와 같이 줄 때 메모리 컨트롤러로 더 잘 동작한다고 한다.
6. Conclusion
conclusion 부분을 보면, 메모리 시스템은 에이전트가 특정 환경을 잘 다루는 숙련자가 되도록 도와야 한다고 한다.
다섯 능력을 다 다루고, 멀티모달 웹 에이전트 이력으로 1억 토큰이 넘는 맥락 깊이까지 벤치마크를 키웠다.
논문이 밝힌 한계는 세 가지다.
- 웹 에이전트만 다룸. 코딩 에이전트, 컴퓨터 사용 에이전트, 도메인 특화 기업 에이전트는 없음
- 미리 모아둔 궤적 이력으로 평가. 에이전트 자신의 행동이 바뀌면서 생기는 분포 변화는 못 담음
- 엔드투엔드 태스크 성공률이 아님. 고정 리더에게 쓸 만한 증거를 돌려주는지만 잼
2번은 앞에서 본 Experience-Following 리뷰와 겹친다. 거기서는 에이전트가 만든 경험이 다시 에이전트 행동을 바꾸는 루프를 쟀는데, V2는 그 루프를 끊고 고정된 이력으로 평가한다.
V1이 사용자 대화를 물었다면 V2는 웹 에이전트 궤적을 묻고, 그만큼 규모도 커졌다. 아직 이 벤치마크에서 돌려본 메모리 시스템은 논문이 만든 AgentRunbook 말고는 거의 없다.
7. 지금 관점: V1과 V2 중 어느 쪽으로 잴지
둘은 갈아타는 관계가 아니다. 재는 대상이 다르다.
V1은 사용자에 대한 사실을 기억하는지를 115k–1.5M 토큰 규모에서 잰다. 개인화 챗봇이나 선호 추적에 맞고, 앞 리뷰들에서 Zep, MemMachine이 평가한 곳이다.
V2는 환경에 대한 경험을 익히는지를 25M–115M 토큰 규모에서 잰다. 웹·도구 에이전트나 반복 작업 자동화에 맞다.
사용자 정보를 기억하고 갱신하는 챗봇이라면 V1이 여전히 맞는 기준 같다. V1의 KU(지식 갱신)와 ABS(모른다고 하기)가 바로 그 일이다. 대신 V2가 보는 쪽은 앞에서 본 논문들에서 거의 비어 있었다. 경험 기억을 제대로 잰 건 Experience-Following 하나였고, 그것도 합성 태스크(RegAgent) 하나에 기존 에이전트 3개(EHRAgent, AgentDriver, CIC-IoT)를 붙인 규모였다. 도구를 반복해서 부르는 에이전트라면 Gotchas와 Premise Awareness가 바로 해당될 것 같다. 예를 들면 어떤 도구가 특정 조건에서 실패하는 패턴을 에이전트가 익히는지 같은 것.
AgentRunbook-R의 3풀 구조는 규모가 작아도 가져와 볼 만하다. 원본 조각, 상태 전이 이벤트, 절차 노트를 따로 저장하고 따로 검색한다. ablation을 보면 풀마다 맡는 질문 유형이 다르다.
26초 지연도 참고할 숫자다. AgentRunbook-R이 빠른 쪽인데도 26초다. thinking을 끄면 내려간다고는 하지만, 이 규모에서 실시간 응답은 어려울 것 같다.
다음은 MemFail이다. 메모리 시스템을 요약·저장·검색 세 연산으로 나눠서, 틀린 답이 어느 단계에서 나왔는지 찾아내는 진단 벤치마크다.
Leave a comment